Schauen wir uns zuerst drei echte Fälle von Fehlschlägen an.
Lassen Sie das Modell eine Aufführung traditioneller chinesischer Musik aufnehmen, und die Instrumente und die Schrift auf dem Bild stimmen nicht mit der echten traditionellen chinesischen Musik überein. Lassen Sie es eine nigerianische Hochzeit aufnehmen, und die Kleidung der Gäste und die Zeremonieartikel sind alle „Standardmodelle“, ohne einen Hauch von Nigeria. Lassen Sie es ein japanisches Shogi-Spiel aufnehmen, und das Schachbrett und die Schachfiguren werden direkt zu westlichen Schachfiguren.
Die Bilder selbst sind einwandfrei, Licht und Schatten, Bewegung und Schärfe sind alle vorhanden – und genau das ist das Problem. Die Videos von Wensheng sind so realistisch, dass sie für das bloße Auge kaum von der Realität zu unterscheiden sind. Je realistischer das Bild ist, desto versteckter und auffälliger sind die kulturellen Fehler. Ein Video für den ausländischen Markt mit falschen Kleidungsstücken und falschen Ritualen wird von den Einheimischen sofort erkannt und ist im besten Fall lächerlich und im schlimmsten Fall beleidigend.
Die Arbeit „CultureVidBench: Benchmarking Cultural Understanding in Text-to-Video Generation“, die auf arXiv unter der Nummer 2608.01942 veröffentlicht wurde, stellt eine vollständige Prüfung für dieses Thema dar: 12 Länder, 1000 Fragen und 7 Modelle, die in einem Wettbewerb gegeneinander antreten, um das kulturelle Verständnis bei der Generierung von Text zu Video zu testen. Der Erstautor Xianjing Han kommt von der Nanyang Technological University, der korrespondierende Autor Bin Zhu von der Singapore Management University. Weitere Kooperationspartner sind Centrale Supélec und die University of Cambridge. Ich habe den Artikel vollständig gelesen und bin der Meinung, dass der Wert dieser Arbeit nicht in einer bestimmten Punktzahl liegt, sondern darin, dass sie zum ersten Mal die Frage „Versteht KI Kultur?“ von einer subjektiven in eine quantifizierbare technische Frage verwandelt hat.
Warum wurden in früheren Bewertungen keine kulturellen Aspekte berücksichtigt?
Es gibt viele Bewertungen von Wensheng-Videos, und es werden weiterhin Mainstream-Benchmarks wie VBench und EvalCrafter verwendet. Diese konzentrieren sich jedoch auf Bildqualität, Bewegungsflüssigkeit, physikalische Plausibilität und Relevanz für das Thema. Es gibt auch Benchmarks, die physikalisches Wissen und die Glaubwürdigkeit von Robotern testen, und jeder Benchmark konzentriert sich auf einen bestimmten Aspekt.
Was den Aspekt der Kultur betrifft, so hat ihn im Bereich der Videos kaum jemand systematisch getestet. Im Bereich der Bilder haben dies jedoch einige getan, und ViSAGe und CUBE-1K haben beide das Konzept der Kultur getestet – allerdings sind die Bilder statisch, sodass man nicht erkennen kann, ob die Bewegungen richtig sind, und man hört auch nicht, ob die Stimmen richtig sind. Die Kultur in Videos ist lebendig: Rituale haben Abläufe, Szenen haben Musik und Schilder haben Texte. Diese Lücke soll CultureVidBench schließen.
Der erste Schritt zum Schließen der Lücken ist die Erstellung der Prüfungsfragen, und die Qualität der Prüfungsfragen bestimmt direkt die Glaubwürdigkeit aller nachfolgenden Schlussfolgerungen. Die Arbeit, die in die Erstellung der Prüfungsfragen gesteckt wurde, ist es wert, separat erwähnt zu werden.
Wie wurde eine Prüfung erstellt, die zwölf Länder abdeckt?
Zuerst wählen Sie ein Land aus.Der Autor hat die Kulturkarte der World Values Survey – ein in der Wissenschaft häufig verwendetes Instrument zur kulturellen Einteilung – übernommen und die Welt in acht Kulturkreise unterteilt, darunter den Konfuzianismus, die englischsprachigen Länder und den afrikanischen Islam. Aus jedem Kreis wurden repräsentative Länder ausgewählt, sodass insgesamt zwölf Länder auf sechs Kontinenten vertreten sind. Beachten Sie die bewusste Zusammenstellung dieser Liste: Sie enthält sowohl hoch exponierte Länder wie die Vereinigten Staaten, China und Indien, über die im Internet viele Informationen verfügbar sind, als auch Länder mit geringen Ressourcen wie Äthiopien, Nigeria und Malaysia. Wie Sie später sehen werden, führt diese Zusammenstellung direkt zu einer der wichtigsten Schlussfolgerungen des gesamten Textes.
Neue Frage.Der Autor unterteilt die Kultur in drei Kategorien: materielle Kultur (Essen, Kleidung, Architektur, Dekoration, Dinge, die man sehen und anfassen kann), soziale Praktiken und Aufführungen (Begrüßungen, Essen, Tanz, Sport, religiöse Aktivitäten, Dinge, die Menschen tun) und Rituale (Hochzeiten, Beerdigungen, ein ganzes Prozedere). Diese drei Kategorien werden in 14 Aspekte unterteilt, und aus kulturellen Materialien verschiedener Länder werden 828 Kulturelemente gesammelt, die schließlich zu 1000 Stichwörtern verfeinert werden – 270 für die materielle Kultur, 386 für die praktische Kultur und 344 für die rituelle Kultur, mit durchschnittlich 12,8 englischen Wörtern pro Stichwort.
Die Qualität der Themen wird manuell überprüft.Jedes Stichwort wird mit einer Vorlage generiert: Materielle Kultur ist „wer + welche Aktion + welche kulturellen Elemente + in welchem Land“, zum Beispiel „Eine Dame serviert Feijoada auf einem Teller in einem Restaurant in Brasilien“. Rituale werden aufgrund ihrer Abfolge in Teilaktivitäten unterteilt, zum Beispiel die chinesische Teezeremonie bei einer Hochzeit in drei Schritte aufgeteilt: Eltern beugen sich, Tee servieren und rote Umschläge erhalten. Die vorgeschlagenen Themen werden außerdem von zwei menschlichen Annotatoren überprüft, um zu überprüfen, ob die Beschreibungen natürlich sind, ob die Kultur korrekt dargestellt wird und ob die Bilder realisierbar sind.
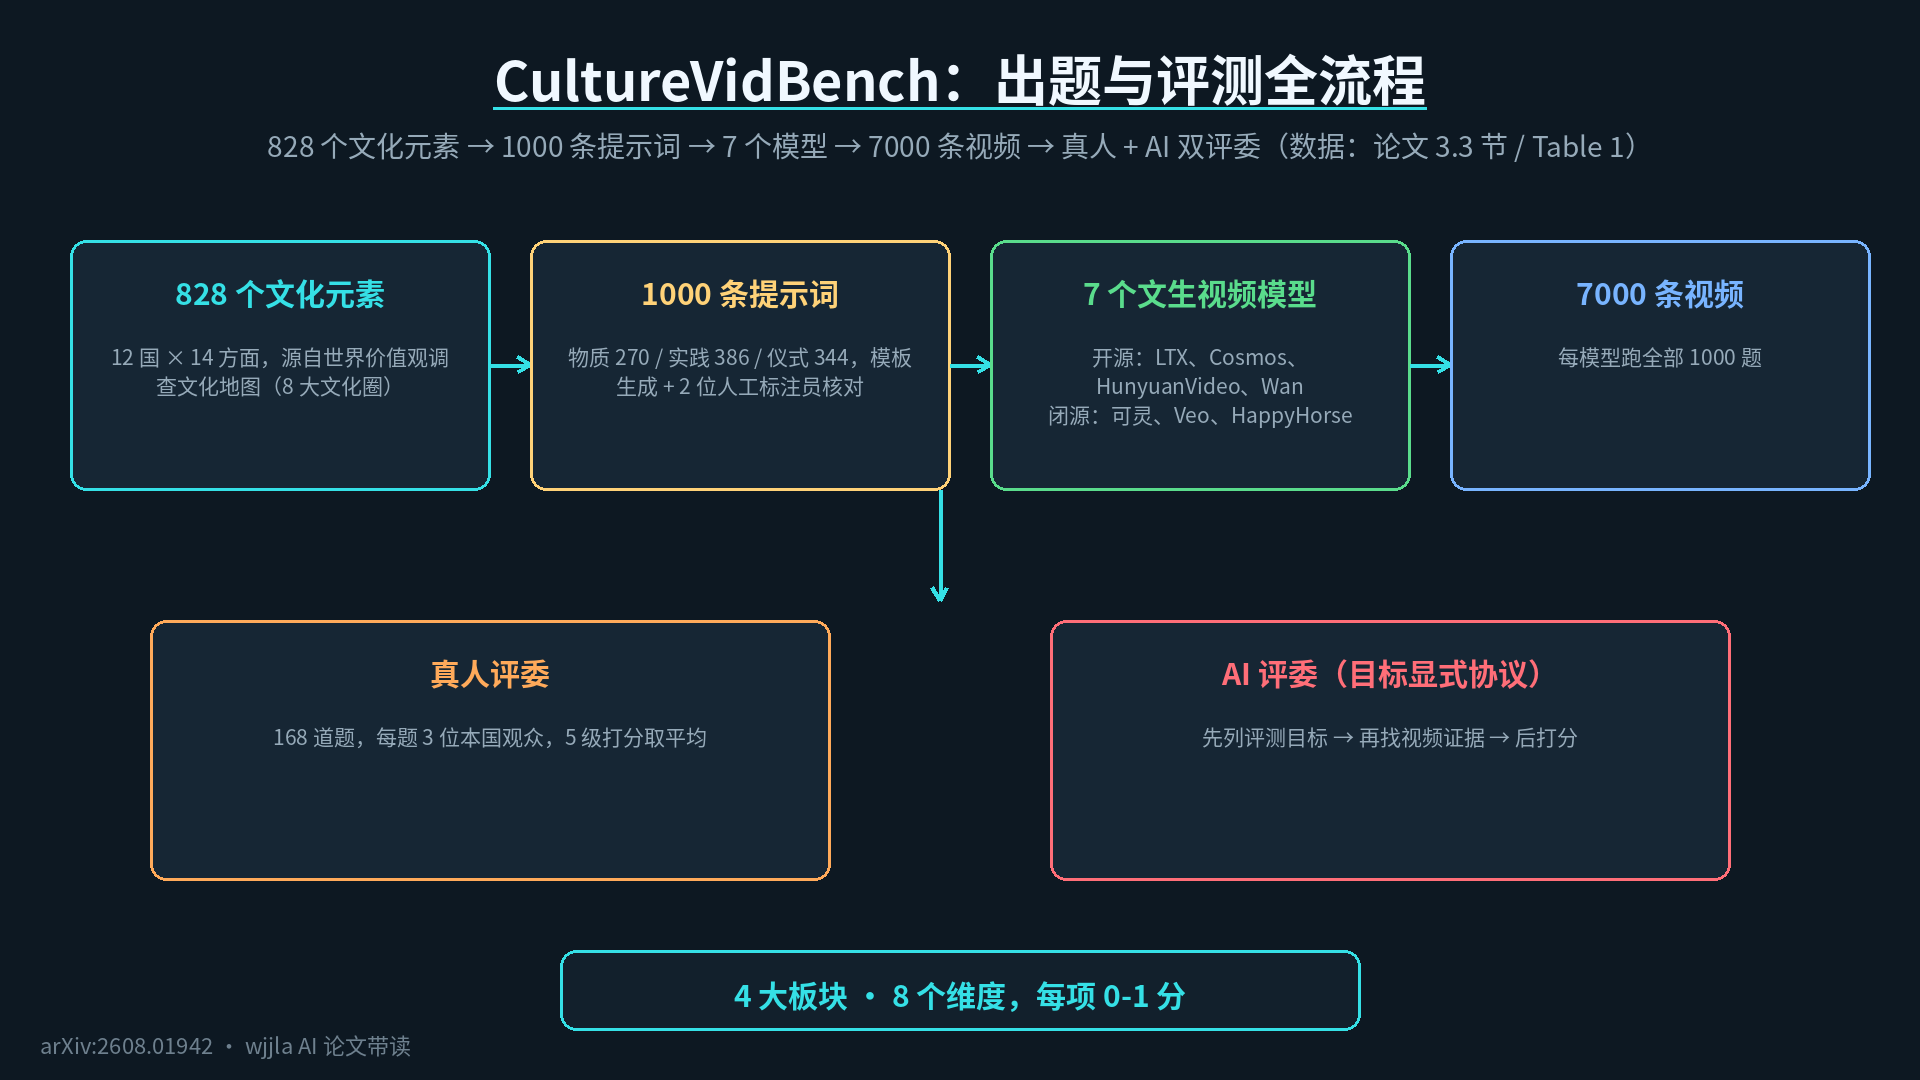
Die gesamte Produktionskette ist wie folgt aufgebaut: 828 kulturelle Elemente → 1000 Schlüsselwörter → 7 Modelle werden jeweils einmal ausgeführt, um 7000 Videos zu generieren → Bewertung durch zwei Jurys, eine menschliche und eine KI-basierte. Die Teilnehmer sind vier Open-Source-Modelle (LTX-2.3-22B, Cosmos-Predict-2.5-14B, HunyuanVideo-1.5, Wan-2.2-14B) und drei geschlossene Modelle (Kling-3.0, Veo-3.1-Fast, Alis HappyHorse-1.0).
Wie man bewertet: Zwei große Fragen, aufgeteilt in 8 kleinere Punkte
Das Bewertungssystem ist sehr klar gestaltet, und jedes Video beantwortet zwei Hauptfragen:
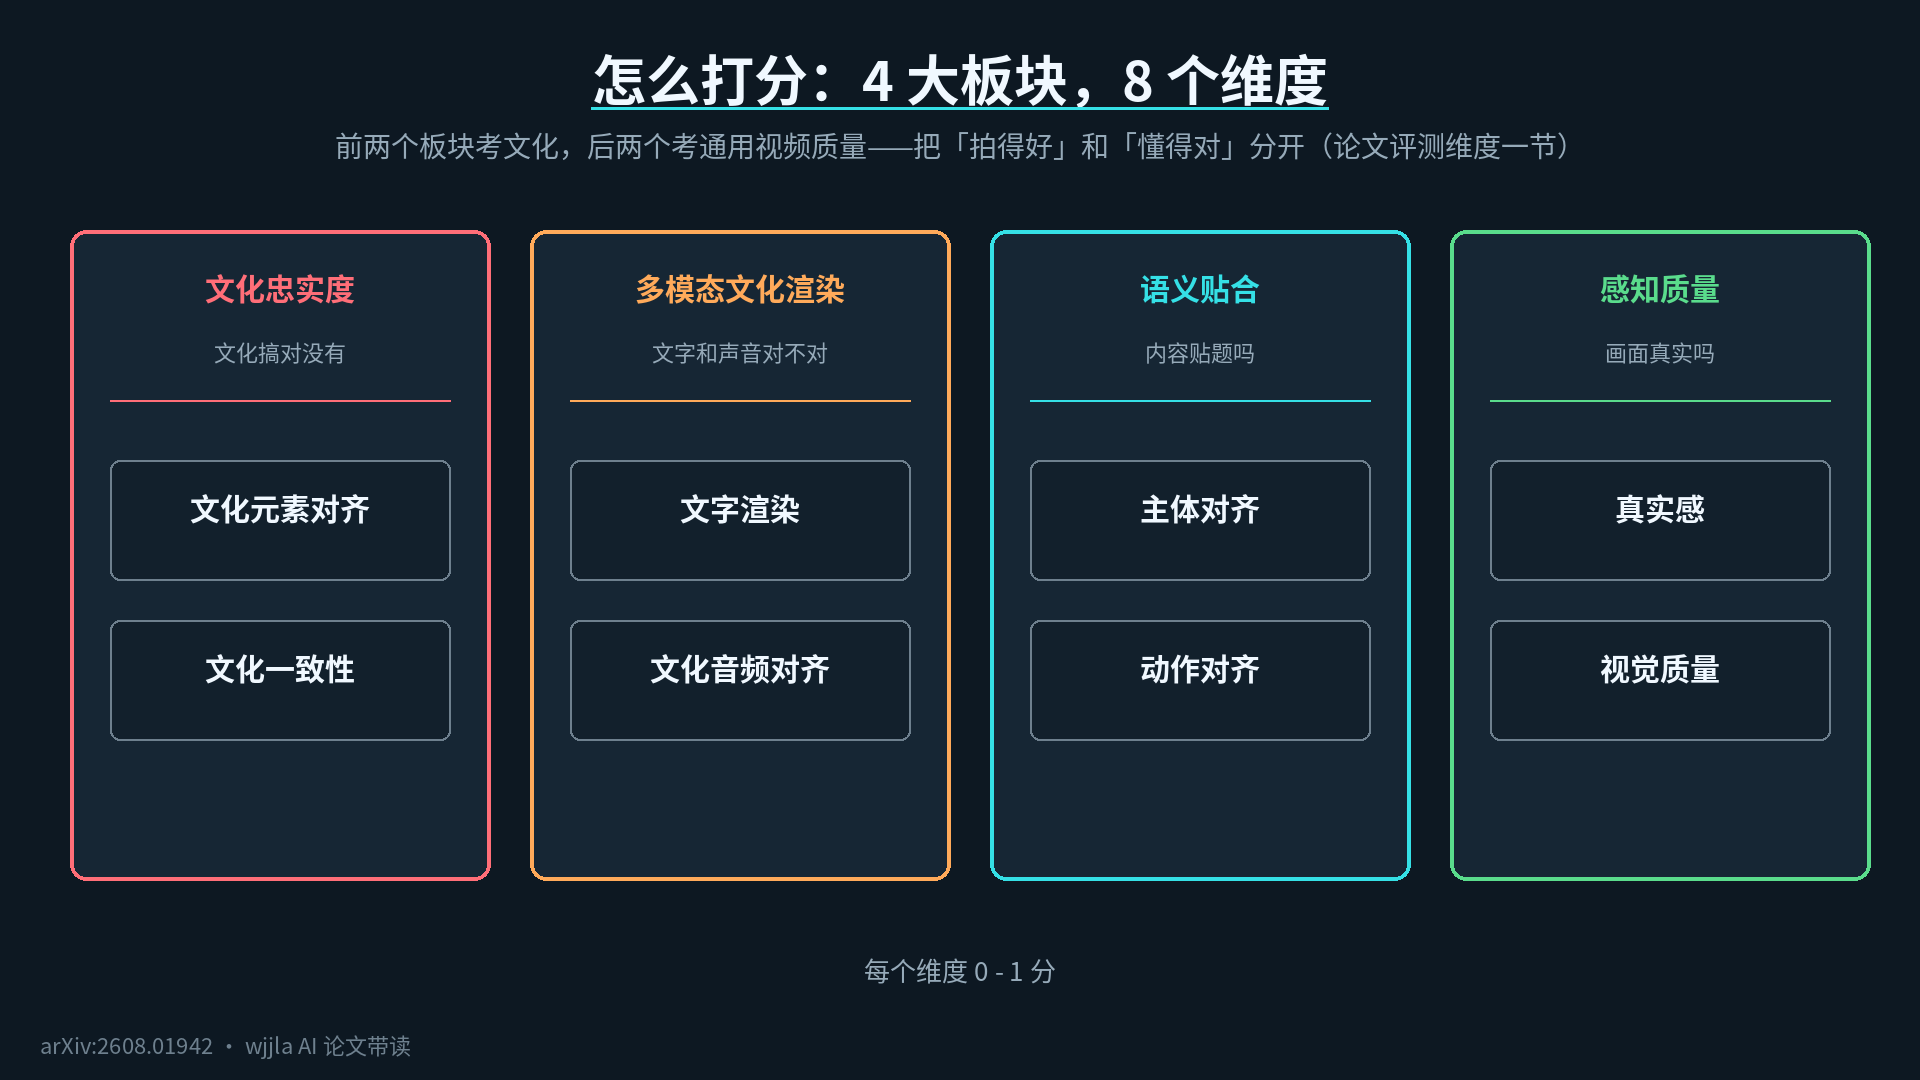
- Ist die Kultur richtig dargestellt?(Kulturelle Authentizität): Sind die erforderlichen kulturellen Elemente vorhanden (Kulturelle Elemente passen zusammen)? Sind fremde Elemente eingeflossen (Kulturelle Konsistenz)?
- Ist das Video selbst gut?(Semantische Übereinstimmung + Wahrgenommene Qualität): Passt der Hauptinhalt und die Aktionen zum Thema? Sind die Bilder authentisch?
Jeder Punkt wird von 0 bis 1 vergeben. Ein weiterer Abschnitt befasst sich mit der multimodalen kulturellen Darstellung: Texte auf Bildern, Hintergrundgeräusche – chinesische Schriftzeichen auf Schildern in japanischen Szenen, traditionelle Musik bei Hochzeiten – all das findet sich in dieser Kategorie. Die Trennung von Text und Geräuschen ist ein besonderes Merkmal dieser Prüfung, das später zu großen Problemen führen könnte.
Die Jury besteht aus zwei Teilen. Die menschlichen Juroren wählten 168 Fragen aus (14 Aspekte × 12 Länder), wobei jede Frage von drei einheimischen Zuschauern mit einer Bewertung von 5 Punkten bewertet und dann im Durchschnitt berechnet wurde – dies ist kostspielig, aber der Goldstandard. Die KI-Juroren verwendeten das vom Autor entwickelte zielgerichtete (target-explicit) Protokoll, was bedeutet, dass die KI nicht nach Gefühl bewerten darf: Zuerst wird ihr gesagt, worum es in der Frage geht, dann sucht sie nur nach relevanten Beweisen im Video, und schließlich bewertet sie basierend auf den Beweisen. Ob dieses Protokoll haltbar ist, wird anhand einer speziellen Tabelle überprüft.
Zeugnisse: Es gibt einen großen Unterschied zwischen Open Source und Closed Source.
Die Tabelle 1 auf Seite 6 ist die wichtigste Tabelle im gesamten Dokument. Betrachten wir zunächst die Bewertungen von echten Personen in der Spalte „Kulturelle Elemente“:
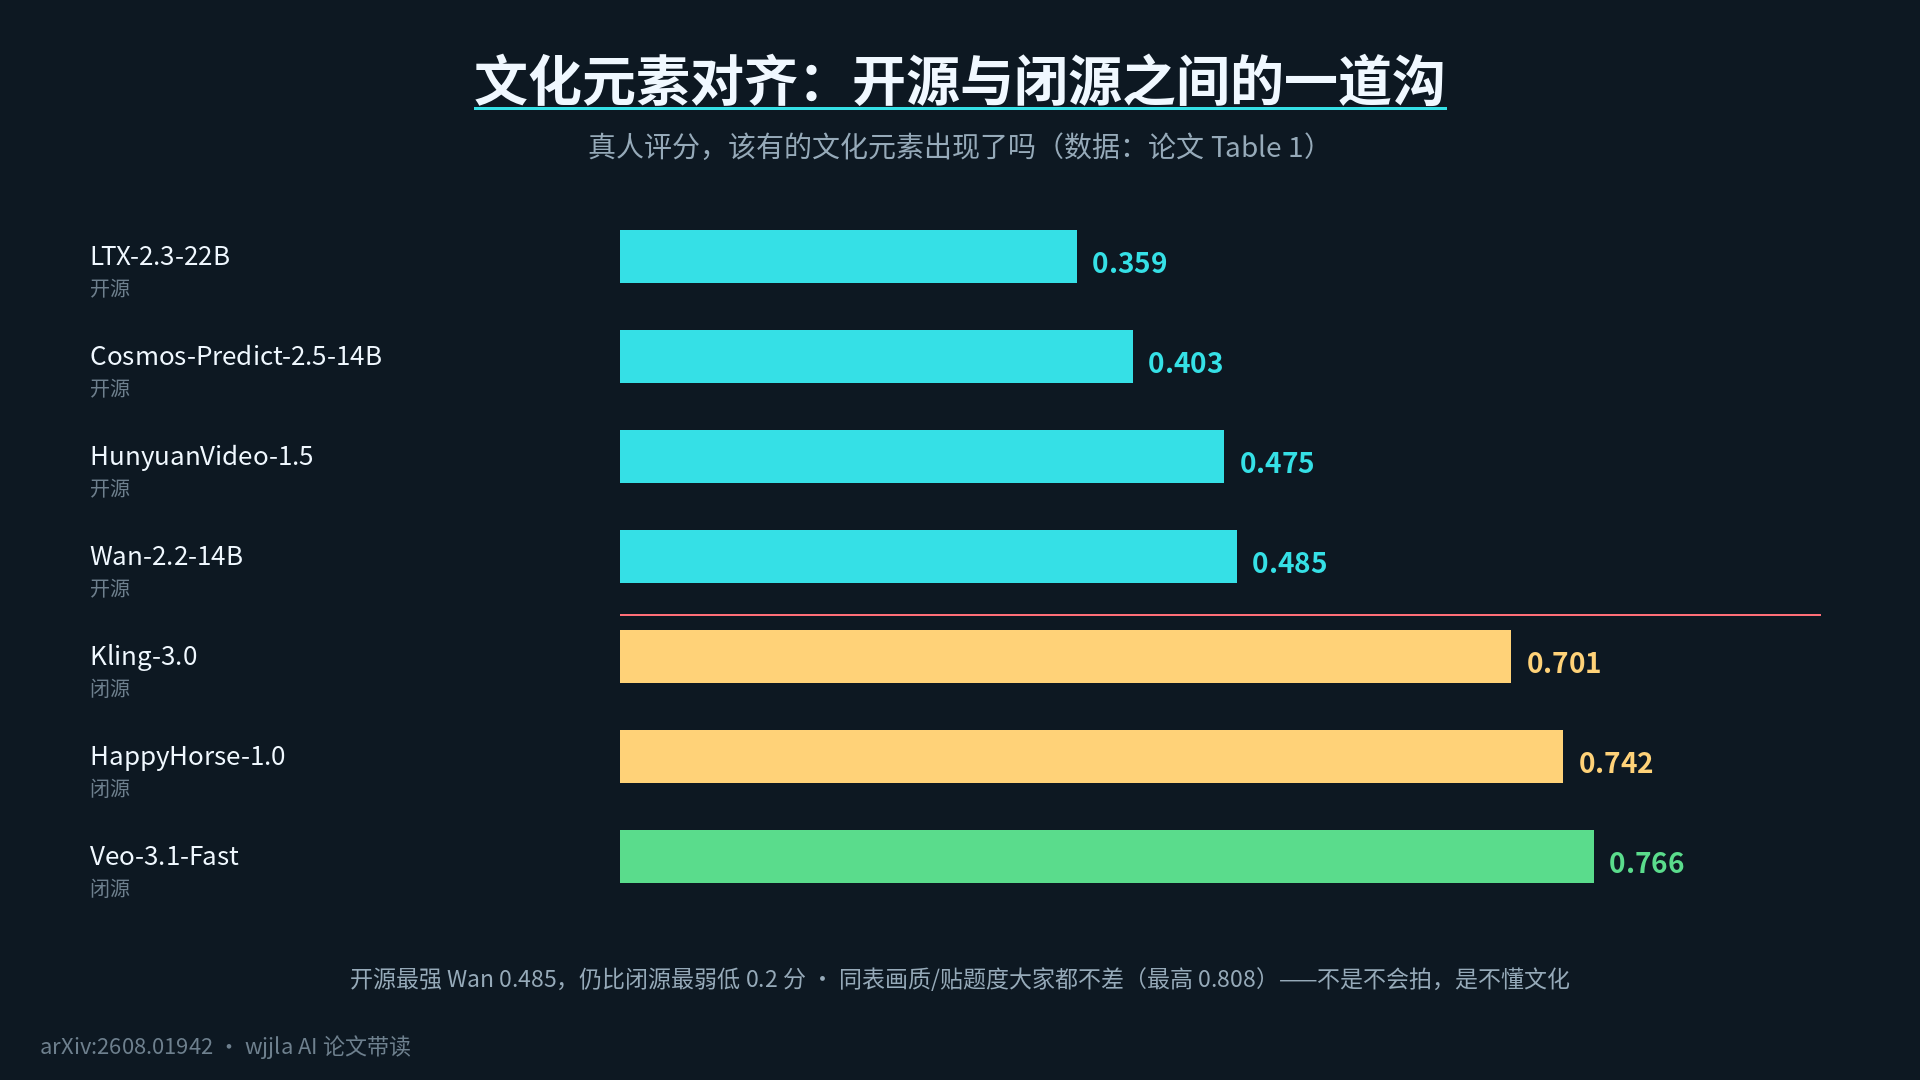
Die vier Open-Source-Modelle liegen alle zwischen 0,359 und 0,485, während die drei Closed-Source-Modelle direkt auf 0,701 bis 0,766 springen. Der Höchstwert ist 0,766 für Veo-3.1-Fast, 0,742 für HappyHorse-1.0 und 0,701 für Kling-3.0; das stärkste Open-Source-Modell, Wan-2.2-14B, erreicht nur 0,485 und liegt damit 0,2 Punkte unter dem schwächsten Closed-Source-Modell. Ein deutlicher Unterschied, der mit bloßem Auge erkennbar ist.
Aber dieselbe Tabelle enthält eine weitere wichtige Information: Die allgemeinen Fähigkeiten wie Bildqualität und Relevanz für das Thema sind bei allen ziemlich gut und liegen im Allgemeinen über 0,49, wobei der Höchstwert bei 0,808 liegt. Wenn man die beiden Dinge zusammen betrachtet, ist die Schlussfolgerung eindeutig –die Modelle können keine Videos aufnehmen, weil sie die Kultur nicht verstehen. Kulturelle Unterschiede und schlechte Generierungsfähigkeiten sind zwei verschiedene Dinge, und genau deshalb werden sie in diesem Test separat getestet.
Die schlechteste Spalte im gesamten Dokument: Text-Rendering
In Tabelle 1 gibt es noch eine Spalte, die noch schlimmer ist als die kulturelle Ausrichtung: die Rendering von Bildtexten.
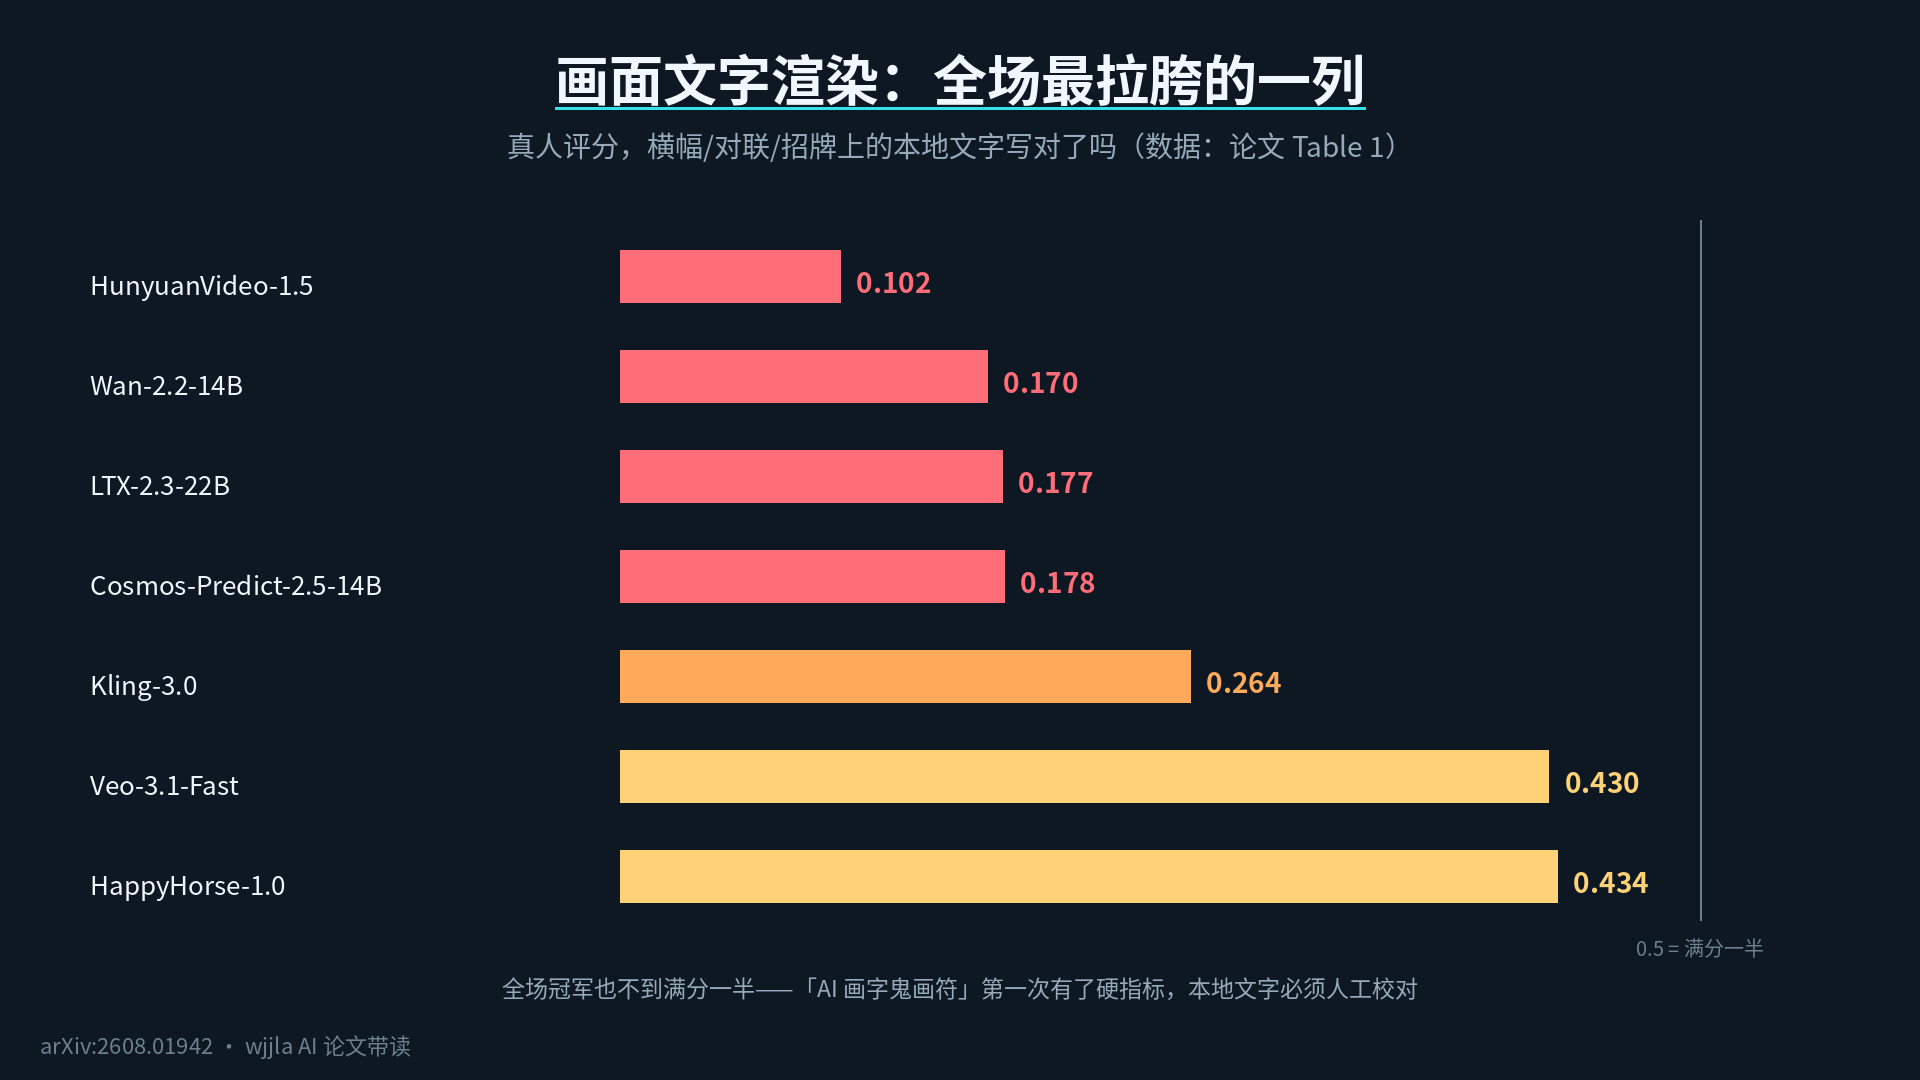
Die höchste Punktzahl der Open-Source-Gruppe für Cosmos-Predict-2.5-14B beträgt nur 0,178, und für HunyuanVideo-1,5 sogar nur 0,102; die Closed-Source-Gruppe schneidet etwas besser ab, mit einer Höchstpunktzahl von 0,434 für HappyHorse-1 – und der Gesamtsieger erreicht nicht einmal die Hälfte der maximalen Punktzahl. Die KI schafft es nicht, lokale Schriftzeichen auf Bannern, Gedichten und Schildern korrekt zu schreiben. Das Online-Phänomen „KI schreibt unverständliche Schriftzeichen“ hat nun erstmals konkrete Zahlen. Praktische Schlussfolgerung: Wenn Videos lokale Schriftzeichen enthalten, sollten Sie diese vor der Veröffentlichung unbedingt manuell korrigieren – kein Modell kann dies derzeit für Sie übernehmen.
Können wir den KI-Juroren vertrauen? Die Wette von Tabelle 2
Die Verwendung von KI als Juror dient dazu, die Bewertung zu skalieren (die Bewertung von 168 Fragen durch echte Menschen erfordert bereits eine hohe Investition), aber kann man den Bewertungen von KI vertrauen? Tabelle 2 beantwortet diese Frage mit dem nationalen Durchschnittswert von Kendall τ und Spearman ρ – je näher der Wert bei 1 liegt, desto konsistenter sind die Bewertungen von KI und Menschen.
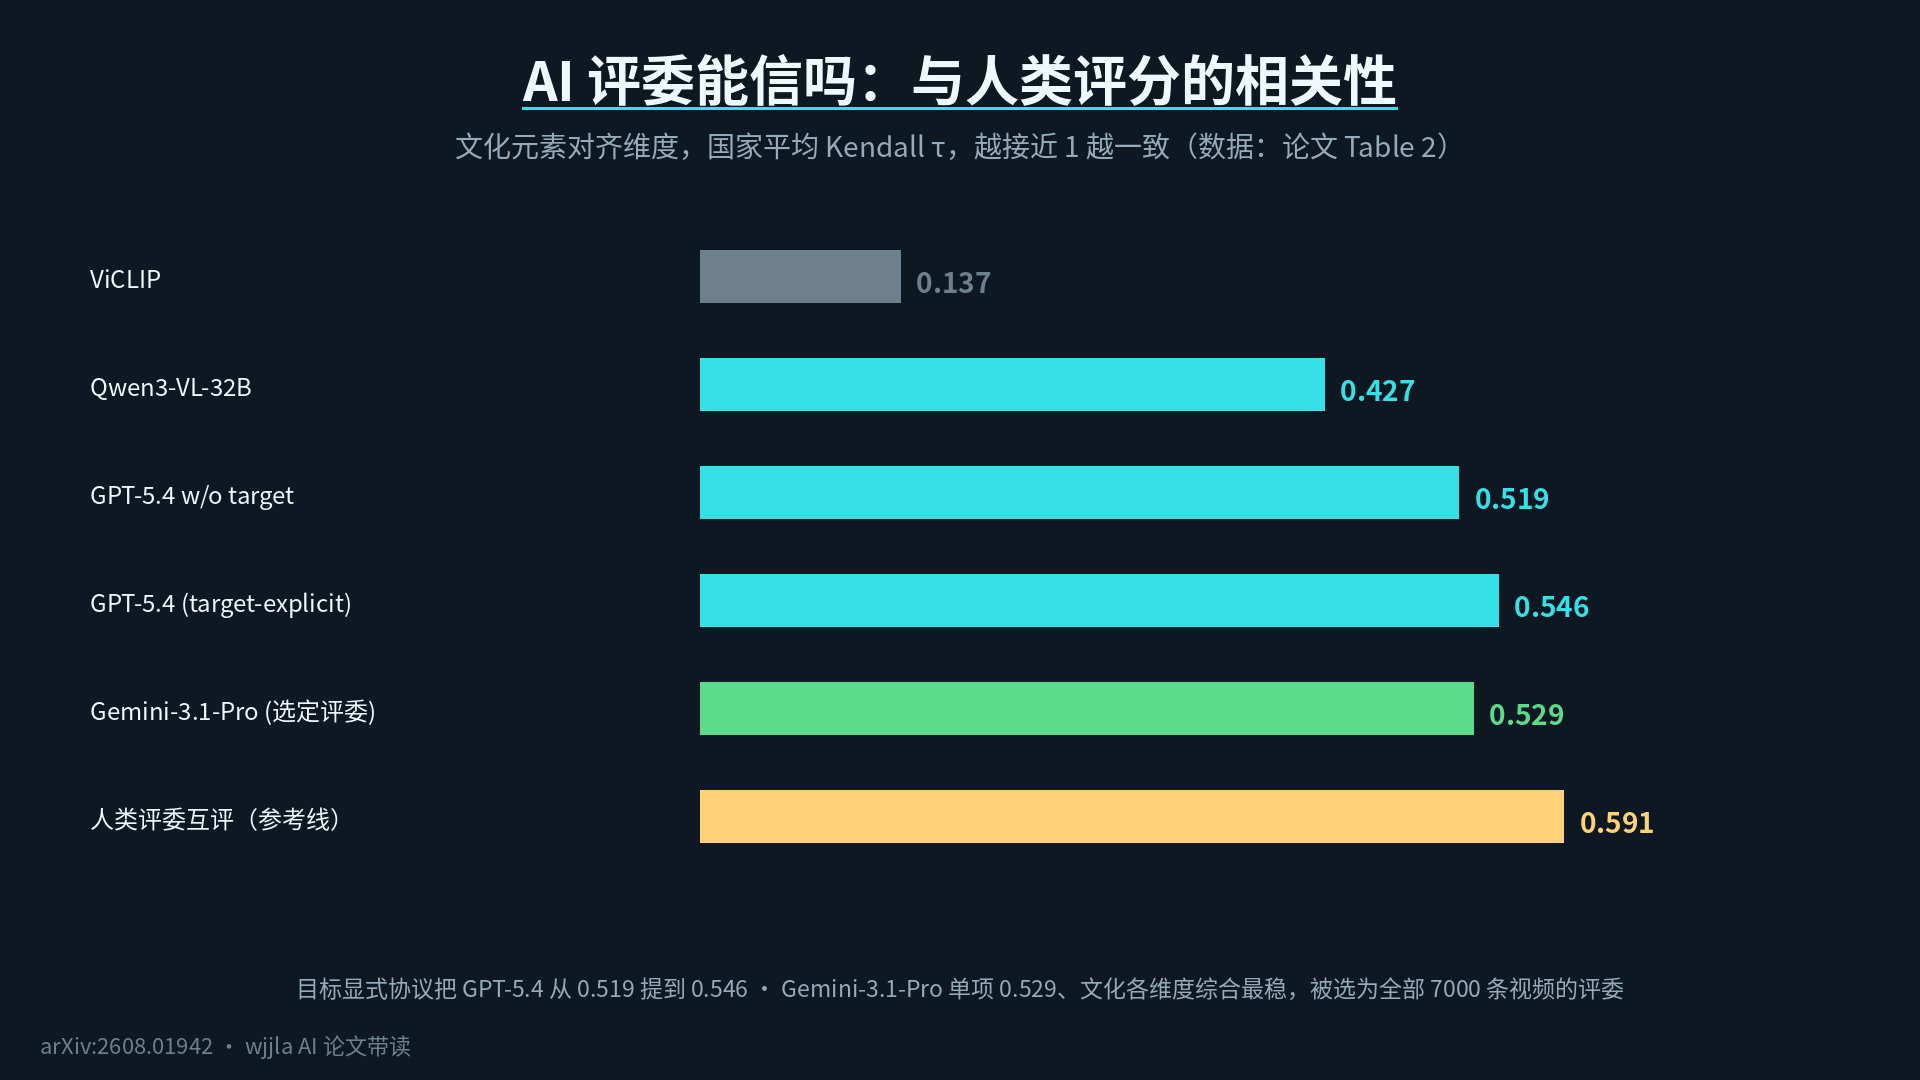
Die kleinen Modelle funktionieren nicht sehr gut: Die Bild-Text-Ähnlichkeit des kleinen Modells ViCLIP beträgt nur 0,137, während sie bei Qwen3-VL-32B auf 0,427 steigt. Nach der Verwendung des expliziten Zielprotokolls in GPT-5.4 steigt die Ausrichtung der kulturellen Elemente von 0,519 auf 0,546, was zeigt, dass das Protokoll tatsächlich effektiv ist. Der von den Autoren schließlich ausgewählte Bewerter ist Gemini-3.1-Pro: Er erreicht 0,529. Obwohl die einzelnen Werte etwas niedriger sind als bei GPT-5.4, ist die Gesamtwertung für alle kulturellen Dimensionen am stabilsten (Kulturelle Konsistenz 0,521, Textrendering 0,527). Die Autoren verwendeten ihn, um alle 7.000 Videos zu bewerten.
Die wichtigste Referenzlinie ist die Korrelation zwischen den menschlichen Bewertern: 0,591. Das bedeutet, dass die besten KI-Bewerter in Bezug auf die kulturelle Dimension bereits nahezu die gleiche Übereinstimmung erreicht haben wie menschliche Bewerter – die Bewertung der Kultur hat sich von „es muss ein Mensch sein“ zu „es kann zuerst von der KI überprüft werden“ geändert. Eine Enttäuschung sind jedoch subjektive Dimensionen wie Realismus und visuelle Qualität, bei denen die Konsistenz unter den Menschen selbst gering ist und die KI hier auch keine guten Ergebnisse erzielen kann. Solche Bewertungen sollte man also eher als Anhaltspunkt betrachten.
Zwischen Nationen: Eine Kluft von 0,3 Punkten
Auf Seite 7 zeigt Abbildung 5 die Punktzahl nach Ländern aufgeteilt. Diese Tabelle (mit genauen Zahlen im Anhang) ist wahrscheinlich die für Praktiker nützlichste Seite des gesamten Textes:
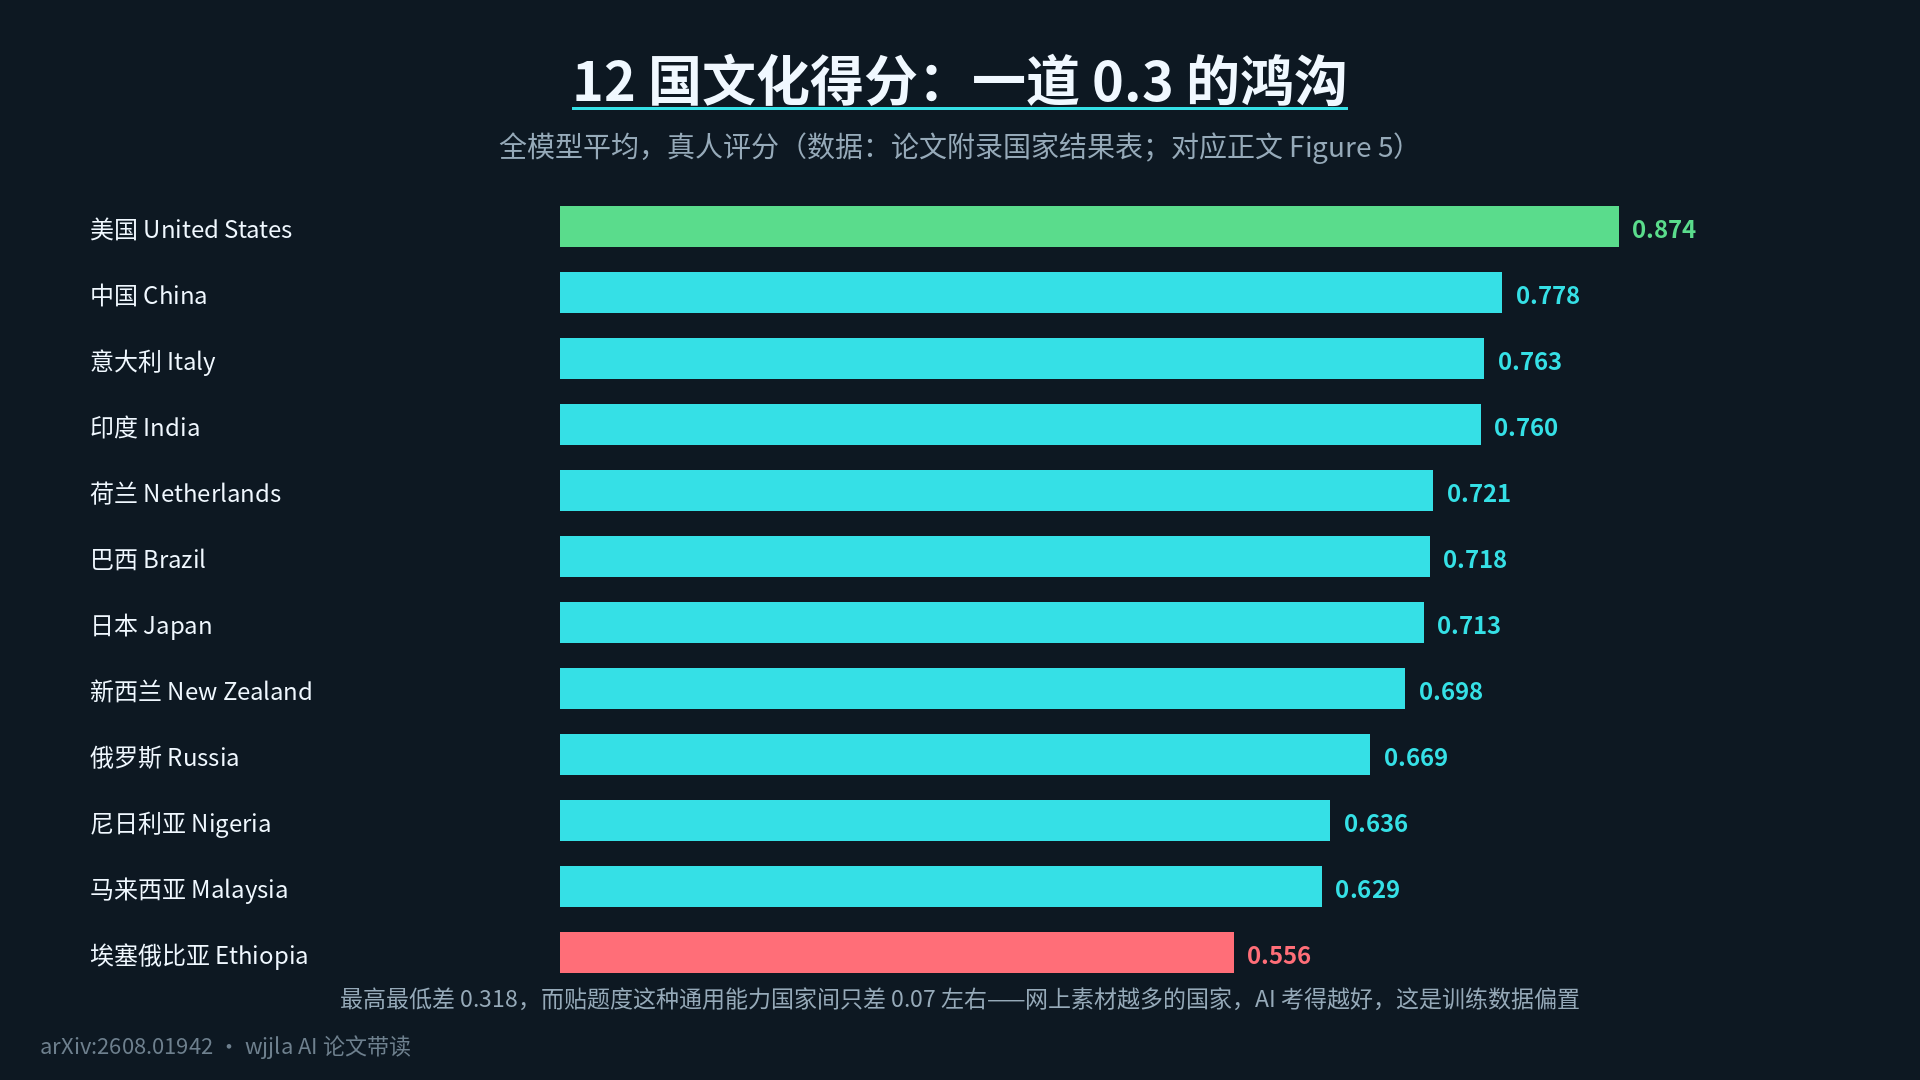
Die Vereinigten Staaten liegen mit 0,874 fast an der Spitze der Liste, gefolgt von China mit 0,778, Italien mit 0,763, Indien mit 0,760; danach kommen die Niederlande mit 0,721, Brasilien mit 0,718, Japan mit 0,713 und Neuseeland mit 0,698; gefolgt von Russland mit 0,669, Nigeria mit 0,636 und Malaysia mit 0,629; und zum Schluss liegt Äthiopien mit 0,556 am Ende der Liste.
Die Differenz zwischen dem höchsten und dem niedrigsten Wert beträgt mehr als 0,3. Der Autor berechnete auch die Streuung der verschiedenen Dimensionen zwischen den Ländern: Die Dimensionen der kulturellen Ausrichtung liegen bei etwa 0,3, während die Allgemeinheit, wie zum Beispiel die Fähigkeit, auf den Punkt zu kommen, nur um etwa 0,07 abweicht. Das heißt, alle Modelle können „zwei Menschen, die Schach spielen“ relativ gut erkennen, aber bei kulturellen Details wie der äthiopischen Schulterbegrüßung oder dem japanischen Shogi öffnet sich die Punktzahl sofort. Die Regel ist so offensichtlich, dass sie fast schon schmerzt:Je mehr Online-Material ein Land hat, desto besser schneidet die KI ab. Es geht nicht darum, ob das Modell intelligent ist, sondern um die Verzerrung der Trainingsdaten.
Abbildung 6 fügt noch hinzu: Open-Source-Modelle verlieren in Ländern mit geringen Ressourcen wie Äthiopien, Malaysia und Nigeria noch stärker an Punkten, während Closed-Source-Modelle ebenfalls an Punkten verlieren, aber aufgrund ihrer stärkeren Ausgangsposition nach dem Verlust immer noch führend sind.
Was ist am schwierigsten zu fotografieren: Objekte sind einfach, Prozesse sind schwierig.
Abbildung 8 zeigt die 14 Aspekte nach Kulturgruppen geordnet: Die materielle Kultur erzielte die höchste Gesamtpunktzahl, gefolgt von sozialen Praktiken und Aufführungen, während Rituale und Zeremonien am schwierigsten waren. Der Rückgang der Kulturpunkte im Vergleich zu den Semantikpunkten reichte von -15,6 % bei Feierlichkeiten bis hin zu -30,9 % bei Kleidung.
Die Logik ist sehr einfach: Das Fotografieren eines Objekts ist ein statisches visuelles Problem, während das Fotografieren einer ganzen Reihe von zeitlichen und räumlichen Abläufen mit einer Abfolge von Ereignissen und Interaktionen eine Schwierigkeit auf einer ganz anderen Ebene darstellt.
Die Fehlschläge in Abbildung 7 sind der beste Beweis dafür: Das japanische Shogi, HappyHorse-1.0. Die Szene ist richtig, aber die Schriftzeichen auf den Figuren sind alle falsch; die äthiopisch-orthodoxe Kreuzigung, bei der alle Modelle die Handgesten mit den Fingerspitzen nicht richtig darstellen konnten; die Dekorationen zum Hari Raya in Malaysia, die HunyuanVideo-1.5 direkt im Weihnachtsstil gerendert hat – Muster aus einer Kultur mit hohem Ressourcenaufwand haben die Szenen einer Kultur mit geringem Ressourcenaufwand „übernommen“.
Einige Punkte, an die man sich nach dem Lesen erinnern sollte
Erstens,betrachten Sie nicht die Gesamtpunktzahl als Fähigkeit. Der größte methodische Beitrag dieser Arbeit besteht darin, „gute Bilder“ und „gutes Verständnis“ getrennt zu bewerten. Ein Modell mit einer Bildqualität von 0,8 und einer Kultur von 0,4 eignet sich hervorragend für lokale Inhalte, ist aber ein Misserfolg, wenn es um internationale Inhalte geht. Die Auswahl des Modells hängt davon ab, was Sie erreichen wollen.
Zweitens istdie Führungsposition von Closed Source zwar real, sollte aber nicht überbewertet werden. 0,766 bedeutet, dass selbst der Spitzenreiter im Bereich Closed Source mehr als 20 % der kulturellen Elemente nicht richtig erfasst hat; Textrendering mit 0,434 zeigt zudem, dass kein Modell für die gesamte Wertschöpfungskette eingesetzt werden kann. Bei multikulturellen Projekten ist die lokale Prüfung unverzichtbar.
Drittensist die Ländertabelle der Punktzahlen sammelbar. Wenn Sie Inhalte für einen bestimmten Markt erstellen, sollten Sie zuerst die Punktzahlen des jeweiligen Landes überprüfen: In Märkten mit hohen Ressourcen wie den Vereinigten Staaten, China und Indien können Sie sich auf die Hauptmodelle verlassen; In Märkten wie Äthiopien und Malaysia bedeuten Punktzahlen zwischen 0,55 und 0,63, dass fast die Hälfte der kulturellen Details falsch ist und manuell nachgebessert werden muss. Der Autor bietet keine weitere Ursachenanalyse außer der vollständigen Matrix jedes Modells für jedes Land an, z. B. ob die Menge der Trainingsdaten oder das Datenverhältnis ausschlaggebend sind; dies wird in der Arbeit nicht näher ausgeführt.
Viertens istdie Richtung der KI-Juroren wichtiger als diese Punktzahl. Eine Bewertung im Umfang von 1.000 Fragen × 7 Modellen wäre für einen Menschen niemals machbar. Das explizite Zielprotokoll (erst Ziele aufstellen, dann Beweise suchen und schließlich bewerten) bringt die Relevanz der KI-Juroren auf ein Niveau, das dem gegenseitigen Bewerten durch Menschen nahekommt, und dieser Ansatz wird wahrscheinlich zum Standard für die nächste Welle von multimodalen Bewertungen werden.
Zusammengefasst: Was das Filmen von Videos betrifft, hat KI ihren Abschluss bereits gemacht; was das Verständnis von Kultur betrifft, muss sie noch Nachhilfeunterricht nehmen – und diese Arbeit liefert den ersten Zeugnisbericht über den Fortschritt dieses Nachhilfeunterrichts.
Abhandlung: CultureVidBench: Benchmarking des kulturellen Verständnisses bei der Generierung von Text zu Video arXiv: https://arxiv.org/abs/2608.01942 Projekt-Homepage: https://hanxjing.github.io/CultureVidBench/