Wang & Zahl, Volumenschätzungen für Vereinigungen von konvexen Mengen und die Kakeya-Vermutung in drei Dimensionen, arXiv 2502.17655v1 (eingereicht am 26. Februar 2025, 127 Seiten). Zusammenfassung: Es wurde nachgewiesen, dass die Dimension der Kakeya-Menge in drei Dimensionen = 3 ist, und nebenbei wurden auch die Tube Doubling-Vermutung in drei Dimensionen und Keletis Vermutung über die Verlängerung von Liniensegmenten bewiesen. Ich habe diesen Artikel vom Abstract bis zu §12 sorgfältig gelesen und dabei alle „magisch klingenden“ Fachbegriffe erläutert.
- Einleitung: Zwei Autoren und eine Frage, auf die seit 108 Jahren gewartet wird.
Die Autoren sind Hong Wang und Joshua Zahl. Wang Hong ist Professor am Courant-Institut der New York University und ständiger Professor am IHES. Er machte im Jahr 2011 seinen Bachelor-Abschluss an der Peking-Universität und promovierte am MIT unter Larry Guth; Zahl ist am Mathematik-Department der University of British Columbia tätig. In den letzten drei Jahren haben die beiden eine Trilogie veröffentlicht und ein fast ein Jahrhundert altes geometrisches Problem von „fast gelöst“ zu „vollständig bewiesen“ weiterentwickelt. Wang Hong wurde kürzlich mit dem Fields-Medaille 2026 ausgezeichnet.
Die Geschichte beginnt 1917 in Japan. Sōichi Kakeya stellte eine Frage, die scheinbar auch ein Grundschüler verstehen könnte:Was ist die kleinste Fläche, die ein Nadelspitze beim Drehen einer Nadel (einer einheitlichen Liniensegment) auf einer Ebene abschneidet?Später wurde diese Frage zum Kakeya-Ansatz erweitert: Eine kompakte Menge wird als Kakeya-Menge bezeichnet, wenn siejede Einheitslinie in jeder Richtungenthält. Davies bewies 1971, dass die Minkowski- und Hausdorff-Dimensionen der Kakeya-Menge in zwei Dimensionen immer 2 betragen (volle Dimension). Aber für mehr als drei Dimensionen blieb es ein Problem – ein Problem, das mehr als ein halbes Jahrhundert lang ungelöst blieb.
Sie können sich das auch so vorstellen:Die Kakeya-Menge ist wie ein „Parkplatz, auf dem Autos in jede Richtung wenden können“– für jede Richtung muss es einen „Parkplatz“ geben, auf dem ein Auto parken kann, auch wenn dieser Parkplatz nur so dünn wie eine Nadel ist, aber die Richtung muss 360° abdecken. In zwei Dimensionen können Sie sich diesen Parkplatz leicht als einen normalen Kreis vorstellen; aber sobald Sie auf drei Dimensionen umsteigen, wird es ungewöhnlich schwierig, da für jede Richtung eine „dreidimensionale Richtungsnadel“ vorhanden sein muss, in die das Auto hineinpassen.
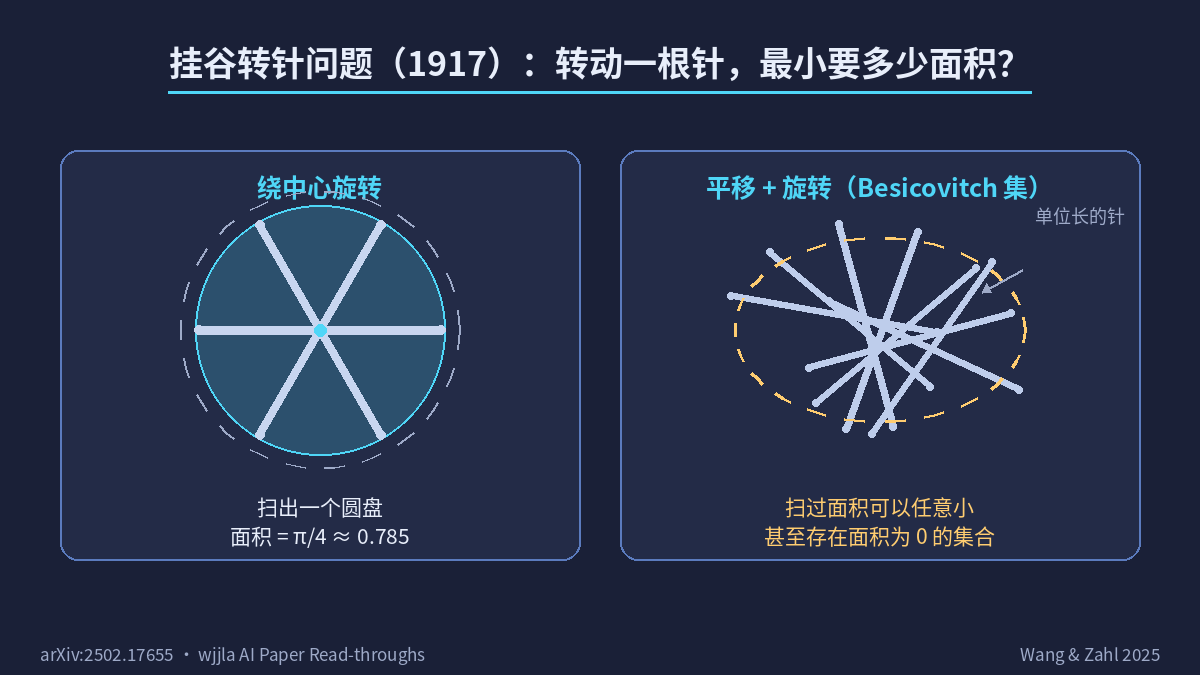
Das obige Bild ist der ursprüngliche Anstoß für das Problem: Die Fläche, die durch eine Drehung abgetastet wird, scheint intuitiv kreisförmig zu sein, aber tatsächlich gibt es eine „blattförmige“ Fläche, die noch kleiner ist – je geschickter Sie drehen, desto näher kommt die abgetastete Fläche an 0 heran – Besicovitch hat eine solche Konstruktion mit einer beliebig kleinen oder sogar null Fläche vorgeschlagen (Abschnitt 1.6 der Arbeit erwähnt Besicovitchs Konstruktion in R², siehe L664). Aber die Dimensionsvermutung fragt umgekehrt: Wenn ein Satz „in jede Richtung eine Nadel aufnehmen kann“, muss die Dimension dieses Satzes 3 sein.
Warum ist „Dimension = 3“ an sich eine ungewöhnliche Behauptung?Hier sollten wir kurz innehalten und den Begriff „Dimension“ erklären.
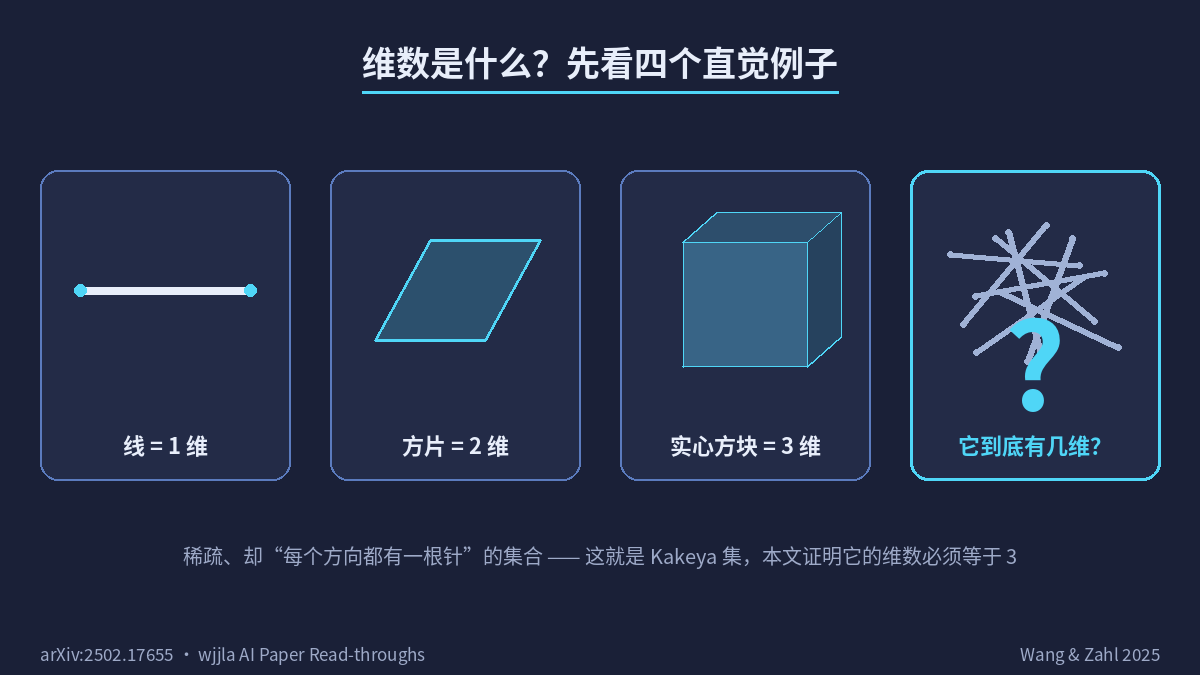
Die intuitivste Version: „Vergrößern Sie eine Menge um den Faktor ε und schauen Sie, wie groß sie „aussieht“.Die Dimension misst nicht die Größe, sondern die „Dicke“– also in wie vielen unabhängigen Richtungen die Menge „den Raum ausfüllt“. Eine dünne Linie ist eindimensional (sie erstreckt sich nur in einer Richtung), ein dünnes Blatt Papier ist zweidimensional (es erstreckt sich in zwei Richtungen) und ein fester Würfel ist dreidimensional (er füllt drei Richtungen aus). Die Kakeya-Vermutung besagt „Dimension = 3“: Eine Menge, die „in jeder Richtung“ mit Nadeln gefüllt ist, muss in drei unabhängigen Richtungen „ausreichend ausgefüllt“ sein, und sie kann nicht zu einem zweidimensionalen Flächenstück, einer eindimensionalen dünnen Linie oder einer Ansammlung von punkten zusammengepresst werden.
Die Frage „Warum können Nadeln mit unterschiedlichen Richtungen nicht in ein Blatt Papier gesteckt werden?“ ist also der Kern des Problems. Geometrisch betrachtet ist das nicht intuitiv, aber mathematisch konnte niemand dies seit Jahrzehnten ausschließen.
II. Warum 3D ein Jahrhundert lang festgefahren war: Betrachten wir die „Halbzeitbilanz“ genauer.
Die Teilergebnisse der dreidimensionalen Kakeya-Vermutung werden in zwei Richtungen vorangetrieben: zum einen durch den harten Indikator „dimensionale Untergrenze“ und zum anderen durch das weiche Werkzeug „Struktursatz“.
Feste Grenzen: Wolff bewies 1995 in [27] (Rev. Mat. Iberoam. 11), dass die Hausdorff-Dimension der dreidimensionalen Kakeya-Menge mindestens (n+2)/2 = 5/2 beträgt; später fügten Katz, Laba und Tao (in der Arbeit [16]) auf dieser Grundlage eine kleine konstante Zahl c hinzu und erreichten 5/2 + c. Diese Grenze gibt den „absoluten Untergrenzwert“ an, der numerisch noch weit von 3 entfernt ist.
- Soft Creative Tools * *: Ab etwa 2000 wurde Bennett-Carberry-Tao multilineare Kakeya-Theorem ([1]) besagt, dass jedes “Gegenbeispiel” planar “sein muss - die Nadeln müssen ungefähr in der Nähe einer Ebene liegen, wenn sie zusammen gestapelt werden; Guth ([9]) verwendet seine berühmte” Kornzerlegung “, um zu sagen, dass das Gegenbeispiel” körnig “sein muss - die Nadeln können in quaderförmige Teilchen organisiert werden; aber * * der wichtigste Klebering wurde geklebt * *: Können Sie sagen, das Gegenbeispiel ist planar + körnig + klebrig, dann was? Karte hier.
Im Jahr 2014 erläuterte Terence Tao in einem Vortrag und einem Blogartikel ([24]) das Katz-Tao-Programm in drei Schritten: Zuerst wird bewiesen, dass Gegenbeispiele zwangsläufig eine von drei Strukturen aufweisen müssen: planar, körnig oder klebrig; im zweiten Schritt werden diese Strukturen „multiskaliert“, um eine immer detailliertere Beschreibung zu erhalten; und im dritten Schritt werden diese multiskalierten Strukturen mit Hilfe der diskretisierten Summenprodukt-Werkzeuge von Bourgain „widerlegt“.
Die beiden Artikel von Wang Hong und Zahl aus den Jahren 2022 und 2024 [25][26] übersprangen tatsächlich den ersten Schritt und führten direkt „die Annahme eines Gegenbeispiels als sticky ein und führten einen Widerspruch herbei“ sowie „die Annahme eines Gegenbeispiels mit einer Assouad-Dimension < 3 und führten herbei, dass es zwangsläufig sticky ist“. Allerdings fehlte für diese beiden Schritte noch ein Element: Die Assouad-Dimension könnte größer als die Minkowski-Dimension sein, sodass [25][26] die Möglichkeit einer Minkowski-Dimension < 3 nicht vollständig ausschlossen.
Die 127-seitige Arbeit füllt genau diese letzte Lücke: Sie nimmt nicht an, dass Gegenbeispiele „sticky“ sind, sondern beweist direkt, dass „wenn D(σ, ω) kompakt ist, müssen Gegenbeispiele zwangsläufig selbst sticky sein“, und führt dann zum Widerspruch mit dem sticky Kakeya-Theorem. Mit diesem Schritt ist der Beweis abgeschlossen, und es wird endgültig gezeigt, dass die Dimension der dreidimensionalen Kakeya-Menge gleich 3 ist.
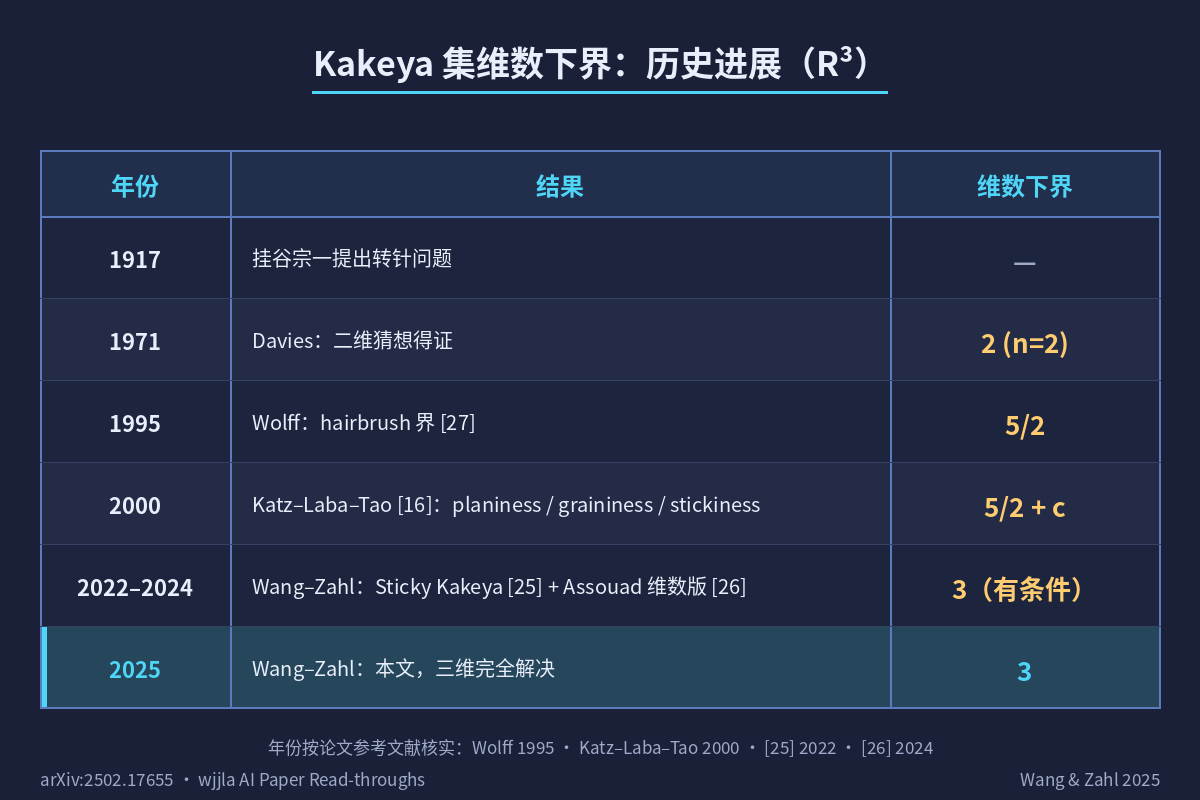
Die spezifische „frühere untere Grenze → aktuelle untere Grenze“-Spanne in Zahlen: von Wolffs 5/2 im Jahr 1995 über Katz-Laba-Taos 5/2 + c in den 2000er Jahren bis hin zum aktuellen Sprung direkt auf 3. Von Wolff bis zu dieser Arbeit lag der Bereich von (5/2, 3) für etwa 30 Jahre, der Anfang 2025 durch diese Arbeit vollständig überschritten wurde.
III. Der eigentliche Hauptakteur dieses Artikels ist die „Schätzung des Querschnitts und des Volumens von Rohren“, während Kakeya eine Folgerung ist.
Dies muss zuerst klar erläutert werden, da die Leser sonst von Fachbegriffen überwältigt werden könnten. Der Titel der Arbeit lautet Volumenschätzungen für Vereinigungen von konvexen Mengen und die Kakeya-Vermutung in drei Dimensionen. Kakeya ist nur eine Folgerung,die eigentlichen Haupttheoremesind Theorem 1.2 und Theorem 1.9 (letzteres führt zu Korollar 1.10), die Folgendes besagen:
Wenn man eine Menge von δ-Röhrchen (mit einem Durchmesser von δ und einer Länge von 1) nimmt und sie so zusammenfügt, dass sie sich nicht in irgendeinem konvexen Satz „überlappen“ (technisch gesehen als Wolff-Axiom oder Nicht-Clustering bezeichnet), dann ist das Volumen der so erhaltenen Menge „fast“ gleich dem Volumen der einzelnen Röhrchen zusammen – das heißt, die Röhrchen liegenfast nicht überlappendnebeneinander und es gibt keine großen Überlappungen.
δ-Röhrchenist ein wiederkehrendes Kernbegriff. Im Grunde ist es „ein 1 cm langes Nadelröhrchen mit einem Durchmesser von δ“. Um es mit dem Alltag zu vergleichen: Es ist wie einStrohhalm– der Strohhalm hat eine eigene Ausrichtung (Längsrichtung) und eine eigene Dicke (Durchmesser δ). Das „Volumen“ des gesamten Strohhalms beträgt δ² · 1 = δ² (Querschnittsfläche des dünnen Strohhalms multipliziert mit der Länge). Wenn δ sehr klein ist (der Strohhalm sehr dünn ist), ist das Volumen eines einzelnen Strohhalms δ² ebenfalls sehr klein; das Volumen von zehntausend dünnen Strohhalmen beträgt nur δ² · 10000 und scheint ebenfalls nicht groß zu sein – aber in der Arbeit soll bewiesen werden: Wenn die Strohhalme die Bedingung erfüllen, „sich nicht in irgendeinem konvexen Satz zu sammeln“, dann kann das Volumen der Vereinigung von zehntausend dünnen Strohhalmen nur ~10000 · δ² betragen und nicht mehr; das heißt, sie sind wirklich „fast nicht überlappend“ angeordnet, ohne große Überlappungen.
DasWolff-Axiomwurde nach Wolff benannt, der 1995 in seinem Artikel [27] diese „nicht konzentrierten“ Bedingungen einführte: Wenn Sie einen beliebigen Quader (Größe a × b × 2) um diese Rohre legen, darf die Anzahl der Rohre, die in den Quader passen, nicht viel größer sein als die Querschnittsfläche des Quaders × 1/δ². Mit anderen Worten, die Rohre dürfen nicht „zu einem Bündel zusammengefasst“ werden.
Übersetzt in Alltagssprache bedeutet diese Bedingung„Beschränkung der Kundenfrequenz im Supermarkt“.Stellen Sie sich zehntausend Strohhalme vor, die in einem riesigen Einkaufszentrum schweben, wobei jeder Strohhalm seine eigene Ausrichtung hat. Nach dem Wolffschen Axiom gilt: Wenn Sie einen beliebigen kleinen Kasten mit den Maßen a × b × 2 schneiden (der Querschnitt beträgt a × b), dann könnenhöchstens etwa a · b / δ² Strohhalmein diesen kleinen Kasten passen – der Querschnitt des Kastens bestimmt dieObergrenzefür die Anzahl der Strohhalme, unabhängig von deren Ausrichtung. Wenn Sie einen kleinen Kasten mit den Maßen 1 × 1 × 2 nehmen und plötzlich 100 Mal mehr Strohhalme hineinstecken, als der Querschnitt zulässt, verstoßen Sie gegen das Wolffsche Axiom. Das Wolffsche Axiom ist im Wesentlichen eine strenge Beschränkung der„Streuung“: Die Strohhalme dürfen sich nicht ansammeln.
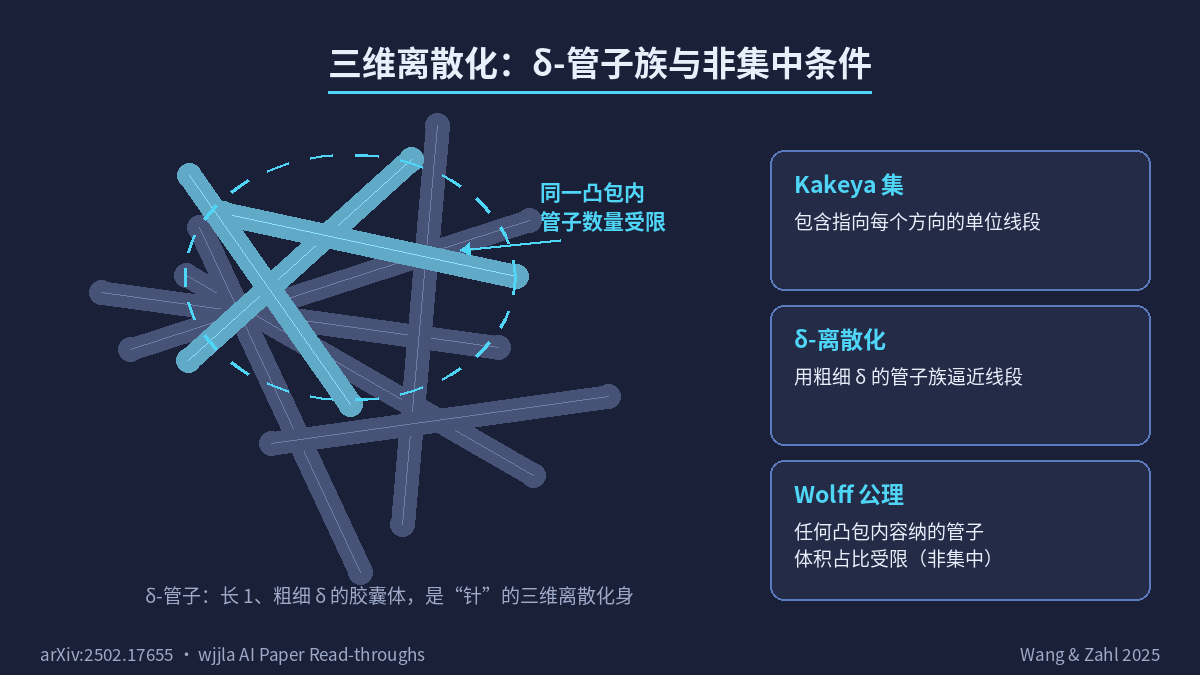
Eine intuitive Erklärung: Stellen Sie sich vor, Sie hätten Zehntausende von feinen Nadeln, eine in jeder Richtung. Der Wolffsche Axiom besagt, dass „diese Nadeln sich nicht plötzlich um das Hundertfache in einem kleinen Kästchen mit den Maßen a × b × 2 ansammeln werden“ – dies ist eine strenge Beschränkung der „Dispersion“.
Kakeya erfüllt genau diese Bedingung: Eine Nadel in jeder Richtung (Richtungen, die durch δ getrennt sind), also passt in jedes a × b × 2 große Quadrat im Einheitsball höchstens ~ab/δ² Nadeln (durch den Querschnitt bestimmt). Daher folgt Theorem 1.2 direkt aus Theorem 1.1 – das ist der Wert des „als Konsequenz“ im Titel der Arbeit.
- Kernkonzept in vier Schritten: Wolffsche Axiome → Zerlegung von konvexen Mengen → Zwei-Skalen-Körner → Drei Schritte → Skaleninduktion
Die gesamte Argumentationsstruktur auf 127 Seiten kann in vier Phasen zusammengefasst werden. Ich werde sie anhand der Abbildungen in der Arbeit selbst erläutern.
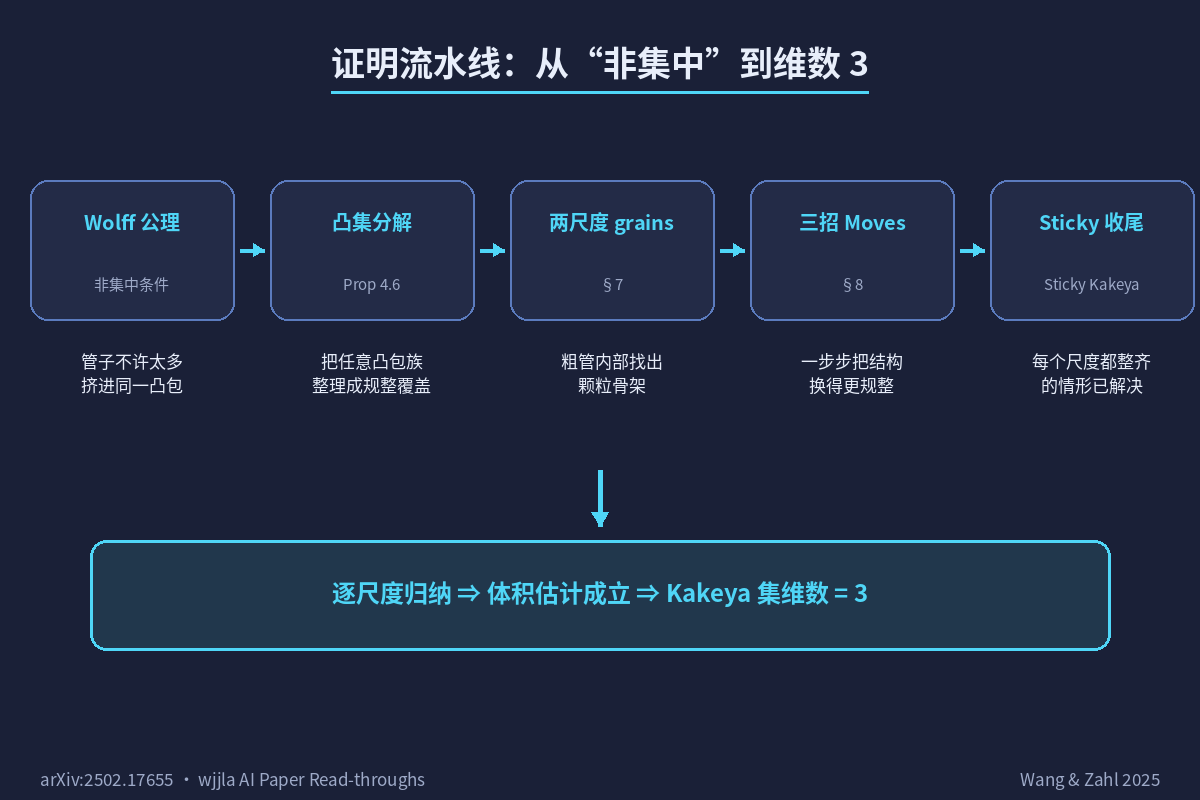
Die Abbildung zeigt die vier Phasen, die noch folgen werden: Die Wolffschen Axiome beschränken die Verteilung der Rohre → Die Decomposition von konvexen Mengen ersetzt die „Rohrfamilie“ durch „verpackte konvexe Mengen“ → Die Zwei-Skalen-Körner ordnen die Rohre zu rechteckigen Partikeln an → Die drei Moves „schieben“ die Partikel an ihren Platz → Die Skaleninduktion drückt den Wert von ω auf 0 herunter.Erinnern Sie sich an diese fünf Phasen, und die gesamte Arbeit wird nicht länger ein Wirrwarr von Fachbegriffen sein.
Schritt 1: Wolff’sche Axiome + Zerlegung von konvexen Mengen(§4)
Was wird in diesem Schritt getan: Zuerst wird „Rohr-Gruppe“ durch eine allgemeinere Sprache ersetzt – eine beliebige Gruppe äquivalenter konvexer Mengen.Warum ist das unvermeidbar: Weil die direkte Behandlung von δ-Rohren zu spezifisch ist, und die geometrischen Beziehungen zwischen „Rohren“ und „Rohren“, die sich überschneiden, schwer zu beschreiben sind; nach dem Wechsel zu konvexen Mengen können die Beweise anhand der „lineareren“ Beziehungen zwischen konvexen Mengen wie Inklusion, Überdeckung und Schnitt organisiert werden.
Definieren Sie zwei Wolff-Konstanten - die Katz-Tao-Konvexe-Wolff-Konstante (CKT-CW, die misst, „wie viele Elemente nicht in ein beliebiges konvexes Mengengefüge W passen“) und die Frostman-Slab-Wolff-Konstante (CF-SW, die misst, „wie viele Elemente nicht in ein Slab-Schnitt passen“). Die Frostman-Konstante „erbt nach oben“, die Katz-Tao-Konstante „erbt nach unten“ - diese Dualitätsbeziehung ist der Motor für alle nachfolgenden Zerlegungen. Der Satz 4.6 ist das wichtigste Werkzeug in dieser Phase: Für eine Familie von konvexen Mengen kann immer eine Familie von „verpackenden konvexen Mengen“ W gefunden werden, die sowohl von unten nach Frostman als auch von oben nach Katz-Tao mit einem Fehler K (absorbierbar) kontrolliert werden kann.
Beschreiben Sie jedes Symbol in einem Satz:CKT-CW ist ein normalisierter Indikator für „wie viele Rohre in dem konvexen Satz W enthalten sind“, und je kleiner der Wert ist, desto weniger Rohre drängen sich in W;CF-SW ist eine „dünne Scheibe“ mit der gleichen Bedeutung, nur dass es sich nicht um einen beliebigen konvexen Satz W handelt, sondern um eine dünne Scheibe (Slab) mit fester Dicke.Frostman-Erbschaft nach obenbedeutet, dass die Dispersion auf großer Skala auf feinere Unterskalen übertragen werden kann,Katz-Tao-Erbschaft nach untenumgekehrt – Dispersion auf feinem Maßstab kann grobe Skalen rückwirkend einschränken. Diese beiden dualen Beziehungen „nach oben und unten erben“ sind wie die beiden Enden einer Feder und sind der Motor, der alle nachfolgenden Zerlegungen antreibt.
Schritt 2: Aufschlüsselung der Grains in zwei Maßstäbe(§7)
Was wird in diesem Schritt getan: Nachdem in Schritt 1 der „verpackte Konvexmenge-Cluster“ erhalten wurde, wird jeder Konvexmenge-gefüllte Schlauch erneutstrukturiert– sie werden zu rechteckigen „Körnern“ (Grains) organisiert.Warum ist das unerlässlich: Weil die Beziehungen zwischen den Schlauchstücken zu komplex sind (jeder Schlauch zeigt in eine andere Richtung und überschneidet sich gegenseitig), während es zwischen den rechteckigen Körnern nur einfache Beziehungen gibt (enthalten/teilweise überlappend/nicht überlappend), was die Verarbeitung wesentlich erleichtert.
Dieser Schritt ist eine zweite Verbesserung der Idee der „Körner“ von Guth ([9]). In [9] zeigte Guth, dass unter der „weiten“ Annahme die Röhrenfamilie in rechteckige Partikel (genannt „Körner“) mit der Größe δ × t × t zerlegt werden kann, wobei t ≥ 1/√(#T) gilt. Die Arbeit wurde in einezweidimensionale Versionumgewandelt: Zuerst wird ein mittleres Maß ρ ausgewählt, und die δ-Röhren werden mit ρ-Röhren umhüllt; in jedem ρ-Röhren wird eine Körnerzerlegung durchgeführt, um Partikel mit der Größe δ/ρ × c × c zu erhalten; durch Rückskalierung erhält man eine Familie von Körnern mit der Größe δ × ρc × c, die als G bezeichnet werden. Das gleichzeitige Auftreten der beiden Maße (δ und ρ) ist die Voraussetzung für die späteren „drei Schritte“.
Das WortKörnerlässt sich im Alltag mitSüßigkeiten auf einem Stielvergleichen – kleine, gleich große Hagebuttenstücke (Körner) werden auf einen Bambusstiel (in Richtung des Stiels) aufgereiht, wobei die Längsseite der Körner entlang des Stiels verläuft.Warum sollte man den Stiel in Süßigkeiten auf einem Stiel zerlegen?Weil Süßigkeiten auf einem Stiel besser zu handhaben sind als ein Haufen lose Hagebutten: Sie können zählen, wie viele Süßigkeiten auf einem Stiel sind, wie viele Süßigkeiten in jeder Reihe sind und wie groß jede Süßigkeit ist – all diese „Größen“ und „Mengen“ können in Formeln eingegeben und geschätzt werden.
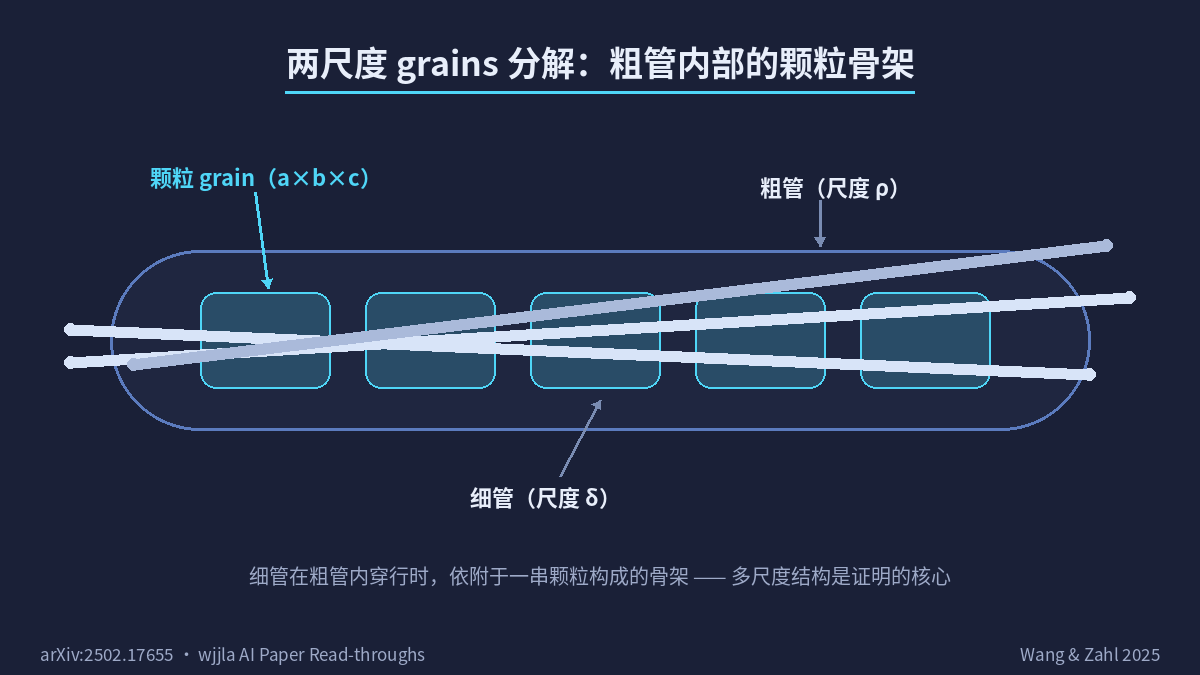
Die Größe des Partikels c ist nicht willkürlich festgelegt: c ≥ 1/√(#T[Tρ]) – die Partikelgröße ist umgekehrt proportional zu der Anzahl der δ-Röhren, die in Ihrer ρ-Röhre stecken. Je spärlicher sie sind, desto länger werden die Partikel gezogen. Diese Formelzeile (L950, §2.2) ist der Grundstein für alle nachfolgenden Größenordnungsschätzungen.Hier ist #T die Abkürzung für „Gesamtzahl der Röhren“, und Tρ ist „eine Teilmenge innerhalb eines bestimmten ρ-Röhrentemperaturbereichs“ – was diese beiden Symbole bedeuten, ist „die Partikelgröße auf der aktuellen Skala ist durch die Anzahl der feinen Röhren in der großen Röhre der vorherigen Skala begrenzt“.
Schritt 3: Drei Moves(§8)
Was wird in diesem Schritt getan: In Schritt 2 sind die erhaltenen Körner noch nicht „in Ordnung“ – einige sind zu lang, andere zu kurz und wieder andere zu schmal.Warum ist das unverzichtbar: Die spätere Skalareduktion hat strenge Anforderungen an die „Form“ der Körner (sechs Eigenschaften (i)–(vi)). Wenn diese drei Schritte nicht durchgeführt werden, erfüllen die Eingabedaten für die Reduktion nicht die Bedingungen, und der Beweis kann nicht fortgesetzt werden.
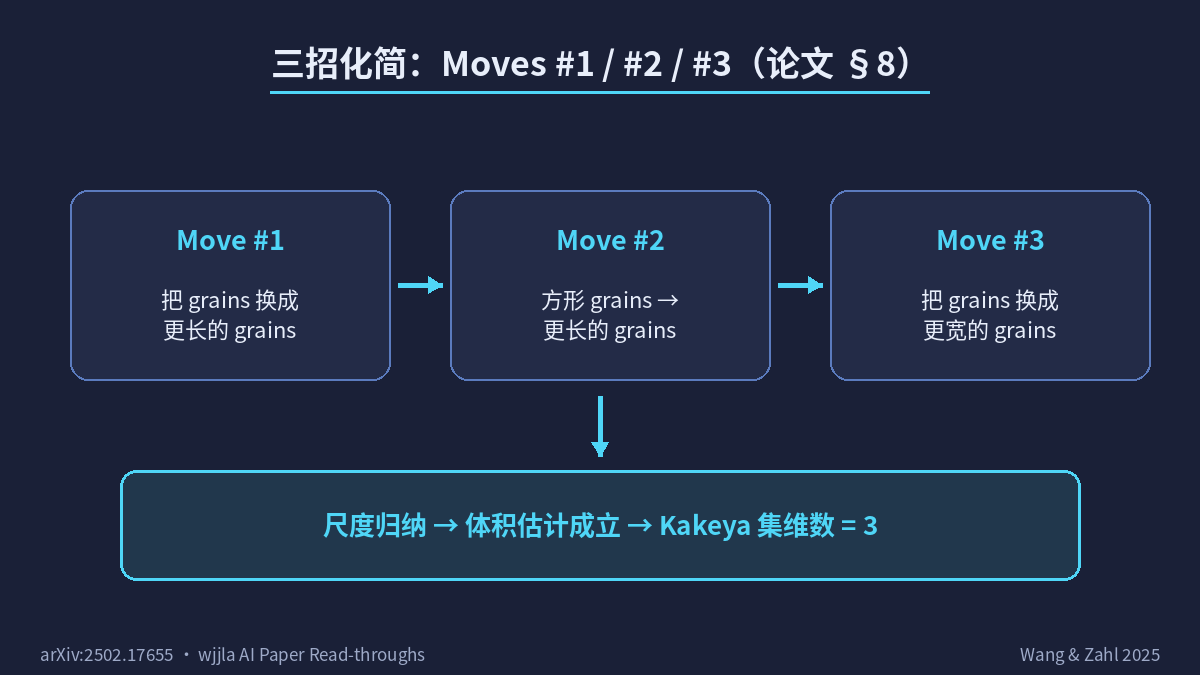
Der Autor hat drei Dinge getan, um die „Körner“ an ihren Platz zu bringen – diese drei Schritte zusammen sind wiedrei Aktionen beim Aufräumen eines Bücherregals: Das schiefe Buch aufrecht stellen (Schritt 1), die unterschiedlich hohen Bücher aufeinander stapeln (Schritt 2) und mehrere benachbarte Bücher zu einem dickeren Sammelband zusammenfassen (Schritt 3).
Konkret:
- Schritt #1(§8.1): Ersetzen Sie die „Körner“ durchlängere Körner, um sicherzustellen, dass c ≥ δ^ζ · ρ·#Tρ / #T ist.Was geschieht bei diesem Schritt: Die „zu kleinen Körner“ der Zuckerstangen werden zu „genug großen“ Körnern umgearbeitet, um die Untergrenze der Körnergrößenformel sicherzustellen.Warum werden die Körner weggeworfen, wenn sie die Bedingung nicht erfüllen: Weil alle nachfolgenden Schätzungen von dieser Untergrenze abhängen. Wenn die Untergrenze nicht erfüllt ist, wird die Schätzung explosiv (zu einer divergenten Schätzung, die keinen Sinn macht). Wenn sie nicht erfüllt ist, geben Sie einfach diese Gruppe von Körnern auf und kehren zum Eingang der Guth-Zerlegung zurück, um erneut zu berechnen – das ist ein „harter Neustart“ des Algorithmus.
- Schritt #2(§8.2): Wenn die Körner „quadratisch“ sind (a × b × c im Querschnitt, wobei b/c zu groß ist), ersetzen Sie die Körner durchlängere Körnermit einer L²-Schätzung im Cordoba-Stil – auf der Ebene von δ^(-ω/100).Was geschieht bei diesem Schritt: Sie behandeln den Fall, dass „die Querschnittsfläche der Körner zu quadratisch und die Länge zu gering ist“ – die Zuckerstangen sind zu „rund“, und Sie müssen jede Hagebutte verlängern.Warum verwenden Sie die L²-Schätzung: Weil dies ein „quadratisch integrierbares“ Ungleichungs-Tool für die Körnergeometrie ist, mit dem genau das Verhältnis „Querschnitt / Länge“ gedrückt werden kann.
- Schritt #3(§8.3): Wenn CKT-CW zu groß ist, können Sie jeden Körner mit der L²-Argumentation zu einem „Haarbürsten“ erweitern: Verwenden Sie δ̃-Nachbarschaften, um die umliegenden Körner einzuschließen, und erhalten Sie einenbreiteren Körner.Was geschieht bei diesem Schritt: Wenn der „Streuungsindex“ auf einer bestimmten Skala bereits schlechter ist (die Rohre beginnen sich zu häufen), führen Sie eine Fusion der nahegelegenen Körner zu einem größeren „Kamm“ durch – Sie kombinieren mehrere kleine Zuckerstangen zu einer großen Zuckerstange.Warum werden die Körner nicht einfach gelöscht: Weil sie echte geometrische Informationen enthalten, und wenn sie gelöscht werden, geht die Struktur verloren; Sie können sie nur zusammenführen, nicht löschen.
Bei jedem Move steigt entweder c oder ρ stark an, aber beide werden durch 1 begrenzt, so dass dieser Iterationsprozess nach einer begrenzten Anzahl von Schritten zwangsläufig endet –dies ist der klassische Ansatz, dass monoton begrenzte Folgen konvergieren. Wenn der Prozess endet, erfüllen die Grains alle sechs Eigenschaften (i) bis (vi) (L948-970) – und das ist der Eingang für die spätere Induktion nach Maßstab.
Schritt 4: Feinmaschige Skalensynthese(§9 + §11)
Was wird in diesem Schritt getan: Die „idealen Körner“ aus Schritt 3 werden noch einmal genauer induziert – E(σ, ω) wird aufzwei Schichtenangewendet, nicht nur einmal.Warum ist das unerlässlich: Die Volumenschätzung, die mit E(σ, ω) nur einmal gegeben wird, ist nicht stark genug (sie reicht nur aus, um ω ein wenig zu verringern, nicht aber, um ω bis auf 0 zu drücken);beide Schichten einmal anwendenist notwendig, um die Schätzung in „Produktform“ zu überführen, was stärker ist als nur einmal anzuwenden.
Nachdem die „idealen Körner“ von Schritt 3 erhalten wurden, führte die Arbeit eine detailliertere Aufgabe durch: E(σ, ω) wurde aufzwei Ebenenangewendet – sowohl auf die δ-Körner innerhalb jedes ρ-Tubus (feinmaßstäbig) als auch auf die skalierte ρ-Tubus-Familie jedes Korns (grobmassstäbig). Wenn beide Ebenen einmal angewendet werden, ergibt sich eine kollektive Volumenschätzung in Form eines „Produkts aus zwei Ebenen“, was stärker ist als die Verwendung von D(σ, ω) allein. Dies ist der Kern von Proposition 1.7 – sie besagt, dass bei jeder Induktion ω um einen Wert g(σ, ω) > 0 verringert wird, und wenn ω festgelegt und wiederholt verwendet wird, kann σ schrittweise auf 0 reduziert werden.
- Der Sinn dieses Induktionssatzes ist “Treppensteigen” * *: Jede Stufe der Treppe ist etwas niedriger als die vorherige Stufe, solange jede Stufe wirklich auch nur ein wenig absteigen kann (g (σ, ω)> 0), kann sie nach wiederholtem Gehen zu Boden fallen (sigma = 0). * * Warum muss es “zwei Schichten” statt “eine Schicht” sein * *: Durch die einschichtige Induktion wird ω nicht schnell genug reduziert, die Anzahl der Iterationen reicht nicht aus, und schließlich wird Sigma nicht auf 0 reduziert; nachdem es in die Produktform überlagert wurde, wird die Abstiegsgeschwindigkeit multipliziert, und es ist möglich, wirklich zu konvergieren. * * Was bedeuten die beiden Symbole Sigma und ω? * *: Grob gesagt ist Sigma der “Dimensionsdefizitindex” (je näher an 0, desto näher an der vollen Dimension), und ω ist der “Dispersionsabbauindex” (je größer das Rohr, desto kleiner das Rohr, desto stärker ist es gestreut); die Induktion sollte diese beiden Parameter gleichzeitig auf (0,0) drücken.
Sticky Kakeya-Abschluss(§10 + §2.4)
Der tödlichste Schritt: Angenommen, D(σ, ω) ist für eine bestimmte Gruppe von σ, ω > 0 kompakt (ohne Redundanz), dann folgt aus Schritt 4, dass T zwangsläufig auf mehreren Skalen selbstähnlich ist und die Eingabe des Sticky Kakeya-Theorems erfüllt; aber [25] hat gezeigt, dass die Dimension der Sticky Kakeya-Menge = 3 ist, was dem Kompaktheitsannahme von D(σ, ω) widerspricht. Daher müssen σ und ω gleichzeitig 0 sein – das heißt, sowohl D(0, 0) als auch E(0, 0) gelten, was Satz 1.9 ist.
Das Wort „sticky“ lässt sich im Alltag mit einem „Matrjoschka-Püppchen“ vergleichen – eine äußere Puppe, die eine innere und diese wiederum eine innere umfasst; die Struktur der sticky Kakeya-Menge ist ähnlich: Auf jeder Ebene (bei oberflächlicher, genauer und noch genauerer Betrachtung) sieht die Menge „ähnlich aus wie sie selbst“ – große Maßstäbe enthalten kleine Maßstäbe, und kleine Maßstäbe enthalten noch kleinere Maßstäbe, wobei jede Ebene selbstähnlich ist.Warum diese „Matrjoschka“-Struktur Widersprüche hervorrufen kann: Wenn ein Gegenbeispiel als „sticky“ festgestellt wird, hat [25] bereits bewiesen, dass die Dimension der sticky Kakeya-Menge 3 betragen muss; Sie gehen jedoch davon aus, dass die Dimension < 3 ist (da ein Gegenbeispiel existiert), also kann das Gegenbeispiel nicht „sticky“ sein – aber zuvor wurde bereits festgestellt, dass das Gegenbeispiel „sticky“ sein muss, was einen Widerspruch darstellt.
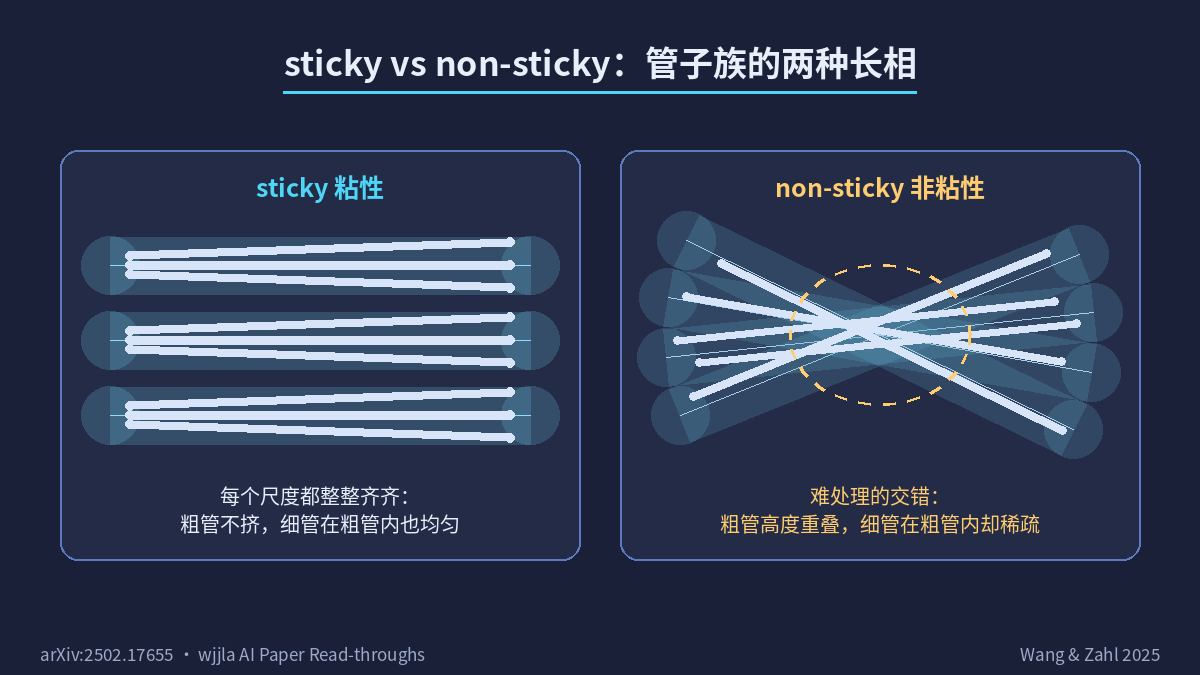
Das Werkzeug in diesem Schritt ist die Nikishin-Stein-Pisier-Faktorisierung (§10.1, L5910): Sie wird verwendet, um spärliche T (Anzahl « δ^(-2)) auf δ^(-2) zu ergänzen, um sicherzustellen, dass der Sticky-Kakeya-Satz anwendbar ist.Der Geist dieses Werkzeugsist „die Gummibänder so fest wie möglich spannen“ – Sie haben eine Menge von Rohren, die zu spärlich sind (Anzahl « δ^(-2)), und der Sticky-Satz benötigt δ^(-2) Rohre, um ausgeführt zu werden; Nikishin-Stein-Pisier erledigt die Aufgabe, die spärlichen Rohre „zu multiplizieren“, um eine dichte Version zu erhalten, was gleichbedeutend damit ist, ein Gummiband straff zu ziehen – die spärliche Menge wird starr in eine dichte Menge erweitert, und der „Grad der Dichte“ innerhalb dieser Menge erreicht die von dem Sticky-Satz geforderte Untergrenze.
- Zwei unerwartete Ergebnisse: Tube Doubling und Keletis Vermutung wurden zusammen veröffentlicht.
Sie denken, es sei hiermit beendet? Nein, die Arbeit bewies auch mühelos die Vermutung der dreidimensionalen Tubenverdopplung ( Theorem 1.12, L685) und die Vermutung der Streckenverlängerung von Keleti ( Theorem 1.14, L698).
Tube Doublingbedeutet, dass eine Reihe von δ-Tuben „doppelt so dick“ gemacht werden (zu 2δ-Tuben), und nach der Verdickung ist das gemeinsame Volumen höchstens um einen subpolynomialen Faktor δ^(-ε) kleiner als das ursprüngliche Volumen. Die zweidimensionale Version war bereits bekannt (dokumentiert in Abschnitt 1.6 der Arbeit), aber für die dreidimensionale Version gab es bisher keine Lösung. Wang und Zahl konnten dies mit Wolffs Axiomen und der Decomposition of Convex Sets lösen.
DieKeleti-Vermutungbesagt, dass die Dimension einer Menge von Linien, die zu Geraden verlängert wurden, gleich der Dimension der ursprünglichen Menge von Linien ist. Keleti-Máthé ([23]) bewies 2022, dass die n-dimensionale Kakeya-Menge-Vermutung die n-dimensionale Keleti-Vermutung impliziert, alsoverschenktWang-Zahl quasi eine dreidimensionale Version der Keleti-Vermutung.
Keine der beiden Folgerungen ist eine „offensichtliche Folgerung“. In Abschnitt 12 des Artikels wird der vollständige Beweis für Tube Doubling gegeben, wobei derselbe mehrskalige Struktursatz aus Abschnitt 11 + Nikishin-Stein-Pisier-Faktorisierung verwendet wird.
6. Grenzen: n ≥ 4 Warum schließt du es nicht einfach?
Dies wird in der Arbeit nicht explizit erwähnt, aber ich werde es nach dem Lesen von §1 erwähnen. Es gibt mindestens drei Stellen in der gesamten Argumentation, diespeziell von der dritten Dimension abhängen:
1.Wolff-Bürstenbindungliefert im dreidimensionalen Fall den δ^(1/2)-Index (in der Nähe von L240) – genau dies ist der Startpunkt für Proposition 1.8 „D(1/2, 0) ist wahr“, und der gesamte Iterationsprozess beginnt mit diesem dreidimensionalen Index. 2.Guth-Körner-Zerlegungist ein Werkzeug im dreidimensionalen Fall ([9], L487, §1.5); ob es in höheren Dimensionen ein Äquivalent gibt, wird in der Arbeit nicht diskutiert. 3.Die Behauptung, dass der Bereich σ ∈ [0, 2/3] für die Äquivalenz von D/E gilt(L302, Proposition 1.6), stammt aus der dreidimensionalen Argumentation in diesem Artikel; wie sich dieser Bereich in höheren Dimensionen ändert und ob der Iterationsprozess weiterhin funktioniert, wird in der Arbeit nicht diskutiert.
Strictly speaking:n ≥ 4 ist immer noch eine offene Frage. Die Methodik der Arbeit könnte als Vorlage für zukünftige Arbeiten dienen, liefert jedoch keine direkten Ergebnisse.
Die Vermutung über die Verlängerung der Ost-Linie ( Theorem 1.14) und die Tube-Doubling ( Theorem 1.12) sind ebenfalls auf drei Dimensionen beschränkt – ein typisches Nebenprodukt der drei Dimensionen, das nicht wie bei Kakeya einfach auf n Dimensionen übertragen werden kann.
VII. Kritische Bewertung: Was ist gut an dieser Arbeit, was ist schwierig und lohnt es sich, sie zu bearbeiten?
Was sind die Vorteile:
- Keine Tricks. Das Katz-Tao-Programm wurde seit seiner Einführung im Jahr 2014 zwölf Jahre lang weiterentwickelt, und während dieser Zeit versuchten viele, „den Schritt der Stickiness zu umgehen“, was jedoch nie gelang. In dieser Arbeit wird die Stickiness jedoch ehrlich behandelt – gestützt auf die neue Beobachtung „Wenn D(σ, ω) kompakt ist, muss das Gegenbeispiel sticky sein“ (zusammengefasst in Abschnitt 2.4) und die Nikishin-Stein-Pisier-Faktorisierung, um spärliche Mengen zu vervollständigen. Mein größter Eindruck beim Lesen der Beweisskizze in Abschnitt 2 war, dass die „Verknüpfungen“ in dieser Argumentation äußerst präzise sind und jeder Schritt auf der zuvor erhaltenen Struktur aufbaut, ohne „inspirierende Sprünge“.
- Mehrskalenstruktursatz(Proposition 7.5 in Abschnitt 7) ist ein unabhängig einsetzbares Werkzeug. Selbst wenn Sie sich nicht für Kakeya interessieren, ist diese „Zerlegung in zwei Skalen + 6 Eigenschaften“ selbst ein wiederholbar zitierbarer Bestandteil der geometrischen Maßtheorie.
- Klarer Aufbau. In der 127-seitigen Arbeit werden die Grundlagen bereits in den ersten 22 Seiten erläutert – Definition 1.3 (Nicht-Konzentrationsbedingung), Definition 1.5 (Behauptung D/E), Satz 1.2 + Satz 1.9 + Folgerung, alles in Abschnitt 1, gefolgt von einer Beweisskizze in Abschnitt 2. Die Abschnitte 3–12 enthalten dann die Details. Diese Vorgehensweise, „zuerst die Schlussfolgerungen, dann den Beweis“, ist für ein 127-seitiges Werk unerlässlich.
Was ist so schwierig daran:
- 3 Wolff-Konstanten + 5 Bewegungen/Eigenschaften + 7 Kombinationen von Korn-Dimensionen: Allein das Erinnern der Namen würde eine große Tabelle erfordern. In Abschnitt 3.2 des Papiers gibt es eine Notationstabelle, aber beim ersten Lesen kann man leicht den Überblick verlieren.
- Nikishin-Stein-Pisier-Faktorisierung(Abschnitt 10.1): Dieses Werkzeug ist für die meisten Leser (einschließlich mir) neu – es ist im Wesentlichen ein probabilistischer Beweis, der „sparse Sets mit Hilfe von zufälligen starren Transformationen ergänzt“, und erfordert ein gewisses Grundwissen in Wahrscheinlichkeit und konvexer Geometrie.
- 127 Seiten sind kein Marketing-Trick: Die „4-Wege-Polychotomie“ (L884-901, Punkte (A)-(D)) in Abschnitt 6 (Behauptungen D und E sind äquivalent) erfordert die vollständige Bearbeitung der Fälle (A)-(D), wobei jeder Fall ein ganzes Kapitel umfasst. Dieser Teil ist ziemlich anstrengend zu lesen.
Ist es wert, sich damit zu beschäftigen:
Wenn Sie sich mit harmonischer Analyse / geometrischer Maßtheorie / partiellen Differentialgleichungen beschäftigen, ist dies einer der wichtigsten Artikel des Jahres 2025 und absolut lesenswert – vor allem sollten Sie mit dem Beweisschema in Abschnitt 1 und Abschnitt 2 beginnen (nur 22 Seiten), bevor Sie sich für die Details in Abschnitt 4 bis Abschnitt 12 entscheiden.
Wenn Sie in einem verwandten Bereich (Kombinatorik, Wahrscheinlichkeit) arbeiten, sollten Sie zumindest die historischen Zusammenhänge in §1 + §1.4 und die Schlussfolgerungen in §1.6 (insgesamt 14 Seiten) lesen, um ein Gefühl dafür zu bekommen, „welche Bedeutung dieses Ergebnis hat“.
Wenn Sie nur ein Mathematikliebhaber sind, habe ich §2 in der obigen Aufschlüsselung geschrieben, die im Grunde die Hauptgeschichte ist. Mit acht Bildern, die durchgegangen werden, ist der Kern der Idee vermittelt worden.
8. Zusammenfassung in einem Satz
Die Dimension der dreidimensionalen Kakeya-Menge beträgt 3. Dies wurde Anfang 2025 in einer 127-seitigen Arbeit mit der Kombination aus Wolffs Axiom + Zerlegung von konvexen Mengen + zweidimensionalen Körnern + drei Zügen + Nikishin-Stein-Pisier-Faktorisierung endgültig bewiesen. Das vor 108 Jahren in Japan aufgeworfene geometrische Problem wurde von einem chinesischen Mathematiker, der 2011 an der Peking-Universität graduierte, und einem Kollegen von der University of British Columbia gemeinsam abgeschlossen. Für n ≥ 4 ist das Problem weiterhin offen, aber der Werkzeugkasten ist jetzt bereit.
Liste der Positionen der beigefügten Abbildungen:
- Abbildung 01 (Hang-Gu-Needle-Problem) entspricht dem oberen Teil des ersten Abschnitts dieses Artikels.
- Abbildung 06 (Was ist die Dimension?) entspricht dem unteren Teil des ersten Abschnitts dieses Artikels, wo der Begriff „Dimension“ eingeführt wird.
- Abbildung 02 (Rohrfamilie und nicht-zentrierte Bedingungen) entspricht dem Ende des dritten Abschnitts dieses Artikels.
- Abbildung 05 (Historischer Fortschritt bei der Untergrenze der Dimension) entspricht dem Ende des zweiten Abschnitts dieses Artikels.
- Abbildung 07 (Übersicht über den Beweis-Workflow) entspricht dem Anfang des vierten Abschnitts dieses Artikels.
- Abbildung 03 (Zweiskalige Grains-Zerlegung) entspricht dem Ende von Schritt 2 des vierten Abschnitts dieses Artikels.
- Abbildung 04 (Drei-Züge-Moves-Prozess) entspricht dem Ende von Schritt 3 des vierten Abschnitts dieses Artikels.
- Abbildung 08 (Vergleich von sticky und non-sticky) entspricht dem Schlussabschnitt über sticky im vierten Abschnitt dieses Artikels.