Stellen Sie sich vor: Sie stellen einen Praktikanten ein, der Ihnen hilft, Flugtickets zu buchen, Formulare auszufüllen und Dokumente zu sortieren.
Aber du hast ihm eine Regel aufgestellt: Er darf nur auf den Bildschirm schauen, nur die Maus und die Tastatur bedienen und keine Schnittstellen im Hintergrund der Software betrachten.
Das klingt hart. Aber genau das hat die am 4. August 2026 bei arXiv eingereichte Arbeit mit dem Titel „Qwen-CUA: Native Computer Use for (almost) Everything“ (Arxiv-Nummer 2608.02352) getan. Die Qwen-Team und das Xlang Lab der Universität Hongkong veröffentlichten sie gemeinsam; mehr als 30 Autoren waren daran beteiligt, und das GitHub-Repository ist unter xlang-ai/Qwen-CUA verfügbar.
In diesem Artikel wird heute eine Frage beantwortet:Können die Praktikanten, die nach dieser Regel ausgebildet werden, tatsächlich lernen, wie man arbeitet?
Warum müssen die Regeln so streng sein?
KI möchte in der digitalen Welt arbeiten, aber es gibt eigentlich nur drei Wege: Code schreiben, Schnittstellen anpassen und grafische Benutzeroberflächen verwenden. Die ersten beiden Wege sind für große Modelle in den letzten Jahren sehr gut geeignet, da sie Text verstehen und Werkzeuge anpassen können.
In der Realität jedoch liegen viele Aufgaben gar nicht auf den ersten beiden Wegen. Desktop-Software, alte Systeme und professionelle Tools zeigen ihre Funktionen nur auf dem Bildschirm an, die Maschine kann sie jedoch nicht lesen. Daher ist „nur auf den Bildschirm schauen und nur mit Maus und Tastatur arbeiten“ keine Selbstquälerei, sondern der einzige Weg, der für alle Software geeignet ist.
Aber es gibt drei große Schwierigkeiten auf diesem Weg:die Benutzeroberfläche ist nur zur Hälfte sichtbar, die Fehler werden immer schlimmer und die Beweise sind auf Dutzenden von Screenshots verstreut.Die Arbeit 1 Introduction beschreibt diese drei Probleme sehr deutlich. Wie hat Qwen-CUA jede Phase erfolgreich gemeistert? Man muss mit „Augen und Händen“ beginnen.
Die erste Runde: Passen Sie ein Paar Augen und eine Hand zusammen
In Abschnitt 2.1 des Dokuments wird den Praktikanten eine minimale Ausrüstung zugewiesen, die in Abbildung 2 dargestellt ist.
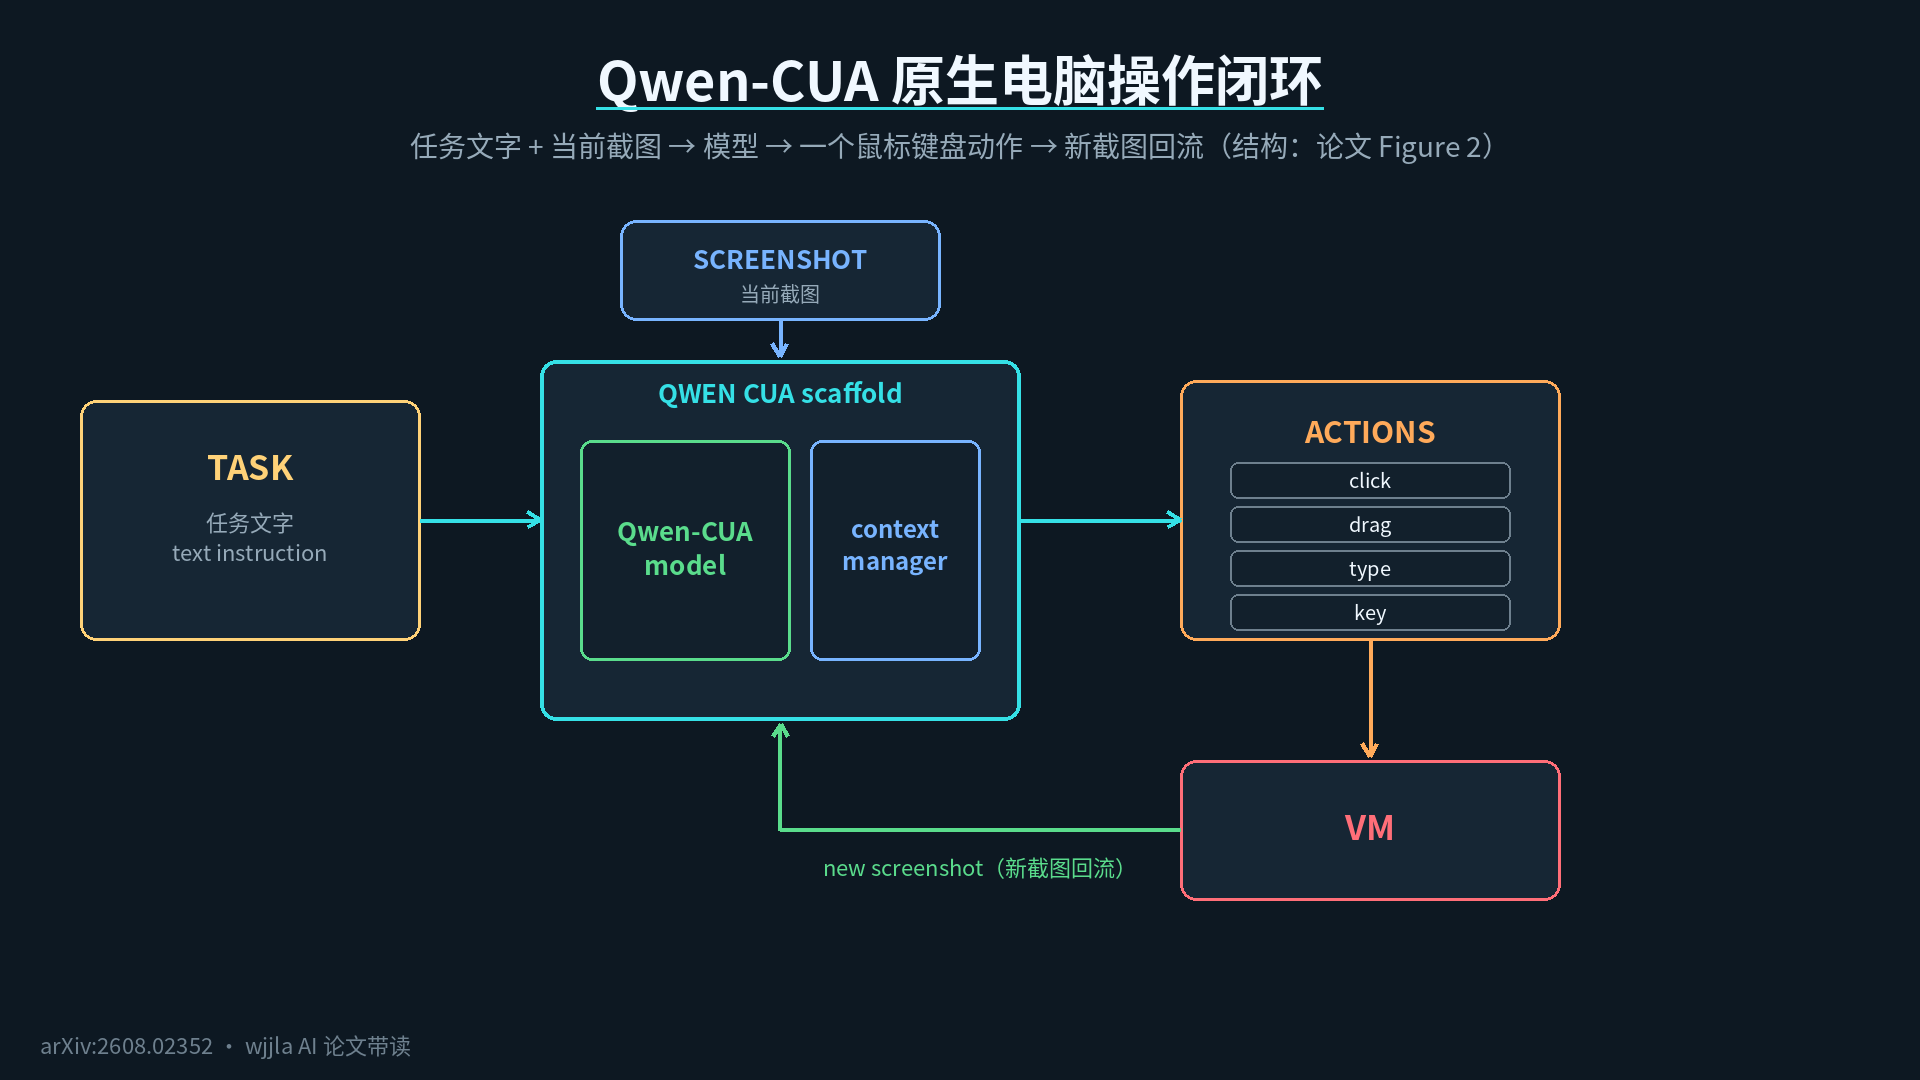
Der gesamte Arbeitszyklus lässt sich in einem Satz zusammenfassen:Geben Sie einen Aufgabentext ein, sehen Sie sich einen aktuellen Screenshot an, und geben Sie eine Maus- und Tastaturaktion aus.Die Aktionen lassen sich in drei Kategorien unterteilen: Maus (Bewegung, Klicken mit der linken/rechten/mittleren Maustaste, Doppel- und Dreifachklick, Ziehen, Scrollen), Tastatur (Tastenkombinationen, Drücken/Loslassen, Texteingabe) und Steuerung (Screenshot, Warten, Beenden, Benutzer anrufen). Eine vollständige Liste der Aktionen finden Sie in Anhang A.
In der Mitte befindet sich etwas, das „Gerüst“ (scaffold) genannt wird. Sie können es als Koordinator am Arbeitsplatz betrachten – geben Sie Aufgaben an das Modell weiter, geben Sie Screenshots ein, führen Sie Aktionen auf dem virtuellen Computer aus und holen Sie dann neue Screenshots zurück. Sie müssen sich nicht um interne Details kümmern und tun in jeder Runde nur eine Sache.
Es gibt einen Satz in der Arbeit, den ich in Alltagssprache übersetzen muss:Diese Ausrüstung funktioniert in allen Browsern und Desktop-Anwendungen, ohne eine einzige Konfigurationszeile zu ändern.Kein DOM-Tree, keine Barrierefreiheits-Metadaten, keine speziellen APIs. Es ist einfach ein Standard „menschliches Auge + menschliche Hand“.
Die richtige Auswahl der Augen und Hände ist nur der erste Schritt. Das eigentliche Problem ist, dass sie sich nicht alles merken können, wenn die Arbeit lange dauert.
Zweite Runde: Wenn das Gedächtnis nicht ausreicht, kann man Notizen verwenden.
2.2 behandelt das Problem des Gedächtnisses.
Bei langen Aufgaben sammeln sich Dutzende oder Hunderte von Screenshots, die alle in das Kurzzeitgedächtnis des Gehirns gepackt werden, das niemand vollständig speichern kann. Die Methode von Qwen-CUA ist wie ein Notizbuch:
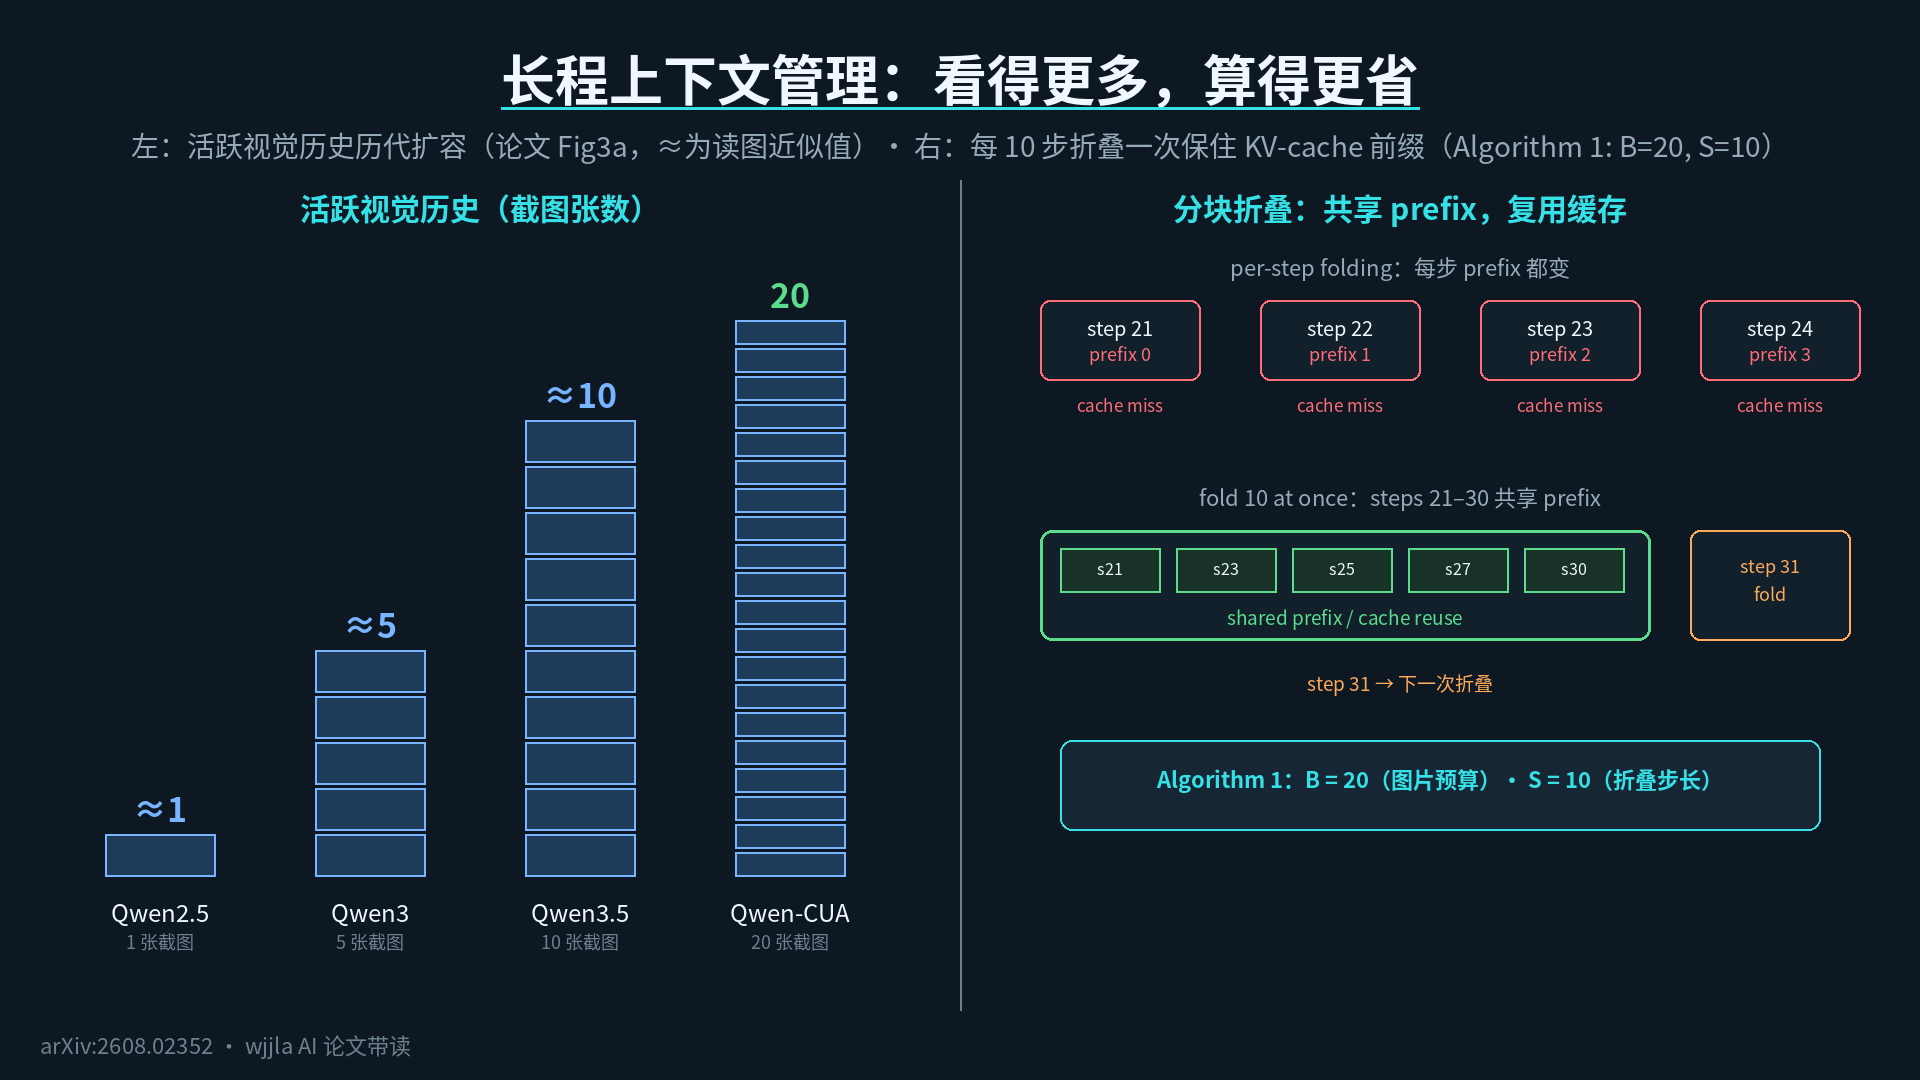
- Aktive visuelle Geschichte von bis zu 20 Screenshots. Die letzten 20 Screenshots liegen auf dem Tisch und können jederzeit eingesehen werden.
- Jedes Mal, wenn 10 Screenshots gesammelt werden, falte sie einmal nach vorne. Falten bedeutet nicht wegwerfen, sondern die älteren Screenshots durch einen Text- Platzhalter zu ersetzen: „Hier war einmal ein Screenshot, als ich X getan habe“, aber die damaligen Handlungen und Überlegungen bleiben im Kontext erhalten.
Die Abbildung 3(a) des Artikels zeigt, dass der „Desktop“ von Qwen im Laufe der Zeit immer größer wurde: Qwen2.5 zeigt nur ein Bild, Qwen3 fünf Bilder, Qwen3.5 zehn Bilder und Qwen-CUA sogar 20 Bilder. Abbildung 3(b) vergleicht zwei Faltenmethoden: entweder wird bei jedem Schritt neu sortiert (der Präfix ändert sich ständig) oder nur alle zehn Schritte – bei letzterem wird der Präfix gemeinsam genutzt und der KV-Cache wird direkt wiederverwendet, was die Rechenleistung spart.
Es gibt noch ein weiteres Detail im Training: Für das verstärkende Lernen wird derselbe Faltungsoperator verwendet, wobei eine ganze lange Spur in mehrere kontextbegrenzte Abschnitte geschnitten wird, von denen jeder dasselbe Endbelohnung erbt. Auf diese Weise müssen keine Belohnungen für Zwischenschritte manuell vergeben werden, und die Überwachungssignale können vom Endzustand bis hin zu den Zwischenentscheidungen weitergeleitet werden.
Die Augen, die Hände und das Notizbuch sind vorhanden – nun kommt die Kernfrage:Wie wird man zu einem solchen Praktikanten?
Dritte Runde: Wie man trainiert – Erstellen Sie zuerst eine „Fahrschule“ mit 100.000 Kernen
Das Schwierigste bei der Schulung eines Computers, um intelligente Entitäten zu steuern, ist nicht das Modell, sondern es muss einen Ort geben, an dem er wiederholt Fehler machen und aus ihnen lernen kann.
Der Autor hat einfach eine „Fahrschule“ eingerichtet, die auf Alibaba Cloud ECS läuft undfast 100.000 virtuelle CPU-Kerneundzehntausende gleichzeitige Umgebungenunterstützt. Jeder virtuelle Computer ist ein unabhängiger Arbeitsplatz, auf dem der Benutzer nach Belieben arbeiten kann.
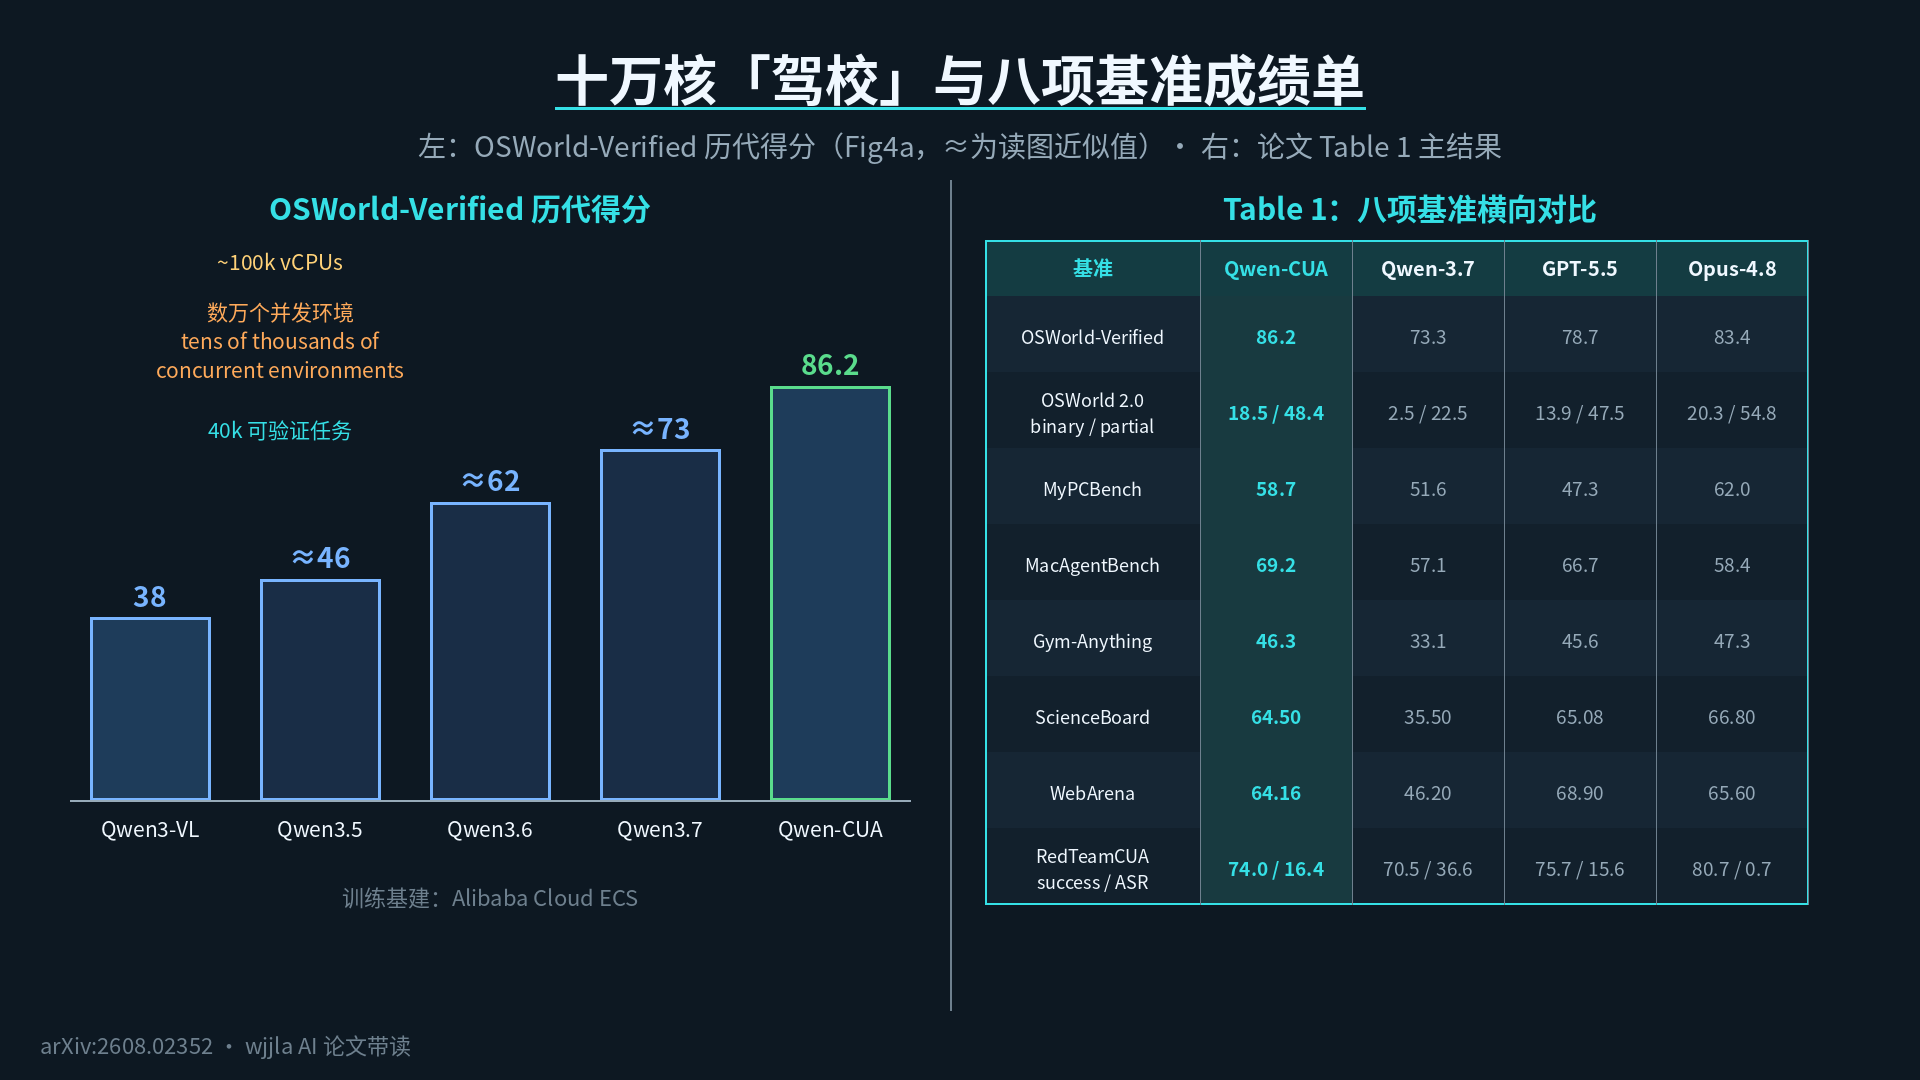
Abbildung 4(a) ist sehr anschaulich: Die Punktzahl von Qwen in OSWorld-Verified stieg von 38 bei Qwen3-VL auf 46 bei Qwen3.5, 62 bei Qwen3.6 und 73 bei Qwen3.7 und schließlich auf 86,2 bei Qwen-CUA. In der Abbildung sind gleichzeitig drei Meilensteine markiert:etwa 40.000 überprüfbare Aufgaben, etwa 100.000 vCPUs und Zehntausende von gleichzeitigen Umgebungen.
Die Fahrschule und die Prüfung sind vorhanden, aber woher kommen die Lehrbücher? Das ist die nächste Hürde.
Die vierte Stufe: Lehrbücher – drei Arten von Übungsaufgaben und eine Art von Lehrerunterstützung
Die Lehrmaterialien sind in drei Kategorien von Übungsaufgaben unterteilt, plus eine Kategorie „Lehrer führt an“, und ich habe sie für Sie in einen Stundenplan zusammengefasst:
- Umgebungsbedienungsaufgaben(erste Kategorie) – Bringen Sie ihm bei, die Schaltflächen, Menüs und Statuswechsel in der Software zu erkennen.
- Benutzerinteraktionsaufgaben(zweite Kategorie) – Beschreiben Sie die Aufgabe absichtlich unvollständig und schauen Sie, ob er aktiv nachfragt. Diese Aufgaben nutzen das Konzept des „simulierten Benutzers“ von OSWorld 2.0: Der simulierte Benutzer antwortet nur, wenn er gefragt wird.
- Langfristige Prozesse(dritte Kategorie) – Teilen Sie große Aufgaben in kleine Phasen auf, die automatisch bewertet werden können. Dies ist wie bei einem Staffellauf, bei dem jeder Läufer einen überprüfbaren Endzustand hat, und sobald dieser erreicht ist, wird der Zustand serialisiert und als Startpunkt für den nächsten Läufer verwendet. Diese Methode wird als „Phasen-Zustands-Kettenbildung“ bezeichnet und wird in Abschnitt 3.2 Absatz 2 des Artikels ausführlich erläutert.
- Menschliche Tutoren(vierte Kategorie) – Lassen Sie einen echten Menschen an seinem eigenen Computer tatsächliche Aufgaben ausführen: Flugbuchungen, Formulare ausfüllen, CAD-Anwendungen oder Blender. Das Modell fügt jeder Schritt einen „inneren Monolog“ (chain-of-thought) hinzu und filtert die erfundenen Schritte in zwei Runden heraus, indem überprüft wird, ob sie mit den aktuellen Screenshots und den von ihm ausgeführten Aktionen übereinstimmen.
Die vier Kategorien zusammen bilden das gesamte Lehrmaterial der Fahrschule.Aber beim Training von intelligenten Agenten für Computer ist es nicht die Datenmenge, die am knappsten ist, sondern die Algorithmen, die Fehler machen und dabei immer besser werden.
Die fünfte Stufe: Coaching-Methode – Verbessere deine Punktzahl durch Ausprobieren und Lernen aus Fehlern
In Abschnitt 3.3 geht es um verstärkendes Lernen. Der Algorithmus heißt SAPO, vollständig Soft Adaptive Policy Optimization. Sie müssen sich den Namen nicht merken, es reicht zu wissen, dass es sich um eine der neuesten Trainingsmethoden handelt, bei der „Fehler bestraft und Erfolge belohnt werden“.
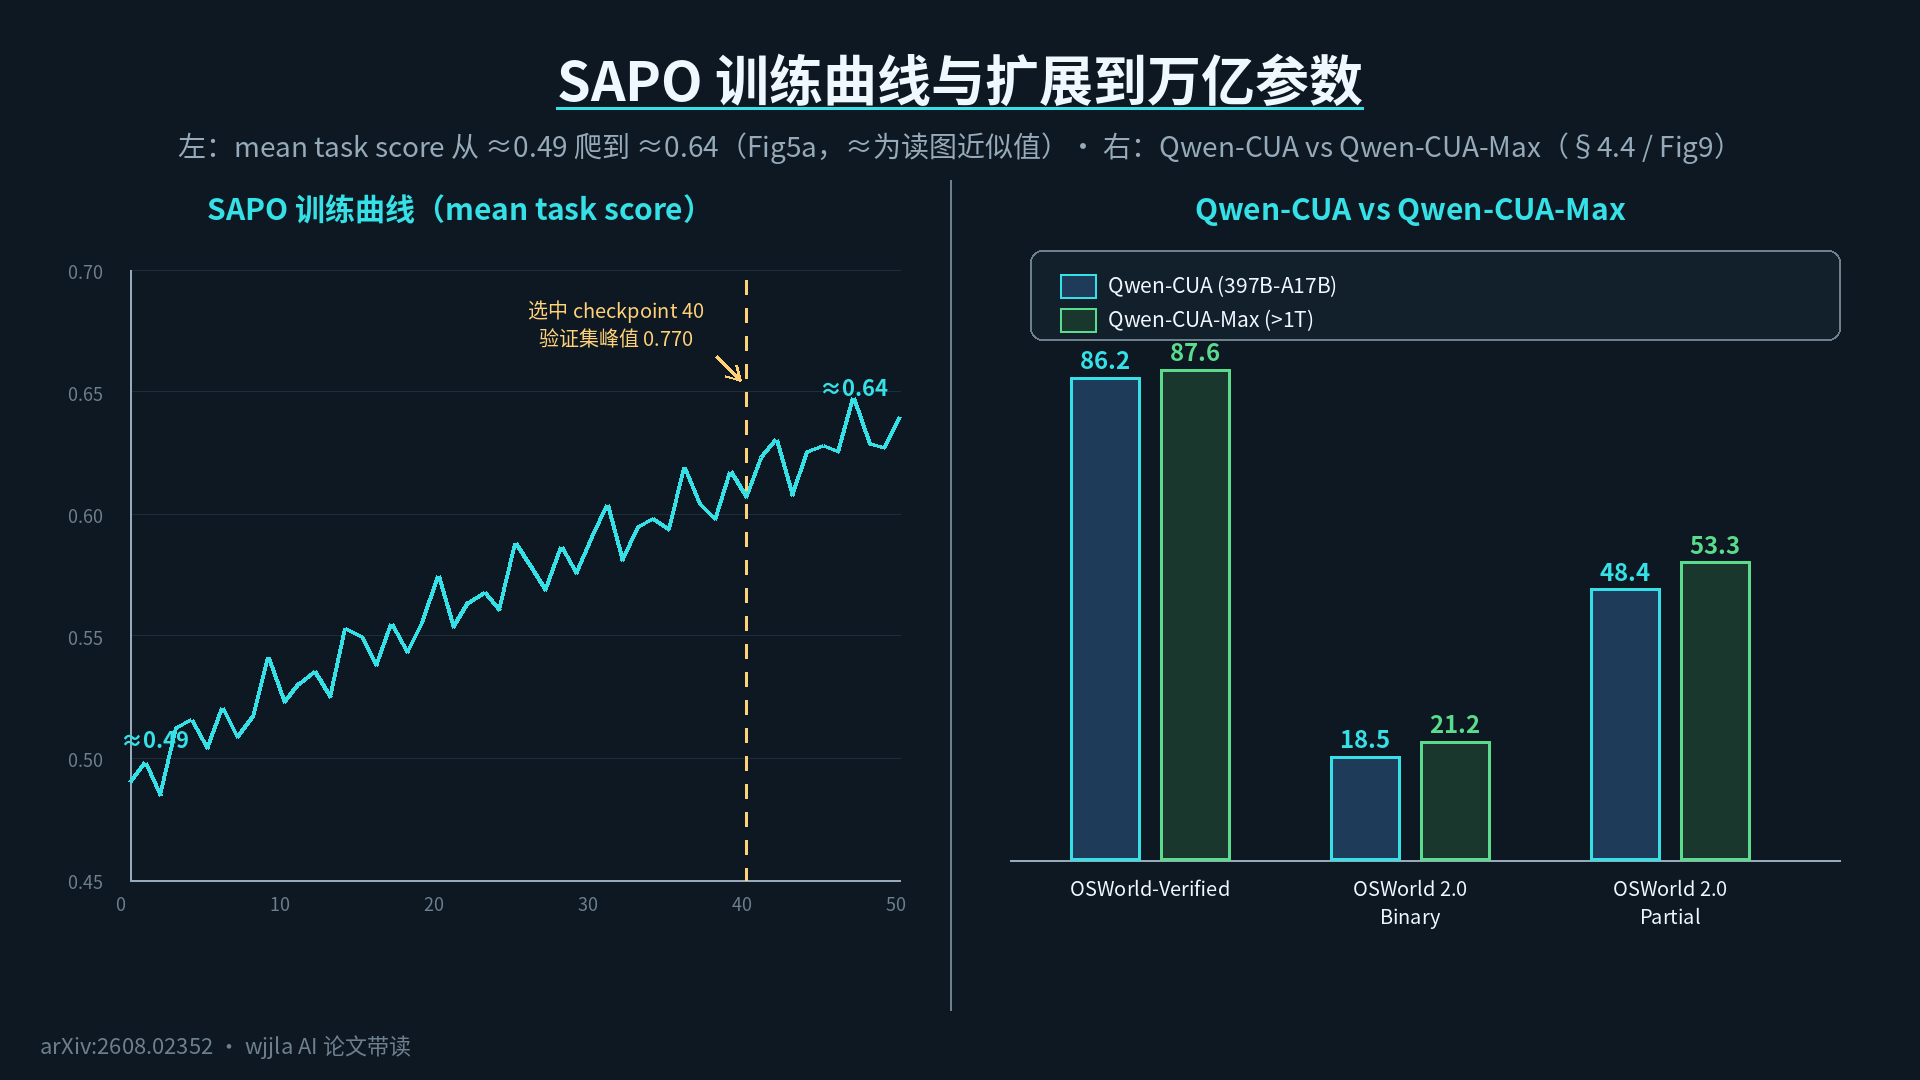
Abbildung 5 ist eine Trainingskurve. Wir betrachten nur den Trend:
- DieTrainingspunktzahlstieg von ursprünglich 0,49 auf 0,64, mit Schwankungen, da jede Charge von Prüfungsfragen unterschiedlich war.
- DieCross-Domain-Validierungspunktzahlstieg von 0,734 vor RL auf einen Höchstwert von 0,770 beiCheckpoint 40 (d. h. der 800. Aktualisierung), und der Autor wählte diese Version als endgültiges Modell. Die gesamte Trainingsphase umfasste 1.000 Aktualisierungen, und bei Checkpoint 50 betrug die Punktzahl 0,762.
Abschnitt 3.4 beschreibt auch die Logik des iterativen Trainings:In jeder Runde werden neue Probleme mit dem neuesten Modell aufgedeckt, neue Fragen hinzugefügt und die nächste Runde trainiert. Die konkrete Vorgehensweise besteht aus zwei Schritten: Im ersten Schritt wird das neueste Modell auf vorhandene SFT-Fragen angewendet, und es wird gezählt, welche Fragen noch falsch beantwortet werden – diese Fragen werden mit einer anderen Lehrstrategie neu generiert und präsentiert. Im zweiten Schritt wird eine „Schwierigkeitsauswahl“ für Fragen zum maschinellen Lernen durchgeführt: 8 Versuche (Rollouts) werden durchgeführt, 0 erfolgreiche (zu schwierig) und 8 erfolgreiche (zu einfach) werden ausgeschlossen, und nur die Fragen im mittleren Bereich bleiben übrig. Diese Logik des „selbstgesteuerten Fragenauswählens“ sorgt dafür, dass das Training immer auf dem neuesten Stand ist.
Nachdem sie bis hierher geübt haben, sind die Praktikanten bereit für die Prüfung – es ist Zeit, die Prüfung abzulegen.
Die sechste Runde: Die Zeugnisse der acht großen Prüfungen
Es gibt insgesamt acht Prüfungsaufgaben, und die Tabelle 1 der Abschlussarbeit ist das Hauptzeugnis.
Die wichtigste Kategorie heißtOSWorld-Verified: Qwen-CUA erreichte 86,2 Punkte, während der Vorgänger Qwen3.7 73,3 Punkte erzielte. Ebenfalls im Wettbewerb waren Closed-Source-Anbieter: GPT-5.5 erreichte 78,7 Punkte, und Claude Opus 4.8 erreichte 83,4 Punkte. Von den acht Kategorien erzielte Qwen-CUA in OSWorld-Verified und MacAgentBench (69,2 Punkte) die höchsten Punktzahlen im Wettbewerb, während sie in den anderen Kategorien mit den Closed-Source-Konkurrenten ein Kopf-an-Kopf-Rennen lieferte – beispielsweise lag Opus 4.8 bei OSWorld 2.0 und RedTeamCUA immer noch vor ihr.
Die schwierigereOSWorld 2.0 Long Task: Qwen-CUA erreichte einebinäre Fertigstellungsrate von 18,5 + eine Teilfertigstellungsrate von 48,4und übertraf die vorherige Version mit 2,5 und 22,5 bei weitem – die binäre Fertigstellungsrate wurde fast siebenfach gesteigert.
Abbildung 1 zeigt die acht Noten in einem Balkendiagramm. Die dunkelste Farbe in jeder Gruppe ist Qwen-CUA-Max, auf die später separat eingegangen wird.
Erinnern Sie sich zunächst an eine Sache: Bei acht Projekten hat er alle seine Vorgänger übertroffen.
Aber klatscht nicht zu schnell – könnte er nicht einfach durch „viel Nachdenken und viel Gerede“ erfolgreich geworden sein?
7. Level: Gibt es Schwachstellen in den Ergebnissen – Effizienzprüfung
Diese Frage ist sehr berechtigt, und in Abschnitt 4.1 der Arbeit wurde eine Effizienzanalyse durchgeführt, um darauf zu antworten, die in Abbildung 6 dargestellt ist.
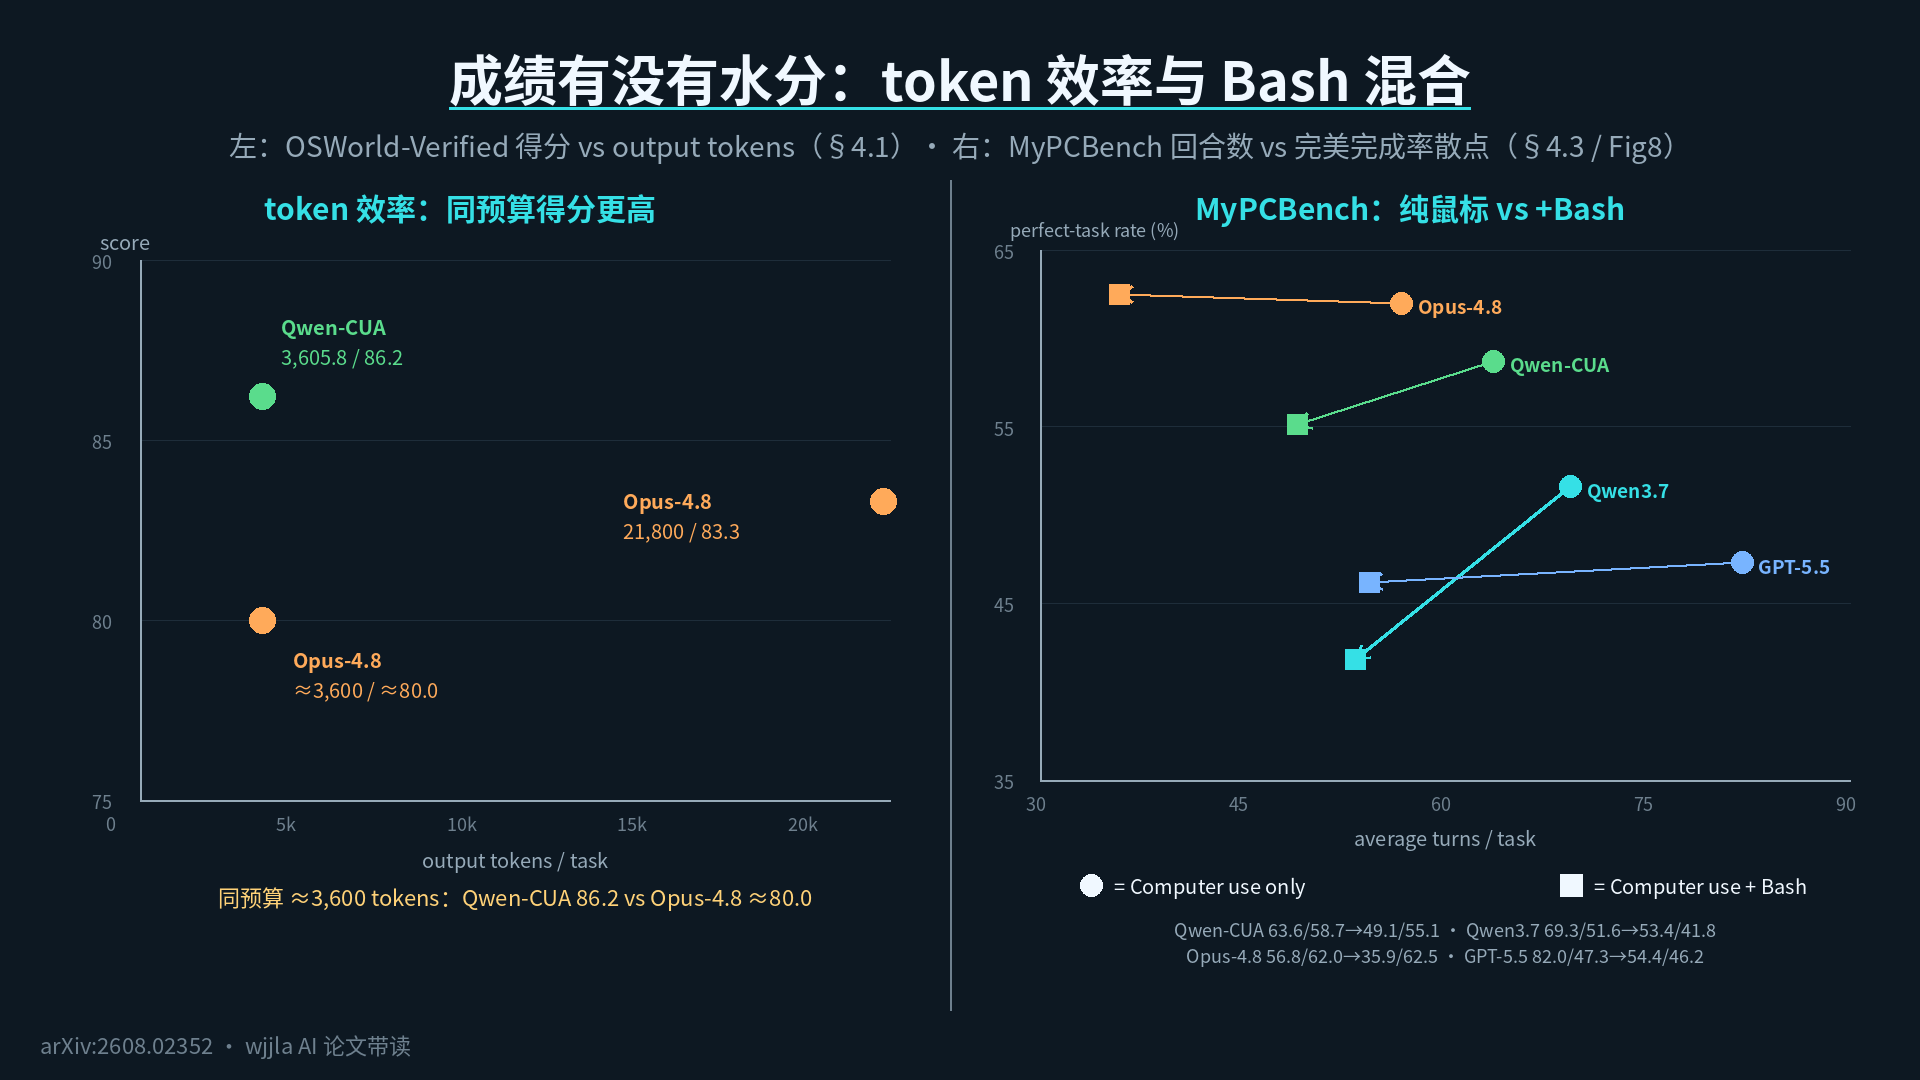
Das linke Diagramm zeigt die Token-Effizienz.Die horizontale Achse ist die Anzahl der Wörter in der Modellausgabe pro Frage, und die vertikale Achse ist der OSWorld-Verified-Score. Qwen-CUA erreicht einen Wert von 86,2 mit nur3.605,8 ausgegebenen Tokens. Mit dem gleichen Budget erreicht Claude Opus 4.8 nur einen Wert von 80,0; Opus 4.8 muss 21.800 Tokens ausgeben, um einen Wert von 83,3 zu erreichen. Die Verbesserung von Qwen-CUA beruht nicht auf „Wiederholungen“.
Die Abbildung rechts zeigt die Interaktionseffizienz.Die horizontale Achse ist die Anzahl der Runden. Auf OSWorld 2.0 beträgt die durchschnittliche Anzahl von Runden pro Frage für Qwen-CUA218,9 Runden, was deutlich mehr ist als die 83,5 Runden von GPT-5.5. Der Autor weist jedoch darauf hin, dass in geschlossenen Systemen pro Runde mehrere Aktionen ausgeführt werden können, während Qwen-CUA pro Runde nur eine Aktion ausführt. Daher ist der Unterschied in der Anzahl der Runden eher auf die unterschiedliche Granularität der Schnittstellen zurückzuführen und nicht auf „Trägheit“.
Die Effizienz ist in Ordnung. Aber es reicht nicht aus, nur zu arbeiten – ist man bei der Arbeit zuverlässig?
Die achte Runde: Vertrauenswürdig oder nicht – Test gegen Phishing
Bei der Computerbedienung gibt es eine besondere Schwierigkeit:Der Inhalt auf dem Bildschirm könnte eine von Kriminellen absichtlich platzierte Falle sein.Zum Beispiel könnte eine gefälschte Schaltfläche „Subventionen erhalten“ auf einer Website tatsächlich zum Geldtransfer führen, wenn man darauf klickt.
Der RedTeamCUA-Benchmark wurde speziell dafür entwickelt, dies zu testen, und gleichzeitig zwei Zahlen zu betrachten: Ob die Arbeit erledigt wurde oder ob man betrogen wurde. Beide Indikatoren von Qwen-CUA haben sich verbessert:
- DieErfolgsquote der Missionstieg von 70,5 in Qwen3.7 auf74,0;
- DieAngriffserfolgsquote (ASR)fiel von 36,6 auf 16,4, was einem Rückgang von 20,2 Prozentpunkten entspricht.
Ein seltener Fall, bei dem beide Seiten profitieren: Die Arbeit wird besser erledigt, und es ist weniger wahrscheinlich, dass man betrogen wird. Diese Verbesserung ist auf drei Plattformen konsistent: dem eigenen Cloud-Speicher, Instant Messaging und Reddit (Tabelle 2).
Der Autor ist jedoch ehrlich:Der ASR von 16,4 ist immer noch ein Restrisiko und keine Sicherheitsgarantie.Auf Rocket.Chat muss der ASR zusammen mit der Erfolgsquote der Aufgaben betrachtet werden - einige Fehler sind auf Blockaden zurückzuführen und nicht auf das Erkennen von Betrügereien.
Was die Leistung im Prüfungssaal betrifft, ist alles gesagt – aber wie schlägt man sich im realen Internet außerhalb des Prüfungssaals?
Praxis: Echtes Plugin Qwen für Chrome
4.2. Nachdem Sie den Prüfungsraum verlassen und das echte Internet betreten haben, zeigt Abbildung 7 einen Browser-Screenshot: Auf der rechten Seite des Bildschirms befindet sich eine zusätzliche Qwen-Seitenleiste. Dies istQwen für Chrome– ein internes Chrome-Plug-in.
Es funktioniert auf echten Websites, und alle Schritte werden Ihnen angezeigt, ohne jegliche Geheimhaltung. Beikritischen Vorgängenwie Zahlungen oder dem Löschen von Dateien erscheint zunächst ein Popup-Fenster, in dem Sie Ihre Zustimmung geben müssen, bevor Sie fortfahren können.
Anhang E enthält auch ein End-to-End-Beispiel: Der Agent kauft selbst einen Cloud-Server im Browser, konfiguriert die Umgebung und führt alle Schritte selbst durch, indem er auf die entsprechenden Schaltflächen klickt. Der Sinn dieser Übung besteht darin, dass der Agent keine Prüfungsaufgaben bearbeitet, sondern in der realen Welt Aufgaben erledigt.
Aber reicht es im wirklichen Berufsleben aus, nur mit der Maus umgehen zu können? Alte Programmierer wissen, dass es auch die Befehlszeile gibt.
Die neunte Runde: Sollte ich ihm eine Befehlszeile geben – Unerwartete Mischung von Bash
In Abschnitt 4.3 wird eine praktische Frage gestellt: Sollte man dem Agenten zusätzlich zu Maus und Tastatur auch Bash zur Verfügung stellen?
Die Antwort lautet:Mit Bash ist der Weg zum Erfolg kürzer, aber die Erfolgsquote sinkt etwas.
Die Abbildung 8 der Arbeit ist in einem Streudiagramm sehr deutlich dargestellt (Achtung: Streudiagramm, kein Balkendiagramm):
- Nach der Installation von Bashist die durchschnittliche Anzahl der Runden in MyPCBench von Qwen-CUA von 63,6 auf 49,1 gesunken;
- aberdie perfekte Abschlussrate ist von 58,7 auf 55,1 gefallen.
Bei Qwen3.7 ist der Trend ähnlich: 69,3 → 53,4 Runden und 51,6 → 41,8 Abschlussrate.
Die Erklärung des Autors lautet:Es geht nicht darum, dass die Befehlszeile nicht konfiguriert werden sollte, sondern dass das Modell noch nicht gelernt hat, „wann es wechseln soll“.Bash bietet einen kürzeren Weg, aber unnötige oder zum falschen Zeitpunkt erfolgende Wechsel können die Genauigkeit beeinträchtigen. Der Autor ordnet dies als „Optimierungsdefizit“ ein und nicht als „Beschränkung der hybriden Schnittstelle“ und erklärt ausdrücklich: „In Zukunft können durch gemeinsames Training und explizite Überwachung der Tool-Routing-Verfahren die Genauigkeit wiederhergestellt und gleichzeitig die Effizienz erhalten werden“.
Dies ist eine sehr wichtige Erinnerung:Die Fülle der Schnittstellen bedeutet nicht, dass die Verwendung ausgereift ist.
Die zehnte Stufe: Ein größeres Gehirn bekommen – Qwen-CUA-Max
4.4 Ein anderer Weg: Vergrößern Sie 397B-A17B direkt aufüber eine Billion Parameterund nennen Sie esQwen-CUA-Max. Verwenden Sie dieselbe Kultivierungsmethode und füttern Sie es mit einem größeren Gehirn.
Ergebnis:
- OSWorld-Verified: 86.2 → 87.6;
- OSWorld 2.0 Binary Completion Rate: 18.5 → 21.2;
- OSWorld 2.0 Partial Completion Rate: 48.4 → 53.3(die größte Verbesserung).
Das heißt, diese Trainingsformel ist nicht veraltet – auch wenn man weitere Parameter hinzufügt, kann man weiterhin Punkte sammeln.
Wir haben über Prüfungsräume, praktische Übungen, Ausrüstung und Upgrades gesprochen – nun kehren wir zum ursprünglichen Problem zurück.
Einige Punkte, die es wert sind, nach dem Lesen erinnert zu werden
Erstens ist der Ansatz „Nur auf den Bildschirm schauen“ machbar, aber langsam und teuer. Der Pixel-Ansatz ist von Natur aus langsamer als der DOM-Ansatz – bei jedem Schritt muss der Screenshot erneut an das Modell übergeben und verarbeitet werden, was jeweils zwischen einigen zehn Millisekunden und einigen hundert Millisekunden dauert. In der Schlussfolgerung des Artikels wird selbst eingeräumt: „Allgemeingültigkeit impliziert nicht Optimiertheit“. Der größte Wert dieses Ansatzes istAllgemeingültigkeit– er funktioniert für Desktop-Software, dynamische Webseiten und professionelle Tools, nicht jedoch für Geschwindigkeit. Wenn Ihre Arbeit in Code oder APIs erledigt werden kann, ist dieser Ansatz kostengünstiger.
Zweitens ist die Betrugsrate von16,4nicht0. Die Reduzierung der Angriffserfolgsrate von 36,6 auf 16,4 durch Qwen-CUA auf RedTeamCUA ist ein großer Fortschritt, bedeutet aber immer noch, dass bei 100 „Bait on Screen“-Angriffen 16 Agenten darauf hereinfallen werden. Diese Zahlen müssen bei der Unternehmensimplementierung durch menschliche Überwachung abgesichert werden – das ist auch der Grund, warum Qwen für Chrome als „Bestätigung von kritischen Aktionen in Popup-Fenstern“ konzipiert ist. Es handelt sich nicht um eine technische Spielerei, sondern um eine echte Notwendigkeit.
Drittensverliert Bash Punkte, wenn es gemischt wird, und ist eine Warnung für den gesamten Bereich der KI-Tools. „Mehr einstellbare Werkzeuge“ bedeutet nicht „bessere Ergebnisse“. Qwen-CUA hat noch nicht gelernt, wann welche Methode angewendet werden sollte, und dies ist der nächste große Schritt für RLHF / agentische RL. Die Autoren der Arbeit haben dies nicht als Ergebnis präsentiert, sondern stattdessen direkt „eine Optimierungslücke“ geschrieben, und diese Ehrlichkeit verdient Anerkennung von Fachkollegen.
Viertenssind interne Plugins nicht öffentlich zugänglich. Qwen für Chrome wird innerhalb des Teams eingesetzt, und in der Arbeit wurde kein Datum für die Veröffentlichung zum Download angegeben. Dies ist eine Einschränkung, die in der Arbeit nicht näher ausgeführt wird: Auch wenn das Modell sehr leistungsfähig ist, hat es ohne einen Zugangspunkt für Entwickler nur die gleiche Wirkung wie die Zahlen in der Arbeit. Für Leser, die sich fragen „Kann ich es heute schon nutzen“, bietet die Arbeit lediglich einen Hinweis auf die Leistungsgrenzen, nicht aber einen Zeitplan für die Produkteinführung.
Fünftenswurde das Max-Modell mit den Parametern von 1T nur beiläufig erwähnt. Die Arbeit enthält keine separaten Abschnitte zur Analyse der Trainingskosten, der Inferenzverzögerung und der Leistungsunterschiede zwischen Max und der Basisversion. Aus technischer Sicht ist 1T ein „kleines Upgrade“ im Zeitalter der großen Modelle, aber die Trainingskosten für RL, die KV-Cache-Auslastung und der Speicherbedarf für die Inferenz langer Trajektorien wurden nicht im Detail offengelegt. Um die Ergebnisse von Max zu reproduzieren, reichen die Informationen in der Arbeit nicht aus.
Zusammenfassung in einem Satz
Wenn man KI nur erlaubt, auf einen Bildschirm zu schauen und mit einer Maus und einer Tastatur zu interagieren, kann sie tatsächlich lernen, Aufgaben zu erledigen – sie übertrifft ihre Vorgänger in allen acht Benchmarks und kann mit Closed-Source-Konkurrenten mithalten. Aber lernen heißt nicht, dass man sie auch einsetzen kann: Die Betrugsrate von 16,4 % bleibt bestehen, der Pixel-Ansatz ist teuer und langsam, und die gemischte Verwendung von Tools ist nicht immer sinnvoll. Qwen-CUA liefert keine endgültige Lösung, sondern eine technische Veranschaulichung des Konzepts einer „universellen visuellen Schicht“ als grundlegende Komponente für hybride Agenten.
Abhandlung: Qwen-CUA: Native Computernutzung für (fast) alles arXiv: https://arxiv.org/abs/2608.02352 Projekt-Homepage: https://github.com/xlang-ai/Qwen-CUA