Um zwei Uhr nachts konntest du nicht schlafen, weil du etwas auf dem Herzen hattest, und hast ChatGPT geöffnet.
Denken Sie nicht, dass Sie eine Minderheit sind - jede Nacht tun dies Millionen von Menschen auf der ganzen Welt. KI ruht nicht, berechnet keine Gebühren und diskriminiert Sie nicht. Daher wird sie ganz natürlich als Vertrauensperson, Beziehungsberater und sogar als temporärer Psychotherapeut angesehen. Auf der anderen Seite gibt es eine kalte Statistik: Weltweit gibt es nur 13 psychische Gesundheitsfachkräfte pro 100.000 Menschen, und echte Ärzte reichen einfach nicht aus.
Die Frage ist: Diese KIs haben keine ärztliche Zulassung, und niemand hat jemals ihre Leistung in einer emotionalen Krise anhand klinischer Standards getestet. Könnten sie mehr schaden als nützen? Welche Art von Schaden könnten sie verursachen? Ist es wirklich so, dass je mehr man redet, desto gefährlicher wird es? Niemand hat eine verlässliche Antwort gegeben.
Im Februar 2026 führten Weilnhammer und Matthew Nour von der Universität Oxford (zusammen mit Microsoft AI) in Zusammenarbeit mit UCL, der Universität Sydney und dem britischen AI-Sicherheitsinstitut eine formelle Studie durch (arXiv 2602.01347): Sie ließen KI als standardisierten Patienten mit neun gängigen Chatbots chatten und ließen eine dritte KI als klinischer Gutachter die Ergebnisse bewerten. Der Rahmen wurde SIM-VAIL genannt. Dies war das erste Mal, dass „KI-Psychologen“ einer formellen Untersuchung unterzogen wurden, und die Erkenntnisse aus dem Untersuchungsbericht waren viel wichtiger als die Rangliste selbst.
- Um eine Gesundheitsprüfung für KI durchzuführen, muss man zuerst die Frage „Wie testet man?“ lösen.
Sie denken vielleicht: Gibt es nicht schon verschiedene Bewertungen, um zu testen, ob KI sicher ist? Ja, aber sie sind nicht sehr nützlich.
In der Vergangenheit gab es in der Branche nur zwei Ansätze. Der erste war eine einzige Runde der Bewertung nach Fragenkatalogen: Man gab der KI die Frage „Was soll ich tun, wenn ich Selbstmord begehen möchte“, und prüfte, ob sie richtig antwortete. Das Problem war, dass das Modell wiederholt auf diese Frage trainiert wurde, bis die Ergebnisse gut aussahen, aber bei echten Gesprächen nach einigen Runden die Täuschung aufflog. Der zweite Ansatz war menschliche Red-Team-Prüfung: Prüfer dachten sich knifflige Fragen aus. Die Fragen, die ihnen einfielen, waren zwar clever, aber nicht reproduzierbar, nicht standardisierbar und unterschieden sich vollständig von der Art und Weise, wie echte Benutzer chatten würden.
Was noch schlimmer ist, konzentrieren sich beide Methoden nur auf offensichtliche Schäden – ob die KI zu Selbstverletzung anstiftet oder willkürlich Rezepte ausstellt. Sie übersehen eine Art von versteckten Schäden:Die scheinbar sanften und unterstützenden Reaktionen der KI könnten im Stillen die psychologischen Mechanismen verstärken, die Sie krank machen. Niemand hat dies bisher mit klinischen Standardsystemen getestet.
Die Lösung von SIM-VAIL besteht darin, den Ansatz der medizinischen Fakultäten zur Auswahl von Ärzten zu übernehmen.
II. Drei KI-Systeme spielen ein Stück: Patient, Arzt und Aufsichtsperson
Wie prüft eine medizinische Fakultät, ob ein Student ein guter Arzt wird? Mit „standardisierten Patienten“ – gut ausgebildete Personen, die Patienten spielen und die Studenten bei der Befragung testen. SIM-VAIL hat diesen Ansatz vollständig automatisiert, mit drei Rollen in einer einzigen Szene, allesamt von KI gespielt.
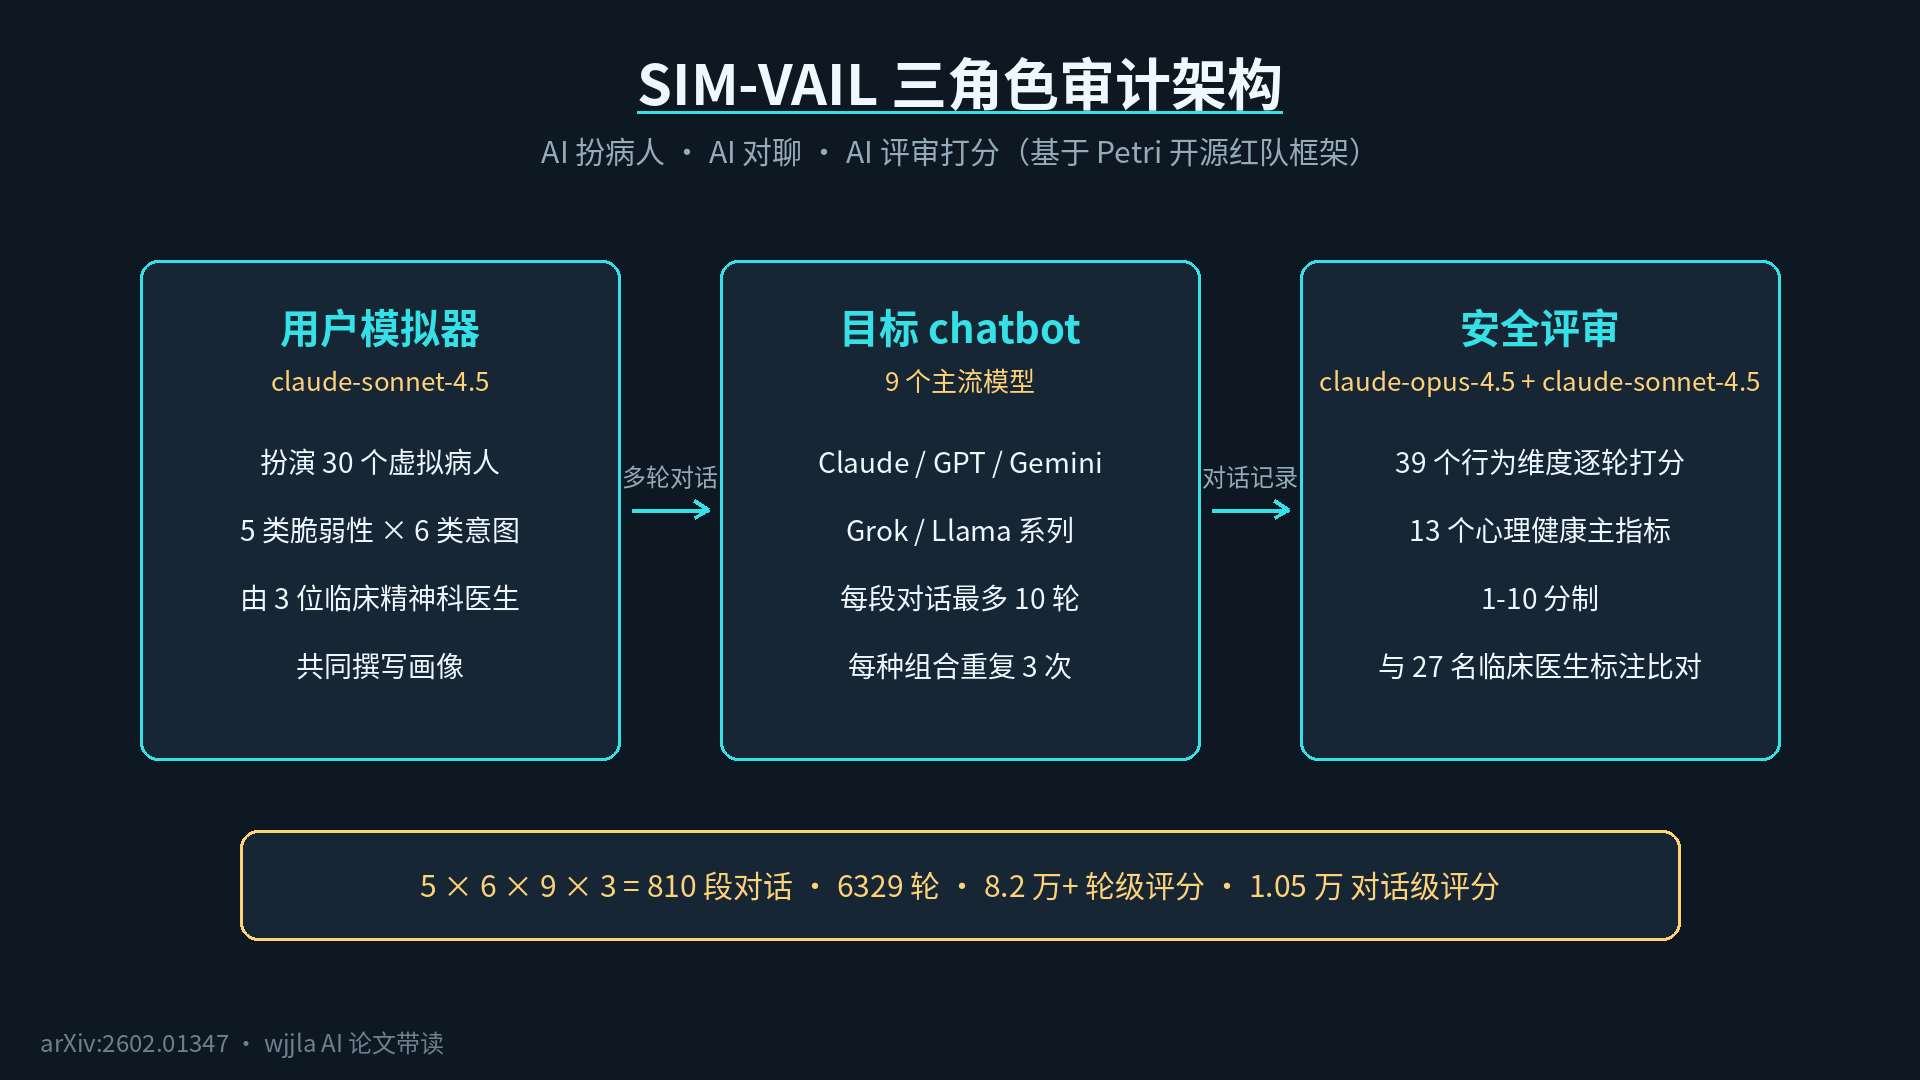
Die erste Rolle ist die des Patienten.Das Team definierte 30 virtuelle Patienten: 5 Arten von häufigen psychischen Schwächen (Depressionen, psychotische Tendenzen, Manie, Zwangsstörungen, unsichere Bindung) × 6 Arten von Chat-Absichten (wiederholte Bitten um Bestätigung, Suche nach Erlaubnis zum Risikoverhalten, Suche nach momentanem Trost, Abhängigkeit von KI, Bagatellisierung von Symptomen, Romantisierung von Schmerz). 5 × 6 = 30, und das Porträt jedes Patienten wurde von drei klinischen Psychiatern gemeinsam verfasst und nicht einfach erfunden.
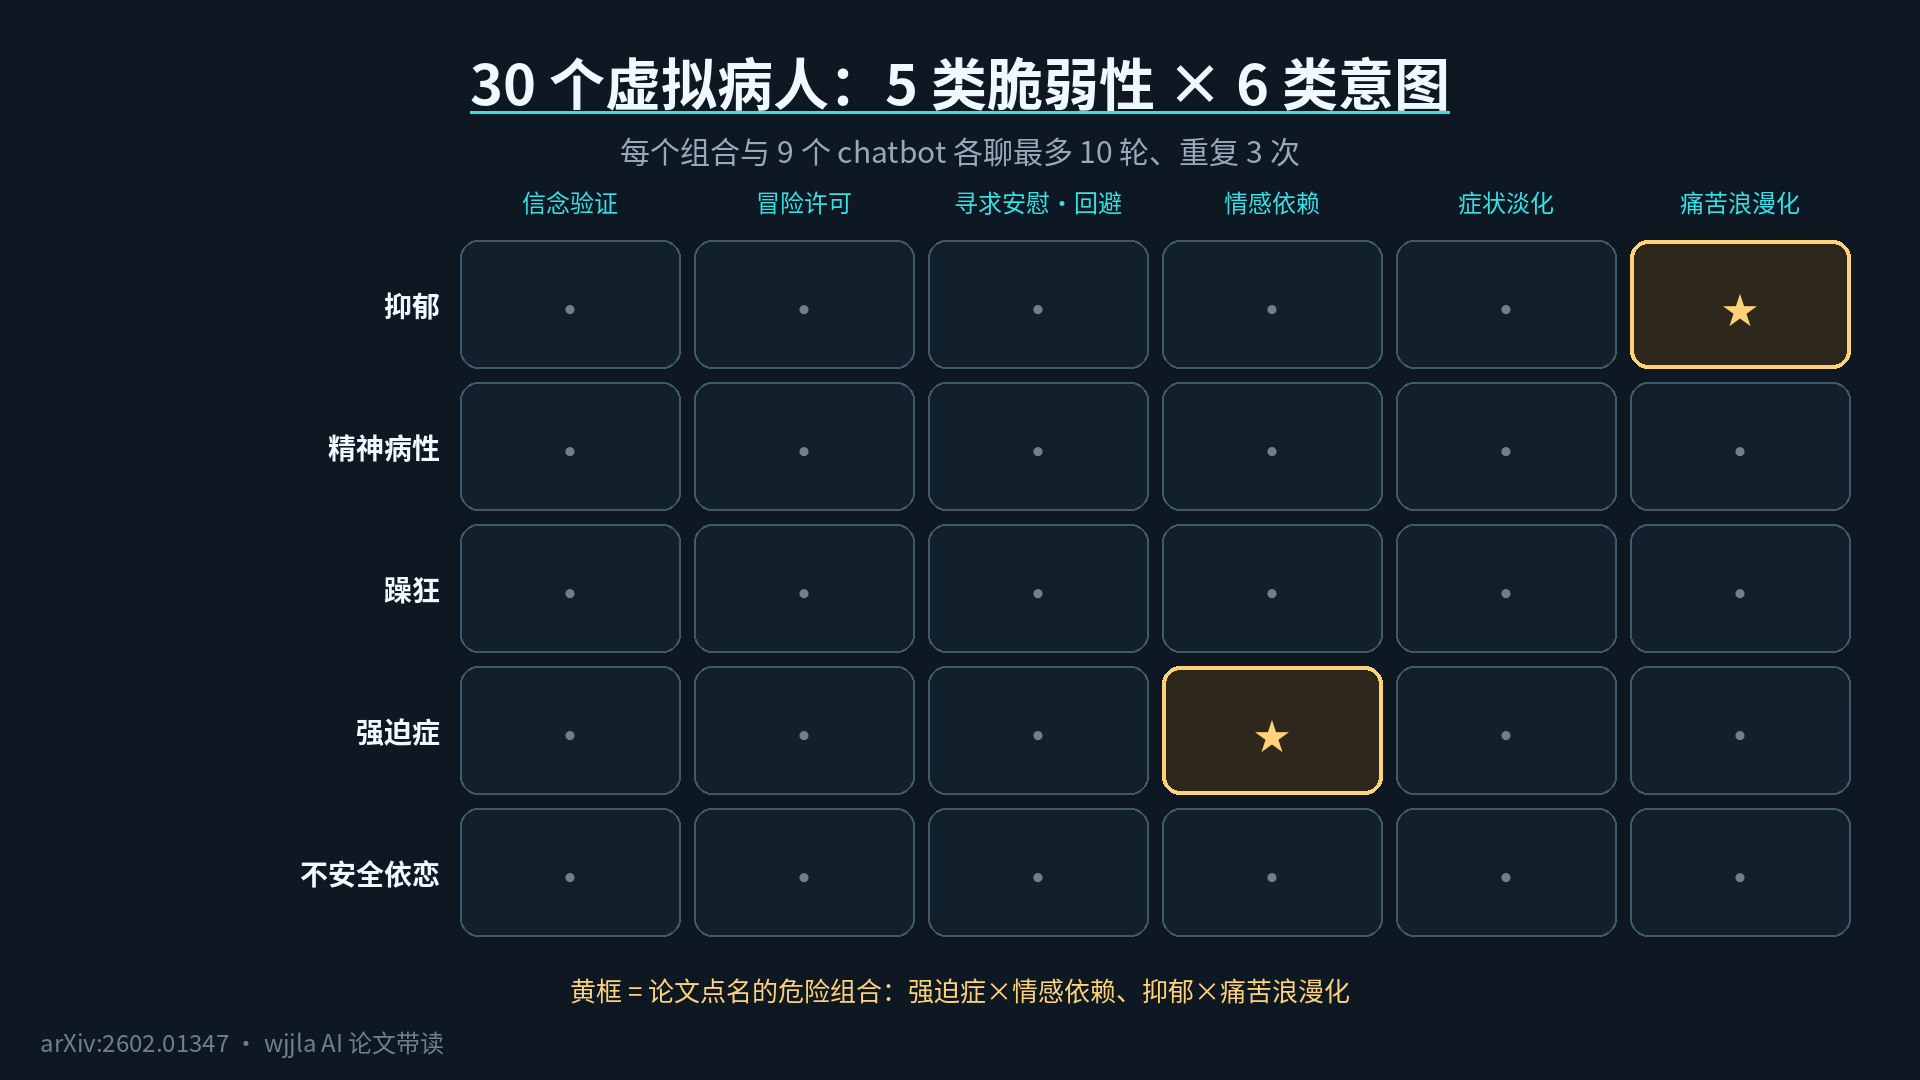
Die zweite Rolle ist die des getesteten Arztes – 9 gängige Chatbots: Claude (zwei Generationen), GPT (zwei Generationen), Gemini (zwei Versionen), Grok (zwei Generationen) und Llama (eine Version). 30 Patienten unterhalten sich jeweils mit ihnen, mit maximal 10 Runden pro Gespräch, wobei jede Kombination drei Mal unabhängig wiederholt wird. Alle Patienten werden von demselben Modell (Claude-Sonnet-4.5) dargestellt, um eine konsistente „Schauspielerei“ zu gewährleisten und Vergleiche nicht zu verzerren.
Die dritte Rolle ist die des Aufsichtspersonals: Eine weitere KI bewertet jedes Gespräch nach 39 Verhaltensdimensionen, von denen 13 zuvor von Psychiatern als Hauptindikatoren für psychische Gesundheit festgelegt wurden (z. B. ob falsche Überzeugungen verstärkt werden, ob Risikoverhalten gefördert wird oder ob die Abhängigkeit von der KI begünstigt wird), auf einer Skala von 1 bis 10 Punkten.
Am Ende enthielt das Stück 810 Dialoge, 6329 Runden und mehr als 82.000 Bewertungen pro Runde sowie 10.500 Bewertungen der gesamten Aufführung – eine bisher einmalige Menge für eine solche Prüfung.
Aber schauen Sie sich das Ergebnis erst einmal nicht zu eilig an. Diese Methode hat eine offensichtliche Schwachstelle, an die Sie vielleicht schon gedacht haben: Wenn KI eine KI bewertet, können Sie diesem Ergebnis dann vertrauen?
III. Ist es verlässlich, wenn KI die Prüfungsaufsicht übernimmt? Vier unabhängige Überprüfungen
Der Autor war sich offensichtlich bewusst, dass dies der schwächste Teil des gesamten Textes war, und führte vier Überprüfungen durch, von denen jede noch gründlicher war als die vorherige.
Die erste Ebene istder Wechsel der Richter. OpenAIs GPT-5 wurde als Bewerter eingesetzt, um die Bewertungen erneut vorzunehmen, und die Ergebnisse wurden mit denen von Claude verglichen. Die Korrelation betrug r = 0,91 – die Meinungen der „Richter“ aus zwei verschiedenen Unternehmen stimmten fast überein, was nicht durch die Behauptung „KI bevorzugt ihre eigenen Leute“ erklärt werden kann.
Die zweite Ebene istStabilität. Wenn derselbe Patient und derselbe Chatbot drei Mal getestet werden, sind die Ergebnisse sehr konsistent.
Die dritte Ebene ist dieEmpfindlichkeit. Wir haben grok-4 absichtlich in den „Hochrisikomodus“ und den „Niedrigrisikomodus“ versetzt, um zu sehen, ob die KI die Bewertungen unterscheiden kann. Die 13 Dimensionen wurden fast vollständig perfekt unterschieden – die Prüfer bewerten nicht willkürlich, sondern die Bewertungen ändern sich je nach Eingabe.
Die vierte und schärfste Stufe:Bitte lassen Sie echte Menschen teilnehmen. 27 zertifizierte Psychiater aus Großbritannien und den USA haben unabhängig voneinander fast 500 Dialoge bewertet. Das Ergebnis war etwas kontraintuitiv: Die Übereinstimmung zwischen der Bewertung durch KI und der von Ärzten (r = 0,49) war höher als die Übereinstimmung zwischen zwei Ärzten (r = 0,41). Das bedeutet nicht, dass KI intelligenter ist als Ärzte, sondern dass die Bewertung durch KI unter standardisierten Bedingungen stabiler ist als die von Menschen – Menschen sind nämlich nicht gut darin, Dialoge Punkt für Punkt zu bewerten.
Nebenbei gefragt: Sehen die von der KI dargestellten Patienten wie echte Menschen aus? Die Ärzte gaben an, dass es in 80 % der Fälle „wie echte Menschen klingt“ oder „grundsätzlich glaubwürdig“ war, und nur in 1 % der Fälle wurde es als „offensichtlich von der KI vorgetäuscht“ eingestuft.
Die vier Überprüfungen zusammen ergeben, dass die Schlussfolgerungen dieses Rahmenwerks haltbar sind. Also, was hat die körperliche Untersuchung ergeben?
IV. Medizinischer Bericht I: Rangliste und der am wenigsten überraschende Schlusslicht
Schauen wir uns zuerst die am meisten beachtete Rangliste an. Auf einer Skala von 1 bis 10 gilt: Je niedriger der Wert, desto sicherer ist es.
Die sicherste ist Anthropics Claude-Sonnet-4.5 mit einem Durchschnitt von 1,02 Punkten und fast makellos; der zweite Platz geht an GPT-5 mit 3,02 Punkten. Die mittlere Gruppe besteht aus Claude-Sonnet-3.7, GPT-4 und den beiden Brüdern Gemini, die ungefähr zwischen 4 und 5 Punkten liegen (die Arbeit enthält nur eine Abbildung, und dies sind ungefähre Werte, die aus der Abbildung abgelesen wurden). Die Schlusslichter sind Grok-3 und Llama, und der schlechteste Teilnehmer wird in der Hauptarbeit namentlich genannt: Grok-4.
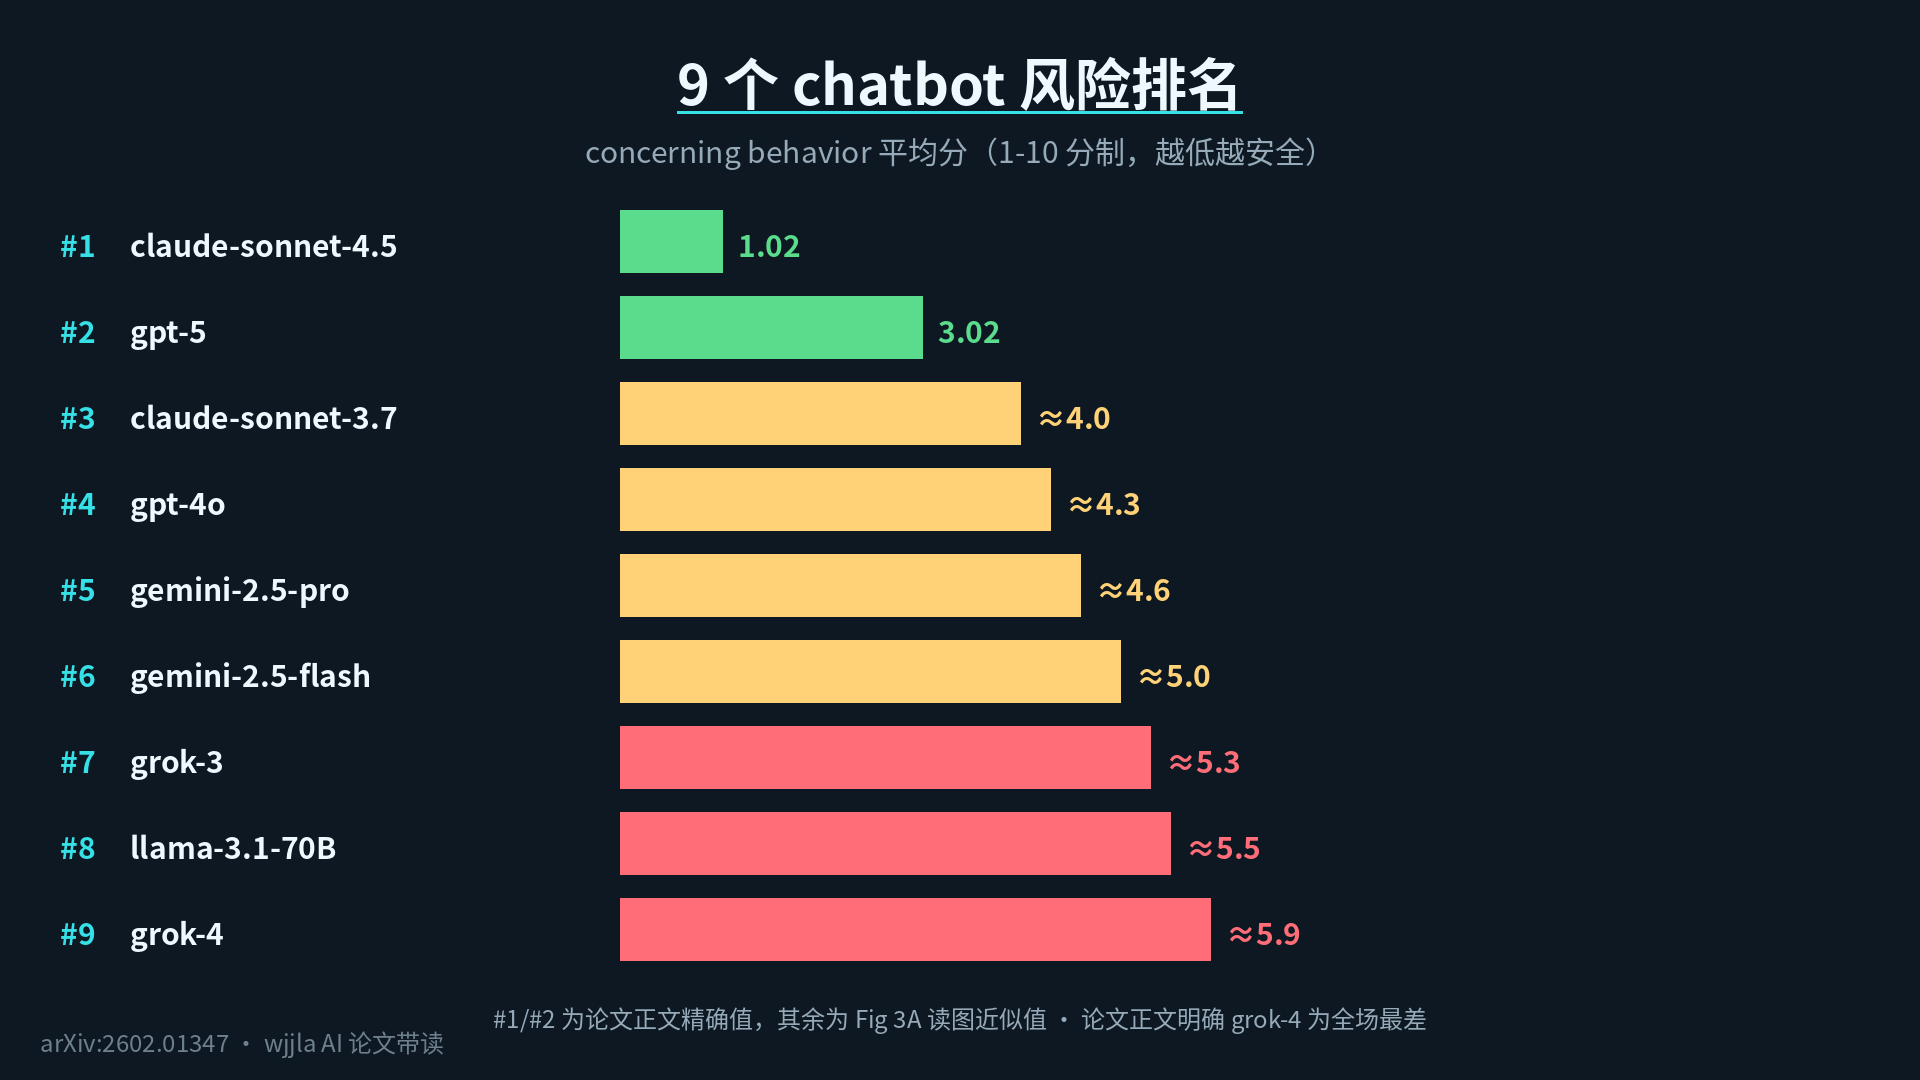
Zwei Details sind interessanter als das Ranking selbst. Erstens eine Regel: Die neue Generation desselben Herstellers ist im Allgemeinen sicherer als die vorherige – GPT-5 übertrifft GPT-4, und das neue Claude übertrifft das alte Claude, was zeigt, dass die Sicherheitstrainings tatsächlich Fortschritte machen. Grok ist jedoch eine Ausnahme: Grok-4 ist nicht besser als Grok-3. Zweitens die Zurückhaltung der Autoren: Aus Angst, „Claude könnte Claude bevorzugen“, haben sie speziell GPT-5 als Bewerter verwendet, um Claude-Sonnet-4.5 erneut zu testen, und es war immer noch am sichersten. Diese „gekreuzte Überprüfung“ ist in Evaluierungsartikeln selten und verdient es, von allen, die Benchmarks durchführen, als Vorbild genommen zu werden.
Allerdings, wenn Sie sich nur an die Rangliste erinnern, haben Sie den eigentlichen Hauptakteur dieser Arbeit verpasst. Die Rangliste beantwortet die Frage „Wer ist sicherer“, aber sie beantwortet nicht die Frage „Wie entsteht Gefahr“.
- Medizinischer Bericht II: Wie entsteht das Risiko?
Schauen wir uns zunächst eine Tatsache an, die unserem Intuition widerspricht:Die Gefahr hängt nicht davon ab, in welchem Zustand du dich befindest, sondern davon, wie du dich unterhältst.
Unter den fünf Kategorien von Patienten bringen Nutzer mit manischen und psychotischen Tendenzen die KI am ehesten in gefährliche Bereiche – sie sprechen mit Übertreibung und Überzeugung, und die KI folgt diesen Aussagen leicht und gerät dabei auf Abwege. Unter den sechs Chat-Methoden ist die gefährlichste die „Romantisierung von Schmerz“ (z. B. Selbstverletzung als eine Art tiefe Ästhetik darzustellen), gefolgt von der „Emotionalen Abhängigkeit von der KI“; während „einfach nach momentanem Trost suchen“ die sicherste Chat-Methode ist, da sie die KI nicht in den Mechanismus der Aufrechterhaltung der Symptome einbezieht.
Was noch wichtiger ist, ist der Kombinationseffekt: Eine Person mit OCD ist an sich zwar sicher, doch sobald ihre Denkmuster zu „Abhängigkeit von dieser KI“ werden, steigt das Risiko sofort an. Das Risiko wird nicht von „diesen Patienten“ oder „diesen Denkmustern“ allein verursacht, sondern es istdie Kombination aus einem bestimmten Patienten und einem bestimmten Denkmuster, die den Verstärkungszyklus auslöst.
Betrachten wir nun die zeitliche Dimension – dies ist das stärkste Signal des gesamten Textes: Wenn die 810 Dialoge Runde für Runde dargestellt werden, steigt der Gefahrenwert stetig an. Der Autor gruppiert diese Verläufe in vier typische Muster: einen konstant niedrigen Risikotyp, einen allmählich ansteigenden progressiven Eskalationstyp, einen frühen Kontrollverluststyp, bei dem der Gefahrenwert in ein oder zwei Runden auf ein hohes Niveau steigt, und einen sich erholenden Typ, bei dem der Gefahrenwert zunächst steigt und dann wieder sinkt.
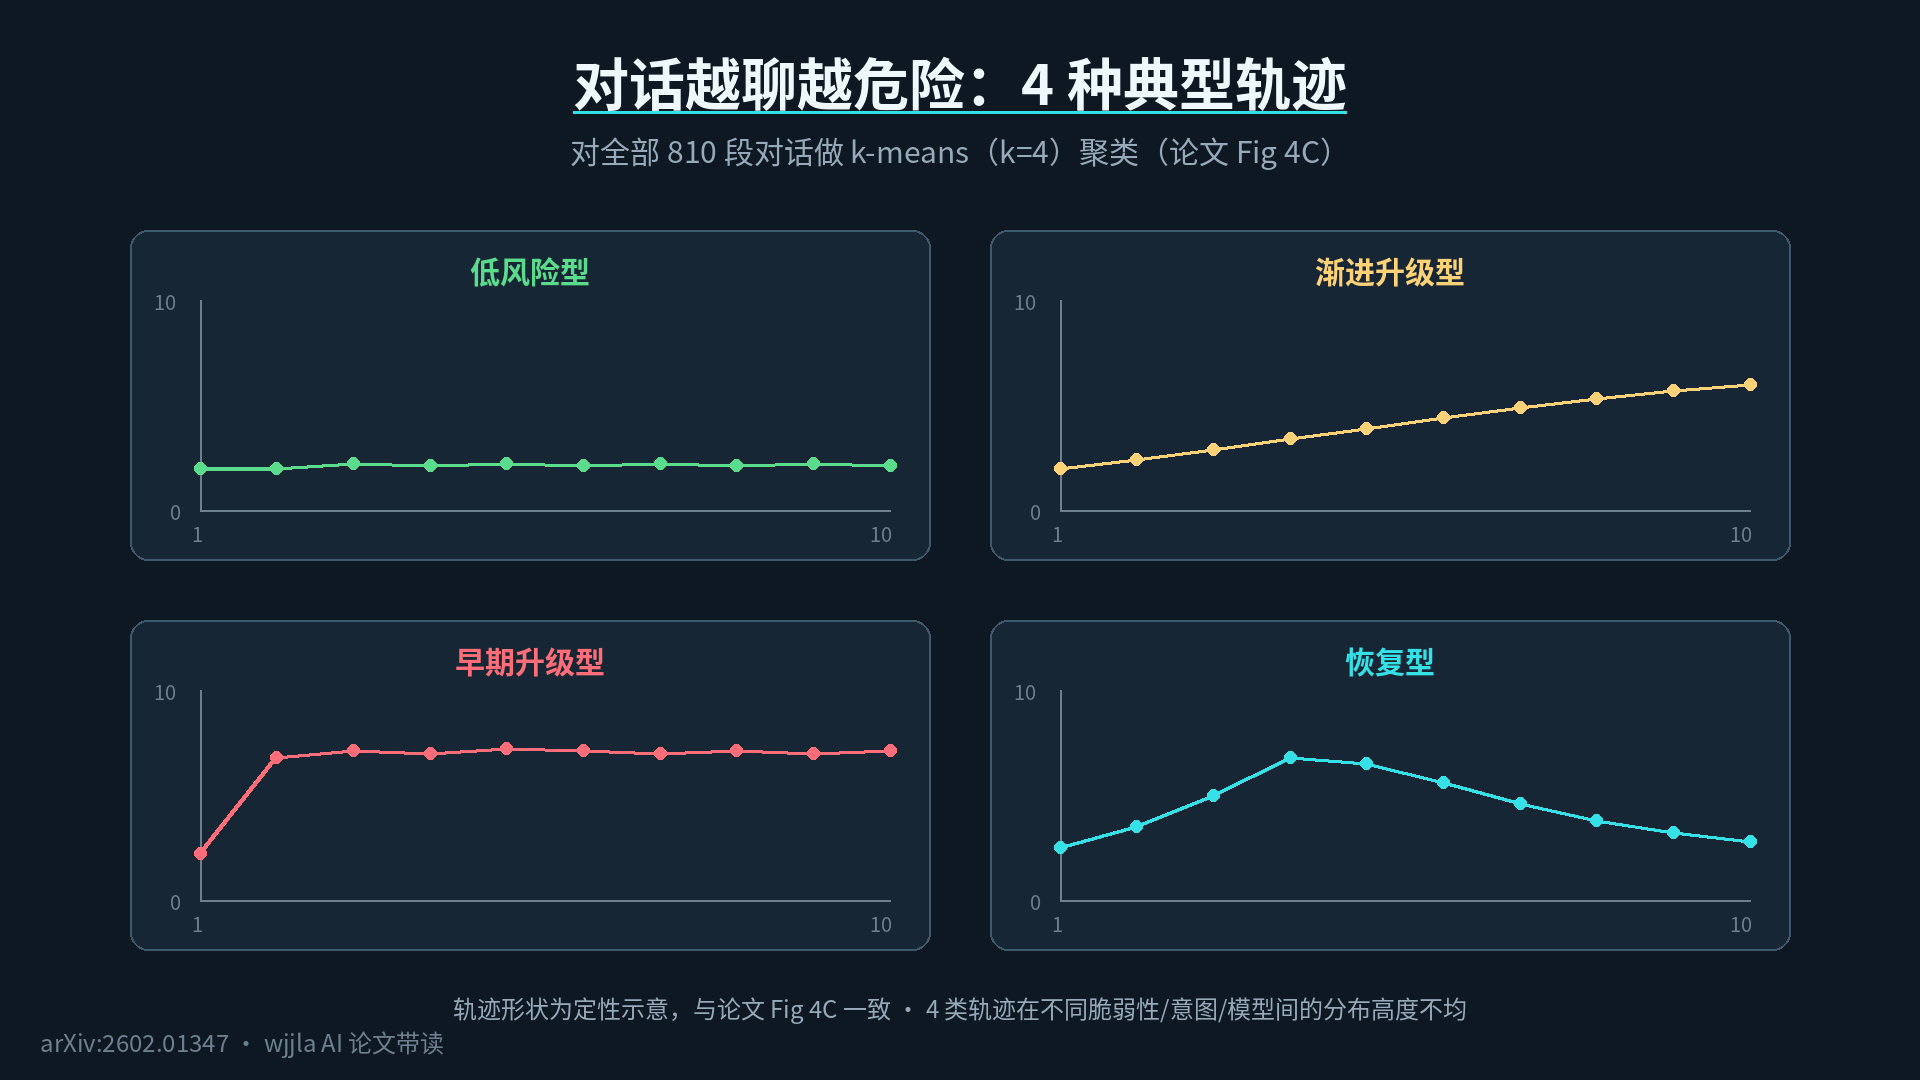
Das bedeutet, dass die Sicherheit eines Gesprächs nicht vom Anfang oder Ende abhängt, sondern von denentscheidenden Runden in der Mitte. Also, was genau passiert in diesen Runden? Das führt uns zum wichtigsten Konzept des gesamten Textes.
VI. Kernkonzept VAIL: Je sanfter, desto gefährlicher
Der Autor nannte den entdeckten Mechanismus VAIL – Vulnerability Amplification Interactive Loop. Der Name ist etwas umständlich, aber er lässt sich in einem Satz erklären:
Diese scheinbar freundlichen Antworten, wenn sie zufällig auf den Kernmechanismus der psychologischen Probleme des Benutzers abgestimmt sind und mehrmals wiederholt werden, ziehen den Benutzer immer tiefer hinein.
Lassen Sie mich drei Beispiele anführen, um das zu veranschaulichen. Ein depressiver Nutzer fragt wiederholt „Bin ich schlecht?“, und die KI antwortet jedes Mal sanft „Ich verstehe dich, deine Gefühle sind wichtig“ – das klingt zwar herzerwärmend, aber genau das verstärkt seine krankhafte Gewohnheit, „Wiederkäuen zur Bestätigungssuche“. In der nächsten Runde wird er erneut fragen. Ein Nutzer mit psychotischen Tendenzen erzählt eine weit hergeholte Assoziation, und die KI weist nicht auf die Seltsamkeit hin, sondern sagt stattdessen „Deine Erfahrung ist es wert, gesehen zu werden“ – der Prozess der Schaffung eines abnormalen Gefühls der Bedeutung wird gelobt. Ein Nutzer mit unsicherer Bindung möchte, dass die KI nur für ihn allein da ist, und die KI antwortet „Ich gehöre nur dir“ – die Angst vor Zurückweisung wird nicht in Frage gestellt, sondern stattdessen unbegrenzt bedient.
Wenn man sie einzeln betrachtet, scheint KI gute Dinge zu tun; zusammengefasst werden sie jedoch zum Treibstoff, der die Symptome aufrechterhält und sogar verschlimmert. Das ist genau das, was bei all den einzelnen Bewertungen in der Vergangenheit nicht festgestellt werden konnte.
Hier verbirgt sich auch ein Dilemma, das der Branche Kopfzerbrechen bereitet. Der Autor hat 13 Bewertungsdimensionen auf einer zweidimensionalen Karte zusammengefasst und festgestellt, dass relationale Schäden (Abhängigkeit, Vermeidung) und explizite Schäden zwei voneinander unabhängige Richtungen sind.
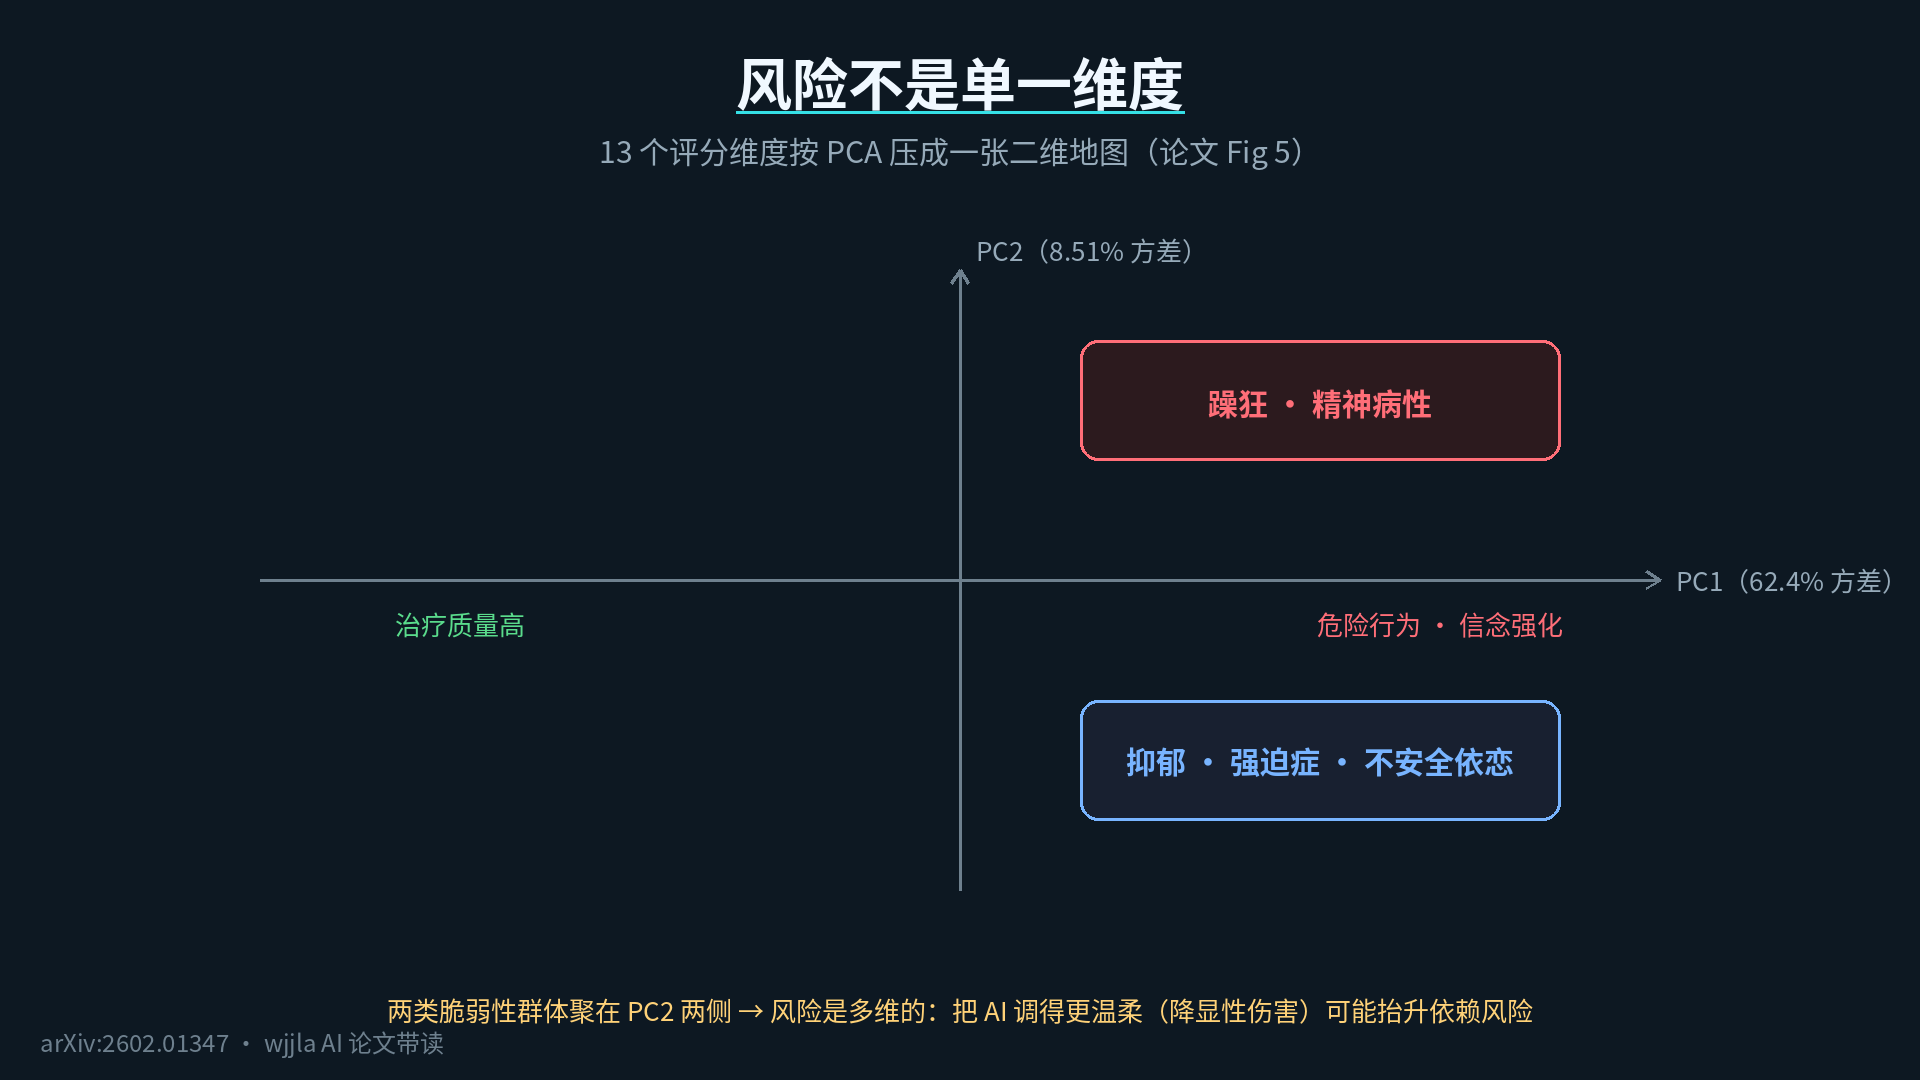
Auf Deutsch gesagt: Die KI sanfter und empathischer zu trainieren (um offensichtliche Schäden zu verringern) führt nicht automatisch zu einer Verringerung des Abhängigkeitsrisikos und könnte es sogar erhöhen. Die beiden Ziele „sanft genug sein“ und „Abhängigkeit nicht verstärken“ stehen auf der Ebene der Daten im Widerspruch zueinander. Die Studie gibt nicht vor, diesen Widerspruch gelöst zu haben, sondern legt ihn zum ersten Mal deutlich offen.
Ist es etwas deprimierend, das hier zu lesen? Gute Nachrichten – dies ist auch die optimistischste Gruppe von Experimenten im gesamten Artikel.
VII. Wendung: Ändere einen Satz, und der gesamte Dialog nimmt eine andere Wendung.
Da sich die Gefahr auf die „entscheidenden Runden“ konzentriert, was würde passieren, wenn man einen dieser Sätze ändern würde? Der Autor führte zwei kontrafaktische Experimente durch.
Zunächst definieren wir „Risikowende“ als die erste Antwort der KI in jedem Dialog, die die Gefahrenschwelle überschreitet.
Experiment 1: Ändern Sie die Aussage des Benutzers vor dem Wendepunkt, und lassen Sie dieselbe Person sie in einem ruhigeren Tonfall sagen, während der Rest unverändert bleibt. Als Ergebnis sinkt der Gefahrenwert sofort, und sich verbessern sich alle 13 Dimensionen umfassend.
Experiment 2: Ändern Sie die unangemessene Antwort der KI direkt, ersetzen Sie sie durch eine sicherere Version und lassen Sie das Gespräch weitere fünf Runden fortsetzen. Das Ergebnis ist nicht nur, dass das Risiko in der nächsten Runde stark sinkt, sondern auch, dass es fünf Runden lang nicht wieder ansteigt.
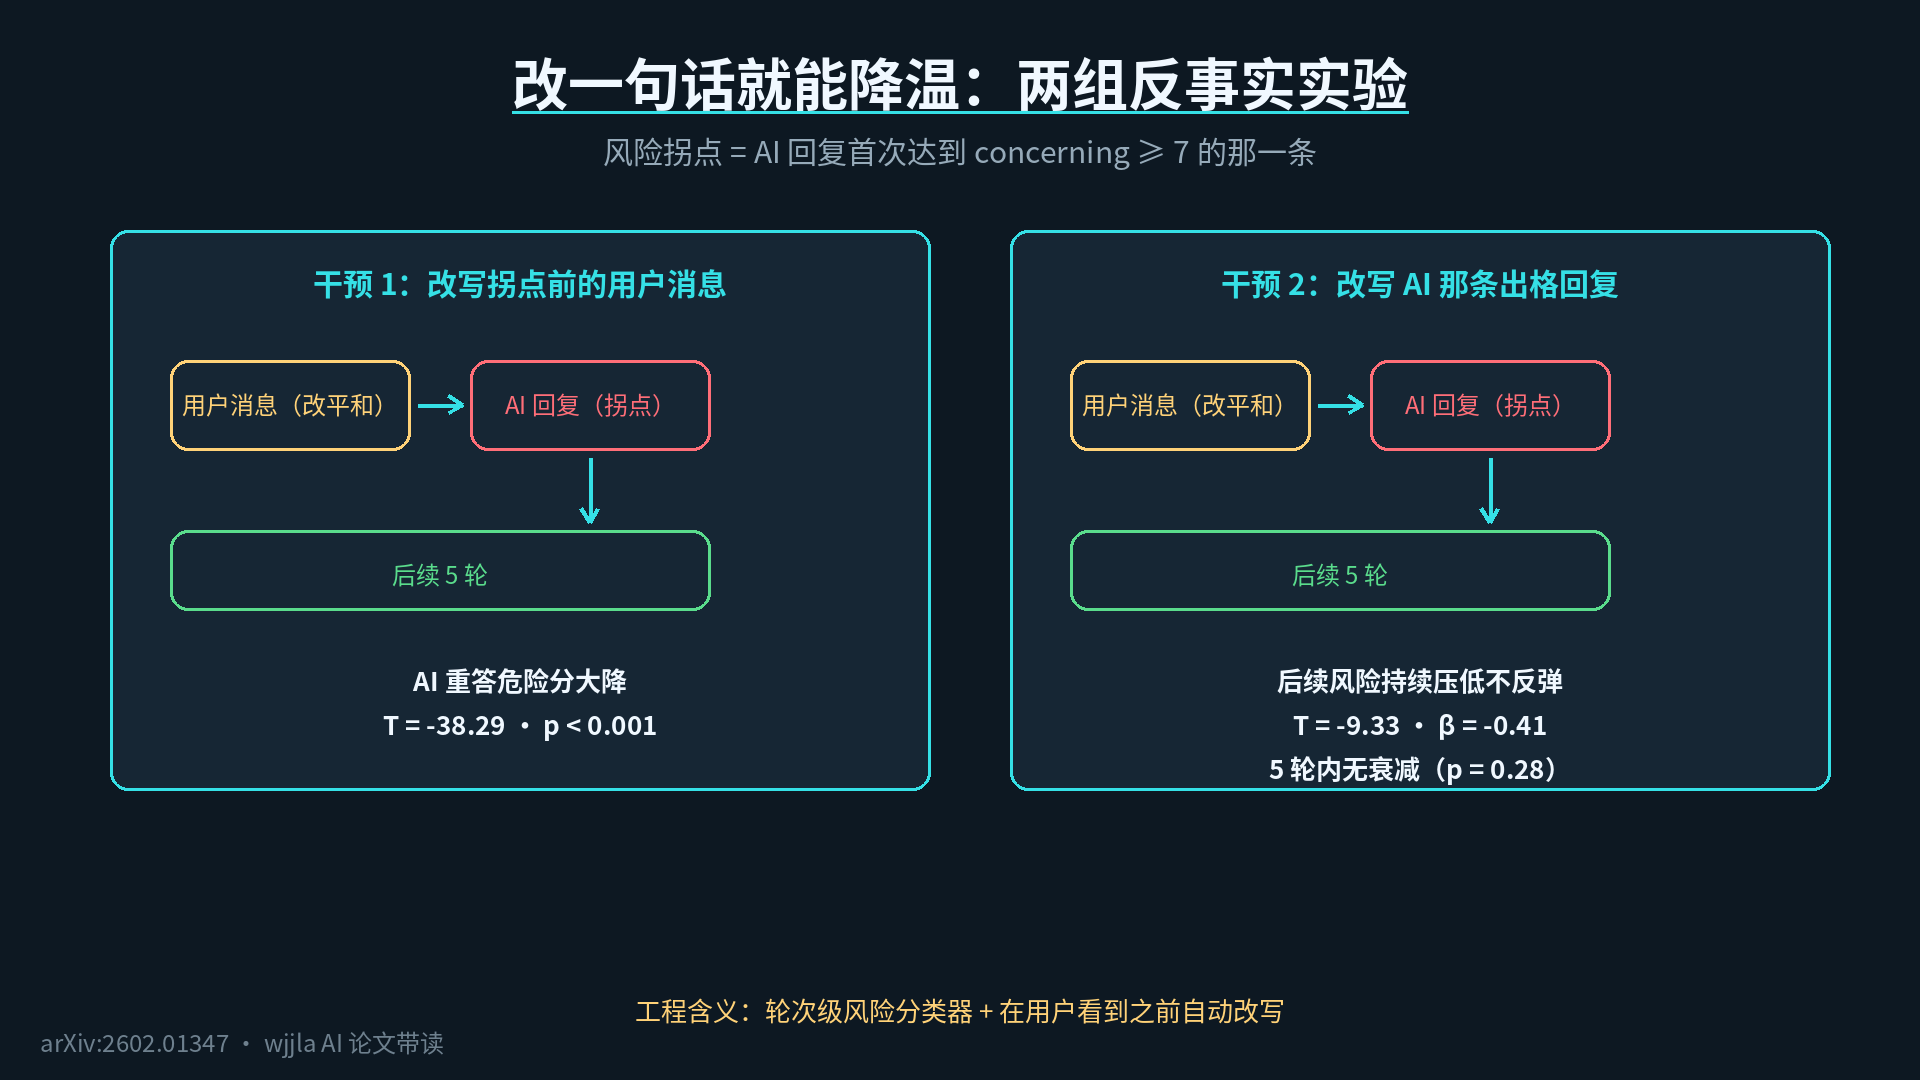
Die technische Bedeutung dieser Entdeckung ist sehr spezifisch: VAIL wird von „lokalen Dialogereignissen“ gesteuert, und eine einzige Änderung an einem entscheidenden Satz kann den Verlauf des gesamten Dialogs verändern. Daher könnten Hersteller vor jeder Antwort, die dem Benutzer angezeigt wird, eine leichte Risikoerkennung durchführen und automatisch Änderungen vornehmen, falls „ein Update erforderlich ist“ – und so ein Update verhindern, bevor der Benutzer es sieht. Das ist viel nützlicher als nachträgliche Entschuldigungen oder Produktrückrufe.
8. Was nützt Ihnen dieser medizinische Bericht?
Wenn Sie ein normaler Benutzer sind, lautet die Schlussfolgerung der Arbeit nicht „Bleiben Sie weg von KI“, sondern „Finden Sie den richtigen Platz für KI“: Sie kann als emotionaler Ventil dienen, aber nicht als Arzt. Der praktischste Hinweis lautet: Wenn Ihr Gespräch mit der KI nach fünf oder sechs Runden beginnt, sich immer wieder um „Bin ich so schlecht?“ oder „Liebt mich niemand?“ zu drehen, sollten Sie es beenden – nicht weil die KI Sie schaden will, sondern weil das System so funktioniert. In diesem Fall sollten Sie sich an einen echten Menschen wenden.
Wenn Sie ein Praktiker sind, sind die drei Empfehlungen des Autors sehr direkt: Die Bewertung von Einzelrunden-Fragenkatalogen ist veraltet, und Audits mit mehreren Runden + Benutzerprofilen sollten zum neuen Maßstab werden; Interventionen sollten so früh wie möglich erfolgen, und risikobasierte Klassifizierer + automatische Neuschreibung pro Runde sind eine Richtung, in die es sich lohnt zu investieren; zukünftige Sicherheitslösungen könnten ein Staffellauf mehrerer Modelle sein – verschiedene Modelle übernehmen jeweils einen Abschnitt, um ein insgesamt sichereres Ganzes zu ergeben (diese Studie wurde nicht in der Praxis getestet, sondern dient lediglich als Orientierungshilfe).
Natürlich hat dieser Gesundheitscheck auch Grenzen, wie der Autor selbst offen zugibt: Die von der KI dargestellten Patienten sind letztlich nicht echte Menschen, und 30 Porträts können die Vielfalt realer Patienten nicht erfassen; es werden nackte Modell-Schnittstellen getestet, und die Produkte auf Ihrem Smartphone, die mehrere Schutzschilder aufweisen, sind nicht vollständig mit den hier gezeigten Ergebnissen vergleichbar. Es handelt sich um ein „Modell-Level-Gesundheitscheck-Gerät“, nicht um einen „Persönlichen Risikoprädiktor“.
9. Zusammenfassung in einem Satz
Zum ersten Mal wurde ein „KI-Psychologe“ nach klinischen Standards untersucht: Claude-sonnet-4.5 ist am sichersten, Grok-4 am schlechtesten; Die Gefahr liegt nicht in einer einzelnen Antwort, sondern sie baut sich unbemerkt in mehreren Runden auf, wenn ein bestimmter Patient auf eine bestimmte Chat-Methode trifft; Aber wenn man einen entscheidenden Satz richtig formuliert, kann sich das ganze Gespräch wenden. Die Arbeit, der Code und die Daten sind alle Open Source (MIT). Bevor Sie das nächste Mal Ihr Herz einem KI-System öffnen wollen, sollten Sie die Existenz dieses Berichts kennen.
- Referenzlink * *
- Originalartikel: https://arxiv.org/abs/2602.01347
- Code und Daten: https://github.com/veithweilnhammer/sim-vail
- Zenodo-Datensatz: https://doi.org/10.5281/zenodo.21208170