Die arXiv-Publikation (2607.22529), die im Juli 2026 vom Qwen-Team von Alibaba veröffentlicht wurde, konzentriert sich im Kern darauf, die „Skill Library“ zu einem Curriculum-Engine für das selbstspielende Training von LLMs zu machen. Dieser Artikel stapelt keine Fachbegriffe, sondern konzentriert sich darauf, was genau gelöst wurde, wie es gelöst wurde und ob es sich lohnt, Zeit in die Umsetzung zu investieren.
- Das eigentliche Problem: Das Training im selbstspielenden Modus steckt in einer Sackgasse bezüglich „Vielfalt“ und „Verifizierbarkeit“.
In den letzten zwei Jahren hat sich das LLM-Trainingsparadigma von „menschlich annotiert + SFT“ zu „Selbstevolution“ verschoben. Der Kerngedanke besteht darin, dass das Modell selbst Trainingsdaten generiert und sich selbst bewertet. Doch auf diesem Weg stieß man im Jahr 2026 auf einen sehr spezifischen Widerspruch:
- Environment-bound-Ansatz(z. B. LLM schreibt Code und führt anschließend Unit-Tests durch): Die Rückmeldung ist präzise, aber der Bereich der ausführbaren Aufgaben ist sehr begrenzt und beschränkt sich im Wesentlichen auf solche Szenarien, die maschinell überprüfbar sind, wie z. B. Programmierung und mathematische Beweise.
- Open-ended-Self-Generation-Ansatz(LLM schreibt eine Aufgabe und lässt LLM anschließend selbst bewerten): Der Bereich der Aufgaben ist breit, aber das Belohnungssignal ist unzuverlässig. Das Modell lernt sehr leicht, „den Bewerter zu täuschen“, und sobald die Belohnung gehackt wird, bricht das Training zusammen.
Diese beiden Probleme machen jeweils die Hälfte der Fehlschläge in der Industrie aus. Der Ansatzpunkt von Skill Self-Play (im Folgenden Skill-SP genannt) ist:Skills (Fertigkeiten)sind von Natur aus ein Mittelweg – eine Skill ist eine wiederverwendbare „strukturierte Ausführungsfähigkeit“, die für eine einzelne Aufgabe ausreichend tief ausgeführt und hochgradig überprüfbar ist, und die dann auf eine andere Aufgabe übertragen und durch dynamisches Routing erweitert werden kann, um den Abdeckungsbereich zu vergrößern.
Nachdem ich den Artikel gelesen habe, ist mein größter Eindruck: Es handelt sich nicht um eine philosophische Argumentation, dass „Fertigkeiten ein Mittelweg sind“ – es behandelt Fertigkeiten direkt als ausführbare Objekte und erstellt eine dynamische Bibliothek, die von RL-Frameworks aktualisiert, weitergeleitet und ausgemustert werden kann. Dieser Ansatz, „abstrakte Konzepte in handhabbare technische Objekte umzusetzen“, ist viel praktischer als die „Fähigkeitsgrenze“, die im Titel des Artikels zum Ausdruck gebracht wird.
II. Drei Rollen: Vorschlagender / Löser / Fähigkeitskontrolleur
Die Architektur von Skill-SP ist sehr übersichtlich und besteht im Kern aus drei Rollen, die sich im RL-Loop gemeinsam weiterentwickeln:
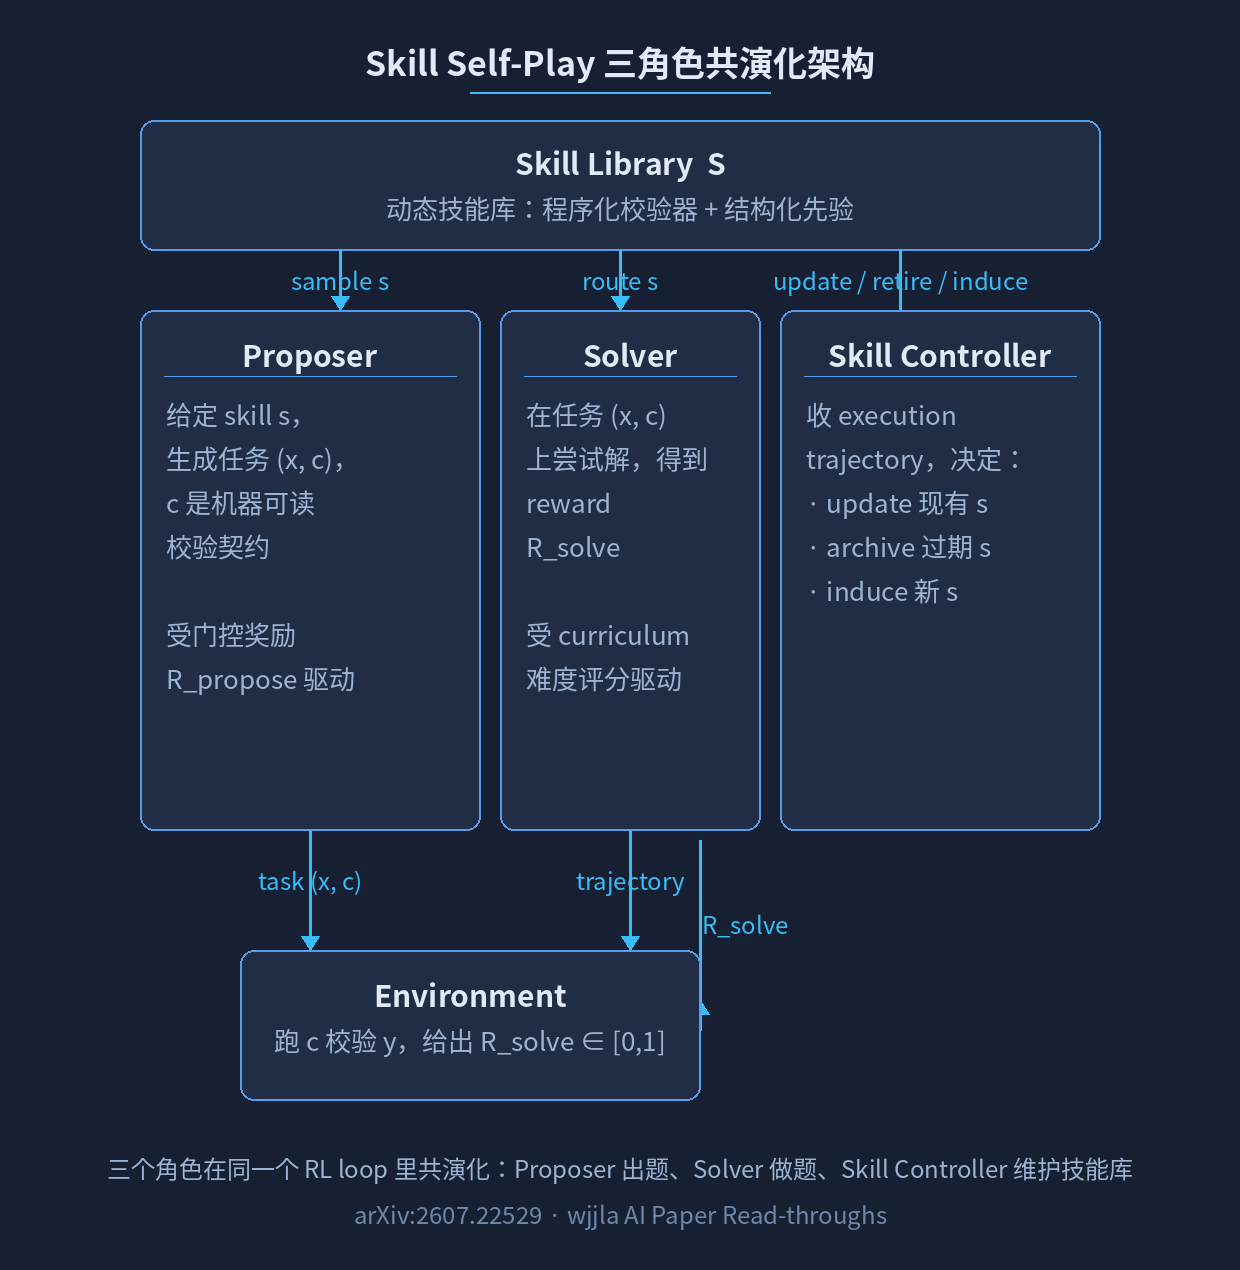
DerProposerkonzentriert sich auf eine Sache: Für eine aus dem Skill-Pool S gezogene Fertigkeit s erstellt er einen (Prompt x, Verifikationsvertrag c). c muss maschinenlesbar sein – in der Arbeit werden Unit-Tests und Referenzantworten als Beispiele genannt. Der Proposer erhält keine Belohnung für die Schwierigkeit der Aufgabe, sondern eine gated-curriculum-Belohnung – nur wenn der Aufgabenvertrag (x, c) strukturell legal ist, wird er mit „Schwierigkeit nahe 0,5“ bewertet, ansonsten wird er auf Null gesetzt. Dieser Schritt ist ein wichtiges Designmerkmal, das in der Arbeit hervorgehoben wird: Er schließt explizit die „Möglichkeit zum Belohnungshacking“ aus. Der Proposer kann nicht versuchen, „ein extrem schwieriges Problem vorzutäuschen“, da die Vertragsprüfung vor der Schwierigkeitsbewertung stattfindet.
DerSolverführt eine traditionellere Aufgabe aus: Angesichts von (x, c) generiert er die Antwort y, die Umgebung führt c aus, um dies zu überprüfen, und gibt R_solve zurück. Das Trainingsziel des Solvers besteht darin, von dem Proposer gestellte Fragen zu trainieren – allerdings stellt der Proposer keine zufälligen Fragen, sondern wird durch einen Curriculum-Score dazu geführt, auf der aktuellen „Lernfront“ des Solvers zu landen (in der Arbeit wird dieser Score als „medium-difficulty score“ bezeichnet, die Formel lautet „1 - 2|v_solve - 0.5|“, und das Ziel ist, die Erfolgsrate des Solvers auf nahezu 0,5 zu bringen, da dies genau der Bereich ist, in dem das Modell „mit etwas Anstrengung richtig antworten kann“).
DerSkill Controllerist das interessanteste technische Design dieses Artikels – es handelt sich nicht um eine statische Liste von Fertigkeiten, sondern um eine dynamisch gepflegte Bibliothek. Drei Arten von Operationen:
1.Aktualisieren: Basierend auf der Ausführungspfad des Solvers für eine bestimmte Fertigkeit, verfeinert man die Prüfungslogik dieser Fertigkeit (z. B. durch Hinzufügen von Tests für Grenzfälle). 2.Archivieren: Wenn eine Fertigkeit mehrere Runden hintereinander nicht ausgelöst wird, wird sie als veraltet markiert und aus der Hauptbibliothek entfernt. 3.Induzieren: Neue wiederverwendbare Strukturen werden aus dem offenen Generierungsstrom entdeckt, automatisch zu neuen Fertigkeiten verpackt und in die Bibliothek aufgenommen.
Die tatsächlichen Messungen im Papier: Nach 5 Iterationen steigt die Anzahl der effektiven Fertigkeiten (Shannon-Entropie-gewichtet) von 1 auf 46, und die Anzahl der aktiven Fertigkeiten auf 86 – was bedeutet, dass der Fertigkeitenpool während des Trainingsprozesses tatsächlich erweitert wird und der Proposer nicht auf einigen wenigen festen Fertigkeiten herumreitet.
III. Das wichtigste im Engineering-Design: Wie verhindert man, dass der Skill-Pool durch „Musterkollaps“ beeinträchtigt wird?
Das klassische Fehlermuster beim Spieltraining wird alsModellkollapsbezeichnet: Wenn der Vorschlaggeber feststellt, dass die Fragen zu einer bestimmten Fertigkeit vom Löser sehr stabil beantwortet werden, verwendet er sie wiederholt, und die Verteilung der Trainingsdaten verengt sich auf einige hochfrequente Fertigkeiten. Skill-SP hat hier drei Schutzmaßnahmen ergriffen:
3.1 Dual-Stream-Sampling (Dual-Stream-Sampling)
Es werden nicht 100 % der Aufgaben aus der Skill-Bibliothek übernommen. Der tatsächliche Anteil im Paper (Abbildung 4, abgeleitet aus den Ablationsversuchen):
- Skill-Stream: Ein Skill s wird aus der Skill-Bibliothek S ausgewählt, und der Proposer generiert Aufgaben darum herum. Dieser Teil sorgt dafür, dass „die Schwierigkeit an der Spitze des Solvers stabil bleibt“.
- Exploration-Stream: Der Skill ist nicht festgelegt, und der Proposer generiert Aufgaben frei —— um die Vielfalt der Aufgaben zu erhalten und einen Zusammenbruch zu verhindern.
Ich habe in der Arbeit keine genauen Zahlen für die tatsächlichen Verhältnisse gefunden, aber die Ergebnisse zeigen: Das reine Skill-Only-Training (100% Skill-Stream) führt zu einem durchschnittlichen Rückgang von 4,1 Punkten; das reine Unguided-SP-Training (0% Skill-Stream) führt zu einem durchschnittlichen Rückgang von 2,6 Punkten; nur der gemischte Stream (der Mischungsverhältnis wird nicht offengelegt, aber der Titel der Arbeit deutet darauf hin, dass beide Wege parallel existieren) führt zu einer stabilen Verbesserung. Dies zeigt, dass Skill-SP nicht darauf abzielt, das offene, selbstgenerierende Lernen zu eliminieren, sondern Skill als ein „Regulierungsventil“ einsetzt, um das Gleichgewicht zwischen der Schwierigkeit und der Vielfalt der Aufgaben zu steuern.
3.2 Schwierigkeitsbewertung mit Gatekeeping (Gatekeeping-Curriculum-Belohnung)
Dies ist der wichtigste Teil der Mathematik in der Arbeit, also werde ich ihn separat behandeln:
Der Belohnungsfunktion R_propose des Vorschlaggebers ist nicht einfach „Schwierig = Gut“, sondern:
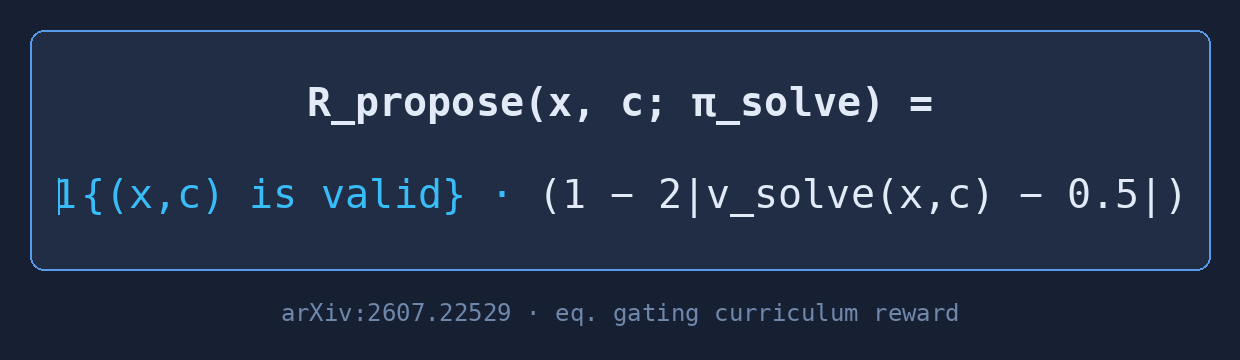
Der erste Ausdruck 𝟙{(x,c) is valid} ist ein binärer Filter: Der Aufgabenvertrag (x,c) muss strukturell gültig sein (die Maschine muss in der Lage sein, die Validierung von c durchzuführen), um Punkte zu erhalten, andernfalls beträgt R_propose = 0. Der zweite Ausdruck ist eine Bewertung mittlerer Schwierigkeit: Je kleiner |v_solve - 0.5|, desto höher ist die Punktzahl – das heißt, der Proposer sollte Aufgaben stellen, die den aktuellen Erfolgsanteil des Solvers in der Nähe von 0.5 halten.
Warum 0,5 und nicht 0,1 (extrem schwierig) oder 0,9 (extrem einfach)? Weil:
- Zu schwierig (v_solve ≈ 0): Der Löser erhält keine Lernsignale, und die Belohnung ist sehr unzuverlässig.
- Zu einfach (v_solve ≈ 1): Man lernt nichts Neues, und es ist praktisch dasselbe wie das Lösen von Aufgaben ohne daraus zu lernen.
- 0,5 ist der optimale Wert, bei dem „man es mit etwas Anstrengung schaffen kann“, und der Lernprozess konvergiert am schnellsten.
Das Gating ist der Schlüssel - ohne es würde der Proposer lernen, „Fragen zu erstellen, die zwar kompliziert erscheinen, aber keine Lösung haben“, und die Belohnungen würden direkt auf Null gesetzt, um ihn dazu zu zwingen, echte Fragen zu erstellen. Das ist es, was der Titel des Artikels mit Co-Evolving Skills meint - es handelt sich nicht nur um die Weiterentwicklung der Skill-Bibliothek, sondern darum, dass Proposer, Skill und Solver sich gegenseitig „erziehen“.
3.3 Die spezifische Implementierung des Skill Controllers
Die Arbeit enthält keinen vollständigen Code (Patentschutz des Qwen-Teams), aber sie gibt einen Überblick über drei Operationen:
- Update: Ein Skill-Paket = (ausführbare Vorlage, Prüfer-Code, mehrere Beispiele) als Dreierpack. Der Controller erhält die Trajektorie des Solvers für diesen Skill, und falls sich das Fehlermuster auf einen bestimmten Bereich konzentriert, werden automatisch Testfälle hinzugefügt.
- Archivieren: Es wird eine „Kühl-Warteschlange“ verwaltet, in die Skills verschoben werden, die N Runden (ich habe keinen konkreten Wert für N gefunden) hintereinander nicht von Proposer-Proben ausgewählt wurden, um Kapazität im Hauptspeicher freizugeben.
- Induzieren: Dieser Schritt ist am interessantesten. Der Controller führt eine leichte Clusteranalyse durch (mit all-MiniLM-L6-v2 + PCA, siehe Abbildung 5b), um hochfrequente „programmierte Strukturen“, die im Exploration-Stream generiert wurden (z. B. „immer nach der Deduplizierung und Sortierung der Liste fragen“), automatisch in neue Skill-Pakete zu gruppieren.
Diese Induce-Kette ermöglicht es in der Praxis, „automatisch wiederverwendbare Prämissen aus Datenverteilungen zu entdecken“ – sie folgt dem gleichen Ansatz wie die Optionserkennung im traditionellen RL oder hierarchisches RL, wird aber auf die Daten-Synthese von LLMs angewendet und ist ein neuer Aspekt im Jahr 2026.
- Experimentelle Daten: Wer profitiert von den Vorteilen und wer nicht?
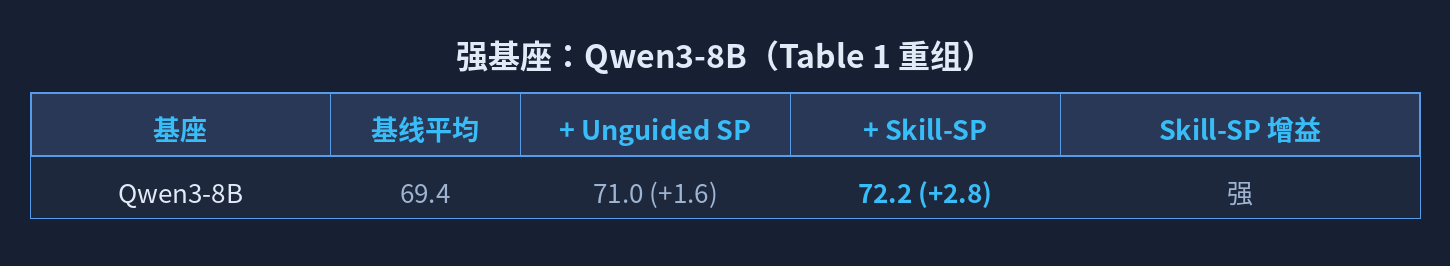
Paper führt Bewertungen in zwei Bereichen durch: Werkzeugaufruf (API-Bank + BFCL vier Kategorien) und logische Schlussfolgerung (ZebraLogic vier Schwierigkeitsgrade). Tabelle 1 enthält die Kern-Daten, die ich nach „Basismodellgröße“ neu organisiert habe:
Starkes Fundament über 8B (Qwen3-8B)
Ein schwacher Sockel unter 8B (wie der Ministral-3-8B, der von Natur aus schwer zu trainieren ist)
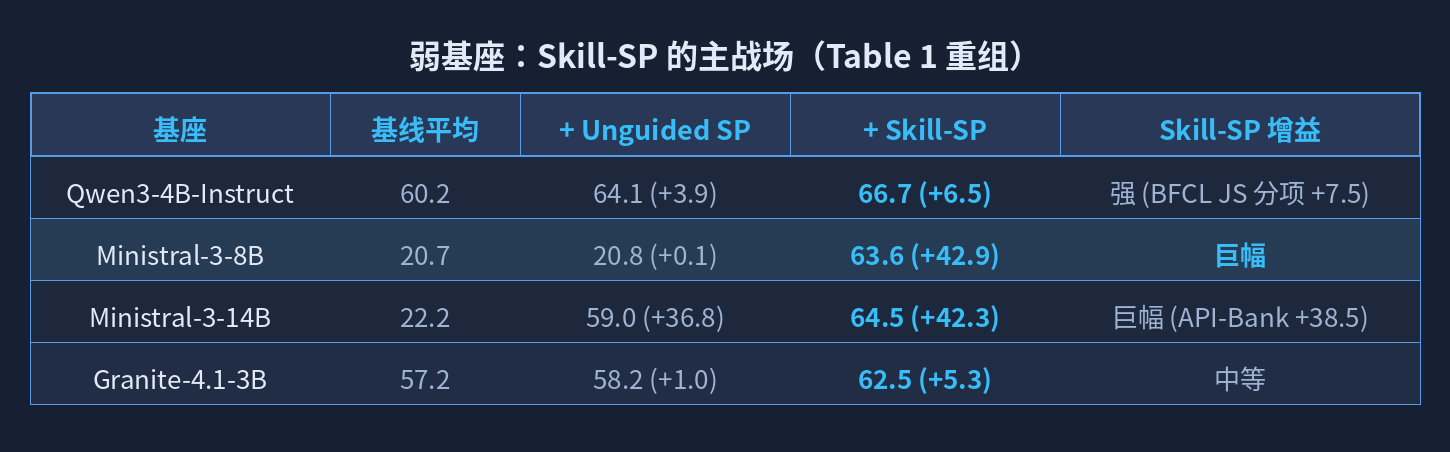
Die interessanteste Zeile in dieser Tabelle istMinistral-3-8B: Der Basiswert beträgt nur 20,7 Punkte (was bedeutet, dass man kaum Werkzeuge anpassen kann), Unguided SP ist völlig hoffnungslos (+0,1), aber Skill-SP steigt direkt auf 63,6 (+42,9). Dies liegt daran, dass Ministral aufgrund einer schwachen Basis nicht einmal weiß, „welche Fragen gestellt werden sollen“. Unguided SP lässt es sich frei entfalten = es stellt schlechte Fragen. Skill-SP gibt ihm einen Skill-Pool, der ihm einen „Vorsprung“ gibt, welche Werkzeuganfragen gestellt werden sollen, was einer zusätzlichen Lernkurve entspricht.
Im Vergleich zu Qwen3-8B, einem bereits sehr starken Basismodell, kann Skill-SP ebenfalls zulegen (+2,8), allerdings mit einer deutlich geringeren Steigerung. Dies bestätigt eine industrielle Intuition:Der Grenznutzen des selbstlernenden Trainings ist umgekehrt proportional zum Basismodell– je schwächer das Basismodell, desto mehr Curriculum-Anleitung wird benötigt, je stärker das Basismodell, desto selbstständiger kann es sein. Es ist kein Zufall, dass das Qwen-Team den eigentlichen Verkaufsargument von Skill-SP auf „schnell verfügbare kleine Modelle“ konzentriert hat.
5. Schmelzexperiment: Welches Teil wird beim Abschneiden zusammenbrechen?
Die Auflösung von Paper ist relativ zurückhaltend und konzentriert sich hauptsächlich auf vier Aspekte:
Hack 1: Keine Skill-Routing (Unguided SP)
Dies ist ein Basisvergleich, den wir bereits gesehen haben: In kleinen Modell-Szenarien steigt es praktisch nicht (Ministral-3-8B +0,1), in großen Modell-Szenarien steigt es leicht (+1,6). Schlussfolgerung: Skill-Routing ist der zentrale Wert, und wenn es vollständig entfernt wird, degeneriert es zu einem normalen Selbstspiel.
Hack 2: Nur Skill-only (100% Skill-Stream, Hack-Exploration)
Das Training, das nur auf Fähigkeiten basiert, verliert Punkte auf allen Plattformen, im Durchschnitt 4,1 Punkte. Intuitive Erklärung: Wenn die Fragen nur auf der Grundlage vorhandener Fähigkeiten gestellt werden, verengt sich die Verteilung der Aufgaben allmählich auf einige häufig verwendete Fähigkeiten, und die Löser werden in diesen Fähigkeiten sehr geübt, aber ihre allgemeinen Fähigkeiten verschlechtern sich (typischer Überanpassung an die Trainingsverteilung).
Hack 3: Statischer Skill-Pool (eingefrorene Skills)
Die gefrorene Fertigkeitsdatenbank (die Fertigkeit entwickelt sich nicht dynamisch während des Trainings) fällt im Durchschnitt um 2,3 Punkte. Dies zeigt, dass die drei Funktionen Update/Archiv/Induzieren des Skill Controllers tatsächlich funktionieren und nicht nur Dekoration sind.
Schritt 4: Einheitliches Routing (uniformes Routing, kein dynamisches Routing basierend auf Ausführungsfeedback)
Das einheitliche Routing erzielte eine Durchschnittspunktzahl von 1,9. Dies zeigt, dass das dynamische Routing (der Controller entscheidet anhand der tatsächlichen Leistung des Solvers in verschiedenen Fertigkeiten, welche Fertigkeit mehr trainiert werden sollte) effektiver ist als die statische Zuweisung.
Die vier Punkte lassen sich in einem Satz zusammenfassen:Jede Ebene von Skill-SP ist notwendig, und das Weglassen einer einzigen Ebene beeinträchtigt die Wirkung, insbesondere bei kleinen Modellen.
VI. Einige Punkte, an die ich nach dem Lesen des Papiers selbst erinnern möchte
(Im Folgenden sind meine Beurteilungen basierend auf dem Inhalt des Papiers, nicht alles davon wird im Papier selbst gesagt.)
1. Das Training ist nicht billig
Die Arbeit gibt keine genauen Angaben zu den GPU-Stunden an, aber fünf Iterationsrunden × das Training von fünf verschiedenen Basen unterschiedlicher Größe + zwei Aufgabenbereiche erfordern grob geschätzt mindestens einige tausend GPU-Stunden. Das ist nicht etwas, das ein einzelner Entwickler direkt nachvollziehen kann. Wenn Sie es selbst ausprobieren möchten, empfehlen wir, zunächst ein oder zwei Testrunden mit einem 7B-Modell durchzuführen, um zu sehen, ob der Skill-Pool stabil wächst.
2. Der anfängliche Bestand an Fähigkeiten in der Fähigkeitsdatenbank ist von entscheidender Bedeutung
Der Artikel erwähnt nicht im Detail, wie die anfänglichen Samen für die Fähigkeitsdatenbank erhalten wurden (wurden Hunderte von ihnen manuell von dem Qwen-Team markiert, oder wurden sie durch mehrere Runden des Bootstrap-Verfahrens von Induce erzeugt?), aber es ist sehr wahrscheinlich, dass Teams wie Qwen menschliche Samen verwenden. Wenn Sie es selbst versuchen möchten,ist die Investition am lohnendsten nicht in RL-Algorithmen, sondern in die anfängliche Qualität der Fähigkeitsdatenbank. Dies ist ein häufiges Muster des „Datenflugrads“ in Industrieprojekten: In der Anfangsphase bestimmen menschliche Samen die Obergrenze, und in der späteren Phase sorgt die automatische Weiterentwicklung für kontinuierliche Verbesserungen.
- Die Anwendungsszenarien sind begrenzt.
Die beiden Bereiche, die in der Arbeit validiert werden (Toolaufruf + logische Schlussfolgerung), sind beide Szenarien mitklaren, maschinenprüfbaren Verträgen. Wenn es Ihnen um offene Dialoge / kreatives Schreiben geht, also Szenarien ohne c, ist Skill-SP nicht direkt anwendbar. Die Prinzipien können jedoch als Vorbild dienen: Teilen Sie die „Aufgabequalität“ in einen maschinenprüfbaren Proxy auf (z. B. Länge, Diversitätsbewertung, Stil-Embedding), fügen Sie einen gated Reward hinzu, und im Wesentlichen bleibt alles gleich.
- Es ist nicht RLHF, aber es ergänzt RLHF.
Die Arbeit trainiert Proposer + Solver mit RL-Algorithmen wie GRPO (es wird nicht spezifiziert, welche Arbeit genau gemeint ist, aber anhand der Code-Referenzen scheint es aus dem Bereich des VERL-Frameworks zu stammen). Dies unterscheidet sich von der „Trainierung des Belohnungsmodells“ im RLHF-Ansatz – die Belohnungen für Skill-SP kommendirekt aus der Umgebung, ohne den Schritt des menschlichen Präferenzmodells. Dies macht es in Szenarien, in denen die Belohnung „überprüfbar“ ist, stabiler als RLHF, aber umgekehrt ist es in Szenarien, in denen die Belohnung eine menschliche Bewertung erfordert, immer noch auf RLHF angewiesen. Die beiden Paradigmen stehen nicht in einer Beziehung von Substitution zueinander.
VII. Zusammenfassung in einem Satz
Die Ingenieurphilosophie von Skill Self-Play lautet:Erkenne, dass LLM zwar unzuverlässig ist, aber schneide ihm nicht alle Spielräume ab — fasse es in einer überprüfbaren, erweiterbaren und entwicklungsfähigen Fertigkeitsdatenbank ein und lasse es in dieser Datenbank frei agieren. Dieser Ansatz ist für diejenigen, die LLM trainieren, ebenso unerlässlich wie für diejenigen, die an Agentensystemen arbeiten — Sie benötigen nicht das vollständige Skill-SP-Framework, aber die Abstraktion „dynamische Pflege einer Fertigkeitsdatenbank“ wird Ihnen bei Ihren eigenen Projekten höchstwahrscheinlich von Nutzen sein.
Die Originalarbeit ist auf arXiv unter der Nummer 2607.22529 verfügbar. Der Code und die Modellgewichte sollten gemäß der üblichen Praxis des Qwen-Teams auf HuggingFace veröffentlicht werden. Folgen Sie Qwen Repository, um zukünftige Veröffentlichungen zu verfolgen.
- Referenzlink * *
- arXiv-Artikel: https://arxiv.org/abs/2607.22529
- Qwen-Team HF-Homepage: https://huggingface.co/Qwen