论文:Zhang, Zhao, Hancock, Kraut, Yang《Interaction with AI Companions and Psychological Well-being》,Stanford + CMU,arXiv:2506.12605v5 [cs.HC],2026-05-04 上线。本文顺着 1,131 名 Character.AI 活跃用户 + 46.5 万条真实聊天记录,把「AI 怎么用,决定你的幸福感」这个问题从头到尾串一遍。数字全部来自原文;论文没讲清楚的地方,老老实实写「作者未给数据」,不替他们找理由。
引子:同一个 app,像微波炉,也像老朋友
同一款 AI 聊天 app,有人用它查资料、写邮件、练表达,越用幸福感越高;有人把它当老朋友,半夜睡不着就找它聊心事,用得越狠,掏心窝越多,反而越空。
这不是个人体验的差别。这是一篇刚发出来的大样本研究给出的硬数据。论文里那张关键表上写着:同一批用户,整体上用得越多,自报幸福感越高(β=+0.27);但把 AI 当"陪伴"用的人,幸福感显著更低(β=−0.48)。方向完全反过来。
下面我们顺着这条数据线往下走:研究怎么做的、查出了什么、哪些数字最硬、哪些要打折、最后你能带走哪三件事。
一、怎么读一篇"1131 人 / 46.5 万条聊天"的大样本研究
先把这个研究的底气摸清楚,再去看结论。
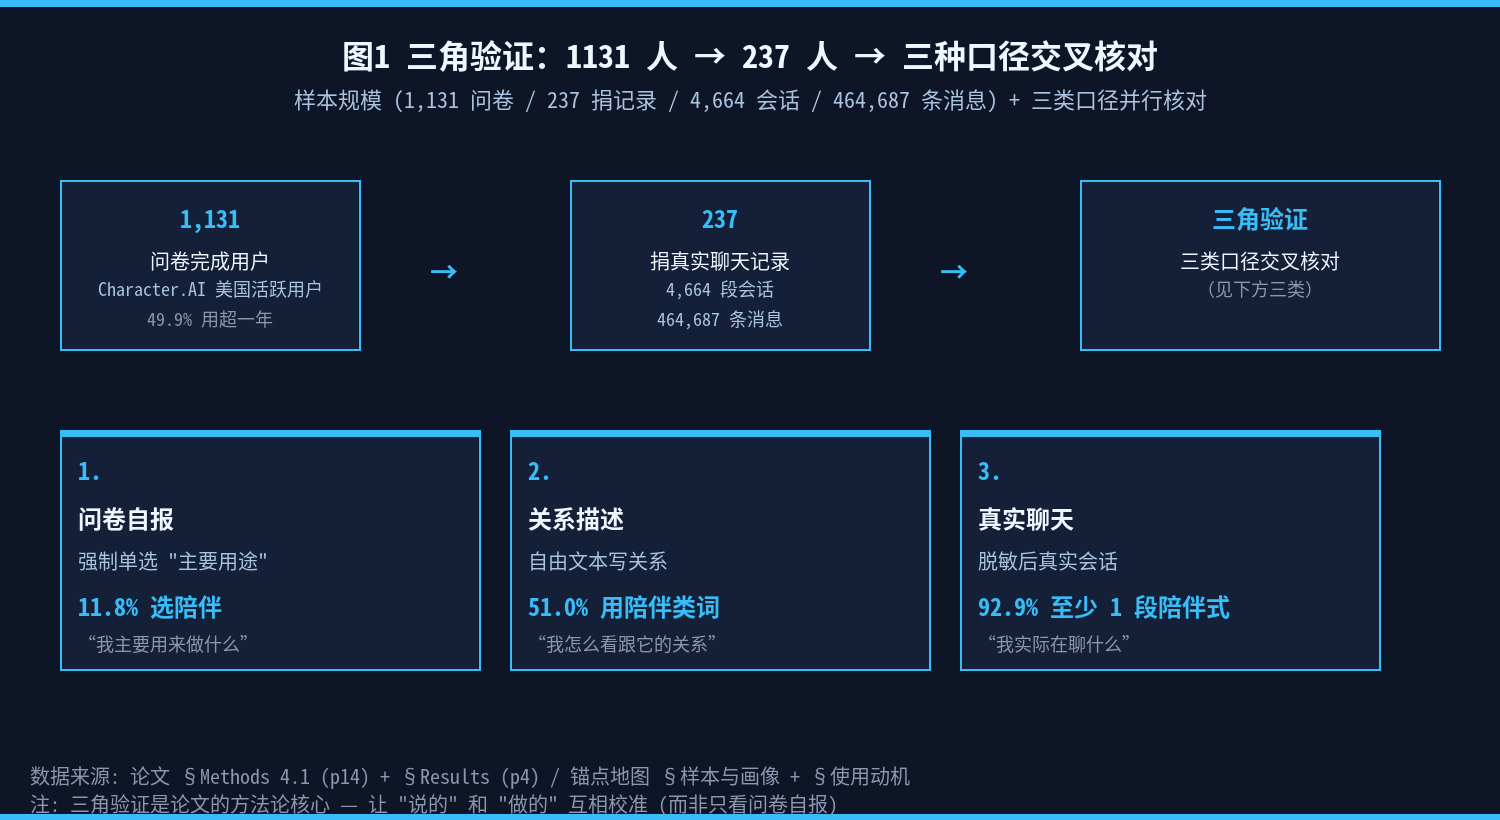
研究者做了一件比"发问卷"硬很多的事:他们对 1,131 名 Character.AI 美国活跃用户做了问卷调查,这批人里有49.9% 用超一年,是重度老用户,不是来尝鲜的新手。更关键的是,其中237 人捐出了自己真实的聊天记录——4,664 段会话、46.5 万条消息,脱敏后供研究者分析。
这是论文最重要的方法论选择:它把"我说的"和"我做的"放到一起做三角验证。三种口径并行——
- 问卷自报:“我主要用 AI 来做什么?”
- 关系描述:自由写下你怎么形容跟这个 AI 的关系。
- 真实聊天:直接看实际对话长什么样。
这三条线互相校准。后面会看到,正是因为有这种三角验证,论文才能给出那些"看着反直觉"的数字。
但"说的"和"做的"之间,有一道巨大的裂缝。下面看这道裂缝长什么样。
二、说的和做的,差一整个真相
这道裂缝本身就是第一个发现。
研究者让大家强制单选"你用 AI 的主要用途是什么"。结果——
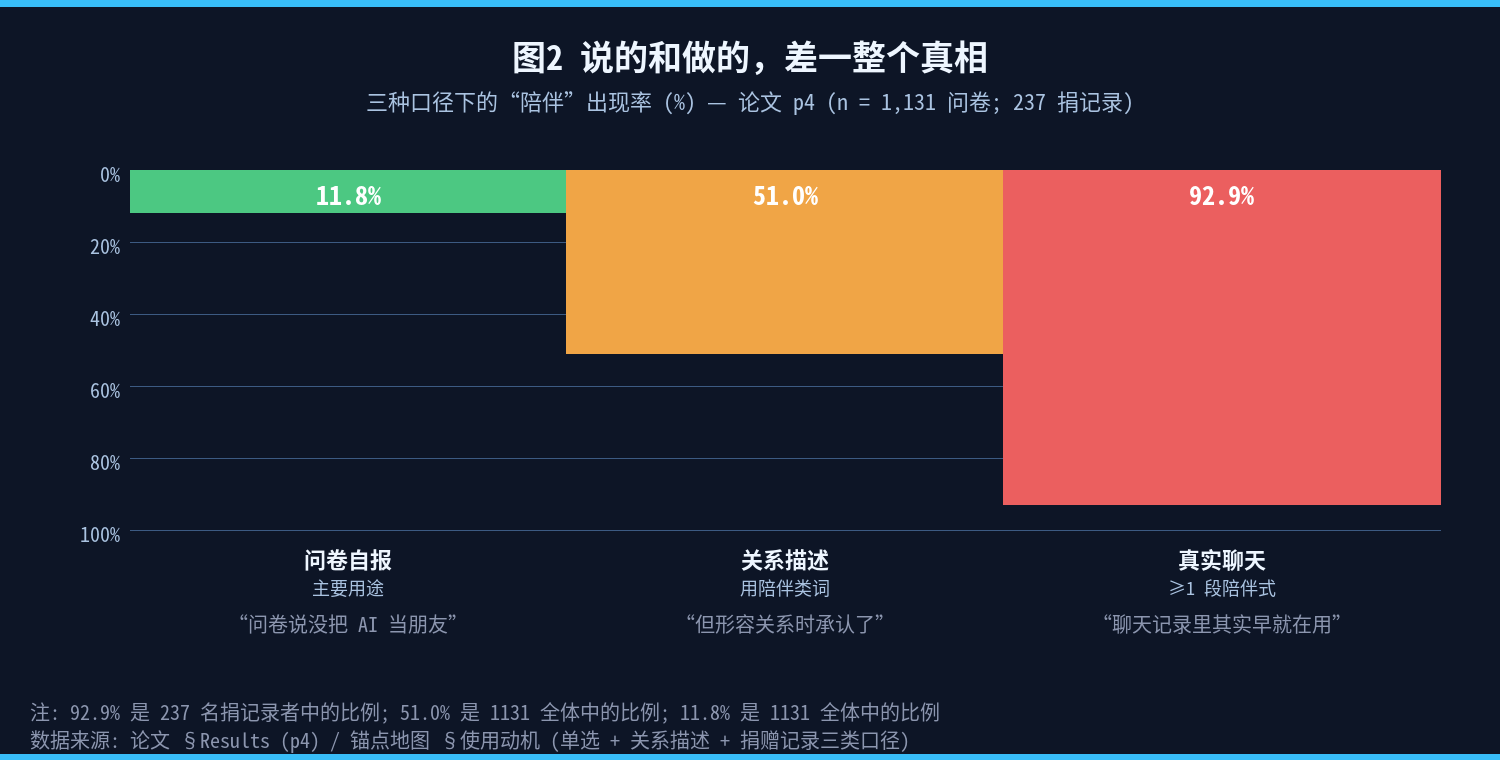
只有 11.8% 的人承认"陪伴"是主要用途。剩下八成多选了娱乐、查资料、消磨时间。
听上去 AI 陪伴是个小众玩法。但紧接着研究者让同一批人用自由文本写"你怎么形容跟这个 AI 的关系",情况就变了——51.0% 用了"朋友、陪伴、恋人"这类词。还没完:捐出真实聊天记录的那 237 人里,92.9% 的聊天记录里至少有一段陪伴式对话。
数据列成三栏看一眼:
- 问卷自报"陪伴"主要用途:11.8%
- 关系描述里含陪伴类词:51.0%
- 真实聊天里出现过陪伴式对话:92.9%
也就是说——嘴上说没把 AI 当朋友的那些人,聊天记录里早就在把它当朋友用了。
这就是为什么研究者要三角验证。如果只看问卷,你会以为"陪伴型用户只占一成";但聊天的真实世界是另一回事。
那么这种"陪"出来的对话,都在聊什么?
80.33% 的对话里有"情感与社会支持"主题——找 AI 倾诉、要安慰、要共情。其他高频主题:协作叙事与角色扮演 77.87%、浪漫与亲密角色扮演 68.03%、冒险与暗黑角色扮演 30.74%。论文用本地大模型先脱敏再自动打主题标签,人工抽检一致率很高(92%–95%)。
到这里为止还只是"AI 陪伴确实存在"的发现。下面才是全文最关键的那一张表。
三、同一批人,两个相反的方向
把"用得频繁"和"用得是陪伴型"两个变量同时塞进回归方程,方向就翻了过来。
整体使用强度 → 幸福感:β=+0.27,95% CI [0.19, 0.35],p<.001。用得越多,自报幸福感越高。这是直觉里的那条线。
陪伴用途 → 幸福感:β=−0.48,95% CI [−0.70, −0.25],p<.001。控制总强度之后,“我把它当陪伴"这一项的方向直接翻成负的,而且是负得相当猛。
论文没只靠一种口径下结论。同样的关系,换两个口径再测一次:关系描述口径(“我用了 friend/companion/romantic partner 这种词”)β=−0.32;真实聊天占比口径(“我的对话里陪伴式内容占多少”)β=−0.27。三种口径同向。
把数字放成一行:+0.27 / −0.48 / −0.32 / −0.27——正的那条线是"用 AI”,负的那组都是"把 AI 当陪伴"。这是论文的核心反差。
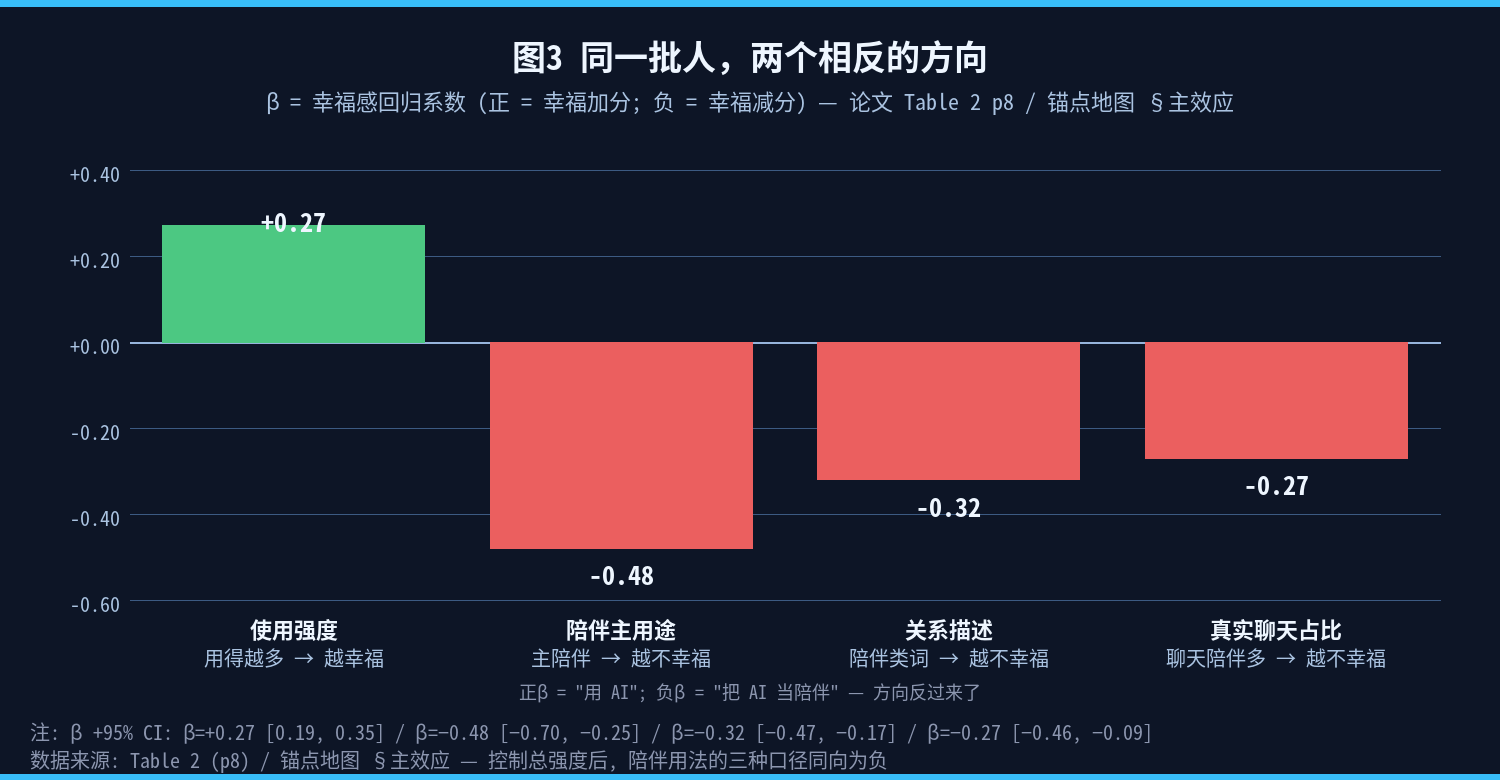
翻译成人话:AI 聊天这件事本身,不亏。用得越多幸福加分,是真的。但怎么用这件事——是当工具,还是当陪伴——才是决定方向的那一杆秤。
到这里还只是"主效应"。下面看更狠的:负相关不是匀速的,它带加速度。
四、用得越狠,掏心窝越多,反而越亏
研究者做了两个交互项,是这张表最让人不安的地方。
陪伴用途 × 使用强度:β=−0.31,95% CI [−0.56, −0.06],p=.014——在把 AI 当陪伴的那群人里,每多用一档,幸福感再往下掉一截。强度量表里有一道题:“如果这个聊天机器人消失了,我会难过。”这项的平均分到了 5.01 / 7 分(SD 1.72)——已经有人对 AI 产生了类似离不开的依赖,而这种依赖专门压在"把 AI 当陪伴"那一批人头上。
陪伴用途 × 自我披露:β=−0.38,95% CI [−0.63, −0.14],p=.002——在陪伴语境里,向机器人坦白心事越多,幸福感反而越低。这跟"说出来就轻松"的直觉直接撞车。
论文里有一组原话数据:用户自报"向机器人坦白最私密的事"的频率越高,对话里出现"情绪痛苦"主题的比例就越高——高披露对话里 60.85% 是情绪痛苦,紧随其后是渴望浪漫连接 41.42%、现实生活困境 31.54%、自杀念头 18.03%。
讲事实不展开细节,是这道题里必须守住的克制。18.03% 这个数字不是研究者挑出来的,是真实聊天记录里贴了对应标签的对话占比。论文给过一个脱敏后的例子:一个用户被养父母骂"坏",接着问机器人能不能假装他的父母。这个例子的价值是告诉你——机器听到的沉重内容比你想的多。
“说出来"本身没问题。问题是讲完之后,没有一个真的人接着你——只有一台永远在线、永远不反驳、永远按你说的来的机器。
到这里,方向和加速度都说清了。下面看"谁最容易去找 AI”。
五、圈小的人找 AI,但 AI 补不上线下
研究者把线下社交网络规模也加进来。
社交网络规模 → 选陪伴为主要用途:β=−0.03,95% CI [−0.05, −0.01],p<.001——线下社交圈越小的人,越倾向于把 AI 当成主要陪伴。听起来很合理:身边没人说话,那就跟 AI 说。
但这里有个反直觉的细节:单身反而是负相关,相关系数只有 −0.11。推动"找 AI 当陪伴"的,是"身边真的没人说话",而不是"没有伴侣"。所以 AI 陪伴,确实在填补一个真实的空位。
问题来了——这个空位,它填得上吗?
论文作者给了一句原话:“Chatbots may augment existing social networks, they do not effectively substitute them.” 翻译过来:AI 可以给已有的社交加分,但没法替代。
数字很硬——
- 线下社交圈 → 幸福感:β=+0.51,95% CI [0.44, 0.57]。这是全篇最大的正向效应。
- 陪伴用途 × 社交网络:交互项不显著(β=0.07,p=.514;贝叶斯因子 BF01=6.55 支持"无交互")——“AI 陪伴能补上圈子小的缺口"这个假设,在数据里立不住。
- 使用强度 × 社交网络:β=−0.11,95% CI [−0.18, −0.05],p<.001——AI 用得越狠,线下社交的正面作用反而被削弱。
把这一组数字翻译成一句:AI 不是社交的退路,它是社交减少的信号。
到这里,“谁受益、谁不受益"就清楚了。下面把克制的边界交代清楚。
六、三道边界,三件带走的事
论文作者自己写下了三道边界——必须交代,不能替他们藏起来。
第一,这是横断面数据——一张照片,不是一段视频。只能看到相关,看不到因果。也可能是本来就过得不太好的人,更愿意找 AI 当陪伴——方向反过来也讲得通。
第二,样本是 Character.AI 的重度老用户——美国、母语英语、近一半用超一年。不能外推到"所有人用 AI 都这样”。
第三,捐聊天记录是自愿的;研究者做了 Heckman 选择模型校正,发现幸福感越高的人越不愿意捐记录(β=−0.19,p=.003)。也就是说我们看到的聊天数据,本身就偏向过得不太顺的那一批用户。
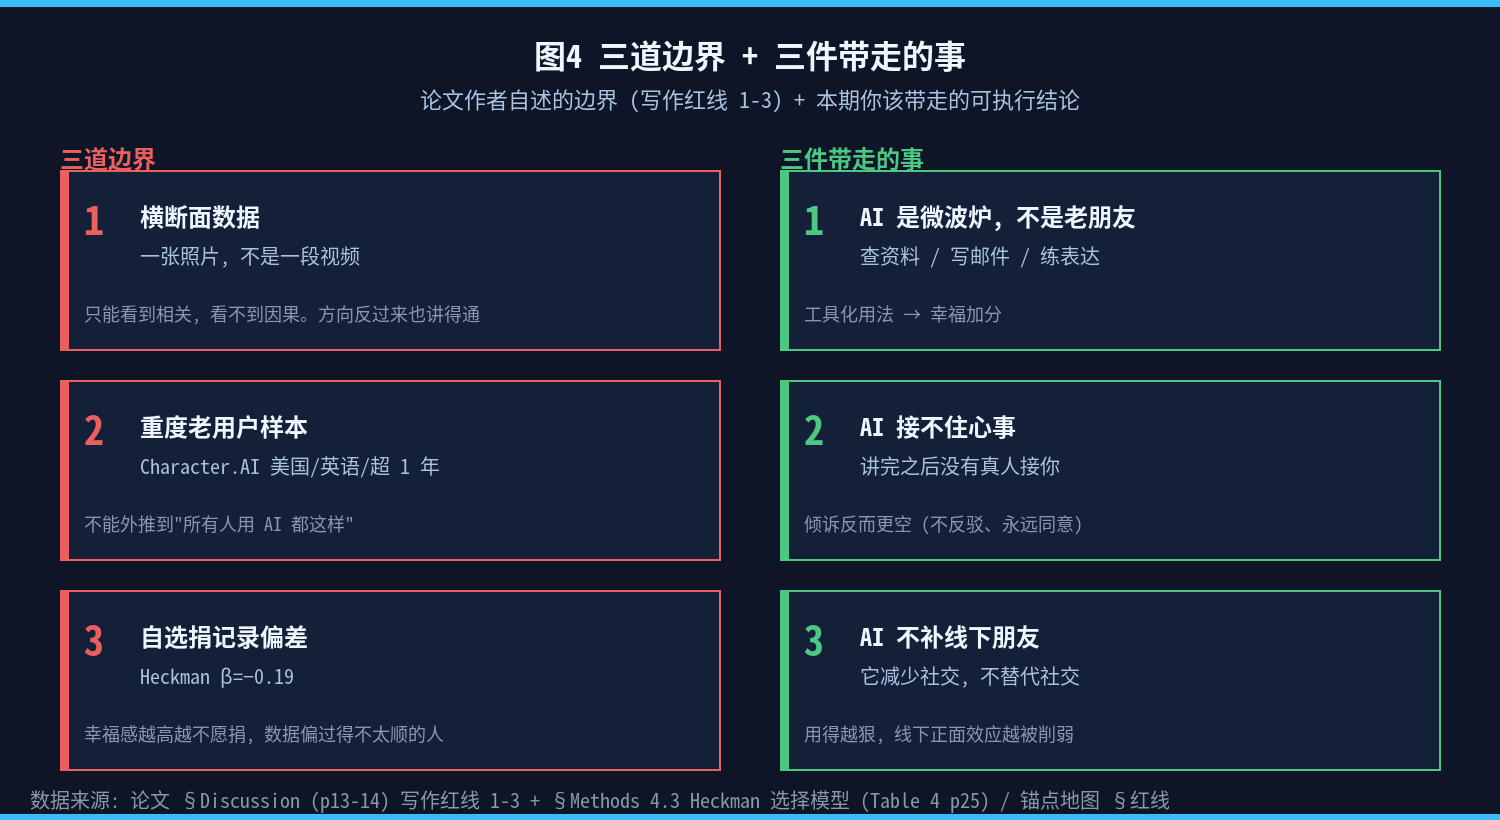
这三道边界里每一道都在告诉我们:这是一个重要的发现,但不是一个普适的答案。
到这里为止,我们已经把研究本身看完了。回到家里,回到那台"微波炉”。
第一,AI 是台好用的微波炉,不是随时在的老朋友。查资料、写邮件、练表达——让它当工具,幸福加分。
第二,AI 接不住心事。难过时找它倾诉不会让你轻松,反而更空。它不会反驳你,也不会真的接住你。
第三,AI 不补线下朋友。它会让我们更容易忽略身边真实的人,而不是补上这个缺口。
如果硬要把这一期压缩成一句:今天这台"微波炉",你打算让它做什么?
论文:Yutong Zhang, Dora Zhao, Jeffrey T. Hancock, Robert Kraut, Diyi Yang,Stanford University + Carnegie Mellon University,Interaction with AI Companions and Psychological Well-being,arXiv:2506.12605v5 [cs.HC],2026-05-04。资助为 NSF / ONR / Sloan / NIMH 等公共基金;无预注册;无利益冲突声明(全文检索确认)。
数字全部来自原文 §Results / Table 1-3 / Figure 2-4。统计量(β、95% CI、p 值、SD)出现时已当场解释含义。本期为非临床样本讨论,“测不到”≠“没有”;18.03% 的自杀念头话题占比属论文已脱敏数据,本文只引用、不展开细节。