课程分享|Stanford CS146S: The Modern Software Developer,第 1 讲。课程官网:https://themodernsoftware.dev/
我平时用 Claude Code,但一直说不清它怎么把一句话变成一串文件修改。模型为什么知道该调用哪个工具?40 个工具的定义都塞在哪里?上下文满了之后,它又是怎么把前面的对话压掉的?
斯坦福 CS146S 的第一周,用三样东西回答这些问题:一个 200 行的最小 agent、一次对 Claude Code 请求的拦截、一篇 55 页的论文。
一、介绍这个课程
CS146S 的全名是 The Modern Software Developer,斯坦福 2026 年秋季开课,3 个学分,周二、周四下午 5:30 到 6:20。讲师 Mihail Eric,助教 Isaac Kan、Vijay Daita、Patrick Hua。
课程页的定位很明确:大语言模型把软件开发从主要靠手写代码,变成了和越来越能干的 coding agent 协作。课程要教三件事:怎么给 agent 正确的上下文,怎么把产品需求翻译成可执行的规格,怎么设计人和 agent 一起计划、构建、评估、改进的循环。
10 周的安排如下:
| 周 | 主题 |
|---|---|
| 1 | coding agent 的内部结构 |
| 2 | 上下文工程 |
| 3 | agent skills 和 CLI |
| 4 | 定制 agent 和仓库 |
| 5 | 让仓库对 agent 友好 |
| 6 | agent 做代码审查 |
| 7 | 安全 |
| 8 | 后台 agent |
| 9 | AI 原生的团队 |
| 10 | 软件工厂和未来 |
客座名单也不像水课。Claude Code 的作者 Boris Cherny、Replit 的 CEO Amjad Masad。还有 Cognition 的 Silas Alberti、Semgrep 的 Isaac Evans、Cloudflare 的 Rajesh Bhatia。SpaceX 的 Lee Robinson、Factory 的 Eno Reyes,以及投资人 Elad Gil,也在这个名单里。
成绩构成:期末项目 50%,开源贡献 30%,每周作业 15%,课堂参与 5%。开源贡献占 30%,这个比例比很多课的项目都重。
先修要求是 CS111 或 CS161 级别的编程经验,CS221/229 推荐。课程页的 FAQ 说,不需要用过 Claude Code 之类的工具,但编程基础必须有。每周投入 10 到 12 小时。
它不适合想学几句提示词就能让 AI 干活的人,也不适合完全没写过代码的人。作业要你去拦截 Claude Code 的请求,再自己解析。它适合每天用 coding agent、但说不清它内部发生了什么的人,或者正在做 agent 产品、想知道生产系统和 demo 差在哪的人。
二、第一周讲了什么
Week 1 的标题是 The Internals of Coding Agents。两节课加一篇论文,分别回答三个问题:agent 怎么跑?生产系统多了什么?为什么多这些?
周二:200 行,先让循环跑起来
Mihail 只用了 3 个工具:读文件、列目录、改文件。
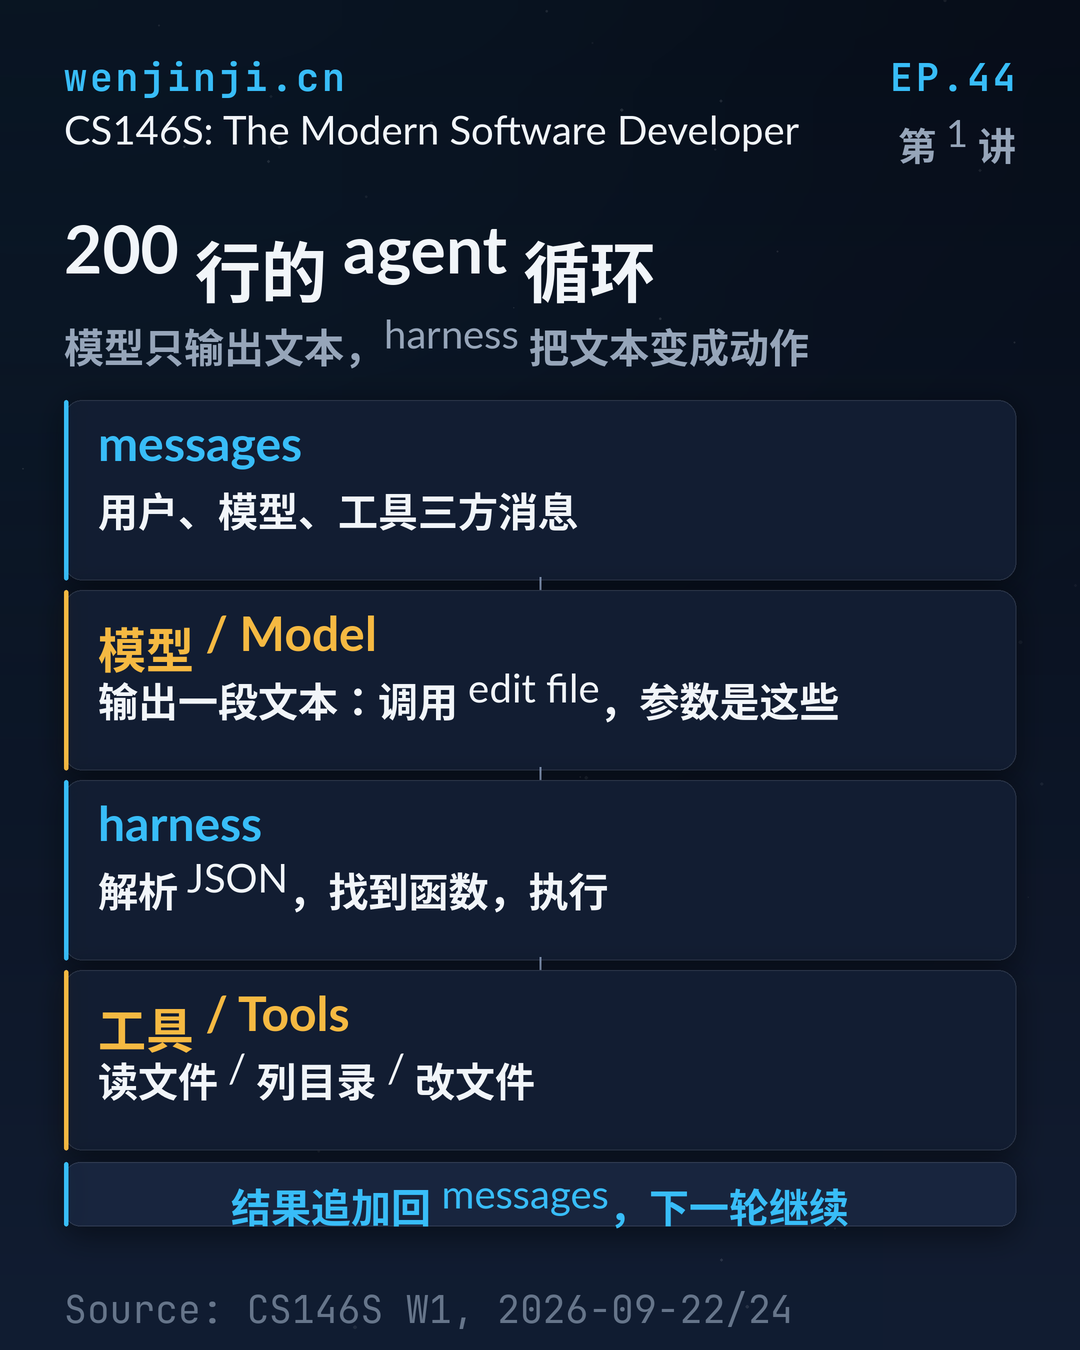
代码结构不复杂:一个工具注册表,把工具名映射到实现;一段 system prompt,把每个工具的名字、用途、参数写进去;一个 while True 循环;一个 messages 列表,记录用户说了什么、模型回了什么、工具返回了什么。
循环里做四件事:把 messages 发给模型;从模型的回复里提取工具调用;执行工具;把结果追加回 messages。
模型不会运行任何东西。它只输出一段文本,说我要调用 edit file,参数是这些。harness 把这段文本解析成 JSON,找到对应的函数,执行,再把结果塞回去。下一轮,模型看到结果,继续。
这就是 agent 的骨架。200 行能证明循环本身不神秘,半天时间,一个会写 Python 的人,就能让模型读文件、列目录、改代码。
但它证明不了能交给别人用。demo 和产品之间,差的是权限、日志、恢复和边界检查。这些不是 200 行能塞下的。
周四:把请求截下来,看真实系统
Mihail 用代理工具把 Claude Code 的请求截下来,存成 JSON。截下来之后,第一眼看到的是工具列表。
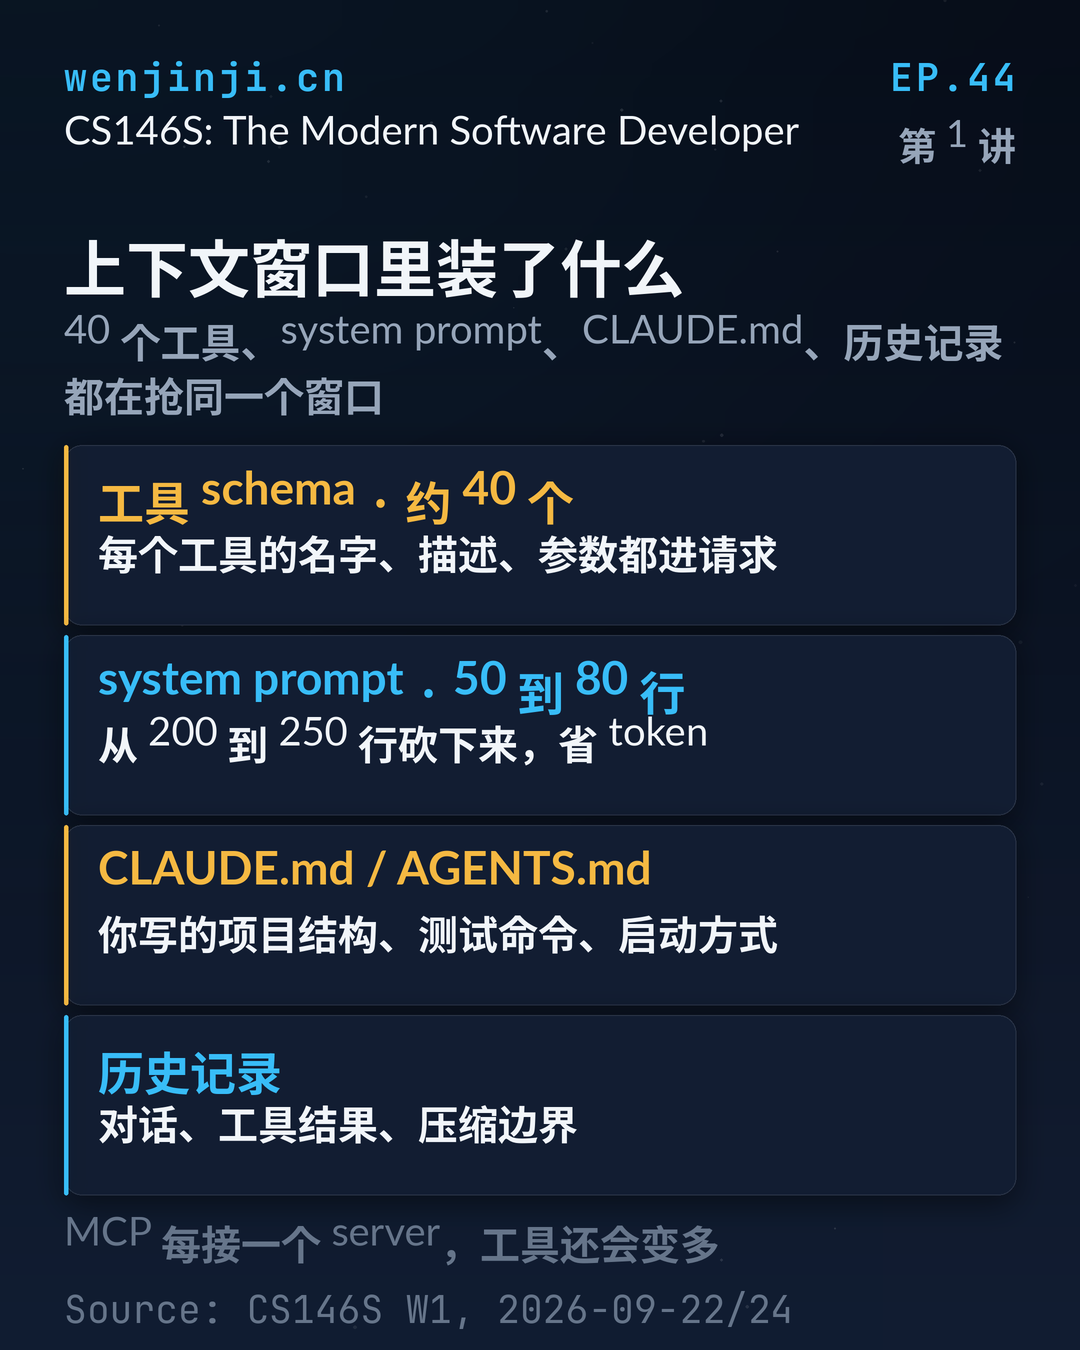
Claude Code 自带大约 40 个工具:读文件、写文件、跑 bash、搜网页、查 LSP、开子 agent、进 plan mode、调 skill、发通知、问用户问题。每一个工具都有名字、描述、参数 schema,这些东西全部被塞进请求里。
工具越多越好吗?Mihail 给了一个反例:早期 GitHub 的 MCP server,一上来就是 110 个工具,列 issue、建 issue、评论 issue,一个动作一个工具。工具越多,上下文越肥,模型越容易在无关的东西里迷路。
他还给了一个数字:Claude Code 的 system prompt,现在是 50 到 80 行,之前是 200 到 250 行。一个月前,Anthropic 又把它砍了大约 8%。为什么要砍?因为这段文字用户看不见,但每次请求都要付 token。
system prompt 之外,还有一层你自己能控制的东西:CLAUDE.md 或 AGENTS.md。它被注入成一个 user 块,开头写着这些指令覆盖默认行为,必须按原文执行。你写进去的项目结构、测试命令、启动方式,模型都会当真。
再往外,是 plan mode、skills、子 agent、hooks 和 compaction。plan mode 本质上是一段工作流说明;skills 平时只露一个名字和一句描述,等模型觉得相关了才把全文拉进来;子 agent 开一个全新的上下文窗口,干完只把结果带回来;hooks 是生命周期事件;compaction 是压缩,上下文快满了就把前面的内容总结成一段,50 万 token 压到 15 万。
这些机制指向同一个约束:上下文窗口是有限的,工具、提示词、历史记录都在抢它。
阅读:一篇 55 页的论文
Week 1 的阅读材料里,有一篇 55 页的论文:Dive into Claude Code。副标题是 The Design Space of Today’s and Future AI Agent Systems。
论文把 Claude Code 的公开 TypeScript 源码拆开,还拉了两个开源 agent 系统做对照:OpenClaw 和 Hermes Agent。摘要里有一句话,几乎就是 Week 1 的答案:核心是一个简单的 while 循环,调用模型、执行工具、重复;但大部分代码,住在这个循环周围。
周围有什么?
权限系统。7 种权限模式,外加一个机器学习分类器。默认模式下,超出只读范围的操作要你批准;acceptEdits 模式自动批准工作目录内的编辑;plan 模式先出计划再执行;bypassPermissions 跳过大部分提示,但安全关键检查还在。
论文里有个数字很刺眼:Anthropic 发现,用户会批准大约 93% 的权限提示。93%。人点多了,就不看了。所以 Claude Code 的做法不是加更多警告,而是换一套结构:能沙箱的先沙箱,能分类的先分类,deny 规则永远优先于 allow 规则。一个操作被拒绝,模型也不是直接停住,它收到拒绝理由,换个更安全的做法再试。
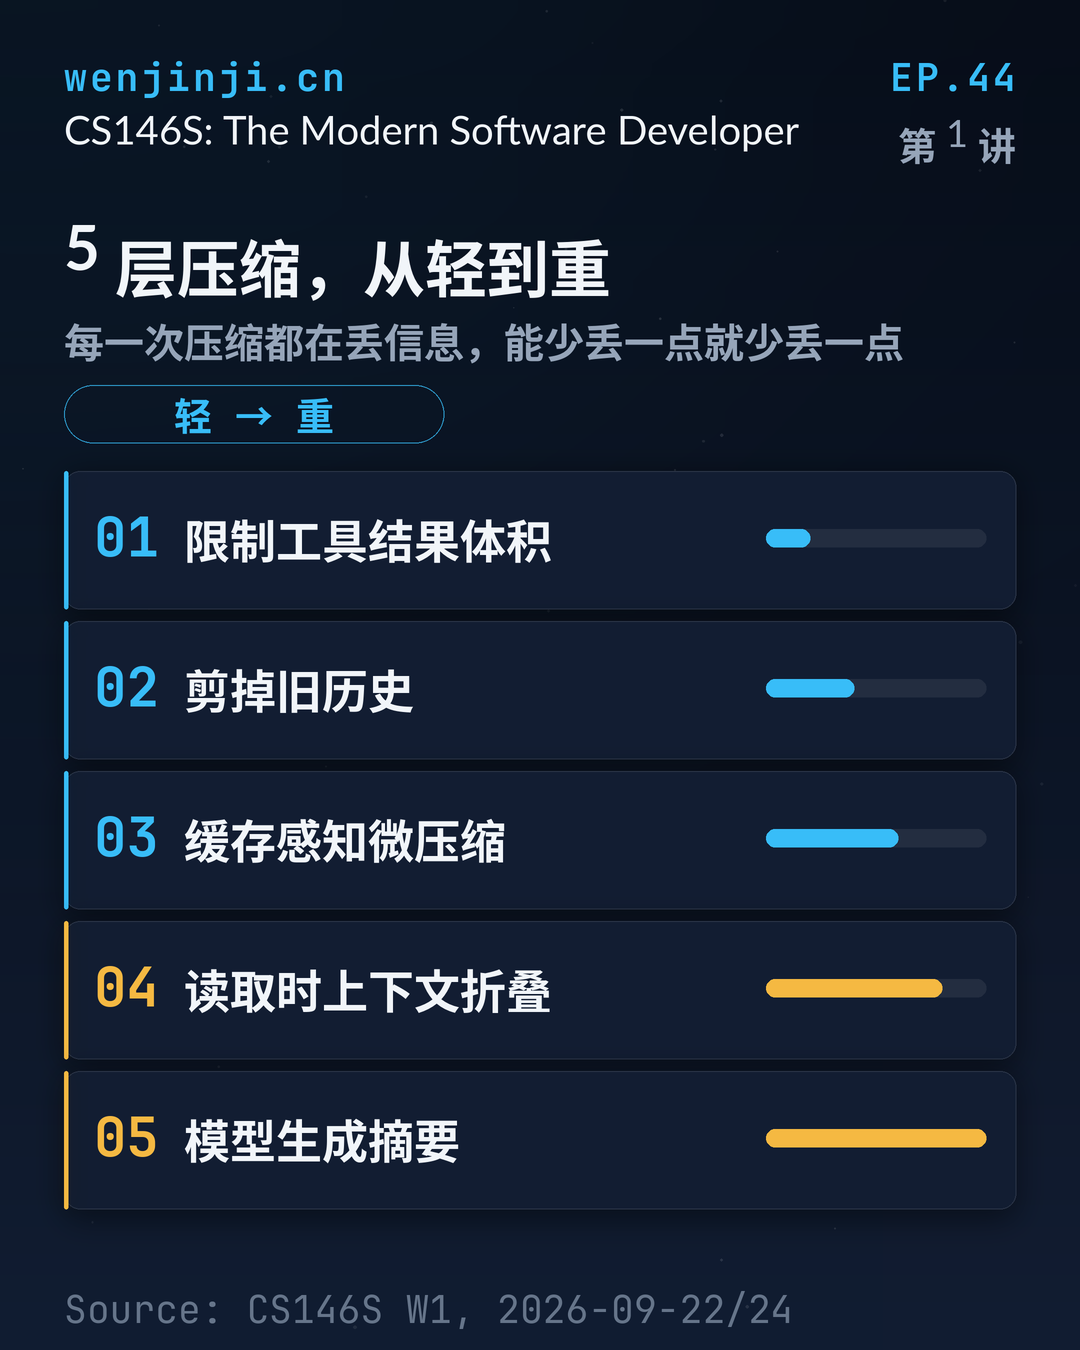
压缩管线。5 层,从轻到重:先限制单个工具结果的体积,再剪掉旧历史,再做缓存感知的微压缩,再做读取时的上下文折叠,最后才让模型自己生成摘要。为什么搞 5 层?因为每一次压缩都在丢信息,能少丢一点就少丢一点。
扩展机制。4 种:MCP、plugins、skills、hooks。它们按上下文成本排队:hooks 默认零成本;skills 在没被调用前只占一句描述;plugins 是打包层,成本中等;MCP 一旦加载工具 schema,成本最高。
子 agent 有独立的上下文窗口和权限边界;会话存储是 append-only,只追加,不改写;恢复会话时,权限相关的状态不会一起恢复。这些都是有意的设计。
论文最后还讲了一个长期问题:Anthropic 调查了 132 名工程师和研究员,发现大约 27% 的 Claude Code 任务,是如果没有这个工具就不会被尝试的工作;但另一项研究发现,在 AI 辅助条件下,开发者在理解力测试上的得分低了 17%。论文把这叫监督的悖论:你越依赖它,越需要有能力监督它,而这个能力可能在退化。
三、第一周的结构、效用与闭环
结构:三层,三个问题
第一周不是三块互不相干的内容,而是三层:
| 层 | 内容 | 回答的问题 |
|---|---|---|
| 动手层 | 200 行最小 agent | agent 怎么跑? |
| 观察层 | 截 Claude Code 请求 | 生产系统多了什么? |
| 理论层 | 55 页论文 | 为什么多这些? |
三层顺序不能换。先搭,你才知道一个 loop 最少需要什么;再截,你才知道真实系统在 loop 外面加了多少东西;最后读论文,你才知道那些东西不是拍脑袋,是设计取舍。
效用:每一层解决什么
200 行的效用,是去掉神秘感。很多人以为 coding agent 是一个复杂的智能系统,看到 3 个工具、一个 while 循环、一个 messages 列表,才知道骨架有多小。骨架小,你才敢改。
截请求的效用,是把上下文从抽象概念变成可数的 token。你不需要猜 40 个工具占了多少位置,截一次请求,数一遍就知道。你也能看到 system prompt、CLAUDE.md、工具 schema 在同一个窗口里排队。
论文的效用,是给你判断依据。7 种权限模式不是每个 agent 都必须有,5 层压缩也不是唯一解;但论文告诉你,每一个机制在解决什么问题,代价是什么。你可以在自己的项目里做减法,而不是照抄。
闭环:课程结构本身就是一个 agent loop
把三层连起来,就是一个闭环:
- 搭一个最小 loop。
- 截一次真实请求。
- 对比差距,找出你的 loop 缺什么。
- 读论文,看生产系统怎么解。
- 回到自己的 loop,改一版。
这五步和 agent 的 loop 同构:行动、观察、反思、再行动。课程的第一周,其实是在用 agent 的方式教你理解 agent。
闭环的关键在最后一步:回到自己的 loop。只看不搭,闭环是断的;只搭不读论文,你会重复造轮子;只读论文不动手,你得到的是地图,不是路。
局限:第一周只是地图
200 行不含权限、恢复、持久化;论文是 Claude Code 某个版本的快照,系统还在变;课程第一周讲的是内部结构,不是完整的工程实践。把这三层当成起点,不要当成终点。
四、我对照学习学到了什么
我把 200 行的 demo、截下来的请求、论文的设计原则放在一起对照,学到四件事。
1. loop 是协议,不是智能
模型只输出文本,harness 把文本变成动作。你可以在 200 行里看懂这个协议,也可以在 40 个工具的请求里看到它的规模。智能在模型里,工程在 harness 里。
2. 上下文是硬约束
工具、system prompt、CLAUDE.md、历史记录,都在抢同一个窗口。40 个工具不是免费的,110 个 MCP 工具更不是。加工具之前,先数 token;写 CLAUDE.md 之前,先问这句话是否真的影响执行。
3. 安全和恢复是架构,不是提示词
93% 的同意率说明每次都问不可靠。deny-first、沙箱、分类器、拒绝后的重试路径,都是结构性的设计。恢复会话不恢复权限,也是结构性的选择。
4. demo 和产品的差距,就是 harness
200 行能跑通一个任务,但跑不了别人的仓库。权限、日志、压缩、子 agent 隔离、会话持久化,这些才是产品。
资料
原文:https://arxiv.org/abs/2604.14228
中译版:58 页 PDF。夸克网盘:https://pan.quark.cn/s/93ee31071271 提取码:1jLF。翻译保留了原文的章节结构,公式和表格没有删。