Wang & Zahl, Volume estimates for unions of convex sets, and the Kakeya set conjecture in three dimensions, arXiv 2502.17655v1 (2025-02-26 投稿,127 页)。一句话总结:三维 Kakeya 集维数 = 3 被证,顺手把三维 Tube Doubling 猜想和 Keleti 的线段延伸猜想也证了。这篇文章我从摘要一路精读到 §12,顺手把里面所有"听起来像魔法"的黑话都拆开讲讲。
一、开篇:两位作者和一篇等了 108 年的问题
作者是 Hong Wang(王虹)和 Joshua Zahl。王虹是 NYU Courant 教授,也是 IHES 常任教授,北大 2011 届本科,MIT 博士师从 Larry Guth;Zahl 是 UBC 数学系。这两位在过去三年里出了一套三部曲,把一个卡了将近一个世纪的几何问题从"差一步"推到"证完"。王虹刚拿了 2026 年菲尔兹奖。
故事得从 1917 年的日本讲起。挂谷宗一(Sōichi Kakeya)提了一个看似小学生都能懂的问题:把一根针(单位长线段)在平面上旋转一周,针尖扫过的最小面积是什么?后来这个问题被推广成 Kakeya 集:一个紧集如果包含了每个方向上的单位线段,就叫 Kakeya 集。Davies 在 1971 年证明二维情况下 Kakeya 集的 Minkowski 和 Hausdorff 维数一定是 2(满维)。但三维以上一直卡住,卡了整整半个多世纪。
你也可以这样想象这件事:Kakeya 集就像一个"什么方向的车都能调头的停车场"——每个方向都得有一条能停一辆车的"车位",哪怕那条车位只是一根针那么细,但方向得覆盖满 360°。二维时你很容易想象这个停车场只是个普通圆盘;可一旦升到三维,每个方向都得有一根"立体方向"的针能被放进去,这件事就反常地难。
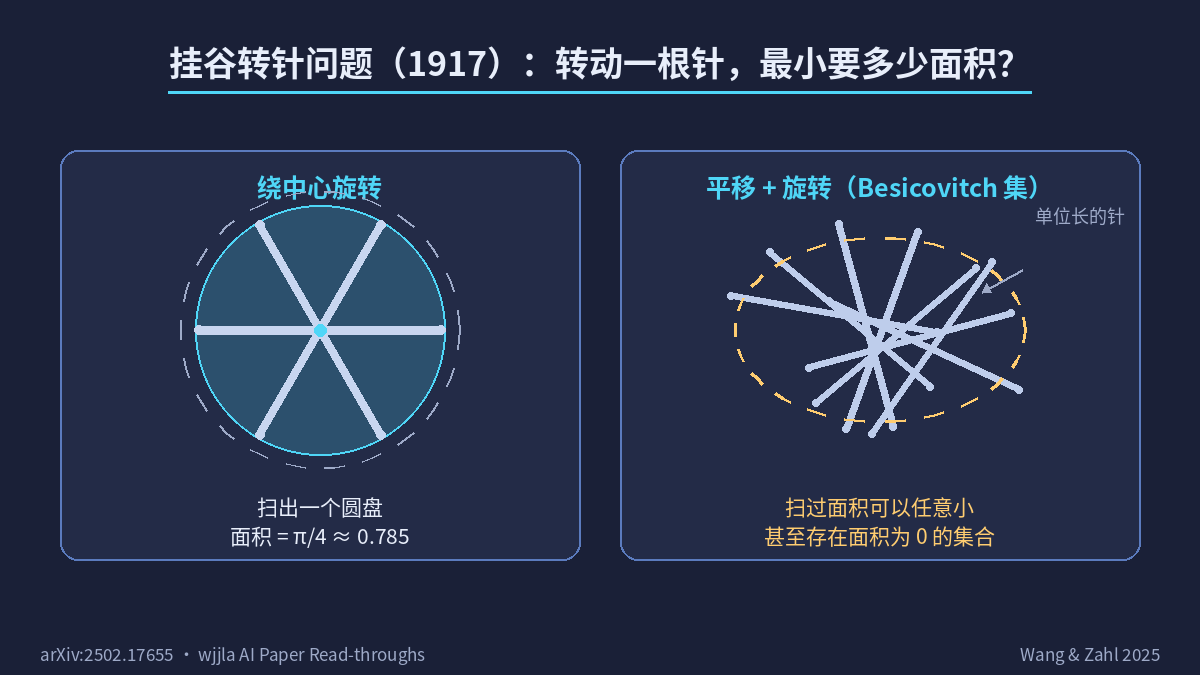
上图这个图就是问题最初的动机:转一圈扫出来的面积,直觉上像圆,实际上存在面积更小的"叶形"——你转得越巧妙,扫过的面积越接近 0——Besicovitch 就给出过这种面积任意小甚至为 0 的构造(论文 §1.6 在 R² 上提到 Besicovitch 的这个构造,见 L664)。但维数猜想问的是反过来:如果一个集合"装得下"每个方向的针,这个集合的维数一定得是 3。
为什么"维数 = 3"本身是个不平凡的命题?这里要先停一下,把"维数"这两个字讲清楚。
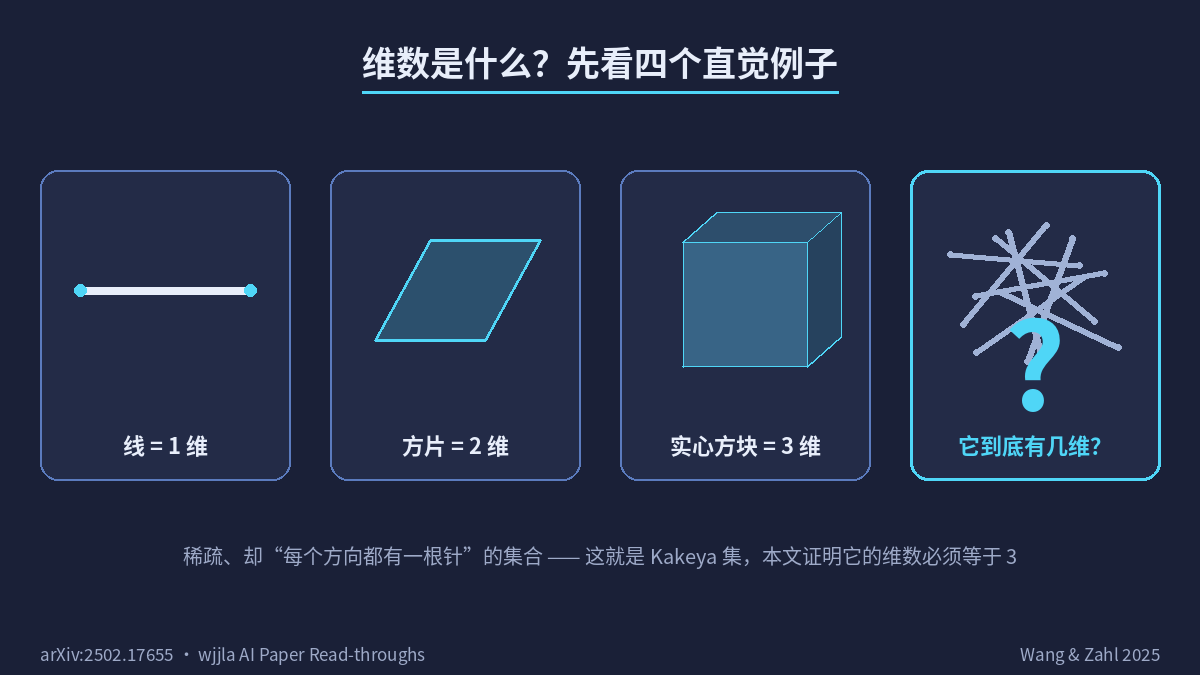
最直观的版本:把一个集合"放大 ε 倍看",看它"看起来有多大"。维数衡量的不是尺寸,是"厚实度"——也就是这个集合到底在多少个独立方向上"撑开了空间"。一条细线是一维的(只沿一个方向延伸),一张薄纸是二维的(沿两个方向撑开),一块实心方块是三维的(三个方向都撑满)。Kakeya 猜想问的"维数 = 3"意思是:装满"每个方向"针的这个集合,必然在三个独立方向上都"撑得足够开",它不可能被压成一张二维的薄片、一条一维的细线、或一堆零维的点。
那么"为什么不能把方向不同的针塞进一张薄纸里"就成了问题核心。几何上反直觉,但数学上几十年没人能排除。
二、为什么三维卡了一个世纪:把"半世纪成绩单"摊开看
三维 Kakeya 猜想的部分结果分两条线推进,一条是"维数下界"的硬指标,一条是"结构定理"的软工具。
硬指标线:Wolff 1995 年的 [27](Rev. Mat. Iberoam. 11)证明了三维 Kakeya 集的 Hausdorff 维数至少是 (n+2)/2 = 5/2;后来 Katz、Laba、Tao(论文里 [16])在这个基础上加了一个小的正常数 c,做到 5/2 + c。这条线给出的是"绝对下限",数字上离 3 还差得远。
软工具线:2000 年前后开始,Bennett-Carbery-Tao 的 multilinear Kakeya 定理([1])说明任何"反例"必须是"planar"——针堆在一起时必须大致躺在某个平面附近;Guth([9])用他著名的"grains 分解"说明反例必须是"grainy"——针能组织成长方体颗粒;但最关键的 stickiness 这一环一直卡住:你能说反例是 planar + grainy + sticky,然后呢?卡这里。
2014 年,Terence Tao 在一次讲座加博客文章([24])里把 Katz-Tao program 讲成三步:第一步证明反例必然有 planar / grainy / sticky 三种结构;第二步把这些结构"多尺度化",得到越来越精细的描述;第三步用 Bourgain 那一路的 discretized sum-product 工具,把这种多尺度结构"证伪"。
王虹和 Zahl 2022 年和 2024 年的两篇 [25][26] 实际上跳过了第一步,直接做了"假设反例是 sticky,推出矛盾",以及"假设反例 Assouad 维数 < 3,推出它必然是 sticky"。但这两步合起来还差一块:Assouad 维数可以比 Minkowski 维数大,所以 [25][26] 没真正关上 Minkowski 维数 < 3 的口子。
这篇 127 页的论文,正是把最后这块板补上了:它不假设反例 sticky,而是直接证明"如果 D(σ, ω) 是紧的,反例必然自己长得像 sticky",然后用 sticky Kakeya 定理推出矛盾。这一步闭合,三维 Kakeya 集维数 = 3 就彻底被证了。
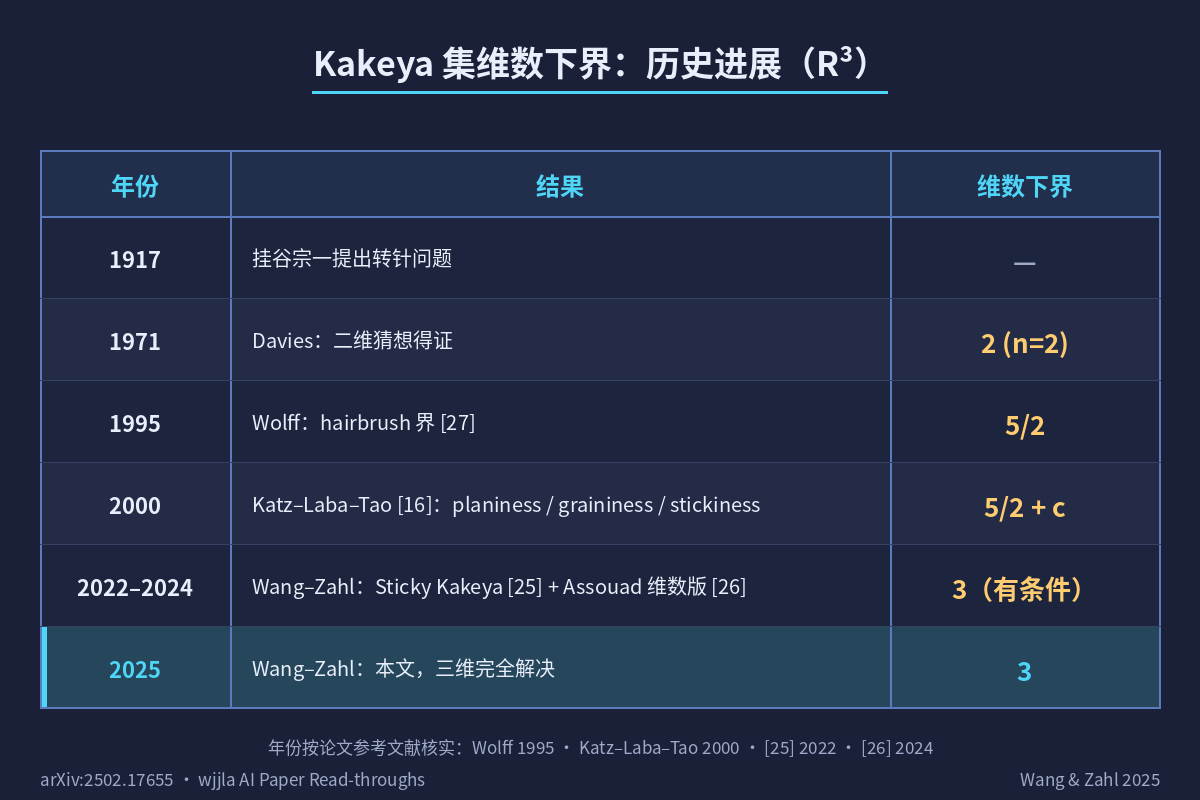
数字上具体的"曾经的下界 → 现在的下界"跨度:从 1995 年 Wolff 的 5/2,到 2000 年代 Katz-Laba-Tao 的 5/2 + c,再到现在直接跳到 3。从 Wolff 到这篇论文,中间大约 30 年的 (5/2, 3) 区间,在 2025 年初被这篇论文整体跨过。
三、这篇文章真正的主角是"管子并集体积估计",Kakeya 是推论
这一点必须先讲清楚,否则读论文会被术语淹没。论文标题是 Volume estimates for unions of convex sets, and the Kakeya set conjecture in three dimensions,Kakeya 只是推论,真正的主定理是 Theorem 1.2 和 Theorem 1.9(后者给出 Corollary 1.10),它们说的是:
给一堆 δ-tube(粗细 δ、长 1 的针管),只要它们不在任何凸集里"扎堆"(技术叫 Wolff axiom 或 non-clustering),把这些管子并起来得到的集合,体积一定"几乎"等于管子体积之和——也就是这些管子几乎互不相交地铺开,没有大量重叠。
δ-tube是个反复出现的核心名词。说白了就是"在某个方向上长 1、粗细 δ 的针管"。换成生活类比,它就像一根吸管——吸管有自己的朝向(长度方向),自己也有粗细(直径 δ),整根吸管的"体积"是 δ² · 1 = δ²(细管的横截面积乘长度)。当 δ 很小(吸管很细),单根吸管的体积 δ² 也就非常小;一万根细吸管的体积加起来也只有 δ² · 10000,看起来也不大——但论文要证明的是:当吸管满足"不在任何凸集里扎堆"的条件时,一万根细吸管的并集体积也只能是 ~10000 · δ²,不会比这更大;也就是说,它们真的是"几乎互不相交地"铺开,没有大量重叠。
Wolff axiom这个名字是因为 Wolff 1995 年那篇 [27] 引入了这类"非集中"条件:你拿任何一个长方体框(尺寸 a × b × 2)套这堆管子,框里能塞进去的管子数量不能比框的横截面积 × 1/δ² 大太多。换句话说,管子不能"扎成一把"。
把这个条件翻成生活语言,就是"超市限流"。想象一万根吸管在一个巨大的商场里飘,每根吸管都有它自己的朝向。Wolff 公理说:你切任意一个 a × b × 2 的小盒子(横截面积是 a × b),这个小盒子里最多只能塞进大约 a·b/δ² 根吸管——盒子的横截面积决定了它能容纳的吸管"上限",跟吸管的方向无关。如果你拿一个 1 × 1 × 2 的小盒子,里面突然塞进了 100 倍于横截面积上限的吸管,那就违反 Wolff axiom。Wolff 公理本质就是一种"分散度“的硬约束:吸管不能扎堆。
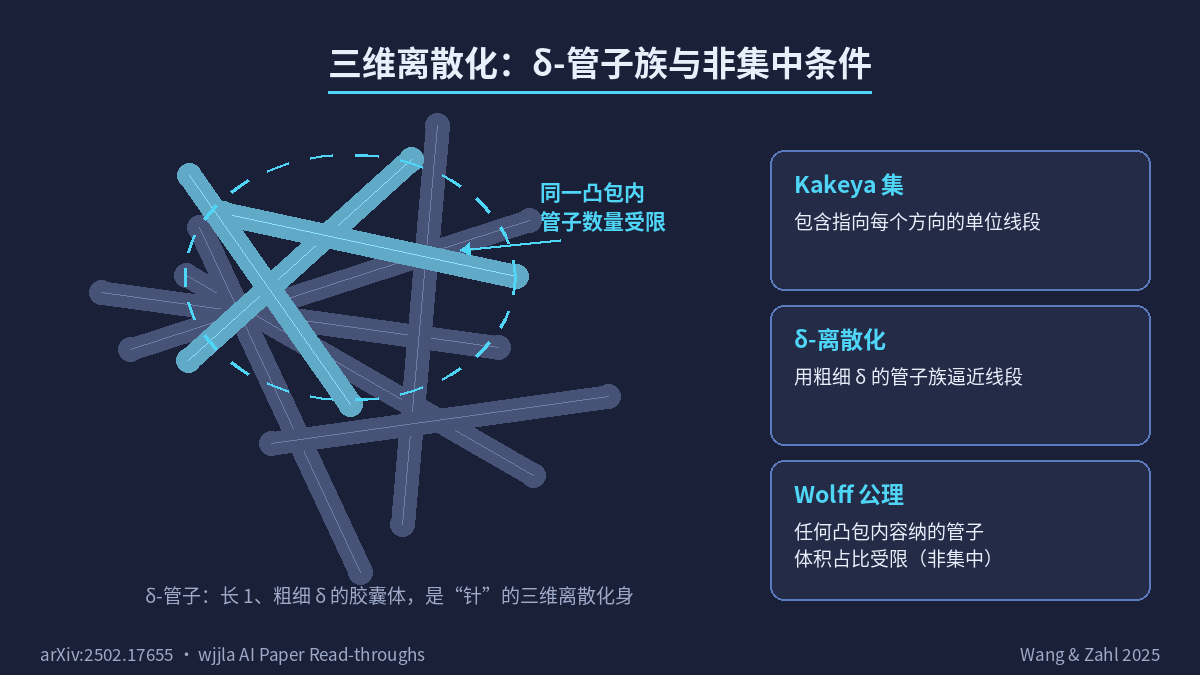
直观地理解:想象你有几万根细针,每个方向上都有一根。Wolff axiom 在说"这些针在任何一个 a × b × 2 的小盒子里不会突然聚集 100 倍”——这是一种"分散度"的硬约束。
Kakeya 集恰好满足这种条件:每个方向上一根针(δ 分隔的方向),所以单位球内任意 a × b × 2 的盒子里最多塞进 ~ab/δ² 根(横截面决定的)。于是Theorem 1.2 直接推出 Theorem 1.1——这就是论文标题里那个"as a consequence"的含金量。
四、核心思路四步走:Wolff 公理 → 凸集分解 → 两尺度 grains → 三招 moves → 尺度归纳
整篇 127 页的论证骨架,可以压成 4 个阶段的流水线。我用论文自己的图编号来对照着讲。
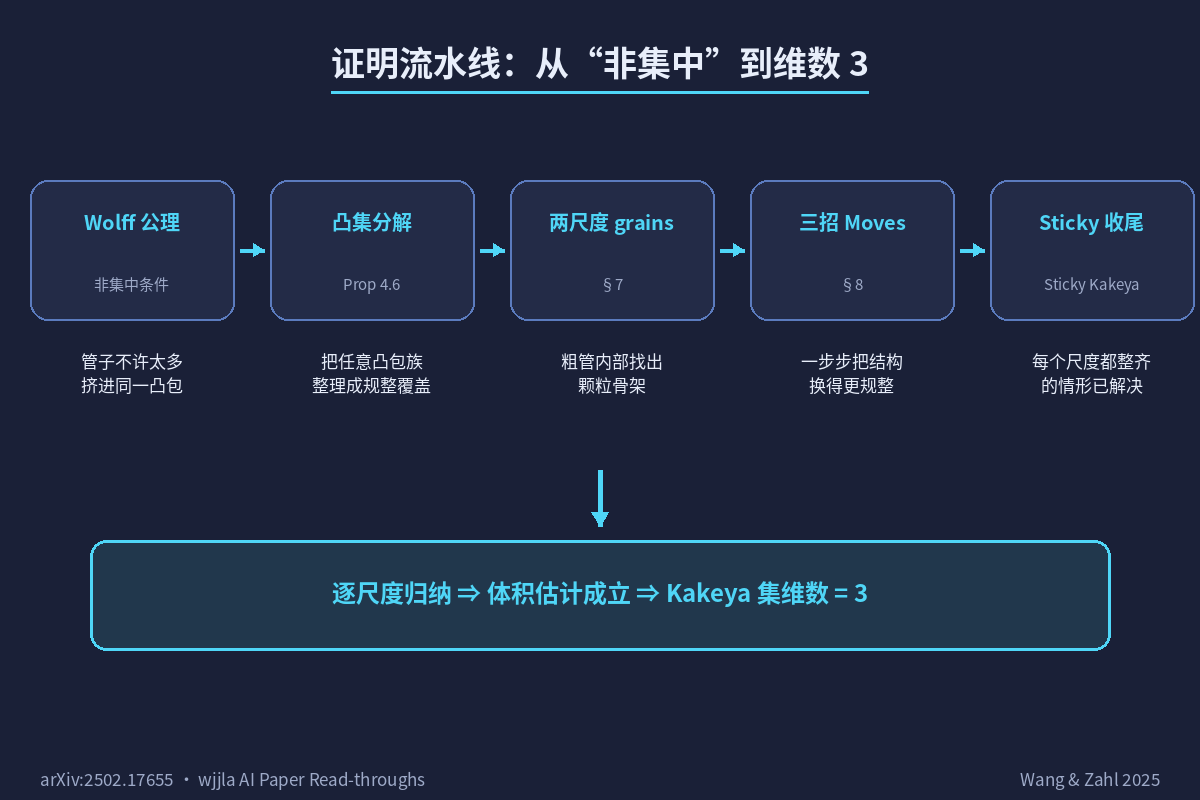
这张图把后面要走的四个阶段一起摆出来:Wolff 公理约束管子分布 → 凸集分解把"管子族"换成"包装凸集" → 两尺度 grains 把管子排成长方体颗粒 → 三招 moves 把颗粒"推到位" → 尺度归纳把 ω 一路压到 0。记住这五段式,整篇论文就不再是术语森林。
Step 1: Wolff 公理 + 凸集分解(§4)
这一步在干什么:先把"管子族"换成更一般的语言——任意一族全等的凸集。为什么非它不可:因为直接处理 δ-tube 太具体了,“管子"和"管子"之间互相穿插的几何关系很难描述;换成凸集之后,可以用凸集之间的包含、覆盖、相交这些更"线性"的关系来组织证明。
定义两种 Wolff 常数——Katz-Tao Convex Wolff constant(CKT-CW,衡量"不能扎堆进任意凸集 W”)和 Frostman Slab Wolff constant(CF-SW,衡量"不能扎堆进 slab 切片")。Frostman 常数"向上继承",Katz-Tao 常数"向下继承"——这个对偶关系是后面所有分解的引擎。Proposition 4.6 是这个阶段的关键工具:给定一族凸集,总能找到一族"包装凸集" W,既从下用 Frostman 控制 U,又从上用 Katz-Tao 控制 U,误差都是 K(可吸收)。
用一句话说清每个符号:CKT-CW 就是"凸集 W 里塞了多少管子"的归一化指标,数值越小说明管子越不往 W 里扎堆;CF-SW 是同一个意思的"薄切片版",只不过不是任意凸集 W,而是固定厚度的一个薄片(slab)。Frostman 向上继承意思是大尺度上的分散度可以传到更细的子尺度上,Katz-Tao 向下继承反过来——细尺度上的分散度能反向约束粗尺度。这两个"上下继承"对偶关系就像弹簧的两头,是后面所有分解能跑的引擎。
Step 2: 两尺度 grains 分解(§7)
这一步在干什么:在 Step 1 拿到"包装好的凸集族"之后,把每个凸集里塞的管子再做一次结构化——把它们组织成长方体"颗粒"(grains)。为什么非它不可:因为管子和管子之间的关系太复杂(每根管子朝不同方向,互相穿插),而长方体颗粒之间只有"包含 / 部分重叠 / 不相交"这几种清爽关系,处理起来容易得多。
这一步是 Guth([9])那一路 grains 思想的二次升级。在 [9] 里,Guth 证明了"宽"假设下,管子族能分解成 δ × t × t 的长方体颗粒(叫 grains),其中 t ≥ 1/√(#T)。论文把它做成两尺度版:先选一个中间尺度 ρ,用 ρ-tube 把 δ-tube 装起来;在每个 ρ-tube 内分别做 grains 分解,得到 δ/ρ × c × c 的颗粒;把缩放还原回去,就得到一族 δ × ρc × c 的 grains,叫 G。两个尺度(δ 和 ρ)同时出现,是后面"三招 moves"的前提。
grains 这个词,生活类比就是糖葫芦串——一根竹签(管子方向)上串了一颗颗大小相近的山楂块(颗粒),颗粒的长边沿竹签方向延伸。为什么要把管子拆成糖葫芦串?因为糖葫芦串比一堆散落的山楂更好管理:你可以数糖葫芦有几串、每串有几颗、每颗多大——所有这些"尺寸"和"数量"都能写进公式做估计。
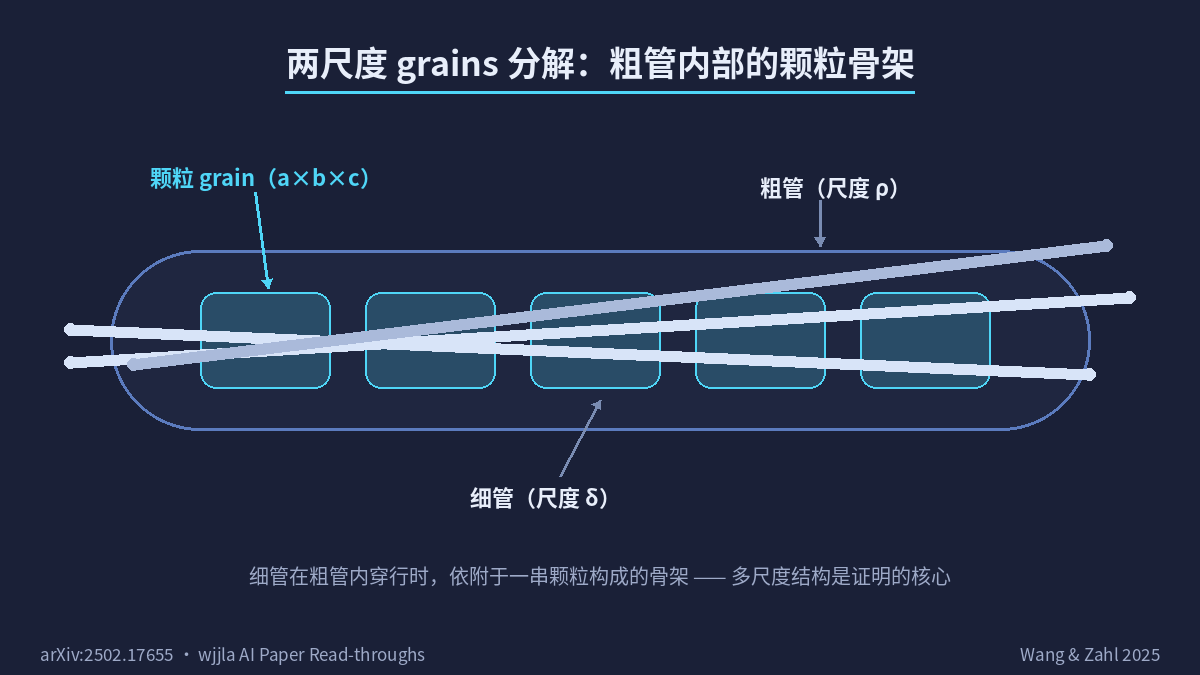
颗粒尺寸里的 c 不是随便定的:c ≥ 1/√(#T[Tρ])——颗粒大小跟你 ρ 管里塞了多少 δ 管成反比,塞得越稀疏,颗粒拉得越长。这一行公式(L950, §2.2)是后面所有数量级估计的基石。这里的 #T 是"管子总数"的简写,Tρ 是"在某个 ρ-tube 范围内的子集"——这两个符号意味着什么,就是"现在尺度的颗粒大小,受限于上一尺度那根粗管里塞了多少细管"。
Step 3: 三招 moves(§8)
这一步在干什么:Step 2 拿到的 grains 还没有"到位"——有的太长、有的太短、有的太窄。为什么非它不可:后面尺度归纳对 grains 的"形状"有严格要求(6 条性质 (i)-(vi)),不把这三件事做了,归纳的输入不满足条件,证明就推不下去。
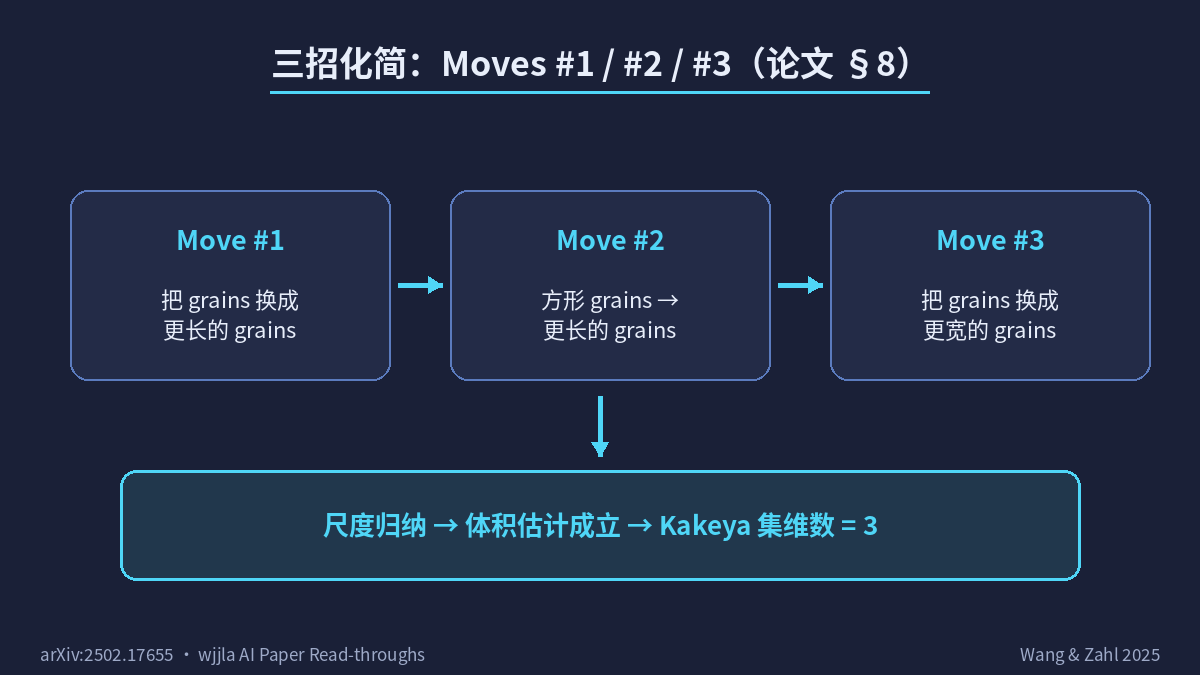
作者做了三件事把 grains"推到位"——这三招合起来,就像整理书架的三个动作:把歪的书扶正(Move #1)、把高矮不一的书摞齐(Move #2)、把相邻几本相关的书合成一本更厚的合订本(Move #3)。
具体来说:
- Move #1(§8.1):把 grains 换成更长的grains,确保 c 满足 c ≥ δ^ζ · ρ·#Tρ / #T。这一步在干什么:把"颗粒太小"的糖葫芦串重做成"颗粒够大"的串,确保颗粒尺寸公式的下界。为什么不满足就扔掉 grains 重做:因为下面所有估计都依赖这个下界,下界不满足公式就会爆掉(变成发散估计,没意义)。如果不满足,直接放弃这组 grains,回到 Guth 分解的输入重新跑一遍——这是算法上的"硬重来"。
- Move #2(§8.2):如果 grains 是"方形"的(横截面 a × b × c 里 b/c 太大),用 Cordoba 风格的 L² 估计把 grains 换成更长的——δ^(-ω/100) 的级别拉长。这一步在干什么:处理"颗粒横截面太方、纵向不够长"的情况——糖葫芦太"鼓"了,需要把每颗山楂拉长。为什么用 L² 估计:因为这是把"平方可积"的不等式工具用在颗粒几何上,刚好能把"横截面 / 纵向"的比值压下来。
- Move #3(§8.3):如果 CKT-CW 太大,每个 grain 可以用 L² 论证扩成一个"hairbrush"(梳子状):用 δ̃-neighborhood 把它周围的 grain 都吃进来,得到一个更宽的grain。这一步在干什么:当某个尺度上"分散度"指标已经恶化(管子开始扎堆),就把附近的 grain 合并成一个更大的"梳子"——把几根小糖葫芦合成一根大糖葫芦。为什么不直接删掉这些 grain:因为它们承载了真实的几何信息,删了就丢结构;只能合并,不能扔。
每做一次 move,要么 c 大幅增长、要么 ρ 大幅增长,但两者都被 1 封顶,所以这个迭代过程必然在有限步后停下——这是单调有界必收敛的经典套路。停下时的 grains 满足全部 6 条性质 (i)-(vi)(L948-970)——这正是后面 induction on scale 的输入。
Step 4: 精细化尺度归纳(§9 + §11)
这一步在干什么:把 Step 3 的"理想 grains"再过一次更精细的归纳——把 E(σ, ω) 应用到两层,不是只用一次。为什么非它不可:单用一次 E(σ, ω) 给出的体积估计还不够强(只够让 ω 减一点,不够让 ω 一路压到 0);两层都用一次才能把估计叠成"乘积形式",比单独用一次强一截。
拿到 Step 3 的"理想 grains"后,论文做了一件更精细的事:把 E(σ, ω) 应用到两层——既用在每个 ρ-tube 内的 δ-tube 上(细尺度),又用在每个 grain 缩放出的 ρ-tube 族上(粗尺度)。两层都用一次,得出来的并集体积估计是"两层乘积"形式,比单独用 D(σ, ω) 强一截。这就是 Proposition 1.7 的核心——它说:每次归纳都把 ω 减掉一个 g(σ, ω) > 0,固定 ω 反复用,σ 就能一路减到 0。
这套归纳的精神就是"爬楼梯":楼梯每一级比上一级略低一点,只要每一步真的能下降哪怕一点点(g(σ, ω) > 0),重复走下去就能落到地面(σ = 0)。为什么一定要"两层"而不是"一层":单层归纳会让 ω 减得不够快,迭代次数不够,最终 σ 减不到 0;叠成乘积形式后,下降速度乘起来了,才有可能真正收敛。σ 和 ω 这两个符号意味着什么:粗略讲 σ 是"维度亏空指标"(越接近 0 越接近满维),ω 是"分散度退化指标"(越大表示管子越扎堆,越小表示管子越分散);归纳要同时把这两个参数压到 (0, 0)。
Sticky Kakeya 收尾(§10 + §2.4)
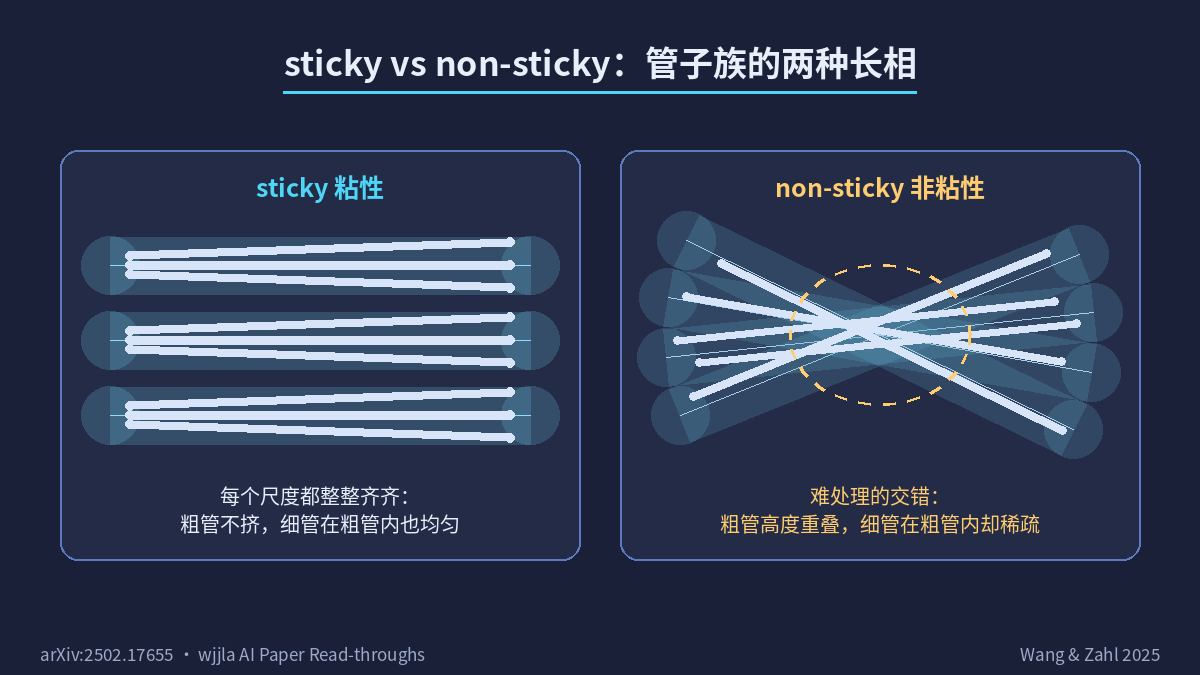
最致命的一步:假设 D(σ, ω) 对某组 σ, ω > 0 是紧的(没有冗余),通过 Step 4 推出 T 必然在多个尺度上 self-similar,满足 Sticky Kakeya 定理的输入;但 [25] 已经证明 sticky Kakeya 集维数 = 3,这就跟 D(σ, ω) 的紧性假设矛盾。所以 σ 和 ω 必须同时为 0——也就是 D(0, 0) 和 E(0, 0) 都成立,这就是 Theorem 1.9。
sticky 这个词,生活类比就是俄罗斯套娃——外面那层娃娃套着里面一层,里面又套着更里面一层;sticky Kakeya 集的结构就是这样:在每一个尺度上(粗看、细看、更细看),这个集合看起来都"长得像自己"——大尺度里有小尺度,小尺度里还有更小的尺度,层层 self-similar。为什么这种"套娃"结构能让矛盾导出:因为一旦确定反例是 sticky,[25] 里已经证明 sticky Kakeya 集维数一定是 3;但你又假设维数 < 3(反例存在),于是反例不可能 sticky——但前面又推出了反例必然 sticky,矛盾。
这一步里的工具是 Nikishin-Stein-Pisier factorization(§10.1,L5910):用来把稀疏的 T(数量 « δ^(-2))补齐到 δ^(-2) 个,确保 Sticky Kakeya 定理能用。这个工具的精神就是"绷到最紧的皮筋"——你有一堆管子,太稀疏(数量 « δ^(-2)),Sticky 定理要 δ^(-2) 个才跑得动;Nikishin-Stein-Pisier 做的事情就是把稀疏管子"乘"出一个稠密版本,相当于把一根皮筋拉紧——稀疏集合被刚性扩张成稠密集合,里面的"密集程度"达到 Sticky 定理需要的下限。
五、两个意外收获:Tube Doubling 和 Keleti 猜想一起被关了
读到这里你以为结束?不,论文顺手证明了三维 Tube Doubling 猜想(Theorem 1.12, L685)和 Keleti 的线段延伸猜想(Theorem 1.14, L698)。
Tube Doubling说的是:把一堆 δ-tube 都"加粗一倍"(变 2δ-tube),加粗后并集体积最多比原来差一个 sub-polynomial 因子 δ^(-ε)。二维版本此前已知(论文 §1.6 记载),三维一直卡。Wang-Zahl 这套 Wolff 公理 + 凸集分解直接拿下。
Keleti 猜想说的是:一堆线段伸长成直线后,这些直线的维数等于原来线段并集的维数。Keleti-Máthé([23])在 2022 年证明 n 维 Kakeya 集猜想蕴含 n 维 Keleti 猜想,所以 Wang-Zahl 这一波白送一个 Keleti 猜想三维版。
这两个推论都不是"显然推论",论文里 §12 给了 Tube Doubling 完整证明,用了 §11 同样的多尺度结构定理 + Nikishin-Stein-Pisier factorization。
六、边界:n ≥ 4 为什么不顺手关上?
这一点论文没明说,但我读完 §1 提一下。整套论证里专门依赖三维的地方至少有 3 处:
1.Wolff hairbrush bound在三维里给的是 δ^(1/2) 指数(L240 附近)——这正是 Proposition 1.8 “D(1/2, 0) is true” 的启动点,整套迭代的起点就吃这个三维指数。 2.Guth grains 分解是三维里的工具([9], L487, §1.5);它在高维有没有等价物,论文没有讨论。 3.断言 D/E 等价的指标范围 σ ∈ [0, 2/3](L302, Proposition 1.6),这个 2/3 来自本文的三维论证;高维下这个范围怎么变、迭代还能不能跑通,论文没有讨论。
所以严格讲:n ≥ 4 仍然是公开问题。论文的方法论可能给后续工作提供模板,但不直接传递结果。
Keleti 线段延伸猜想(Theorem 1.14)和 Tube Doubling(Theorem 1.12)也被同时关在三维——这是三维特有的副产品,不能像 Kakeya 那样简单推 n 维。
七、批判性点评:这篇论文好在哪、难在哪、值不值得你啃
好在哪:
- 不耍花招。Katz-Tao program 从 2014 年提出到现在 12 年,中间一直有人想"绕开 stickiness 这一步",但每次都没绕成。这篇论文老老实实把 stickiness 处理掉——靠的是"如果 D(σ, ω) 紧,反例必然 sticky"这个新观察(§2.4 总结),加上 Nikishin-Stein-Pisier factorization 把稀疏集合补齐。我读 §2 proof sketch 最大的感受是:这套论证的"挂钩"接得极其紧凑,每一步都从前面拿到的结构推,没有"灵感式跳跃"。
- 多尺度结构定理(§7 的 Proposition 7.5)是独立可用的工具。即使你不关心 Kakeya,这"两尺度 grains 分解 + 6 条性质"本身就是几何测度论里可以反复引用的 piece。
- 写作清晰。127 页的论文,前 22 页就把骨架讲完了——Definition 1.3(非集中条件)、Definition 1.5(断言 D/E)、Theorem 1.2 + Theorem 1.9 + 推论,全部在 §1 摆出来,§2 给出 proof sketch。后面 §3-§12 才是填细节。这种"先说结论,再说证明"的写法对 127 页的体量是必要的。
难在哪:
- 3 个 Wolff 常数 + 5 个 moves/properties + 7 种 grain 维度组合,光是把命名记住就要画一张大表。论文 §3.2 有 notation 表,但第一次读很容易迷失。
- Nikishin-Stein-Pisier factorization(§10.1)这套工具对大多数读者(包括我)是新的——它本质上是"用随机刚体变换把稀疏集合补齐"的概率论证,需要一点概率 + 凸几何双重底子。
- 127 页不是营销噱头。§6(Assertions D 和 E 等价)的"4 路 polychotomy"(L884-901, items (A)-(D))需要把 Cases (A)-(D) 全部处理,每个 Case 又是一整章体量。这部分读起来比较熬。
值不值得啃:
如果你做调和分析 / 几何测度论 / PDE,这篇是 2025 年最重要的论文之一,绝对值得啃——而且建议从 §1 + §2 proof sketch 入手(只要 22 页),再决定要不要进 §4-§12 的细节。
如果你做的是相邻领域(组合、概率),至少读 §1 + §1.4 的历史脉络 + §1.6 的推论(共 14 页),足以建立"这件事是什么级别的结果"的直觉。
如果你只是数学爱好者,我把 §2 写成上面这段拆解,基本上就是故事主线。配 8 张图过一遍,核心思路就到位了。
八、一句话总结
三维 Kakeya 集的维数是 3,这件事在 2025 年初被一篇 127 页的论文用 Wolff 公理 + 凸集分解 + 两尺度 grains + 三招 moves + Nikishin-Stein-Pisier factorization 这套组合拳彻底关上。108 年前的日本几何问题,被一位北大 2011 届毕业的中国数学家和一位 UBC 的合作者联手画了句号。n ≥ 4 仍然开着,但工具箱现在已经搭好。
附图位置清单:
- fig01(挂谷转针问题)对应本文第一节上半部分
- fig06(维数是什么)对应本文第一节下半部分,介绍"维数"概念处
- fig02(管子族与非集中条件)对应本文第三节末尾
- fig05(维数下界历史进展)对应本文第二节末尾
- fig07(证明流水线总览)对应本文第四节开头
- fig03(两尺度 grains 分解)对应本文第四节 Step 2 末尾
- fig04(三招 moves 流程)对应本文第四节 Step 3 末尾
- fig08(sticky 与非 sticky 对比)对应本文第四节 Sticky 收尾段