设想一下:你招了个实习生,让他帮你订机票、填表格、整理文件。
但你给他立了一条规矩:只许看屏幕,只许动鼠标键盘,不许看软件后台的任何接口。
听起来很苛刻。可这正是 2026-08-04 提交到 arXiv(编号 2608.02352)的论文《Qwen-CUA: Native Computer Use for (almost) Everything》干的事。Qwen 团队和港大 Xlang Lab 联合发布,作者超过 30 人,GitHub 仓库已开在 xlang-ai/Qwen-CUA。
今天整篇文章就回答一个问题:这条规矩下被培养出来的实习生,到底能不能被练出来干活?
为什么非得把规矩定得这么绝
AI 想在数字世界干活,其实只有三条路:写代码、调接口、用图形界面。前两条路,过去几年的大模型已经很擅长,因为它们看得懂文本、调得动工具。
可现实中大量的活,根本不在前两条路上。桌面软件、老系统、专业工具,功能只画在屏幕上,机器读不出来。所以"只看屏幕、只动鼠标键盘"不是自虐,是唯一一条能通吃所有软件的路。
但这条路有三个老大难:界面状态只看到一半、错误越滚越大、证据散落在几十张截图里。论文 1 Introduction 把这三条讲得很硬。Qwen-CUA 怎么一关一关过的?得先从"眼睛和手"说起。
第一关:配好一双眼睛和一只手
论文 2.1 节给实习生配了一套极简装备,画在 Figure 2 里。
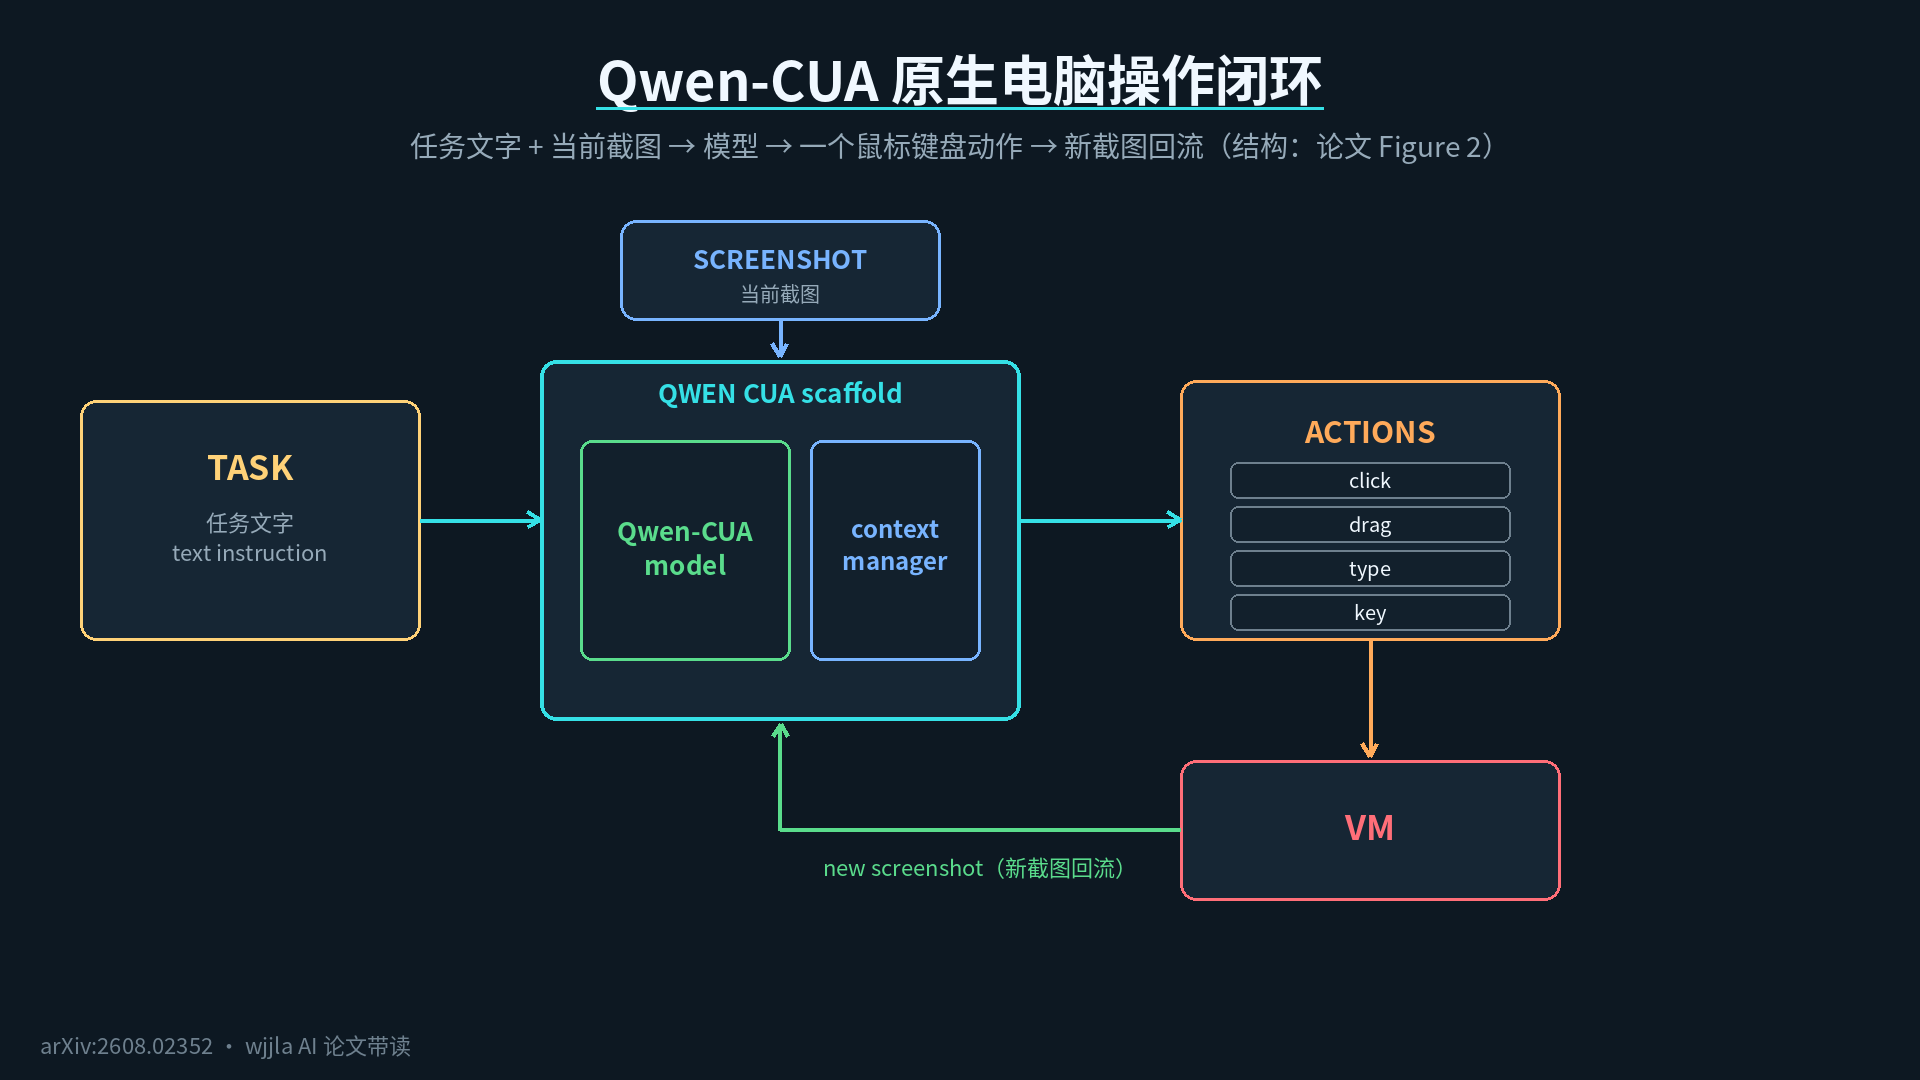
整个工作循环就一句话:输入一段任务文字,看一张当前截图,输出一个鼠标键盘动作。动作分三类:鼠标(移动、左/右/中键点击、双击三击、拖拽、滚动)、键盘(按键组合、按住/松开、文本输入)、控制(截图、等待、终止、呼叫用户)。附录 A 列了完整动作清单。
中间有个叫"脚手架"(scaffold)的东西,你把它当成工位上的协调员就行——把任务交给模型、把截图喂进去、把动作下达到虚拟机、再把新截图收回来。内部细节不用你管,每个回合只做一件事。
论文里有一句话我必须翻译成人话:这套装备跨浏览器、跨桌面应用都能用,不改一行配置。不用 DOM 树、不用无障碍元数据、不用任何专用 API。它就是一只标准的"人眼 + 人手"。
配好眼睛和手只是第一步。真正头疼的,是活一干长,它就记不过来了。
第二关:记性不够,便签本来凑
2.2 节解决的就是记性问题。
长任务会攒下几十上百张截图,全塞进脑子的短期记忆,谁也装不下。Qwen-CUA 的办法像一本便签本:
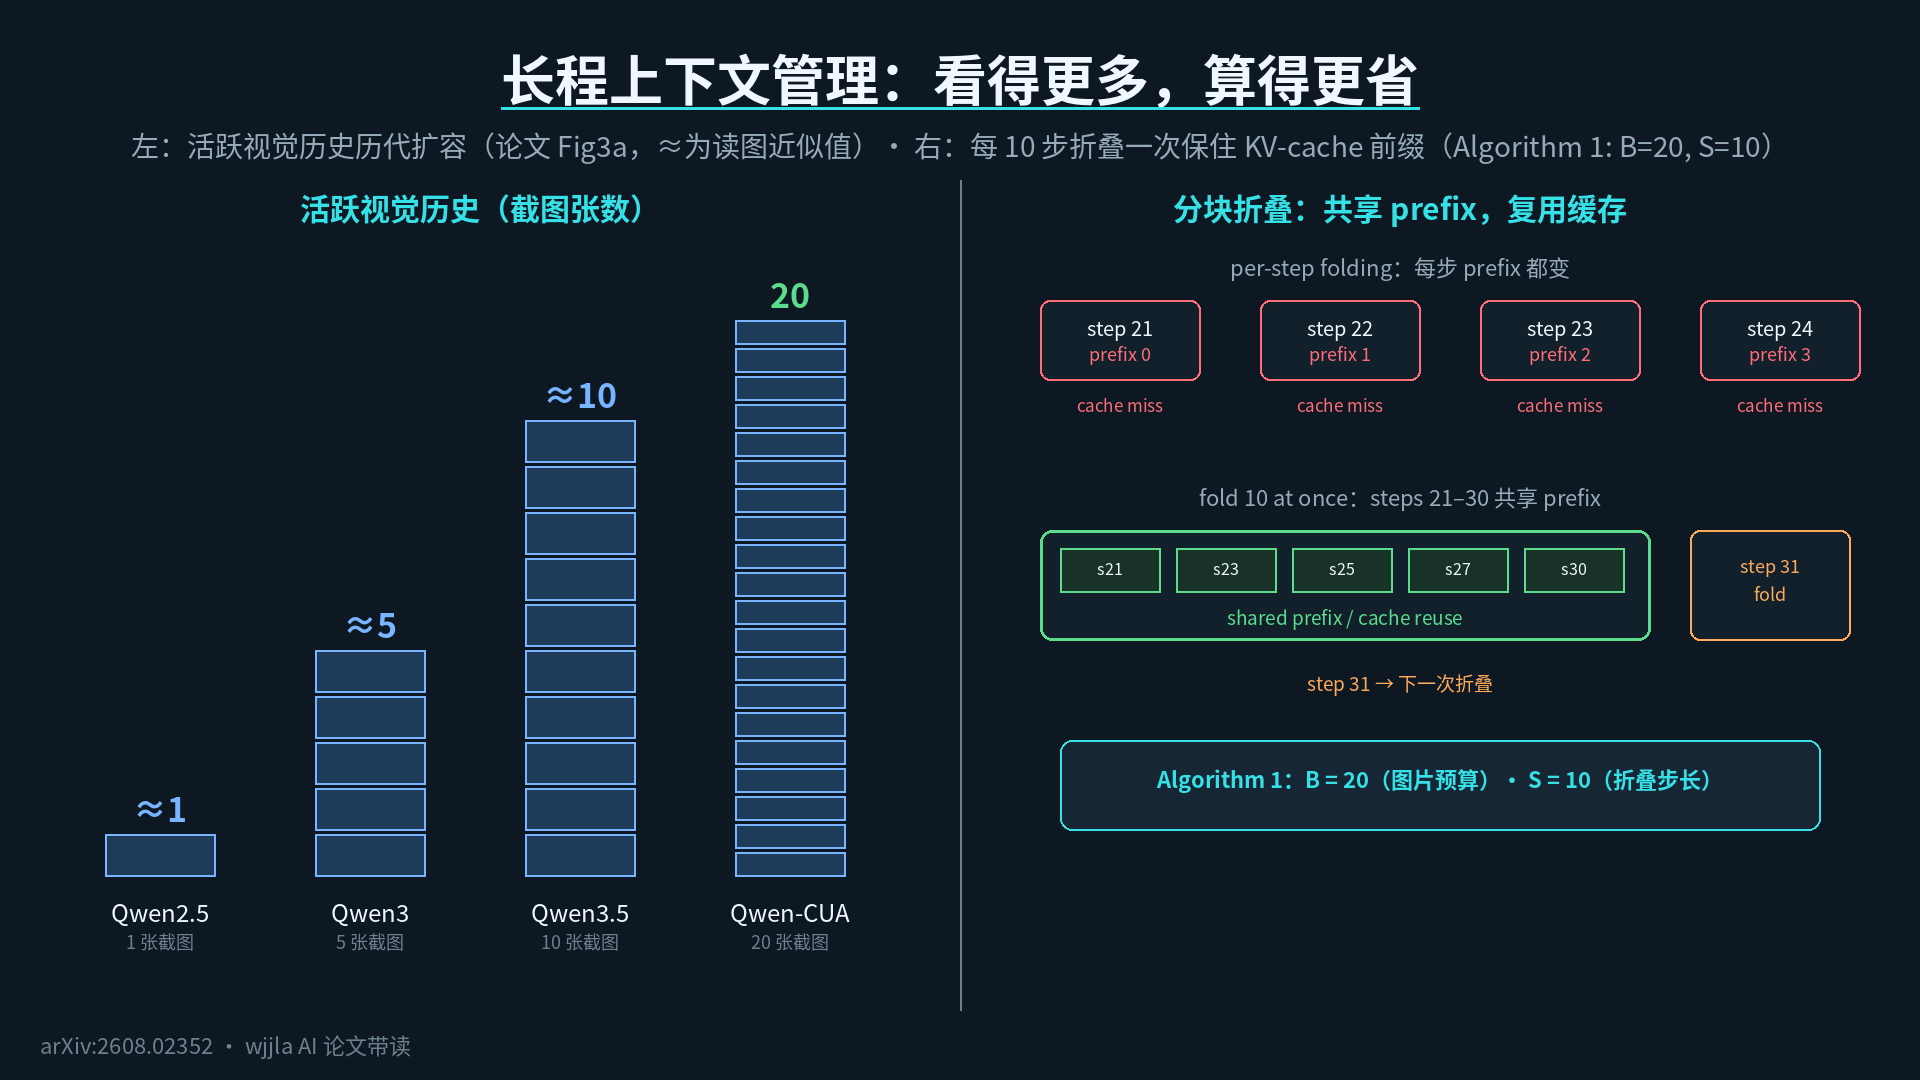
- 活跃视觉历史最多 20 张截图。最近 20 张摊在桌上随时看。
- 每攒满 10 张,往前折叠一次。折叠不是扔掉,是把更老的截图换成一段文字占位"这里曾经有张截图,当时做了 X",但当时做的动作、当时的思考,全都还在上下文里。
论文 Figure 3(a) 画了历代 Qwen 的"桌面"越摊越大:Qwen2.5 只看 1 张、Qwen3 是 5 张、Qwen3.5 是 10 张,Qwen-CUA 直接扩到 20 张。Figure 3(b) 对比两种折叠方式:每步都重订(prefix 一直在变),还是每 10 步才订一次——后者共享 prefix,KV-cache 直接复用,省算力。
还有一个训练上的细节:强化学习用的就是同一个折叠算子,一整条长轨迹被切成多个上下文有界的切片,每个切片继承同一个终止奖励。这样不需要人为给中间步骤编奖励,监督信号也能从最后状态一路传到中间决策上。
眼睛、手、便签本都有了——接下来是核心问题:这个实习生到底是怎么练出来的?
第三关:怎么练——先建一座十万核的"驾校"
训练电脑操作智能体,最难的不是模型,是得有个地方让他反复试错。
作者干脆建了一座"驾校",跑在阿里云 ECS 上,接近 10 万个虚拟 CPU 核心,同时能铺开数万个并发环境。每台虚拟电脑都是一个独立工位,随便他折腾。
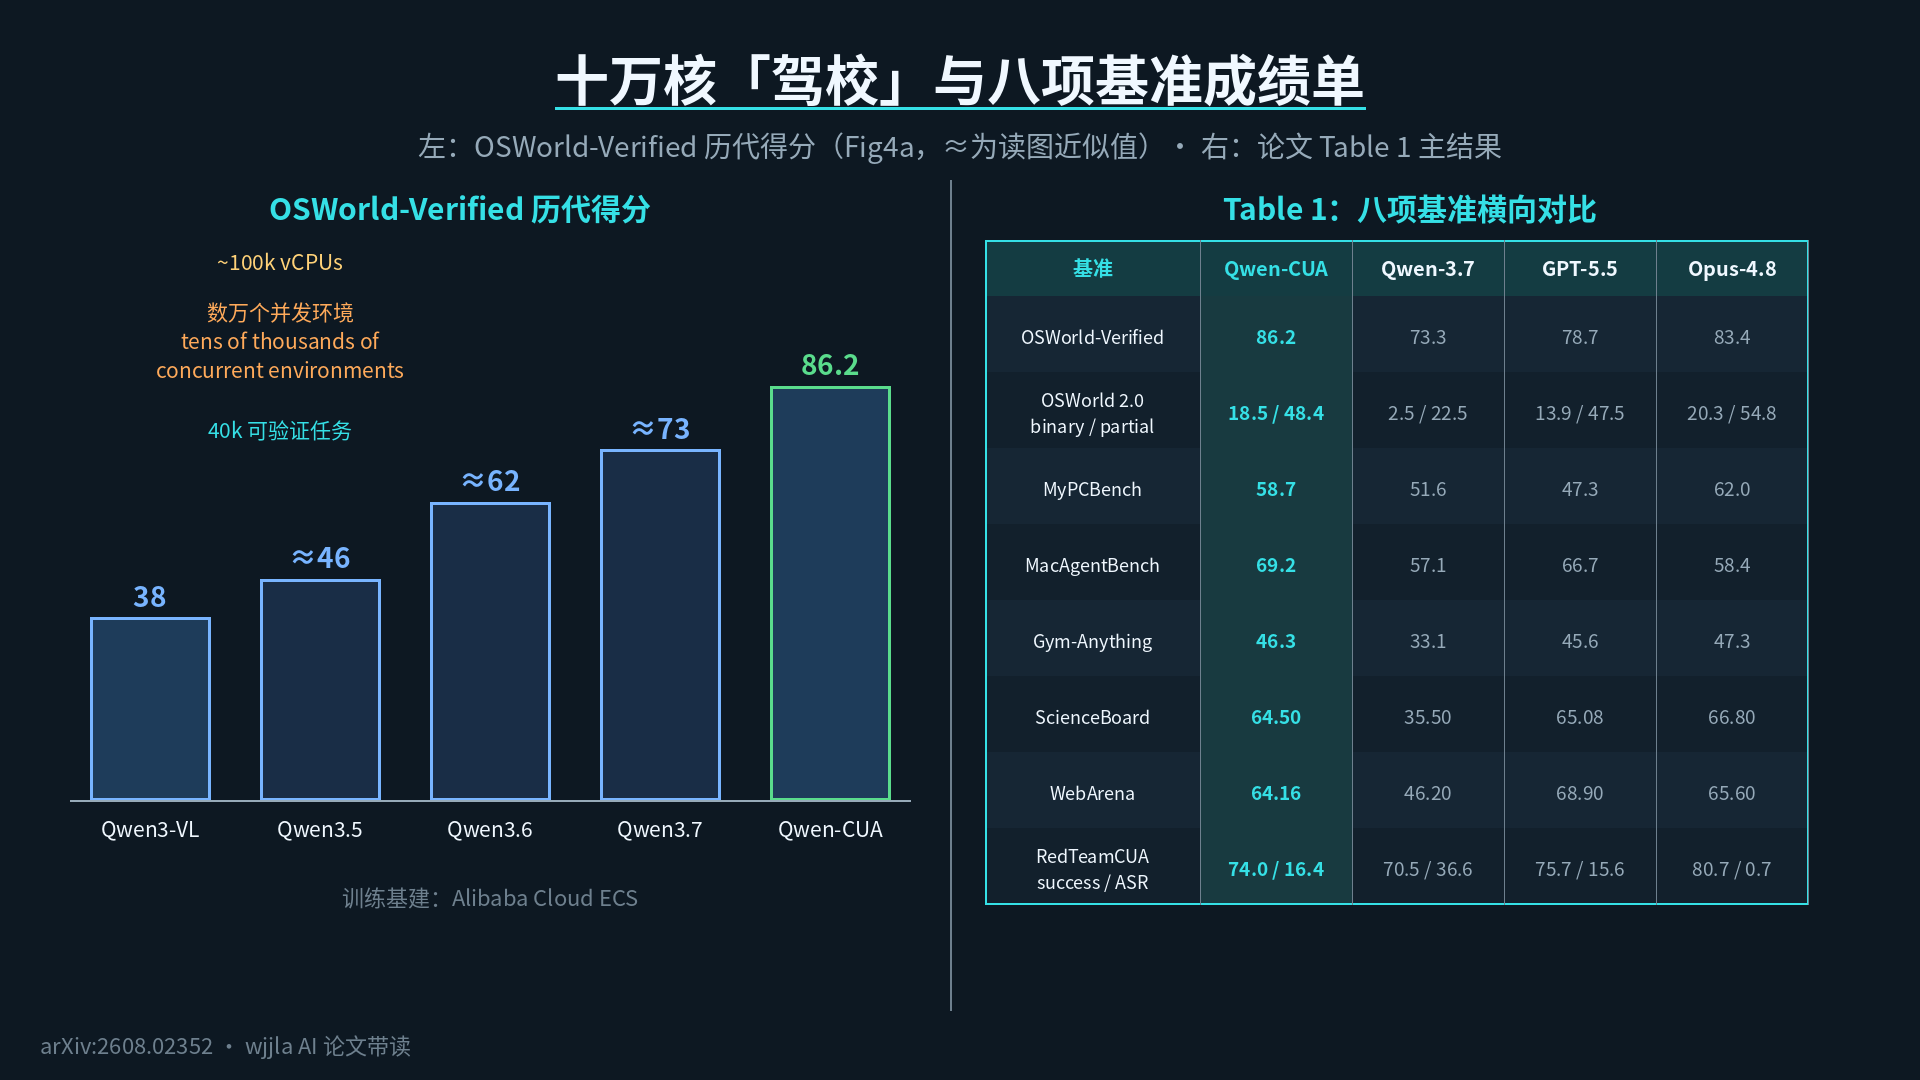
Figure 4(a) 很有画面感:历代 Qwen 在 OSWorld-Verified 上的得分,从 Qwen3-VL 的 38 一路爬到 Qwen3.5 的 46、Qwen3.6 的 62、Qwen3.7 的 73,再到 Qwen-CUA 的 86.2。图里同时标了三个里程碑:约 4 万条可验证任务、约 10 万 vCPU、数万个并发环境。
驾校和考具备齐了,那教材从哪来?这就是下一关。
第四关:教材——三类习题加一类师傅带教
教材分三类习题,再加一类"师傅带教",我帮你压成一张课表:
- 环境操作题(第一类)——教他认出软件里的按钮、菜单、状态切换。
- 用户交互题(第二类)——故意把任务说得信息不全,看他会不会主动开口问。这套题用了 OSWorld 2.0 的"模拟用户"思路:模拟用户只在他问的时候才回话。
- 长流程题(第三类)——把大事拆成可自动判分的小阶段。像接力赛一棒一棒传,每一棒有一个可验证的终止状态,过了就把状态序列化给下一棒当起点。这一招叫"phase-state chaining",论文 3.2.2 讲得很细。
- 真人师傅带教(第四类)——让真人在自己电脑上干真实的活:订机票、填表格、CAD、Blender 都干。模型再给每一步补上"内心独白"(chain-of-thought),并按"和当时截图对得上、和我做的动作对得上"两轮筛掉胡编的。
四类加一起就是驾校的全部教具。但训练电脑操作智能体,最稀缺的不是数据,是会犯错、能在错里越练越好的算法。
第五关:教练方法——在试错里涨分
3.3 节讲强化学习,算法叫 SAPO,全称 Soft Adaptive Policy Optimization。名字不用记,知道它是"做错了扣分、做对了加分"的最新练法之一就行。
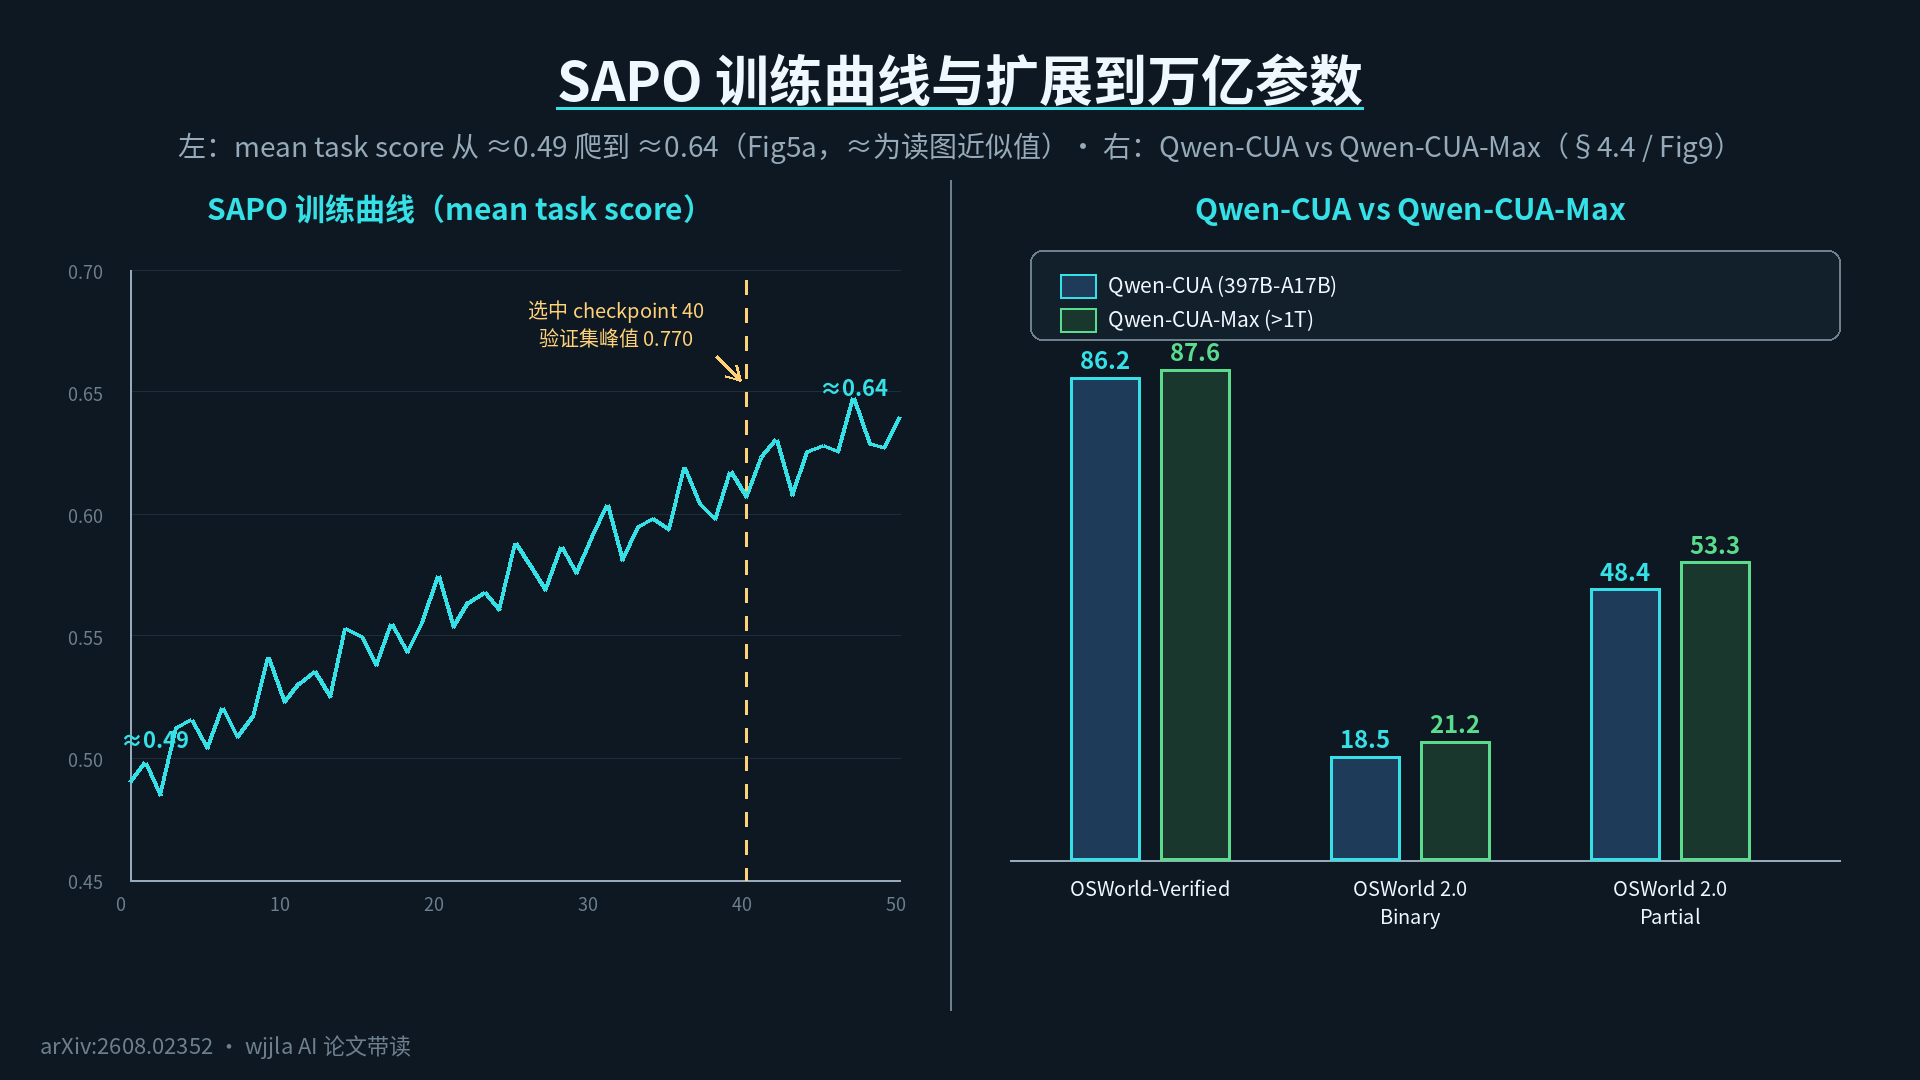
Figure 5 是训练曲线,咱们只看趋势:
- 训练得分从一开始的 0.49 一路爬到 0.64,中间有抖动,因为每批考题都不一样。
- 跨域验证得分从 RL 前的 0.734 爬到checkpoint 40(即第 800 次更新) 的 0.770 峰值,作者就定下这个版本作为最终模型。整个训练跑满 1000 次更新预算,到 checkpoint 50 时是 0.762。
3.4 节还讲了一个迭代训练的逻辑:每一轮用最新模型去暴露新问题、补新题、再训下一轮。具体做法分两步:第一步让最新模型去跑现有 SFT 题,统计哪些题还做不对——这些题换教师策略重新生成演示。第二步对强化学习候选题做"难度筛选":跑 8 次试验 rollout,0 次成功的(太难)和 8 次都成功的(太简单)都剔掉,只留中间地带。这种"自我挑题"的逻辑让训练永远在刀刃上。
练到这里,实习生出师了——该上考场了。
第六关:八项大考的成绩单
考场一共八个项目,论文 Table 1 是主成绩单。
最重头的一门叫OSWorld-Verified:Qwen-CUA 拿 86.2 分,前任 Qwen3.7 是 73.3。同场还有闭源选手:GPT-5.5 是 78.7,Claude Opus 4.8 是 83.4。八项里 Qwen-CUA 在 OSWorld-Verified 和 MacAgentBench(69.2 分)两项拿了同场最高分,其余各项也都跟闭源强手打得有来有回——比如 OSWorld 2.0 和 RedTeamCUA 上 Opus 4.8 仍压他一头。
更难的OSWorld 2.0 长任务:Qwen-CUA 拿二值完成率 18.5 + 部分完成率 48.4,把前任的 2.5 和 22.5 甩开一大截——二值完成率几乎翻了 7 倍。
Figure 1 把八门成绩画成柱状图,每组颜色最深的是 Qwen-CUA-Max,后面单独讲。
先记住一件事:八个项目,他全部超过了自己的前任。
但先别急着鼓掌——会不会他是靠"想得久、废话多"刷出来的?
第七关:成绩有没有水分——效率检查
这个质疑很合理,论文 4.1 节专门做了效率分析来回应,就在 Figure 6。
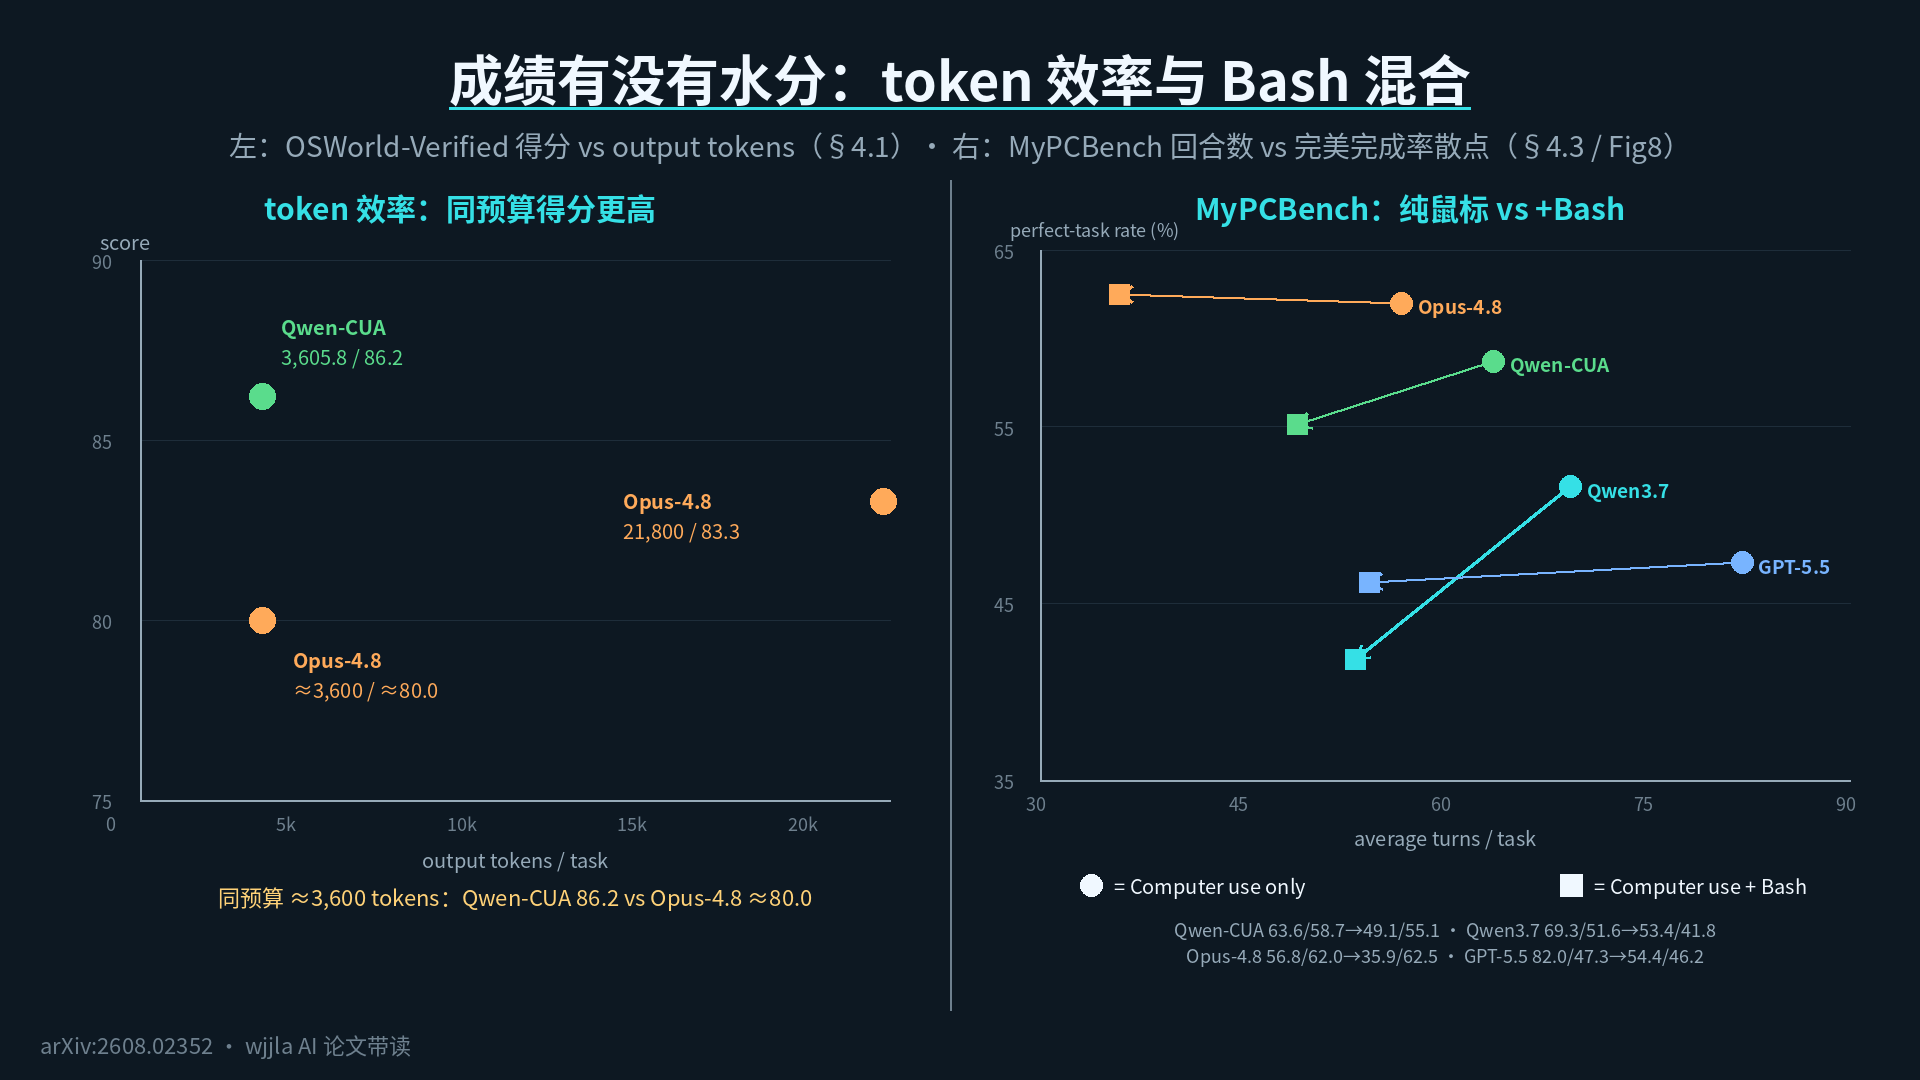
左图是 token 效率。横轴是每道题模型输出的字数,纵轴是 OSWorld-Verified 得分。Qwen-CUA 只用3,605.8 个输出 token就拿到 86.2。同样的预算下,Claude Opus 4.8 只有 80.0;Opus 4.8 想拿到 83.3,得烧到 21.8K token。Qwen-CUA 的提升不是来自"啰嗦"。
右图是交互效率。横轴是回合数,OSWorld 2.0 上 Qwen-CUA 平均218.9 回合/ 题,比 GPT-5.5 的 83.5 多不少。不过作者提醒一句:闭源系统一回合可发多个动作,Qwen-CUA 一回合发一个,所以回合数差距更多是接口颗粒度不同,不是"笨"。
效率关过了。但会干活还不够——干活的时候靠不靠得住?
第八关:靠不靠得住——防钓鱼测试
电脑操作智能体有个特有的大坑:屏幕上的内容,可能是坏人故意塞的诱饵。比如网页上弹个"领取补贴"的假按钮,一点其实是转账。
RedTeamCUA 这个基准专门测这个,同时看两个数:活干成没有、被骗了没有。Qwen-CUA 的两项指标双双改善:
- 任务成功率从 Qwen3.7 的 70.5 涨到74.0;
- 攻击成功率(ASR)从 36.6 降到 16.4,整整削掉 20.2 个百分点。
难得的双赢:活干得更好,还更不容易上当。这个改进在自己云盘、即时通讯、Reddit 三个平台上是一致的(Table 2)。
不过作者很诚实:16.4 的 ASR 仍然是残余风险,不是安全保证。在 Rocket.Chat 上看 ASR 还得连着任务成功率一起看——有些失败是被卡住、不是识破骗局。
考场里表现说完了——出了考场,在真实互联网他行不行?
实战场:真插件 Qwen for Chrome
4.2 节走出考场,上了真实互联网。Figure 7 是一张浏览器截图:屏幕右侧多了个 Qwen 侧边栏,这就是Qwen for Chrome——一个内部 Chrome 插件。
它就在真实网站上干活,每一步动作都摆给你看,不搞暗箱。碰到付款、删文件这种关键操作,先弹窗让你点头,再动手。
附录 E 还有一个端到端案例:让 agent 在浏览器里自己买云服务器、配环境,一路点鼠标完成。这件事的意义在于:他不是在做考卷,是在真实世界里跑腿。
不过真实工作里,光会点鼠标就够了吗?老程序员都知道,还有命令行。
第九关:该不该给他配命令行——Bash 混合的意外
4.3 节问了个实在问题:鼠标键盘之外,要不要再给 agent 开个 Bash?
答案是:配上 Bash,干活路径更短,但成功率会掉一点点。
论文 Figure 8 用散点图画得很清楚(注意:散点图,不是柱状图):
- 配上 Bash 后,Qwen-CUA 的 MyPCBench 平均回合数从 63.6 降到 49.1;
- 但完美完成率从 58.7 跌到 55.1。
Qwen3.7 也是同样的趋势:69.3 → 53.4 回合、51.6 → 41.8 完成率。
作者的解释是:不是命令行不该配,是模型还没学会"什么时候该切过去"。Bash 给了一条更短的路,但不必要或时机错的切换会拖累正确率。作者把这点归类为"优化缺口",不是"混合接口的局限",并明确说"未来靠联合训练和显式 tool-routing 监督能恢复正确率同时保留效率"。
这是一个很重要的提醒:接口的丰富不等于用法的成熟。
第十关:换更大的脑子——Qwen-CUA-Max
4.4 节换条路:把 397B-A17B 直接放大到超过 1 万亿参数,名字叫Qwen-CUA-Max。同一套培养方法,喂更大的脑子。
结果:
- OSWorld-Verified:86.2 → 87.6;
- OSWorld 2.0 二值完成率:18.5 → 21.2;
- OSWorld 2.0 部分完成率:48.4 → 53.3(提升最大的一项)。
也就是说,这套培养配方没过时——再喂参数,还能继续涨分。
考场、实战、装备、升级版都讲完了——回到开头那个问题。
读完觉得值得提醒的几点
第一,“只许看屏幕"这条路走得通,但慢且贵。像素路线天然比 DOM 路线慢——每一步都要把截图重新喂给模型推一遍,每次推理都是几十毫秒到几百毫秒。论文 Conclusion 自己承认:“Generality does not imply optimality”。这条路线最大的价值是通用性——能通吃桌面软件、动态网页、专业工具,而不是速度。如果你的活能在代码或 API 里完成,那条路更便宜。
第二,16.4 的被骗率不是 0。RedTeamCUA 上 Qwen-CUA 把攻击成功率从 36.6 砍到 16.4 是巨大进步,但仍然意味着 100 次"屏幕上有诱饵"里有 16 次 agent 会上当。这条数字放在企业部署里必须配人工兜底——这也是 Qwen for Chrome 设计成"关键操作弹窗确认"的原因,不是技术炫技,是真的需要。
第三,Bash 混合反而掉分,是给整个 AI 工具圈的提醒。“能调的工具更多"不等于"效果更好”。Qwen-CUA 还没学会什么时候该用哪只手,这是 RLHF / agentic RL 的下一个攻坚方向。论文没有把这点包装成成果,而是直接写"an optimization gap”,这种诚实值得同行学。
第四,internal-only 插件没对外开放。Qwen for Chrome 跑在团队内部,论文里没承诺开放下载日期。这是论文没有展开的限制:模型再强,没有落到开发者手里的入口,影响力就只是论文数字。对关心"能不能今天就用上"的读者,论文给的是能力上限的参考,不是产品上线时间表。
第五,1T 参数的 Max 模型只是顺手提了一嘴。论文没单独花章节讲训练成本、推理延迟、Max 与基础版的差距分析。从工程角度看,1T 是大模型时代的"小升级",但 RL 训练成本、KV-cache 占用、长轨迹推理的显存压力都没具体披露。要复现 Max 的成绩,论文给的信息还不够。
一句话总结
让 AI 只许看屏幕、动鼠标键盘,确实能练出来干活——八项基准全面超过前任,和闭源强手打得有来有回。但练出来不等于用得上:16.4 的被骗率还在、像素路线贵且慢、工具混用还不会挑时候。Qwen-CUA 给出的不是终点,是"通用视觉层"作为混合 agent 的基础组件这个思路的工程实证。
论文:Qwen-CUA: Native Computer Use for (almost) Everything arXiv: https://arxiv.org/abs/2608.02352 项目主页: https://github.com/xlang-ai/Qwen-CUA