阿里 Qwen 团队 2026 年 7 月放出的 arXiv 论文 (2607.22529),核心是把"技能库 (skill library)" 做成 LLM 自博弈训练的 curriculum 引擎。这篇文章不堆 term,只看它到底解决了什么、怎么解决的,以及值不值得你花时间上手。
一、问题的真痛点: 自博弈训练卡在了"多样性"和"可验证性"的死结上
过去两年 LLM 训练范式从"人工标注 + SFT"切到"自演化 (self-evolution)",核心思路是让模型自己生成训练数据、自己给自己打分。但这条路走到 2026 年,卡在了一个非常具体的矛盾上:
- 环境绑定 (environment-bound) 路线(比如让 LLM 写代码、再跑 unit test): 反馈精确,但能跑的任务域很窄,基本就是编程和数学证明这类能机器验证的场景。
- 开放式自生成 (open-ended self-generation) 路线(让 LLM 写一道题、再让 LLM 自己判): 任务域宽,但 reward 信号不可靠。模型很容易学会"糊弄判官",reward 一旦被 hacking,训练就崩了。
这两个问题在工业界各占一半的失败案例。Skill Self-Play (下文简称 Skill-SP) 的切入点是:技能 (skill)这个东西天然是中间地带 —— 一个 skill 是一段可复用的"结构化执行能力",对单个任务来说执行深度足够、可验证性高,换一个任务又可以通过动态路由拓展覆盖域。
我读完 paper 之后最大的感受是:它不是在哲学层面论证 “skill 是中间地带” —— 它直接把 skill 当成可执行对象,做成一个能被 RL 框架 update、route、retire 的动态库。这个"把抽象概念落地成可操作的工程对象"的思路,比论文标题想表达的"能力前沿"要实在得多。
二、三个角色:Proposer / Solver / Skill Controller
Skill-SP 的架构非常干净,核心是三个角色在 RL loop 里 co-evolve:
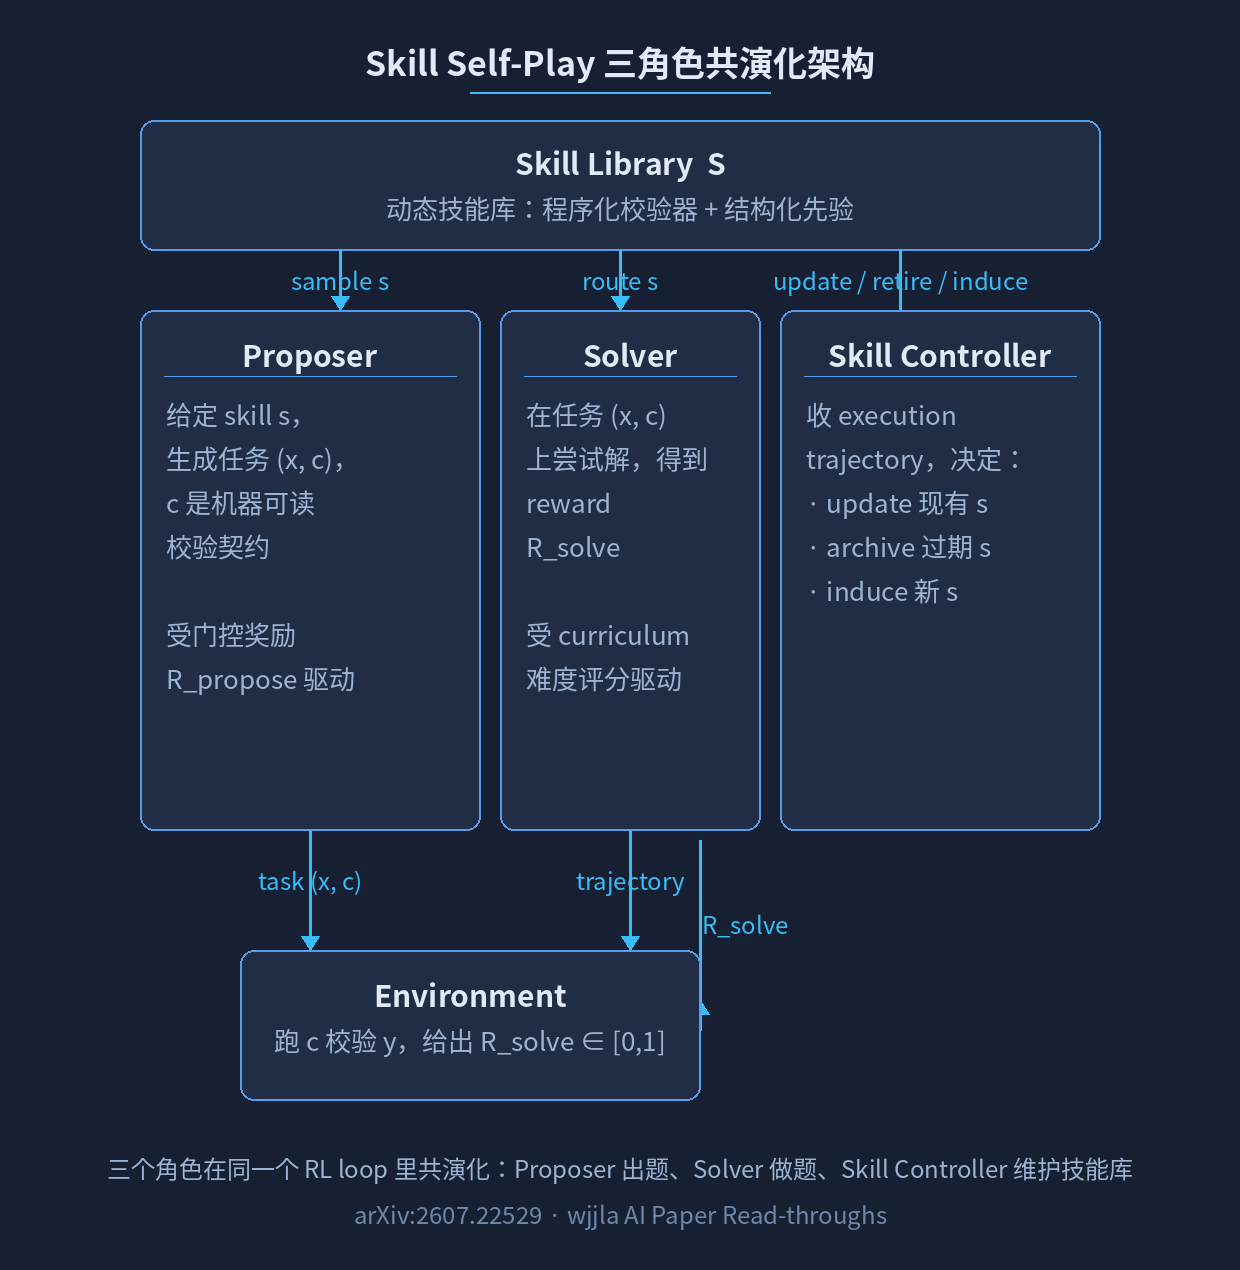
Proposer干的事很聚焦:给定一个从技能库 S 里 sample 出来的 skill s,合成一个 (prompt x, verification contract c)。c 必须机器可读 —— paper 里举的例子是 unit tests 和 reference answers。Proposer 拿到的奖励不是"任务多难",而是一个 gated curriculum reward —— 只有当任务契约 (x,c) 在结构上合法时,才按"难度接近 0.5"打分,否则直接归零。这一步是 paper 强调的关键设计:它显式地把"reward hacking 的口子"堵上了,Proposer 想合成"我假装造了一个超难的题"是不行的,因为契约校验先于难度评分。
Solver干的事更传统:给定 (x, c),生成答案 y,环境跑 c 校验,返回 R_solve。Solver 的训练目标是被 Proposer 出的题训练 —— 但 Proposer 出题不是随机的,而是被 curriculum 评分引导到 Solver 当前的"学习前沿"上 (paper 里这个分数叫 medium-difficulty score,公式是 1 - 2|v_solve - 0.5|,目标是让 Solver 成功率接近 0.5,因为这恰好是模型"努力一把能做对"的范围)。
Skill Controller是这篇 paper 最有意思的工程设计 —— 它不是静态的 skill 列表,是一个动态维护的库。三类操作:
1.Update: 基于 Solver 在某个 skill 上的 execution trajectory,把这个 skill 的校验逻辑精炼一下 (比如新增边界 case 的 test)。 2.Archive: 一个 skill 如果连续多轮没人 trigger,标记为过期,移出主库。 3.Induce: 从开放生成流里发现新的可复用结构,自动包装成新 skill,加入库。
paper 里的实测:5 轮迭代后,有效 skill 数 (Shannon 熵加权) 从 1 长到 46,active skill 数到 86 —— 这意味着技能库在训练过程中是真的在扩张,不是 Proposer 在几把固定的 skill 上打转。
三、最核心的工程设计:技能库如何不被"模式坍缩"
自博弈训练的经典失败模式叫mode collapse:Proposer 发现某个 skill 出的题 Solver 反馈很稳,就反复用它,训练数据分布收窄到几个高频 skill 上。Skill-SP 在这一点上做了三层防护:
3.1 双流采样 (dual-stream)
不是 100% 从 skill 库采任务。Paper 里的实际配比 (Figure 4 消融实验推出来):
- Skill-stream: 从技能库 S 里 sample 一个 skill s,Proposer 围绕它生成任务。这部分负责"难度稳定在 Solver 前沿"。
- Exploration-stream: 不绑定 skill,Proposer 自由生成 —— 保留任务多样性,防止坍缩。
实测配比我没在 paper 找到精确数字,但消融显示:纯 Skill-only 训练 (100% skill stream) 平均掉 4.1 分;纯 Unguided SP 训练 (0% skill stream) 平均掉 2.6 分;只有混合流 (混合比例未公开,但论文标题暗示两路并存) 才稳定提升。这说明 Skill-SP 不是把开放式自生成干掉,而是把 skill 当成一个"调节阀",控制任务难度和多样性的平衡。
3.2 难度分数的门控 (gating curriculum reward)
这是 paper 里数学最关键的一处,把它单独拎出来:
Proposer 的奖励函数 R_propose 不是简单的"难 = 好",而是:
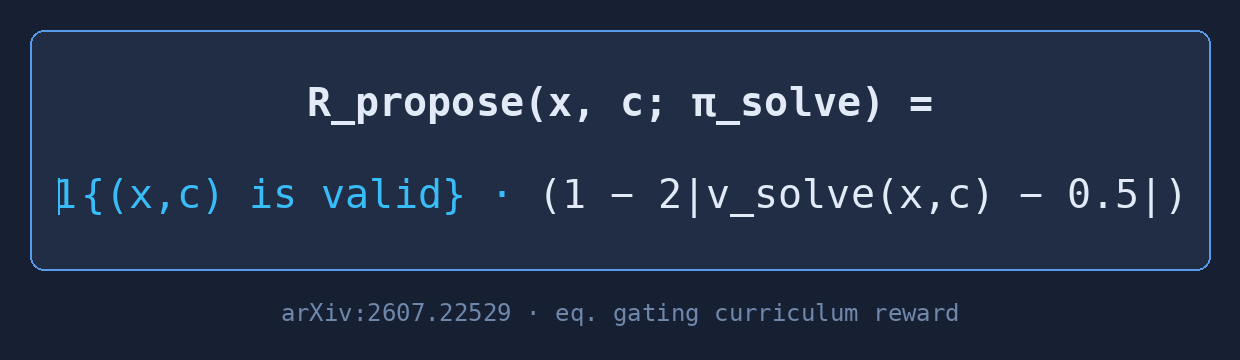
第一项 𝟙{(x,c) is valid} 是二元过滤器:任务契约 (x,c) 必须结构合法 (机器能跑 c 校验) 才计分,否则整个 R_propose = 0。第二项是 medium-difficulty 评分,|v_solve - 0.5| 越小分越高 —— 也就是让 Proposer 出的题,恰好让 Solver 当前成功率在 0.5 附近。
为什么是 0.5 而不是 0.1 (极难) 或 0.9 (极简单)?因为:
- 太难 (v_solve ≈ 0):Solver 得不到学习信号,reward 噪声大。
- 太简单 (v_solve ≈ 1):学不到东西,等效于刷题。
- 0.5 是"努力一下能做对"的 sweet spot,RL 收敛最快。
门控是关键 —— 没有它,Proposer 会学会"造一些看起来很复杂但 c 是空壳的题",rewards 直接归零逼迫它必须造真题。这就是 paper 标题说的 Co-Evolving Skills —— 不只是 skill 库在演化,是 Proposer-Skill-Solver 三方在互相"调教"。
3.3 Skill Controller 的具体实现
Paper 没给完整代码 (Qwen 团队专利保护),但给出了三个操作的口径:
- Update: 一个 skill 包 = (可执行模板, 校验器代码, 若干示例) 三件套。Controller 收到 Solver 在这个 skill 上的 trajectory,如果失败模式集中在某个边界,自动追加 test case。
- Archive: 维护一个"冷却队列",连续 N 轮 (我没找到 N 的具体值) 没被 Proposer sample 出来用的 skill 移到 archive,腾出主库容量。
- Induce: 这一步最有意思。Controller 跑一个轻量聚类 (用了 all-MiniLM-L6-v2 + PCA,见 Figure 5b 描述),把 exploration-stream 里生成的高频"程序化结构" (比如"总是要求列表去重后排序") 自动聚类成新 skill 包。
这条 Induce 链路,工程上实现了 “自动从数据分布里发现可复用先验” —— 跟传统 RL 里的 option discovery / hierarchical RL 是同一思路,但应用在 LLM 数据合成上,是 2026 年的新看点。
四、实验数据: 谁吃到了红利, 谁吃不到
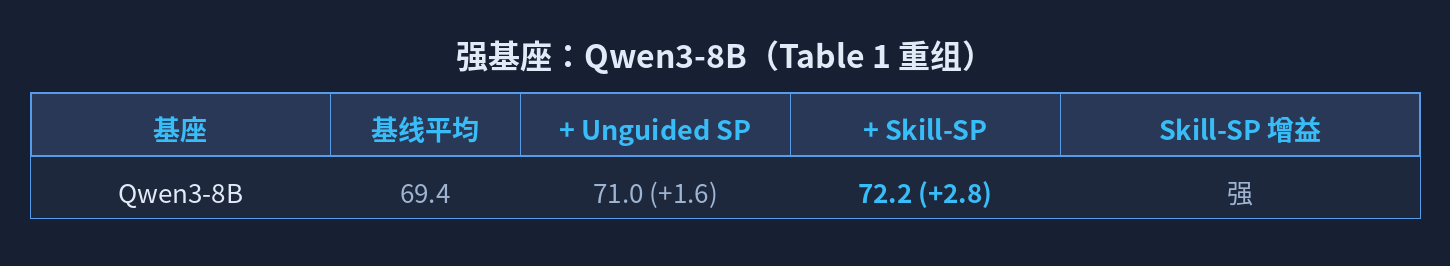
Paper 在两个域做评测:工具调用 (API-Bank + BFCL 四类) 和逻辑推理 (ZebraLogic 四档难度)。表 1 是核心数据,我把它按"基座模型规模"重新组织一下:
8B 以上的强基座 (Qwen3-8B)
8B 以下的弱基座 (Ministral-3-8B 这种本来就难训的)
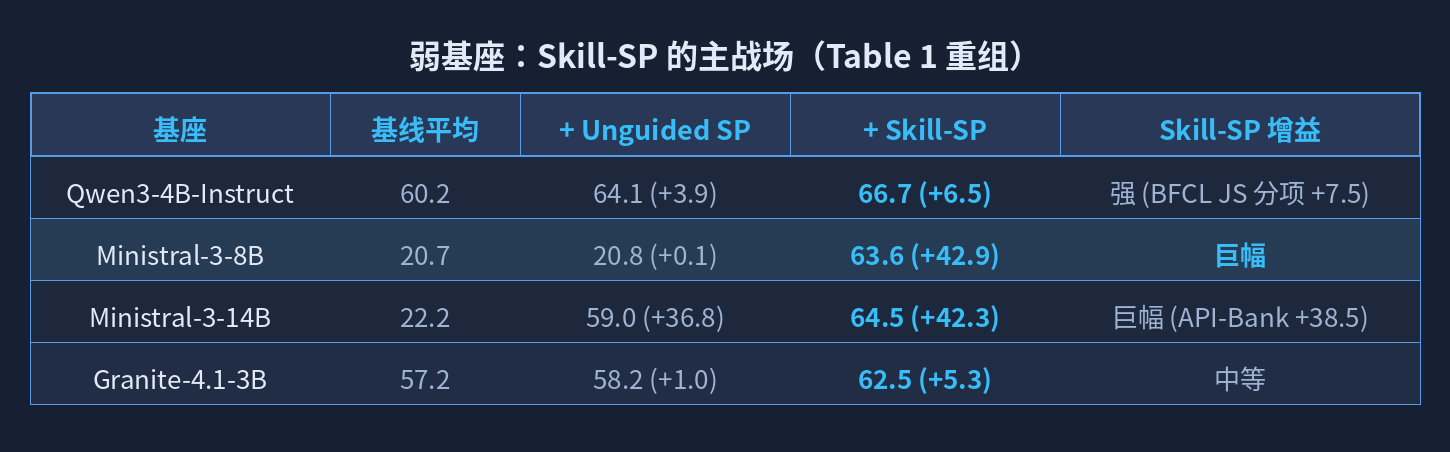
这个表最值得品读的是Ministral-3-8B这一行:基座只有 20.7 分 (基本是不太会调工具的水平),Unguided SP 完全没救 (+0.1),但 Skill-SP 直接拉到 63.6 (+42.9)。这是因为 Ministral 这种弱基座,本来连"出什么题"都不知道,Unguided SP 让它自由发挥 = 出垃圾题。Skill-SP 的 skill 库等于给它装了一个"我应该出什么样的工具调用题"先验,等于外挂了一层 curriculum。
对比 Qwen3-8B 这种已经很强的基座,Skill-SP 也能涨 (+2.8),但涨幅明显小。这印证了一个工业直觉:自博弈训练的边际收益跟基座成反比—— 越弱的基座越需要 curriculum 引导,越强的基座越能自给自足。Qwen 团队把 skill-SP 的真正卖点放在了"小模型快速可用"这条线上,不是偶然。
五、消融实验: 砍掉哪个零件会崩?
Paper 的消融做得比较克制,主要砍四个维度:
砍 1: 完全没有 skill 路由 (Unguided SP)
这是 baseline 对比,前面已经看到:小模型场景下基本不涨 (Ministral-3-8B +0.1),大模型场景下小涨 (+1.6)。结论:skill 路由是核心价值,完全去掉 = 退化成普通自博弈。
砍 2: 只用 Skill-only (100% skill stream, 砍 exploration)
Skill-only 训练在所有基座上都掉分,平均掉 4.1。直观解释:如果只围绕现有 skill 出题,任务分布会慢慢收窄到几个高频 skill,solver 在这些 skill 上练得很熟,但通用能力反而退步 (典型的过拟合到 training distribution)。
砍 3: 静态 skill 库 (frozen skills)
Frozen skill 库 (skill 不在训练中动态演化) 平均掉 2.3 分。说明 Skill Controller 的 update/archive/induce 三件套是真在干活,不是装饰。
砍 4: 均匀路由 (uniform routing, 不基于执行反馈动态路由)
Uniform routing 平均掉 1.9 分。说明动态路由 (Controller 根据 Solver 在不同 skill 上的实际表现来决定哪个 skill 该多训练) 比静态分配更有效。
四个消融综合起来一句话:Skill-SP 的每一层设计都是必要的,任何一层砍掉都会拖累效果,尤其对小模型。
六、几个我自己读完 paper 后觉得值得提醒的点
(下面是我基于 paper 内容做的判断,不全是 paper 自己说的)
1. 训练代价不低
Paper 没说具体 GPU hours,但 5 轮迭代 × 训练 5 个不同规模基座 + 双任务域,粗算至少要几千 GPU-hours。这不是个人开发者能直接复现的事。如果你想自己玩,建议先用 7B 级模型做 1-2 轮试跑,看 skill 库能不能稳定长出来。
2. Skill 库的初始种子至关重要
Paper 没详细说技能库的初始种子怎么来 (是 Qwen 团队手工标注了几百个?还是 Induce 链路几轮 bootstrap 出来的?),但 Qwen 这种团队大概率是有人工 seed。如果你想自己搞,最值得投入的不是 RL 算法,是 skill 库的初始 quality。这是工业项目里"数据飞轮"的常见模式:前期人工 seed 决定上限,后期自动演化负责持续改进。
3. 应用场景有边界
Paper 验证的两个域 (工具调用 + 逻辑推理) 都是有清晰机器可验证契约的场景。如果你关心的是开放式对话 / 创意写作这类没有 c 的场景,Skill-SP 不直接适用。但原理可以借鉴:把"任务质量" 拆成一个可机器检查的 proxy (比如长度、多样性评分、风格 embedding),门控 reward 套上去,本质一致。
4. 不算 RLHF, 但跟 RLHF 互补
Paper 用 GRPO 之类的 RL 算法训练 Proposer + Solver (具体哪种 paper 没明说,从代码引用看是 verl 框架那一脉)。它跟 RLHF 的"训练 reward model" 不同 —— Skill-SP 的奖励直接来自环境,没有人类偏好模型这一步。这让它在"奖励可验证"的场景里比 RLHF 更稳,但反过来,在"奖励需要人类判断"的场景里仍然得靠 RLHF。两个范式不是替代关系。
七、一句话总结
Skill Self-Play 的工程哲学是:承认 LLM 自由生成不可靠,但也别把它的发挥空间全砍掉 —— 把它框在一个可验证、可扩展、可演化的技能库里,让它在这个库里自由发挥。这套思路对做 LLM 训练的人来说是必读,对做 Agent 系统的人来说也是 —— 你不需要完整的 Skill-SP 框架,但"动态维护一个技能库"这个抽象,你自己的项目大概率能用得上。
论文原文 arXiv:2607.22529,代码和模型权重按 Qwen 团队惯例应该会开源到 HuggingFace,关注 Qwen 仓库 后续 release。
参考链接
- arXiv 论文: https://arxiv.org/abs/2607.22529
- Qwen 团队 HF 主页: https://huggingface.co/Qwen