八年前,美国进口货架上每五件商品就有一件来自中国;今天,每十二件里摊不到一件。同一段时间里,美国对中国商品的贸易加权平均关税到 2025 年 11 月是 47.5%。我读这篇论文之前,心里压着一个很土的疑问:墙垒到这个高度,货架上的中国货去哪儿了?
我原来的答案是「贸易战打了八年,全球贸易该走下坡了」。数据给的却是另一个画面:世界贸易占全球 GDP 的比重自国际金融危机之后就基本走平。论文的原话是——世界并没有在去全球化,它只是停止了进一步全球化。总量还在,变的是「谁把什么东西卖给了谁」。论文给这件事起的名字叫大重组,连标题都是借来的,借自石黑一雄的《长日将尽》:重头戏不在断裂,在重排。
先把结论放在最前面:货一滴都没少,只是绕开了堤坝,灌进了别人的市场。挪走的规模有多大?论文算了一笔账——2025 年中国出口 3.77 万亿美元,从美国市场挪走的部分,相当于智利、葡萄牙或者希腊一整年的经济总量。
三个口径必须先钉死,因为它们决定了全文每个数字该被信到什么程度。第一,这是一篇工作论文,2026 年 9 月挂出,未经同行评审,是学界内部传阅、专门等人挑错的稿子,不能当已发表文献引用。第二,三位作者分别来自哈佛大学与国际货币基金组织,论文扉页写明观点只代表作者本人、不代表国际货币基金组织,所以「IMF 的研究认为」这种说法一次都不能出现。第三,全文的读数是模型算出来的预测,不是实测值——这条后面会单独打折。
一、我读论文之前没想通的那件事
2018 年起美国对中国商品加征关税,此后八年,「贸易战」这三个字几乎成了新闻里的背景音。我脑子里的默认剧本是:关税一加,两边贸易都该萎缩,全球贸易总量该往下走。可世界贸易占 GDP 的比重在国际金融危机之后就横着走了,没有往下掉。总量不动,说明货还在流通;那货架上的变化就只能来自另一个方向——流向变了。
论文把这层意思拆成了两句话。第一句是判断:世界不是在去全球化,只是不再继续全球化。第二句是命名:这不是断裂,是重排,所以叫大重组。我猜(论文没这么说,这是我的联想)题目借《长日将尽》不是修辞趣味,是在提醒读者别去找「贸易战让全球化崩了」这种戏剧性结局——数据里没有那个结局,只有排行榜在换人。
判断有了,尺子还没有。要量「谁被砸到、砸得有多疼」,得先知道这道墙垒了多高。
二、一篇专门等人挑错的论文
在报任何数字之前,得先说清楚这篇论文的身份,因为身份决定了数字的分量。
这是一篇 NBER 工作论文,2026 年 9 月发布,未经同行评审;预稿是 2026 年 2 月的一篇会议论文。作者 Pol Antràs、Adrian Kulesza、Andrea F. Presbitero 分别任职于哈佛大学与国际货币基金组织,论文声明这些观点不应归于国际货币基金组织、其执行董事会或管理层。工作论文这个身份的意思是:它是学界内部传阅、专门等人挑错的半成品,不是定论。
数据主体是2023 年的产品级双边贸易数据,来源是 CEPII-BACI 公开库,覆盖 224 个国家、5,380 个六位海关编码产品;其中 4,254 个产品可以算出产品级冲击。样本再剔除人口不足 20 万的经济体、香港与澳门,以及指数覆盖贸易流不足 25% 的国家,最后剩110 个国家。基期选 2023 年,论文给的理由很具体:避开 2024 年美国大选前贸易商提前行动带来的预期污染。
月度验证用的是另一套数据——商业订阅库 Trade Data Monitor,前期取 2023 年 4 月到 2024 年 3 月,后期取 2025 年 4 月到 2026 年 3 月。这里得如实说:订阅库不是公开数据,所以这篇论文不能承诺「全部数据可复现」;能查的是公开的那部分,以及作者另行开放的查询平台。
顺带一句,选基期这个细节,比任何一句「我们控制了预期效应」都更能让人看见作者的顾虑在哪。分寸拿捏好了,再看它量的第一件事。
三、这道墙垒了多高
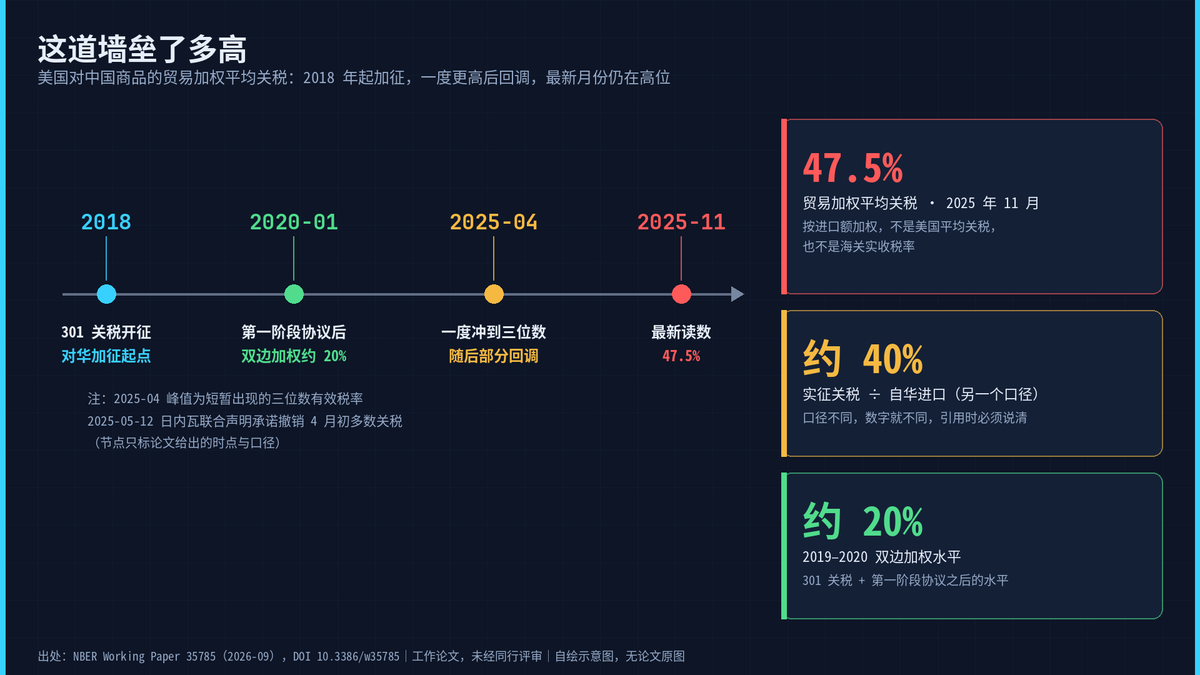
先记住一个数:47.5%。口径是贸易加权平均关税——按进口额加权算出来的平均税率,时间点是 2025 年 11 月,来源引自 Bown 的关税统计。它不是「美国平均关税」,也不是海关实收税率,这三个数不能互换。
时间线是这样的:2018 年开始加征;到 2019–2020 年,301 关税加上 2020 年 1 月的第一阶段协议之后,双边贸易加权平均关税大约都在 20%;2025 年 4 月的「解放日」行政令把有效税率推得极高,一度出现三位数的短暂峰值,随后部分回调——2025 年 5 月 12 日日内瓦联合声明承诺撤销 4 月初的多数关税;到最新月份,这个数仍然是 47.5%。另有一个口径更松的数字:实征关税与自华进口之比约 40%,论文脚注引的是另一个追踪项目。
两个数差了七个百分点。这给我的提醒是:以后凡是看到「关税多少」,先问一句是哪个口径——法定的、加权的、实收的,是三把不同的尺子。墙立起来之后,货架发生了什么?论文用两根柱子回答,而这两根柱子经常被混着读。
四、两个份额,两把尺子
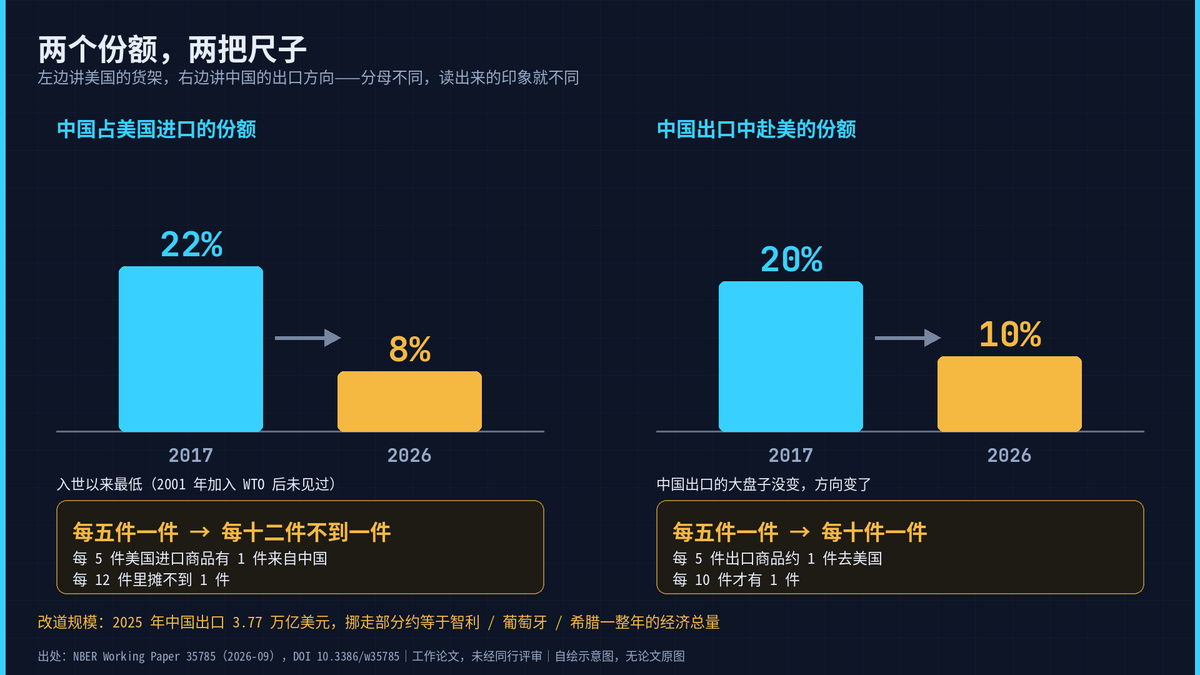
左边一根:中国占美国进口的份额,从 2017 年的 22% 跌到 2026 年的约 8%——这是中国 2001 年加入世贸组织以来没有出现过的水平。换成自然频率就是:八年前每五件美国进口商品有一件来自中国,现在每十二件里摊不到一件。
右边一根:中国出口中运往美国的份额,同期从约 20% 跌到约 10%。也就是八年前中国每出口五件商品大约一件去美国,现在十件里才有一件。
两句话的分母不同,读出来的印象也不同。第一句讲的是美国的货架,第二句讲的是中国的出口方向。只讲第一句,容易得出「中国出口塌了」的印象;只讲第二句,又容易得出「美国货架空了」的印象。两个一起看,才知道总量没变、方向变了——而方向变化的规模,就是开头那笔账:挪走的部分相当于智利、葡萄牙或希腊一年的 GDP。
总量没变、方向变了,这只是描述。论文真正的功夫在下一步:拿什么尺子去量「谁被冲击、冲击多大」。
五、旧尺子量不了不对称的冲击
传统做法叫贸易篮子相似度,大白话是:把两个国家卖的东西摆在一起,看有多像,越像就越算竞争对手。这把尺子有个天生的毛病——它是对称的。论文引了一个极端的例子:按它的算法,中国受洪都拉斯竞争影响的程度,等于洪都拉斯受中国竞争影响的程度。一边是大象,一边是蚂蚁,尺子说它们一样重。
作者把尺子换掉之后,榜单整个换了一轮,而且相关系数低得出乎我意料:
- 出口相似度与出口竞争指数的跨国相关只有0.493;
- 进口相似度与进口竞争指数的相关是负的,约**−0.039**,接近零;
- 两张进口榜的前二十名里,只有捷克、日本、波兰三个经济体同时出现。
量「像不像」的榜,前五名是加拿大、英国、法国、德国、日本;换成量「疼多少」的榜,前五名变成越南、柬埔寨、巴基斯坦、马达加斯加、日本。
我的读法是:这是本期最值得带走的方法论——同一份数据,尺子换一把,结论就换一个方向。看到任何国际排名,先问它量的是相似还是发生。至于新尺子具体在量什么,值得一块一块看。
六、四块水表:同一股水的四个读数
论文的做法是给这股改道的水装四块表,它管这四个角度叫四个边际,读数叫暴露指数。四个指数各量一件事:
- 出口竞争:改道的中国货涌进第三方市场,把你的出口挤掉了多少,读数是预测的出口降幅,越大越疼;
- 进口竞争:改道的中国货涌进你自己的市场,把本国厂商的销售挤掉了多少,读数是预测的国内销售降幅;
- 消费收益:更便宜的中国货让你的进口品价格降了多少,读数是预测的进口价格降幅——它不是居民消费价格指数,也不是老百姓的整体物价;
- 采购收益:更便宜的中国中间品让你的下游产业成本降了多少,读数是预测的出口增幅。
三个口径要跟着四块表一起带走。第一,这四个读数是模型预测值,不是观测值,覆盖 110 个国家、2023 年基期。第二,它们互不冲突,同一个国家完全可以在四张榜上有四个不同的名次。第三,前两块表量的是「被挤」,后两块表量的是「捡到的便宜」,一块表一个角度。
还有个细节值得停一下:采购收益与上游进口竞争的相关只有 0.233,与上游消费收益的相关却有 0.586。这说明这块表更接近「投入品变便宜了」,而不是「进口竞争缓和了」——它量的是成本链条,不是竞争格局。
四块表各就各位。真有国家被同一股水又淹又灌溉吗——有,而且是最常被引用的那个。
七、越南:同一股水,又淹又灌溉
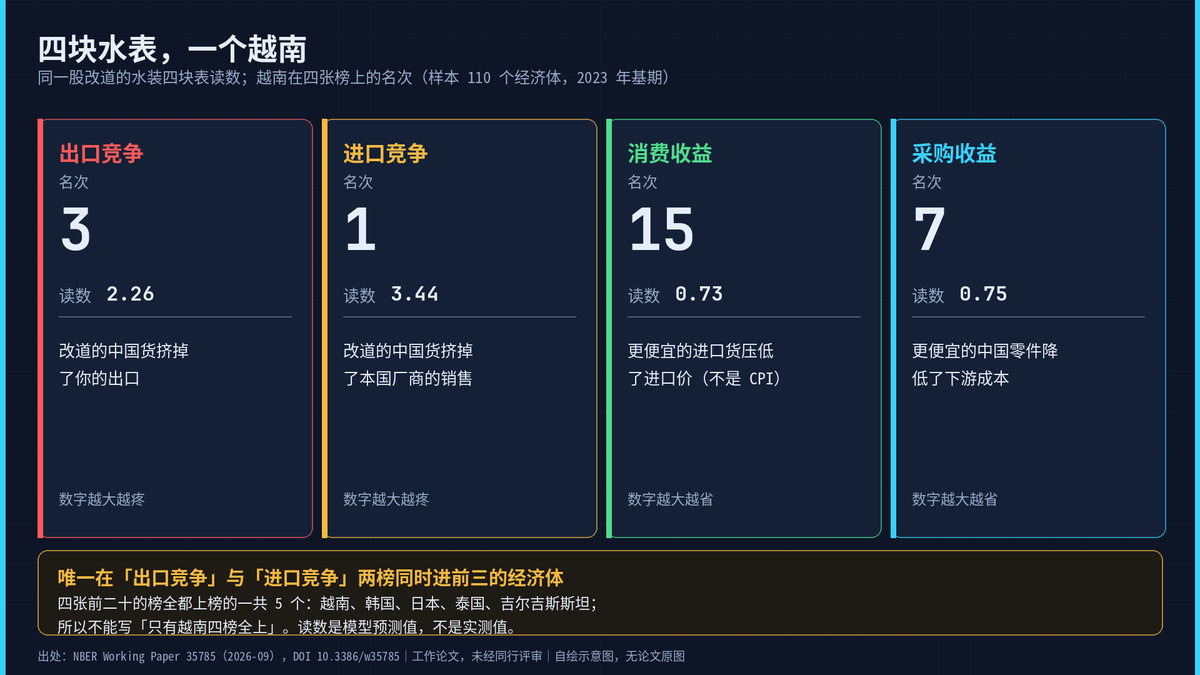
四张前二十的榜,越南全部上榜——不过这里必须钉一句口径:四榜全进前二十的经济体一共 5 个,是越南、韩国、日本、泰国、吉尔吉斯斯坦,所以「只有越南四榜全上」是错的。越南的独特之处在两本「被挤」的榜:出口竞争排第 3(读数 2.26),进口竞争排第 1(读数 3.44),是唯一在这两榜同时进入前三的经济体。
另外两块「好处」的榜上也有它:消费收益第 15(0.73),采购收益第 7(0.75)。
论文里有一句话说的就是这种处境:两个巨人打架,小国不是趴在墙上、与己无关的苍蝇。水在外面撞它,冲进家门还接着撞;同一股水,对同一个国家可以既是压力也是红利。
所以「暴露」从来不是单数。把一个国家简化成「受益方」或者「受害方」,在四块表面前都站不住。越南这个样本还有一层提醒——它的读数同时来自出口市场和国内市场两个方向,任何只看单向贸易流的叙述都会漏掉一半。这些读数在一个国家内部也不是平摊的,拆到产品级,画面集中得出乎意料。
八、一个国家的读数,常常压在几样商品上
- 匈牙利出口竞争读数的48.07%来自锂电池;
- 越南出口竞争读数的32.19%来自手机;
- 亚美尼亚的 25.87% 来自彩电,吉尔吉斯斯坦的 26.64% 来自散热器及零件;
- 对美依赖度最高的产品里,冻军曹鱼在 2023 年的对美依赖度是1.000,也就是那一年的产出全部卖给了美国,鲜冷凤尾鱼是 0.974。
采购收益那一侧更极端:哈萨克斯坦读数的 92.57%、阿塞拜疆的 96.48% 来自原油;乌干达的 73.99% 来自半制成黄金,埃塞俄比亚的 59.59% 来自咖啡。消费收益则分散得多——前五大产品平均只占其读数的 26.1%,而进口竞争的前五大产品占 37.6%。
一条鱼比一个国家更能说明问题。对美依赖度是 1.000 的产品,堤坝一立就没有缓冲市场——要么降价去找新买家,要么从货架上消失。至于哈萨克斯坦和阿塞拜疆那九成以上的原油,我倾向于这样理解:便宜的中国投入品顺着投入产出链条往下走,最后折成它们出口石油的成本优势——这条因果链比「某国受益」四个字长得多,而且这个理解是我的,论文没有给出这条链的完整推导。
到这里,指数的结构讲完了。剩下也是最要紧的一层:这些读数跟真实发生的数据对不对得上。
九、验证:对上的一半,与对不上的一半
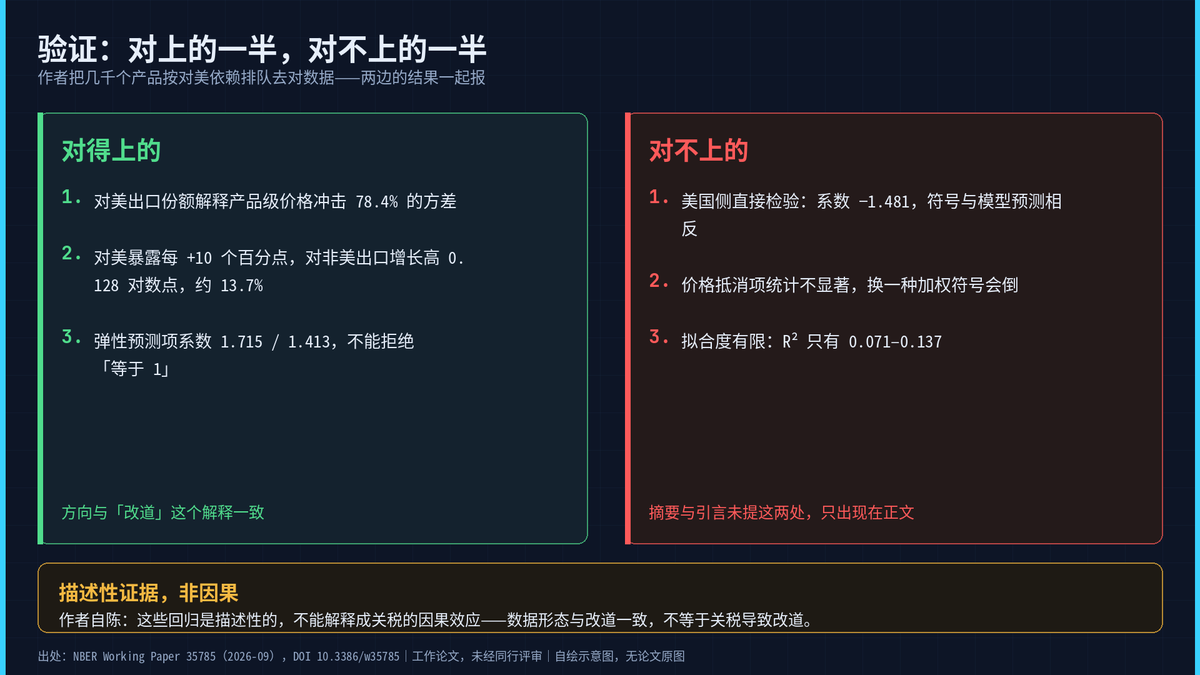
作者的办法是把几千个产品按对美依赖度排个队,再去看它们之后的去向。对得上的部分有三层:
- 产品级价格冲击的方差分解里,对美出口份额这一个因素就解释了 78.4%,弹性项解释 18.9%,关税变化只占 2.6%;
- 对非美目的地的出口增长回归中,产品对美依赖度的系数显著为正,对美暴露每提高 10 个百分点,对非美市场的出口增长高出 0.128 个对数点,约合 13.7%;
- 模型按弹性推出来的那个预测项,回归系数是 1.715 和 1.413,且不能拒绝它等于模型预测值 1这一假设。
对不上的部分,作者也没藏:
- 换到美国这一侧做同样的直接检验,产品对美依赖度的系数是 −1.481 一类的负数,与模型预测的正号相反,论文自己写:直接对数变化检验未能复原模型预测的符号;
- 水平值口径的结构分解里,那个「中国出口商自己降价、吃掉一部分关税冲击」的价格抵消项统计上不显著,换一种加权方式符号甚至会倒过来;
- 这两处失败在摘要与引言里完全缺席,只出现在正文。
还有一层是拟合度:那组对非美出口增长的回归,R² 只有 0.071 到 0.137。机制方向对得上、解释力有限,这是两件必须一起说的事——只说前半句是捧场,只说后半句是砸场,都不诚实。至于因果,作者自己划了线:这些回归是描述性的,他们拒绝把它解释成关税的因果效应。所以准确的说法只能是「数据的形态与改道这个解释一致」,不能说「论文证明了关税导致改道」。
机制方向对得上、解释力有限、两处检验失败不进摘要——把这些叠在一起,引用这套读数之前该打几个折扣,就有了一张清单。
十、读数要打的五个折扣
第一个折扣:读数是模型预测值。论文脚注写明,这些指数应被理解为在数据可得的产品与国家范围内预测的变化,不是实测出来的变化。
第二个折扣:引言里的幅度是头部极值。出口降 0.4–0.9%、最暴露经济体国内销售降超 3%、部分国家消费与采购收益超 1%,说的是全球最大二十个经济体里的少数国家、以及最暴露的那些案例,不是 110 国的普遍水平。
第三个折扣:描述性而非因果。关税政策本身是内生的,作者明确拒绝把回归读成因果估计。
第四个折扣:改道不等于福利改善,也不等于福利恶化。四块表量的都是毛账——出口被挤多少、销售被挤多少、进口价降多少;就业有没有受影响、不同的人谁赚谁亏,论文没有算,净账留白。而且消费收益是进口价格,从进口价到居民钱包还要过进口商、批发商、零售商好几道手。
第五个折扣来自论文自陈的知识不足,三条一起列:国内销售没有产品级数据,进口竞争的部门权重是用出口结构代理的,作者自己写这个结果要打个折扣;采购收益用的投入产出连接是机器生成的二元连接、对每种投入均匀赋权,而且只算一轮直接成本效应、不做产业链连锁传播;替代弹性的估计来自 1993–2007 年的数据,用到 2023 年基期上,论文也承认偏好与技术当然可能已经变了。
这五个折扣不是给论文挑刺,是给引用它的人设的门槛。看到「某国捡了大便宜」或者「某国被挤惨了」的标题,先问它打的是哪几个折扣——这么一问,这套东西立刻就有了用武之地。
十一、带着四块水表看新闻
一个可以直接用的场景:欧盟委员会在 2025 年专门上线了进口监测工具,盯的就是被关税挡在门外、改道涌进欧洲的商品。这说明「改道」不是修辞,是各国海关正在处理的现实。
另一个提醒更实用:别拿一个国家的税率高低去猜它对美出口的涨跌。论文试过这条关系,发现它并不稳健——稳健标准误下 t 值从 −3.91 掉到 −0.87,而且把中国的数据拿掉之后这个关系基本就散了。同期还有反例:台湾与越南在 32%、46% 的「解放日」宣布税率下,对美出口依然强劲增长。
所以以后再看到「某国对美出口大涨、从中国进口也大涨」这类标题,可以掏那四块表问四个问题:它的出口被挤了多少?它的国内市场被挤了多少?它买到的货便宜了多少?它的下游成本降了多少?四个问题问完,一个「涨」字就吓不住人了。
十二、下次看到「某国捡了便宜」,先掏那四块水表
这篇论文给的不是预言,是一副眼镜。它不告诉你关税明天会怎样,也不替任何一边算账——它甚至坦白告诉你,验证对上了一半、对不上另一半,解释力有限,读数是预测。它的价值恰恰在这份坦白里:下次再有人拿一个「涨」字或者「跌」字让你站队,你手里有四个问题可以问回去。
想自己查数字,论文把四个指数的国家值、排名与产品级分解开放在作者的查询页面(pantras-hash.github.io/remains_of_the_trade),输入你关心的国家就能看到它在四块表上的读数;想核对原文,DOI 是 10.3386/w35785。转述这篇论文时记得带上它的限定词——工作论文、未经同行评审、模型预测值,以及论文观点不代表国际货币基金组织。
出处:NBER Working Paper 35785(2026-09),DOI 10.3386/w35785|工作论文,未经同行评审|fig01–fig04 全部自绘,无论文原图|论文声明作者观点不代表国际货币基金组织。