Commençons par examiner trois exemples réels de situations qui ont mal tourné.
Lorsque l’on demande au modèle de filmer une performance de musique traditionnelle chinoise, les instruments et les caractères chinois affichés sur l’écran ne correspondent pas à la musique traditionnelle chinoise réelle. Lorsqu’on lui demande de filmer un mariage nigérian, les vêtements des invités et les accessoires de la cérémonie sont tous des « modèles génériques », sans aucune trace de culture nigériane. Lorsqu’on lui demande de filmer un jeu de Shogi japonais, l’échiquier et les pièces se transforment directement en pièces d’échecs occidentales.
Les images elles-mêmes ne sont pas mauvaises, l’éclairage, les mouvements et la netteté sont tous excellents - et c’est précisément le problème. Les vidéos de Wensheng sont tellement réalistes qu’il est difficile de les distinguer des vraies. Plus les images sont réalistes, plus les erreurs culturelles sont dissimulées et plus elles sont frappantes. Une vidéo destinée au marché étranger avec des erreurs de costumes et de rites sera immédiatement détectée par les locaux, et sera considérée au mieux comme une blague, et au pire comme une insulte.
L’article « CultureVidBench : Évaluation de la compréhension culturelle dans la génération de texte en vidéo », publié sur arXiv sous la référence 2608.01942, constitue un véritable examen complet de cette question : 12 pays, 1 000 questions et 7 modèles en compétition, tous axés sur la compréhension culturelle dans la génération de texte en vidéo. L’auteur principal, Xianjing Han, est de l’Université technologique de Nanyang, et l’auteur correspondant, Bin Zhu, est de l’Université de gestion de Singapour. Les partenaires de cette recherche comprennent également Centrale Supélec et l’Université de Cambridge. J’ai lu l’article en entier et sa valeur ne réside pas dans un score particulier, mais dans le fait qu’il transforme pour la première fois la question « Les IA comprennent-elles la culture ? » en un problème d’ingénierie quantifiable.
Pourquoi les évaluations précédentes ne prenaient-elles pas en compte la culture ?
Il y a déjà de nombreuses critiques de vidéos de Wensheng, et des benchmarks tels que VBench et EvalCrafter sont toujours utilisés. Cependant, ils se concentrent sur la qualité des images, la fluidité des mouvements, la plausibilité physique et la pertinence du contenu. Il y a aussi des benchmarks qui testent les connaissances en physique et la crédibilité des robots, chacun ayant sa propre spécialité.
Dans la dimension culturelle, peu de personnes ont effectué des tests systématiques du côté de la vidéo. En revanche, certains l’ont fait pour les images textuelles. ViSAGe et CUBE-1K ont tous deux testé le concept culturel – mais les images sont statiques, il est impossible de voir si les mouvements sont corrects ou si les sons sont appropriés. La culture dans la vidéo est vivante : les rituels ont des procédures, les scènes ont de la musique et les panneaux ont des mots. Cette lacune est ce que CultureVidBench doit combler.
La première étape pour combler les lacunes est de préparer les questions d’examen, et la qualité de ces questions détermine directement la crédibilité de toutes les conclusions ultérieures. Le travail effectué pour préparer les questions de cet examen mérite d’être mentionné séparément.
Comment est élaboré un questionnaire couvrant 12 pays ?
Choisissez d’abord un pays.L’auteur s’est inspiré de la carte culturelle de l’Enquête mondiale sur les valeurs (World Values Survey), un outil de classification culturelle couramment utilisé dans le milieu universitaire, pour diviser le monde en huit cercles culturels, tels que le cercle confucéen, le cercle des pays anglophones et le cercle islamique africain. Pour chaque cercle, l’auteur a sélectionné des représentants, réunissant ainsi douze pays répartis sur six continents. Notez la composition délibérée de cette liste : elle comprend à la fois des pays très médiatisés tels que les États-Unis, la Chine et l’Inde, et des pays à faible revenu tels que l’Éthiopie, le Nigeria et la Malaisie. Comme nous le verrons plus loin, cette composition permet de tirer l’une des conclusions les plus importantes de l’ensemble du texte.
Exercice de reconstruction.L’auteur divise la culture en trois grandes catégories : la culture matérielle (nourriture, vêtements, architecture, décoration, objets visibles et tangibles), les pratiques et performances sociales (salutations, repas, danse, sports, activités religieuses, actions humaines) et les rituels et cérémonies (mariages, funérailles, processus complets). Ces trois catégories sont subdivisées en 14 aspects, et 828 éléments culturels sont recueillis dans diverses sources culturelles internationales, pour finalement aboutir à 1 000 mots-clés : 270 pour la culture matérielle, 386 pour les pratiques sociales et 344 pour les rituels et cérémonies, avec une moyenne de 12,8 mots par mot-clé.
La qualité des sujets est contrôlée manuellement.Chaque mot-clé est généré en utilisant un modèle : la culture matérielle est « qui + fait quoi + porte quels éléments culturels + dans quel pays », par exemple « Une femme sert du feijoada dans un restaurant brésilien » ; les rituels, étant un ensemble de procédures, sont décomposés en sous-activités, comme le mariage chinois qui comprend trois étapes : s’agenouiller devant les parents, offrir du thé et recevoir des enveloppes rouges. Les sujets proposés doivent également être vérifiés par deux annotateurs humains pour vérifier si la description est naturelle, si la culture est correcte et si l’image peut être prise.
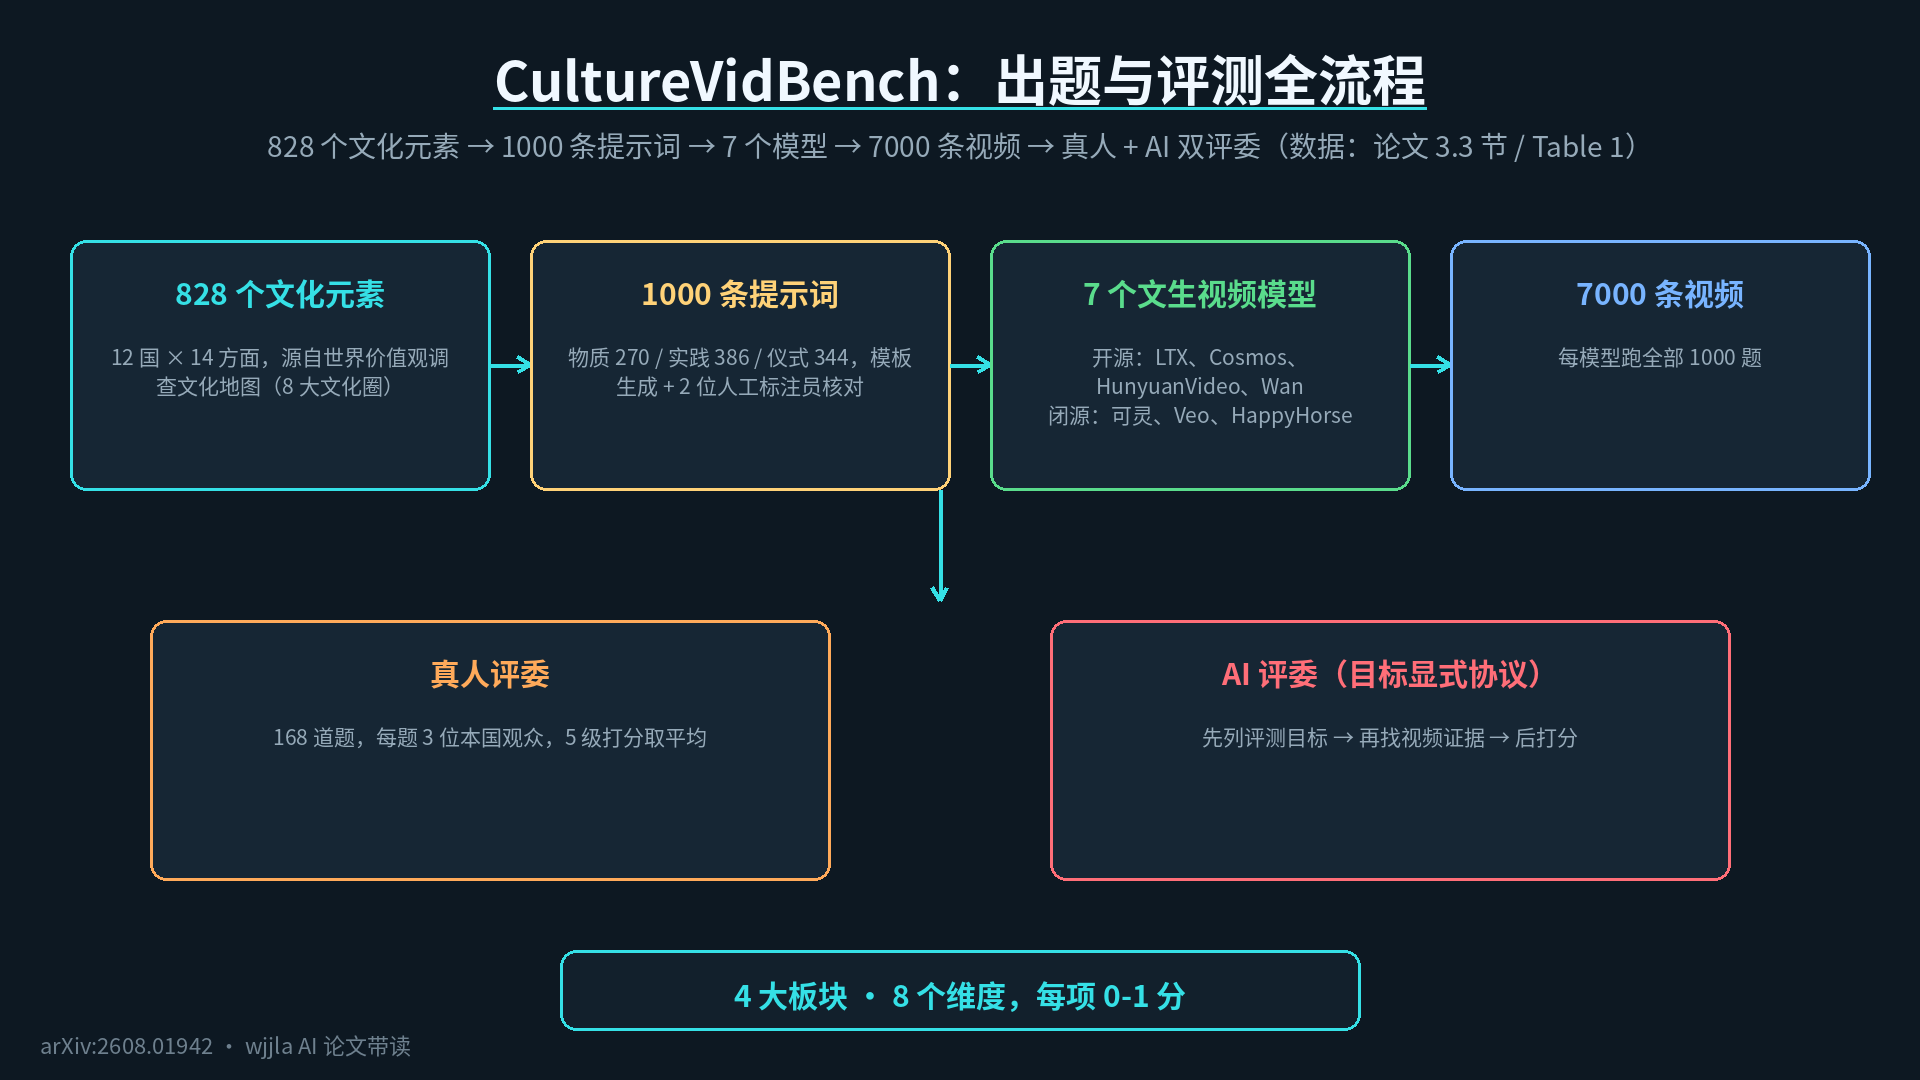
L’ensemble du processus est illustré ci-dessous : 828 éléments culturels → 1 000 mots-clés → 7 modèles exécutés chacun une fois pour générer 7 000 vidéos → deux ensembles de juges, humains et IA, attribuent des notes. Les candidats sont 4 modèles open source (LTX-2.3-22B, Cosmos-Predict-2.5-14B, HunyuanVideo-1.5, Wan-2.2-14B) et 3 modèles propriétaires (Kling-3.0, Veo-3.1-Fast, HappyHorse-1.0 d’Alibaba).
Comment noter : Deux grandes questions décomposées en huit petites rubriques.
Le système de notation est conçu de manière très claire, chaque vidéo répondant à deux grandes questions :
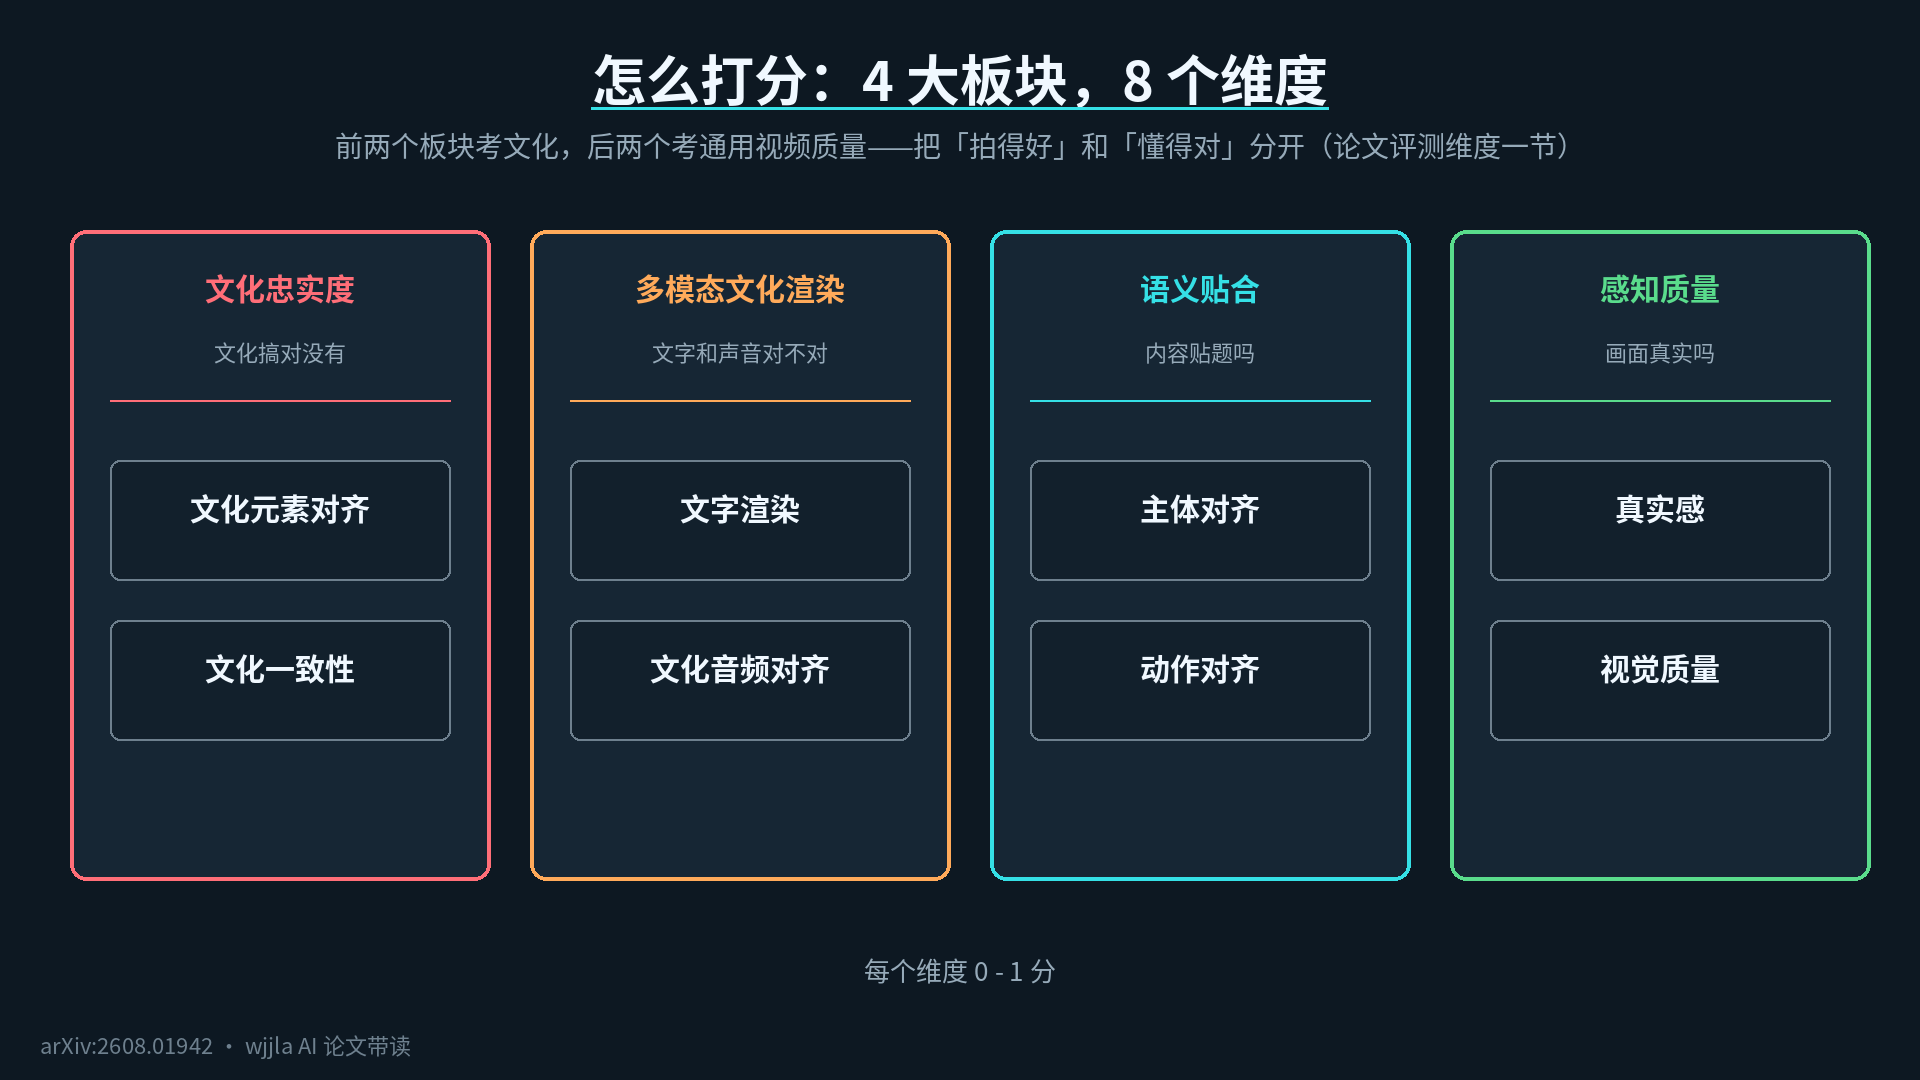
- La culture est-elle correctement représentée ?(Fidélité culturelle) : Les éléments culturels appropriés sont-ils présents (alignement des éléments culturels) ? Y a-t-il des éléments provenant d’autres pays (cohérence culturelle) ?
- La vidéo est-elle de bonne qualité ?(Adéquation sémantique + Qualité perçue) : Le sujet et les actions sont-ils en rapport avec le thème ? Les images sont-elles réalistes ?
Chaque élément est noté de 0 à 1. Un volet distinct est également consacré à la représentation multimodale de la culture : les mots dans les images, les sons en arrière-plan – les panneaux en caractères chinois dans les scènes japonaises, la musique traditionnelle lors des mariages – sont tous répertoriés dans cette catégorie. Le fait que les mots et les sons soient évalués séparément constitue une particularité de ce test, et cela pourrait poser de gros problèmes par la suite.
Il y a deux types de juges : les juges humains ont sélectionné 168 questions (14 aspects × 12 pays), chaque question étant notée sur 5 par trois téléspectateurs du pays concerné, puis la note moyenne est calculée – c’est coûteux, mais c’est la référence. Les juges IA utilisent un protocole cible explicite conçu par les auteurs, ce qui signifie qu’on ne laisse pas l’IA noter en se basant sur son intuition : la première étape consiste à lui indiquer ce que la question évalue, la deuxième étape consiste à lui demander de trouver uniquement les preuves pertinentes dans la vidéo, et la troisième étape consiste à noter en se basant sur ces preuves. Un tableau spécial est utilisé pour vérifier si ce protocole est valable.
Bulletin scolaire : il y a un fossé entre l’open source et le closed source.
Le tableau 1 de la page 6 est le tableau le plus important de tout le document. Commençons par examiner les notes attribuées par les personnes réelles dans la colonne « alignement des éléments culturels » :
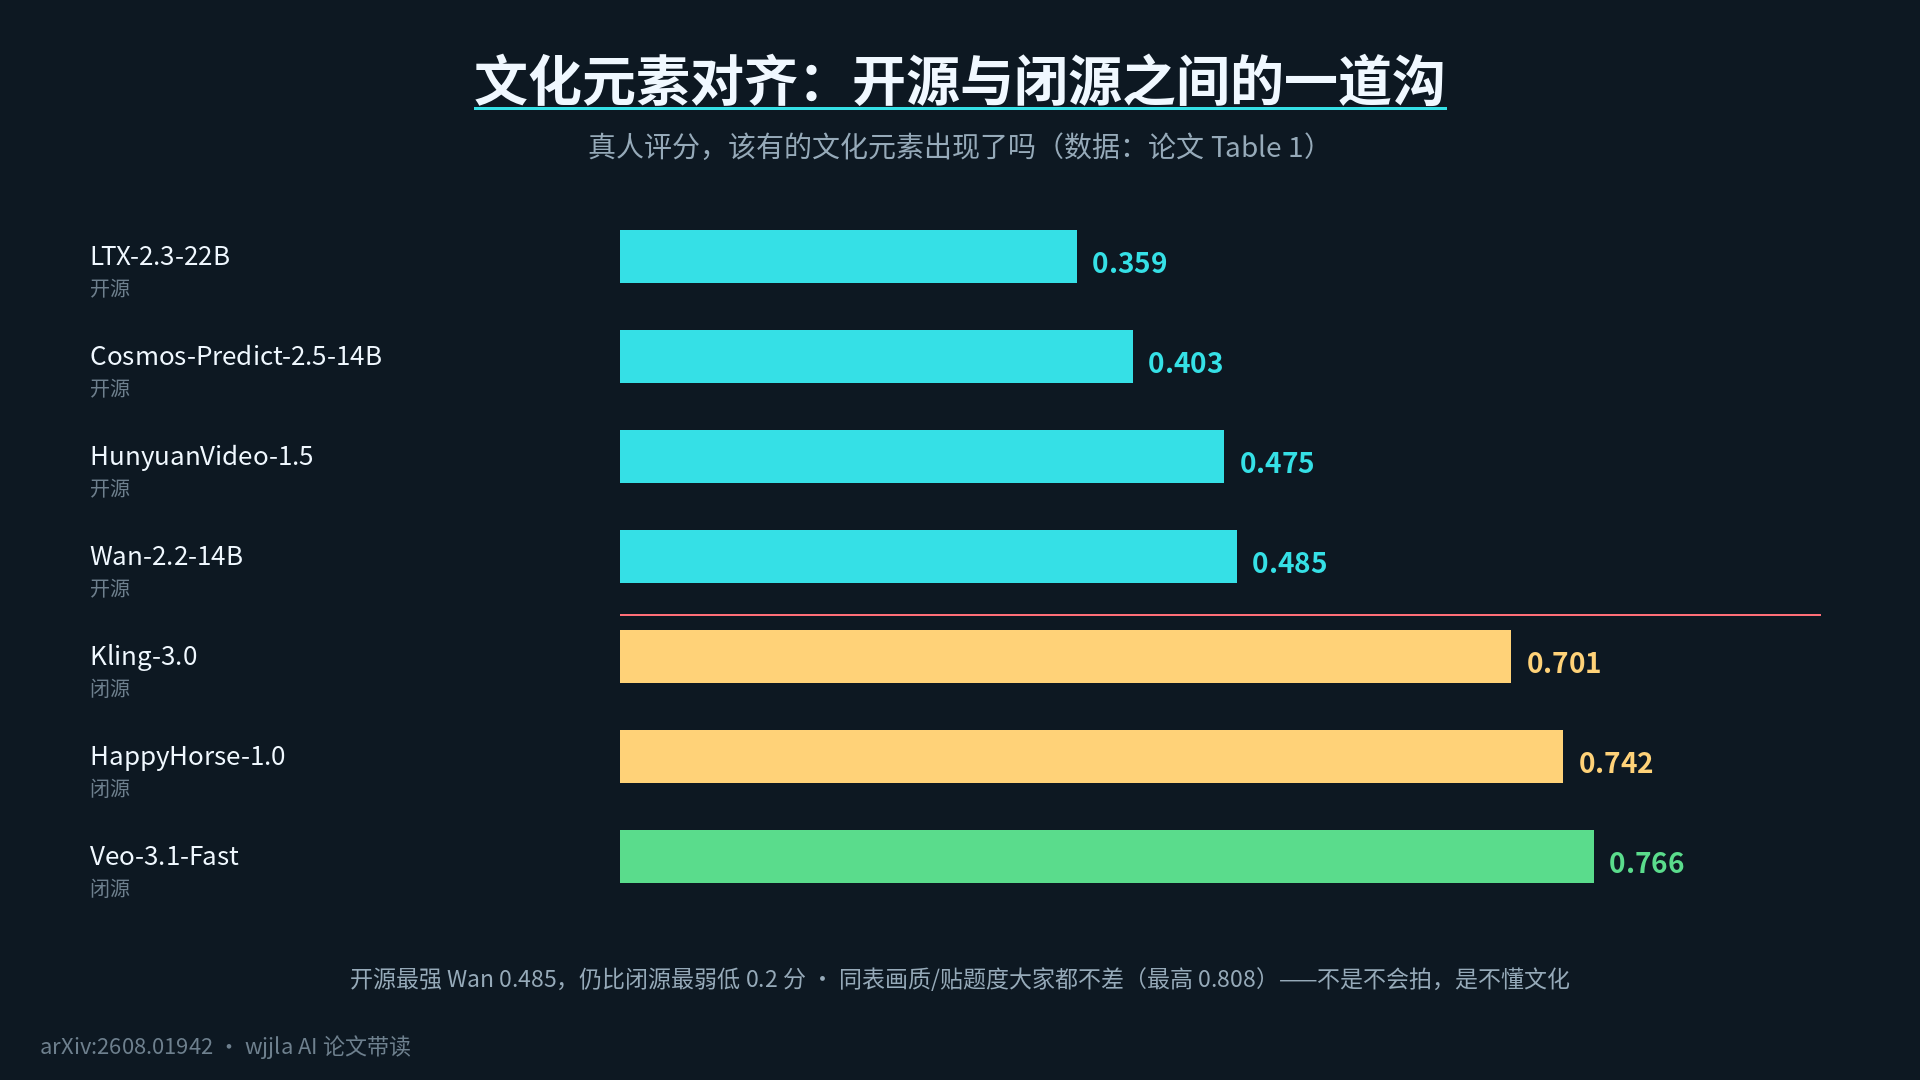
Les quatre modèles open source ont tous obtenu des scores compris entre 0,359 et 0,485, tandis que les trois modèles propriétaires ont directement atteint des scores allant de 0,701 à 0,766. Le meilleur score est celui de Veo-3.1-Fast avec 0,766, HappyHorse-1.0 avec 0,742 et Kling-3.0 avec 0,701 ; le meilleur score open source, Wan-2.2-14B, n’atteint que 0,485, soit 0,2 point de moins que le pire score propriétaire. Un écart visible à l’œil nu.
Mais le même tableau contient une autre information clé : les capacités générales telles que la qualité de l’image et la pertinence du sujet sont toutes de bonne qualité, avec un score global supérieur à 0,49, atteignant un maximum de 0,808. En considérant ces deux éléments ensemble, la conclusion est sans équivoque :le modèle n’est pas incapable de produire des vidéos, il ne comprend tout simplement pas la culture.La mauvaise compréhension de la culture et la mauvaise capacité de génération sont deux choses différentes, et c’est précisément la raison pour laquelle ce test les évalue séparément.
La partie la plus décevante de l’ensemble : le rendu des textes.
Il y a une autre colonne dans le tableau 1 qui est encore plus difficile à aligner que la culture : le rendu du texte dans les images.
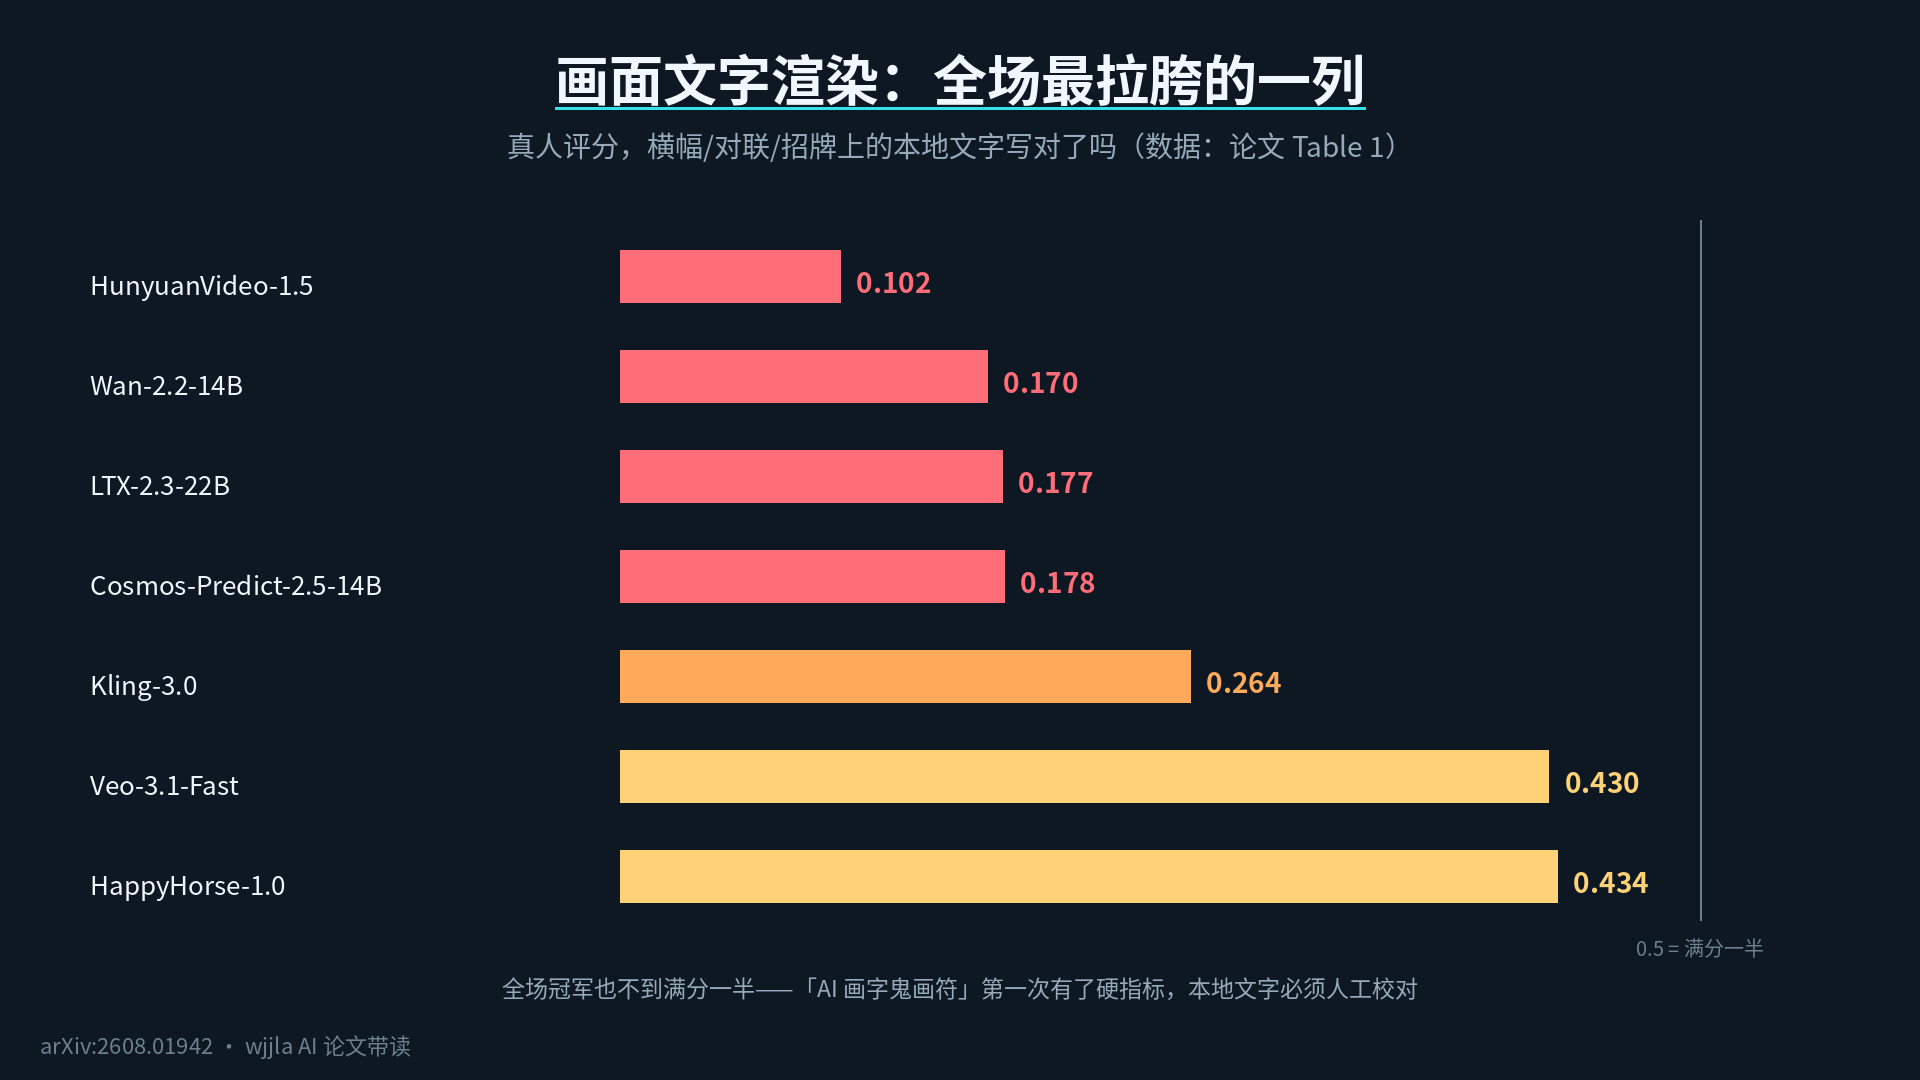
Le meilleur résultat du groupe open source est de 0,178 pour Cosmos-Predict-2.5-14B, et le plus faible est de 0,102 pour HunyuanVideo-1.5 ; le groupe propriétaire est meilleur, avec un score maximum de 0,434 pour HappyHorse-1.0, ce qui signifie que le champion du concours n’a même pas atteint la moitié du score maximum. Les IA ne parviennent pas à écrire correctement les caractères locaux sur les bannières, les paires de vers et les enseignes. La rumeur en ligne selon laquelle « l’IA écrit des caractères incompréhensibles » a maintenant des preuves concrètes. Conclusion pratique : si la vidéo contient des caractères locaux, il est indispensable de la relire manuellement avant de la publier, car aucun modèle ne peut actuellement le faire pour vous.
Les juges d’IA sont-ils fiables : le pari de Table 2.
Le recours à l’IA comme juge vise à rendre l’évaluation à grande échelle possible (les évaluations humaines de 168 questions représentent déjà un investissement important), mais peut-on faire confiance aux scores attribués par l’IA ? Le tableau 2 répond à cette question en utilisant les coefficients Kendall τ et Spearman ρ moyens par pays : plus le chiffre est proche de 1, plus les classements de l’IA et des humains sont cohérents.
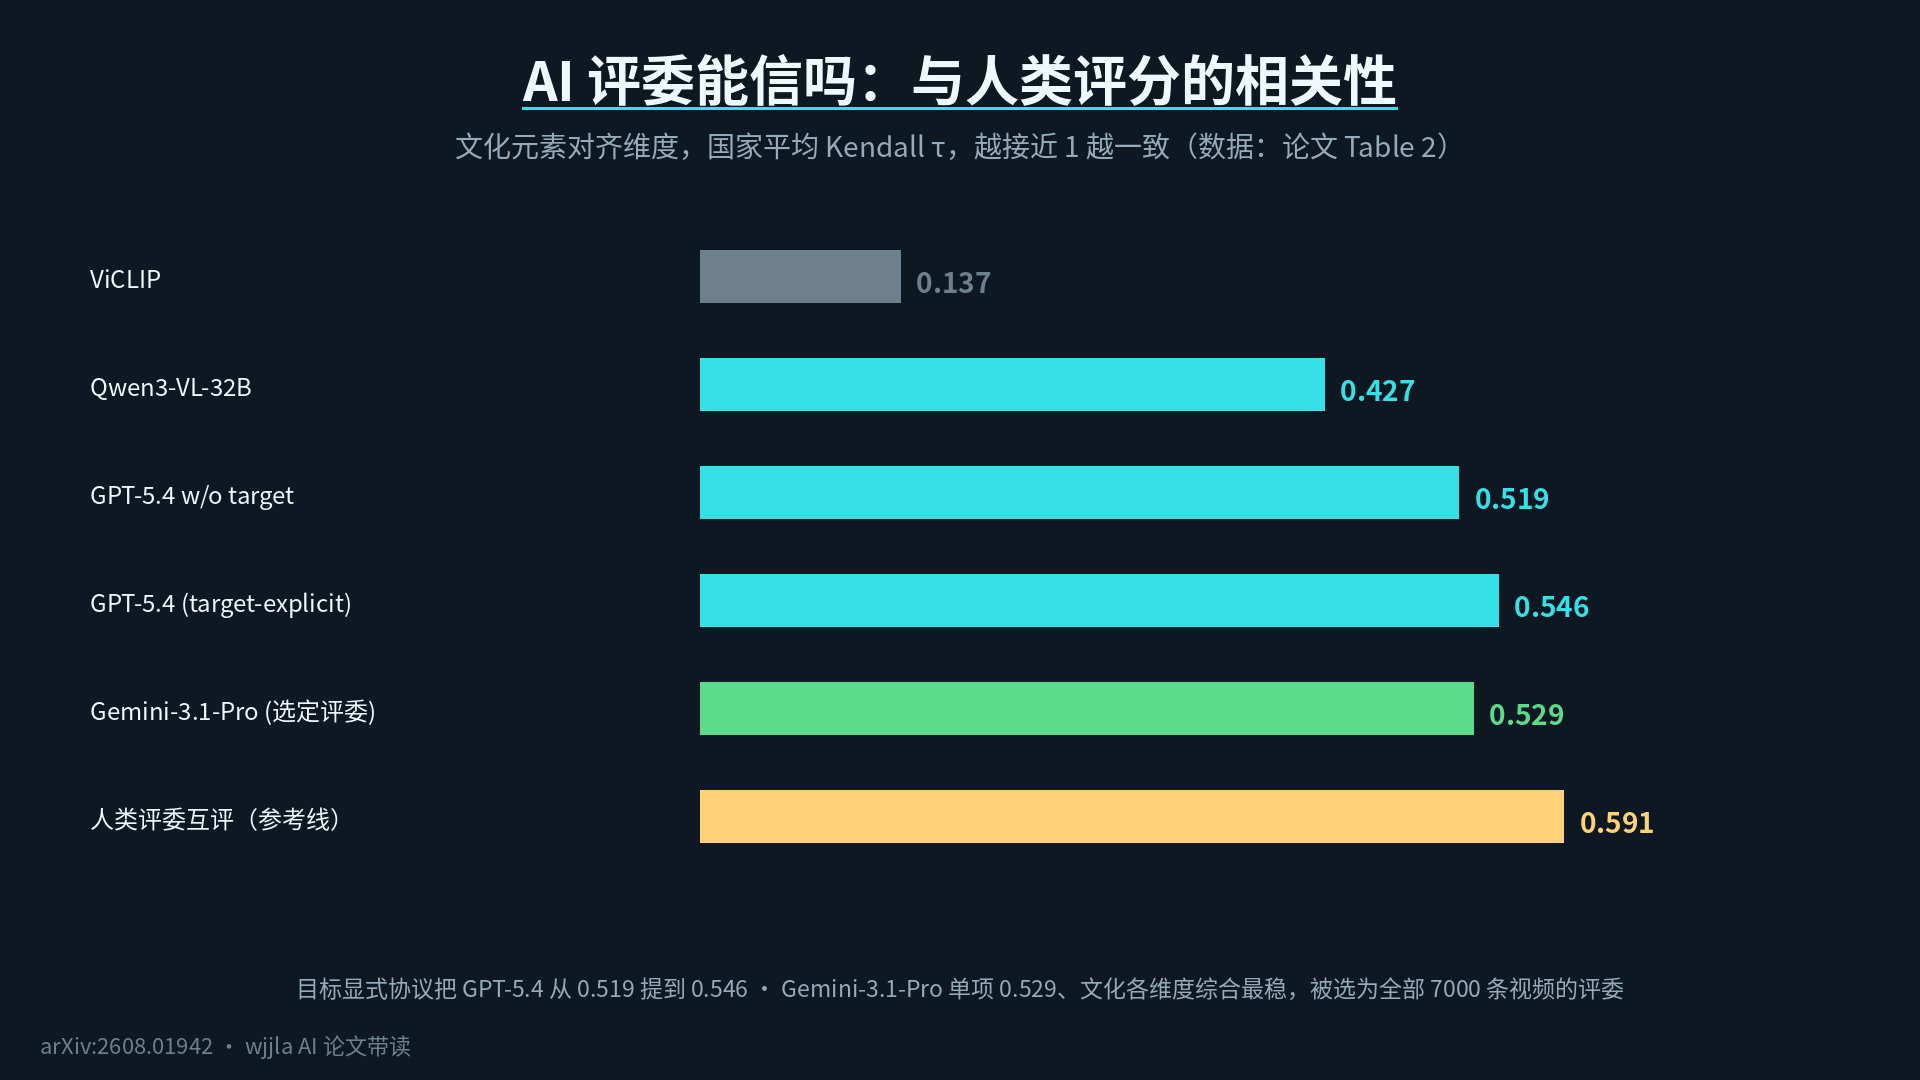
Les petits modèles ne sont pas très performants : le modèle de similarité image-texte ViCLIP n’obtient que 0,137, tandis que Qwen3-VL-32B atteint 0,427. Après l’utilisation du protocole explicite des objectifs par GPT-5.4, l’alignement des éléments culturels est passé de 0,519 à 0,546, ce qui montre que le protocole est effectivement efficace. L’évaluateur final choisi par les auteurs est Gemini-3.1-Pro : il obtient un score de 0,529. Bien que ses scores individuels soient légèrement inférieurs à ceux de GPT-5.4, il offre la plus grande stabilité pour l’ensemble des dimensions culturelles (cohérence culturelle : 0,521, rendu du texte : 0,527). Les auteurs l’ont utilisé pour noter l’ensemble des 7 000 vidéos.
La référence clé est la corrélation entre les juges humains : 0,591. En d’autres termes, les meilleurs juges d’IA se rapprochent du niveau de consensus entre les juges humains en termes de dimension culturelle – l’évaluation culturelle est passée de « il faut faire appel à des humains » à « on peut d’abord laisser l’IA passer en revue ». Cependant, pour les dimensions subjectives telles que le réalisme et la qualité visuelle, où la cohérence humaine est faible, l’IA ne peut pas non plus exceller, et ces scores peuvent être ignorés.
Entre les pays : un fossé de 0,3 point
La figure 5 de la page 7 présente les scores par pays. Ce tableau (les chiffres exacts figurent en annexe) est probablement la page la plus utile de l’ensemble du document pour les praticiens :
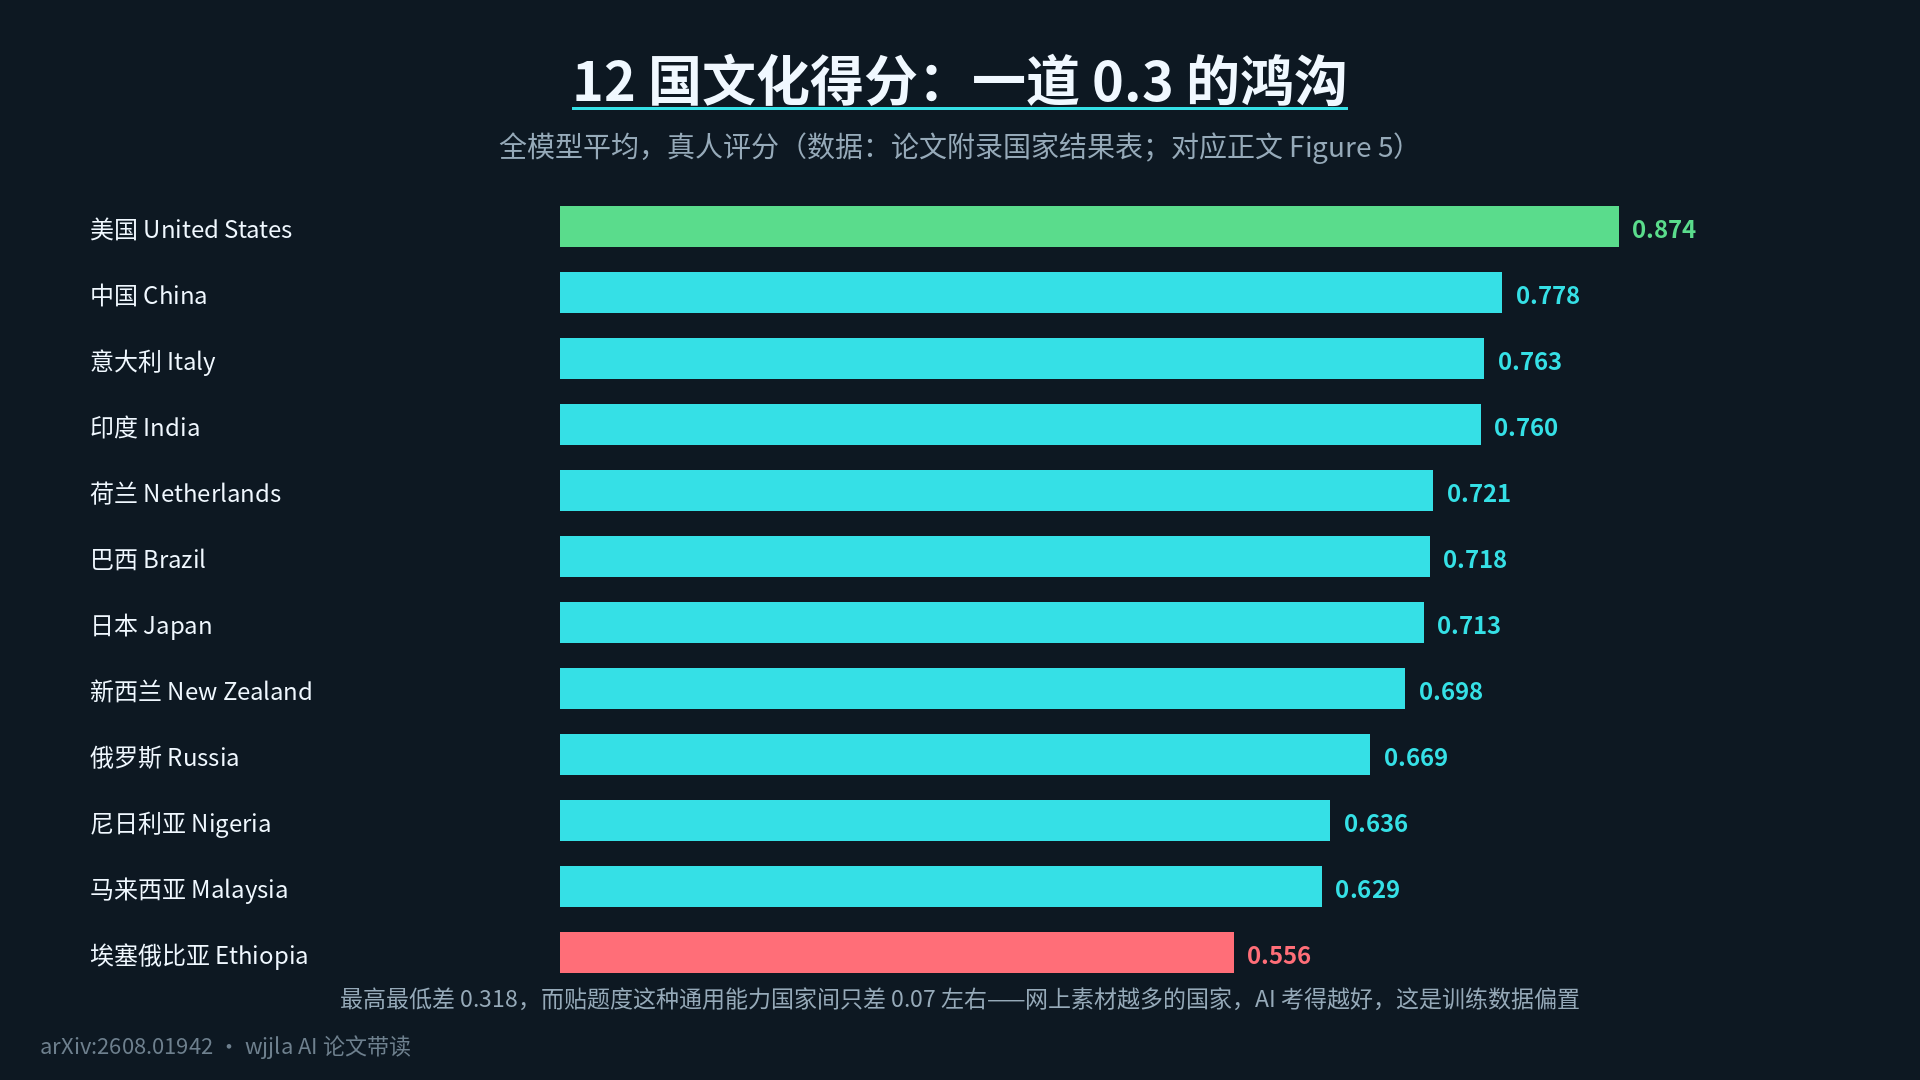
Les États-Unis se classent en tête du classement avec un score de 0,874, suivis par la Chine (0,778), l’Italie (0,763), l’Inde (0,760) ; ensuite viennent les Pays-Bas (0,721), le Brésil (0,718), le Japon (0,713) et la Nouvelle-Zélande (0,698) ; ensuite la Russie (0,669), le Nigeria (0,636) et la Malaisie (0,629) ; et enfin l’Éthiopie (0,556), qui est en dernière position.
La différence entre le score le plus élevé et le score le plus faible est supérieure à 0,3. L’auteur a également calculé la dispersion entre les pays pour chaque dimension : la dimension de l’alignement culturel est de l’ordre de 0,3, tandis que la dimension de la pertinence, qui est une capacité générale, n’est séparée que d’environ 0,07. En d’autres termes, tous les modèles sont capables de reproduire correctement une scène de deux personnes jouant aux échecs, mais lorsqu’il s’agit de détails culturels tels que la salutation par les épaules en Éthiopie ou le jeu de Shogi au Japon, les scores s’écartent immédiatement. La règle est tellement évidente qu’elle peut paraître brutale :plus un pays dispose de nombreux matériaux en ligne, meilleurs sont les résultats de l’IA. Ce n’est pas une question d’intelligence du modèle, mais de biais des données d’entraînement.
La Figure 6 ajoute une précision : les modèles open source perdent encore plus de points dans les pays à faibles ressources tels que l’Éthiopie, la Malaisie et le Nigeria, tandis que les modèles propriétaires perdent également des points, mais bénéficient d’une base solide et restent en tête après ces pertes.
Quelle culture est la plus difficile à photographier : les objets sont faciles, les processus sont difficiles.
La figure 8 classe les 14 aspects par catégorie culturelle : la culture matérielle a le score global le plus élevé, les pratiques sociales et les spectacles viennent ensuite, et les rituels et cérémonies sont les plus difficiles. La baisse des scores culturels par rapport aux scores sémantiques varie de -15,6 % pour les célébrations à -30,9 % pour les vêtements.
Le principe est très simple : photographier un objet est un problème visuel statique, tandis que photographier un processus temporel et spatial complet, avec des étapes successives et des interactions, est d’un niveau de difficulté supérieur.
Les photos ratées de la Figure 7 sont la meilleure illustration : le jeu de go japonais, HappyHorse-1.0. La scène est correcte, mais les caractères sur les pièces sont tous faux ; la peinture de la croix orthodoxe éthiopienne, tous les modèles ne peuvent pas reproduire le geste de pincement des doigts ; les décorations de l’Aïd al-Fitr en Malaisie, HunyuanVideo-1.5 les a directement rendues dans le style de Noël - les motifs de la culture à haute résolution ont directement “pris le contrôle” des scènes de la culture à faible résolution.
Quelques points qui méritent d’être rappelés après avoir lu ceci
Premièrement,ne confondez pas le score total et la capacité. La plus grande contribution méthodologique de cet article est de séparer les évaluations de la « qualité de la production » et de la « pertinence culturelle ». Un modèle avec une qualité de production de 0,8 et une pertinence culturelle de 0,4 est idéal pour le contenu local, mais serait un échec pour le contenu international. Le choix du modèle dépend de ce que vous recherchez.
Deuxièmement,le leadership en matière de source fermée est réel, mais il ne faut pas le déifier. 0,766 signifie que le champion de la source fermée a également manqué de capturer plus de 20 % des éléments culturels ; et 0,434 pour le rendu du texte montre qu’aucun modèle ne peut être entièrement fiable pour l’ensemble de la chaîne. Pour les projets multiculturels, l’étape de révision localisée est indispensable.
Troisièmement,le tableau des scores par pays vaut la peine d’être conservé. Pour chaque marché, consultez d’abord les scores du pays : pour les marchés à forte ressource tels que les États-Unis, la Chine et l’Inde, les modèles principaux sont généralement fiables ; pour les marchés tels que l’Éthiopie et la Malaisie, un score de 0,55 à 0,63 signifie que près de la moitié des détails culturels sont erronés et qu’une vérification manuelle est nécessaire. L’auteur n’a pas fourni d’analyse causale supplémentaire en dehors de la matrice complète de chaque modèle dans chaque pays, par exemple si c’est la quantité de données d’entraînement ou la répartition des données qui joue un rôle décisif. Ce point n’est pas développé dans l’article.
Quatrièmement,les juges IA sont plus importants que les scores eux-mêmes. Une évaluation de l’ampleur de 1 000 questions × 7 modèles serait impossible à réaliser par des humains. Le protocole d’évaluation explicite (énoncer les objectifs, rechercher les preuves et attribuer les scores) pousse la pertinence des juges IA jusqu’à un niveau proche de celui des évaluations humaines mutuelles. Cette approche deviendra probablement la norme pour la prochaine vague d’évaluations multimodales.
En un mot : pour ce qui est de la réalisation de vidéos, l’IA a déjà terminé sa formation ; pour ce qui est de la compréhension de la culture, elle est encore en train de rattraper son retard – et cet article fournit la première note attribuée à ses progrès dans ce domaine.
Articles : CultureVidBench : Évaluation de la compréhension culturelle dans la génération de texte en vidéo. arXiv : https://arxiv.org/abs/2608.01942 Page d’accueil du projet : https://hanxjing.github.io/CultureVidBench/