Wang et Zahl, Estimations de volume pour les unions d’ensembles convexes et la conjecture du jeu de Kakeya en trois dimensions, arXiv 2502.17655v1 (soumis le 26 février 2025, 127 pages). Résumé en une phrase : la dimension du jeu de Kakeya en trois dimensions = 3 a été démontrée, et de manière fortuite, la conjecture du doublement du tube en trois dimensions et la conjecture de l’extension des segments de Keleti ont également été prouvées. J’ai lu attentivement cet article du résumé jusqu’à la section 12, et j’ai expliqué tous les termes techniques « qui semblent sortis d’un conte de fées ».
1. Introduction : deux auteurs et une question qui a attendu 108 ans pour être résolue.
Les auteurs sont Hong Wang et Joshua Zahl. Wang Hong est professeur à l’Institut Courant de l’Université de New York et professeur titulaire à l’Institut des hautes études scientifiques (IHES). Il a obtenu son diplôme de premier cycle en 2011 à l’Université de Pékin et a obtenu son doctorat au MIT sous la direction de Larry Guth. Zahl est professeur de mathématiques à l’Université de la Colombie-Britannique. Au cours des trois dernières années, ces deux chercheurs ont publié une trilogie qui a permis de résoudre un problème géométrique resté en suspens pendant près d’un siècle, passant d’une « preuve partielle » à une « preuve complète ». Wang Hong vient de recevoir le prix Fields 2026.
L’histoire commence au Japon en 1917. Sōichi Kakeya a posé une question que même un enfant pourrait comprendre :Quelle est la plus petite surface que la pointe d’une aiguille (un segment de ligne unitaire) peut balayer en tournant une fois sur un plan ?Plus tard, cette question a été généralisée en l’ensemble de Kakeya : un ensemble compact qui contient un segment de ligne unitairedans toutes les directionsest appelé un ensemble de Kakeya. En 1971, Davies a prouvé que la dimension de Minkowski et de Hausdorff de l’ensemble de Kakeya en deux dimensions est toujours égale à 2 (dimension complète). Mais pour les dimensions supérieures à trois, il y a eu un blocage pendant plus d’un demi-siècle.
Vous pouvez également envisager cela de la manière suivante :l’ensemble de Kakeya est comme un « parking où les voitures peuvent faire demi-tour dans n’importe quelle direction »- chaque direction doit avoir une « place de stationnement » pouvant accueillir une voiture, même si cette place n’est pas plus large qu’une aiguille, mais la direction doit couvrir 360°. En deux dimensions, il est facile d’imaginer que ce parking est juste un disque ordinaire ; mais une fois passé en trois dimensions, il devient étrangement difficile de trouver une aiguille « tridimensionnelle » pouvant être placée dans chaque direction.
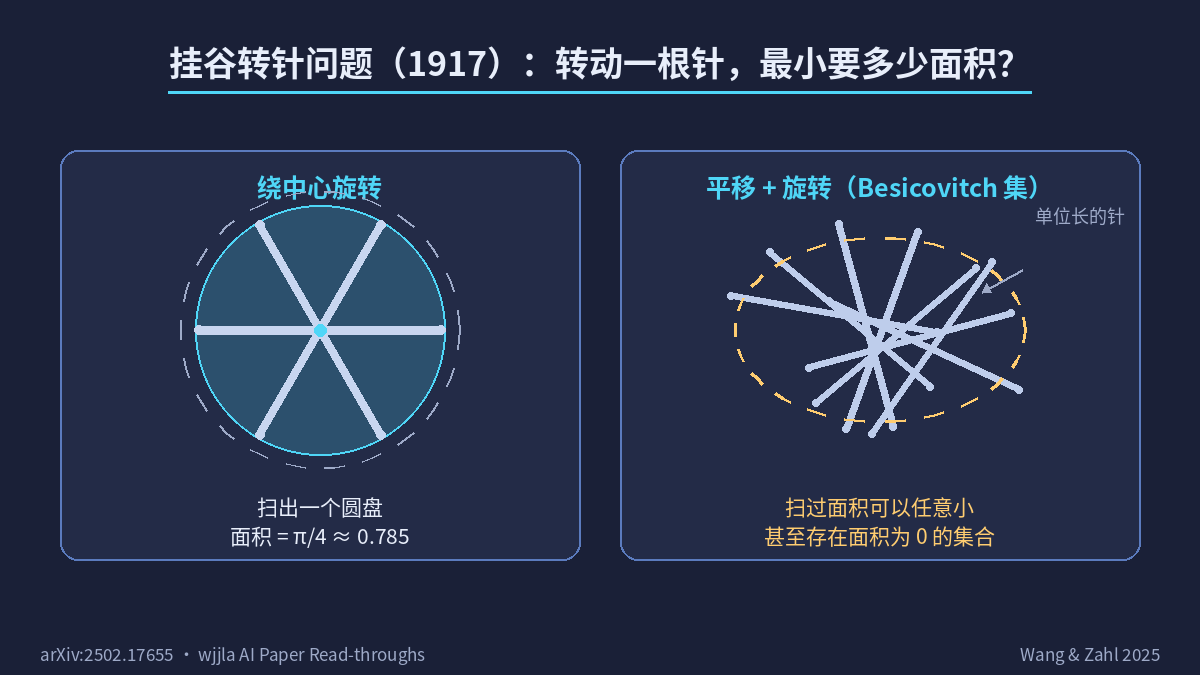
L’image ci-dessus illustre la motivation initiale du problème : lorsque vous tournez un objet, la zone balayée ressemble intuitivement à un cercle, mais en réalité, il existe une forme « en feuille » avec une surface encore plus petite - plus vous tournez habilement, plus la surface balayée se rapproche de zéro - Besicovitch a proposé une construction de cette sorte où la surface peut être aussi petite qu’on le souhaite, voire nulle (le § 1.6 de son article mentionne cette construction dans R², voir L664). Cependant, la conjecture de dimension pose la question inverse : si un ensemble peut « contenir » une aiguille dans toutes les directions, sa dimension doit être égale à 3.
**Pourquoi « dimension = 3 » est-elle en soi une proposition extraordinaire **?Il faut s’arrêter un instant ici pour expliquer clairement le terme « dimension ».
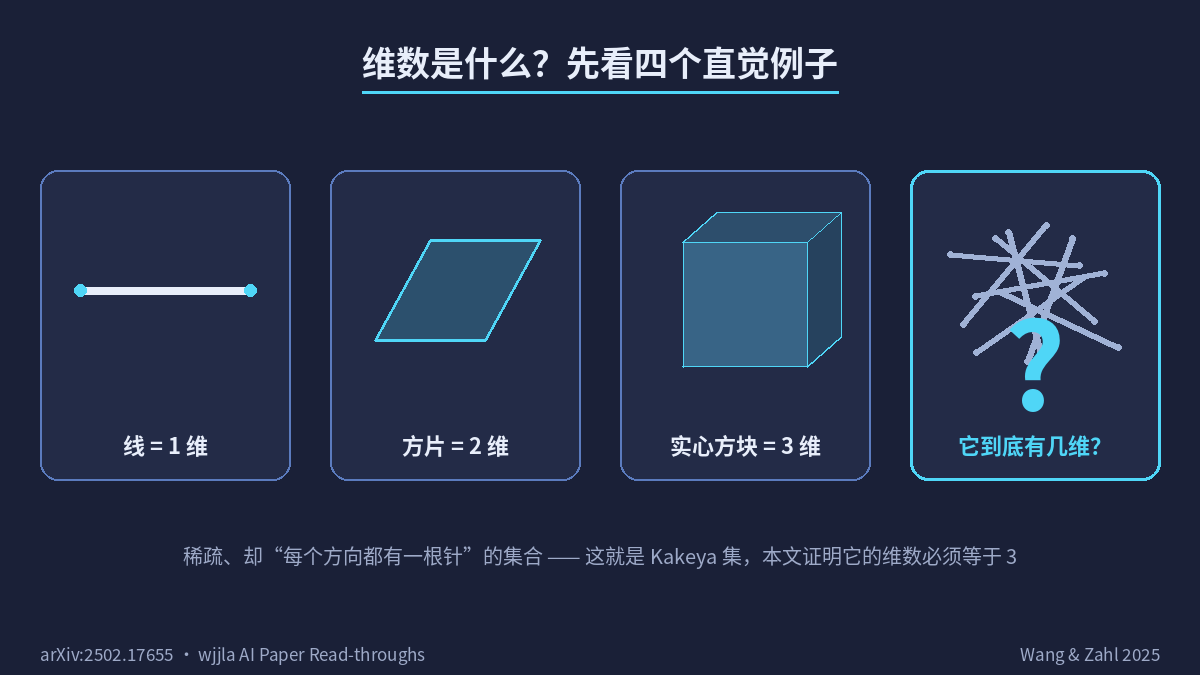
La version la plus intuitive est la suivante : « agrandissez un ensemble de ε fois », et observez « à quoi il ressemble ».La dimension ne mesure pas la taille, mais la « densité »— c’est-à-dire le nombre de directions indépendantes dans lesquelles l’ensemble « étire l’espace ». Un fil fin est un ensemble unidimensionnel (il s’étend uniquement dans une direction), une feuille de papier est un ensemble bidimensionnel (il s’étend dans deux directions), et un cube plein est un ensemble tridimensionnel (il s’étend dans trois directions). La conjecture de Kakeya affirme que « la dimension = 3 » signifie que l’ensemble rempli de « aiguilles dans toutes les directions » doit être suffisamment étiré dans trois directions indépendantes, et qu’il ne peut pas être comprimé en un mince disque bidimensionnel, un fil unidimensionnel, ou un tas de points zéro-dimensionnels.
Alors, la question centrale est : « Pourquoi ne peut-on pas insérer des aiguilles orientées différemment dans une feuille de papier ? » C’est géométriquement contre-intuitif, mais mathématiquement, personne n’a été capable de le prouver depuis des décennies.
II. Pourquoi la 3D a stagné pendant un siècle : examinons de plus près le « bilan du demi-siècle ».
Les résultats partiels de la conjecture de Kakeya en trois dimensions ont été obtenus en suivant deux voies : l’une est un indicateur rigide de la « dimension inférieure », et l’autre est un outil flexible du « théorème de structure ».
Ligne d’indicateurs rigides: Wolff a prouvé en 1995 [27] (Rev. Mat. Iberoam. 11) que la dimension de Hausdorff de l’ensemble de Kakeya en trois dimensions est au moins égale à (n+2)/2 = 5/2 ; plus tard, Katz, Laba et Tao (dans l’article [16]) ont ajouté un petit nombre normal c à cette base, pour obtenir 5/2 + c. Cette ligne donne la « limite inférieure absolue », qui est encore très éloignée du chiffre 3.
Outils logiciels: À partir de 2000 environ, le théorème multilinéaire de Kakeya de Bennett-Carbery-Tao ([1]) a montré que tout « contre-exemple » doit être « planaire » — lorsque les aiguilles sont empilées ensemble, elles doivent reposer approximativement sur un plan ; Guth ([9]) a utilisé sa célèbre « décomposition en grains » pour montrer que le contre-exemple doit être « granuleux » — les aiguilles doivent pouvoir s’organiser en grains cubiques ; maisle maillon le plus crucial, la collosité, est resté un obstacle: on peut dire qu’un contre-exemple est planaire + granuleux + collant, et ensuite ? On s’arrête là.
En 2014, Terence Tao a décrit le programme Katz-Tao en trois étapes dans un exposé et un article de blog ([24]): la première étape consiste à prouver que les contre-exemples doivent avoir l’une des trois structures planaires / granuleuses / collantes; la deuxième étape consiste à « multiscaler » ces structures pour obtenir une description de plus en plus fine; et la troisième étape consiste à utiliser les outils de somme-produit discrétisés de Bourgain pour « réfuter » cette structure multiscalaire.
Les deux articles de Wang Hong et Zahl en 2022 et 2024 [25][26] ont en fait sauté la première étape et ont directement fait « hypothéter que le contre-exemple est sticky et montrer une contradiction », ainsi que « hypothéter que le contre-exemple a une dimension d’Assouad < 3 et montrer qu’il doit être sticky ». Mais ces deux étapes ne suffisent pas : la dimension d’Assouad peut être supérieure à la dimension de Minkowski, donc [25][26] n’a pas vraiment fermé la porte à la possibilité que la dimension de Minkowski soit < 3.
Cet article de 127 pages comble précisément cette lacune : il ne suppose pas l’existence de contre-exemples collants, mais prouve directement que « si D(σ, ω) est compact, les contre-exemples doivent ressembler à des objets collants ». Il utilise ensuite le théorème de Kakeya sur les objets collants pour démontrer une contradiction. Cette étape conclut la preuve et permet d’affirmer définitivement que la dimension du complexe de Kakeya en trois dimensions est égale à 3.
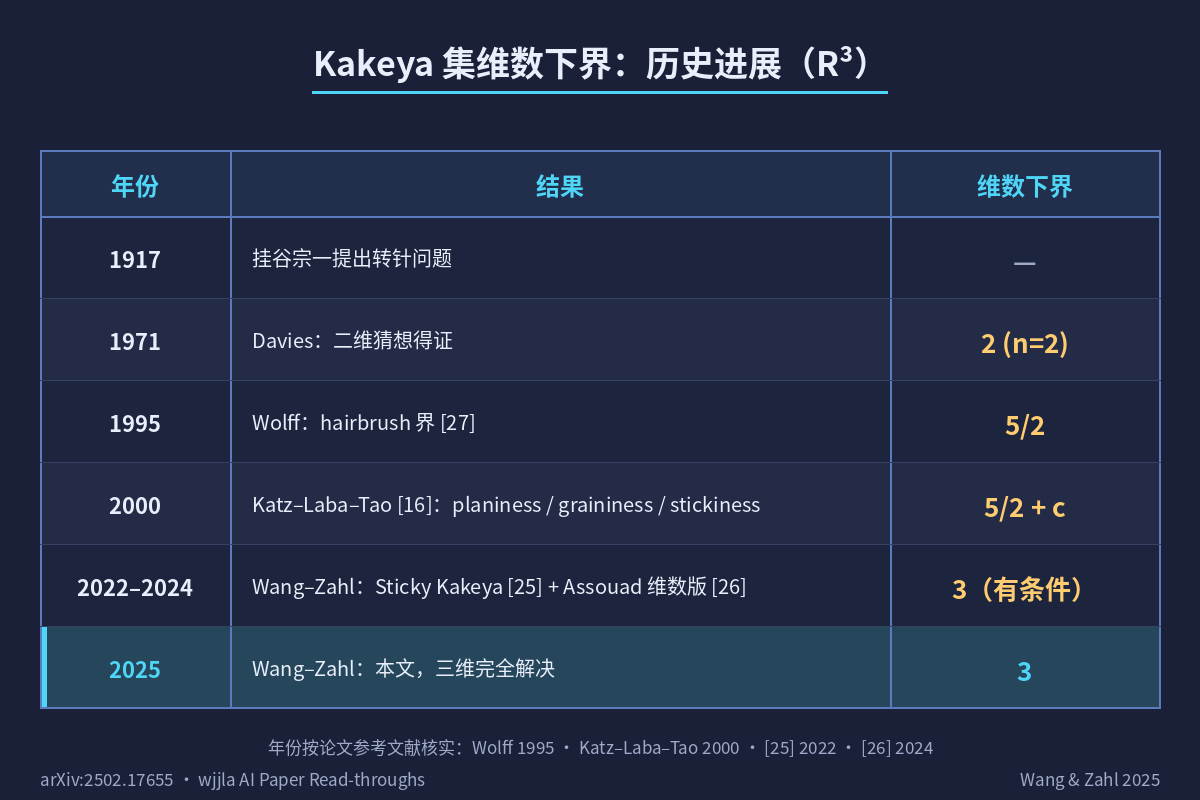
En termes de chiffres, l’étendue de « l’ancien bas → le bas actuel » est la suivante : de 5/2 de Wolff en 1995 à 5/2 + c de Katz-Laba-Tao dans les années 2000, et maintenant directement à 3. Entre l’étude de Wolff et celle-ci, il y a un intervalle d’environ 30 ans (5/2, 3), qui a été entièrement franchi par cette étude au début de 2025.
III. Le véritable sujet de cet article est « l’estimation du volume par des tubes parallèles », et Kakeya n’est qu’une déduction.
Il faut d’abord expliquer cela clairement, sinon la lecture de l’article sera noyée sous les termes techniques. Le titre de l’article est Estimations du volume pour les unions d’ensembles convexes, et la conjecture de l’ensemble de Kakeya en trois dimensions. Kakeya est juste une conséquence, lethéorème principalest le Théorème 1.2 et le Théorème 1.9 (le dernier donne le Corollaire 1.10), qui disent :
Pour un ensemble de tubes δ (avec un diamètre δ et une longueur de 1), tant qu’ils ne sont pas « agglomérés » (ce que l’on appelle techniquement un axiome de Wolff ou un non-regroupement) dans un ensemble convexe quelconque, le volume de l’ensemble obtenu en assemblant ces tubes sera « presque » égal à la somme des volumes des tubes – c’est-à-dire que ces tubes se chevauchent très peu et ne se superposent pas de manière significative.
Tube δest un terme central récurrent. En clair, il s’agit d’uneaiguille de longueur 1 et d’épaisseur δ dans une certaine direction. Pour faire un parallèle avec la vie quotidienne, c’est comme unepaille— la paille a sa propre orientation (la direction de la longueur) et sa propre épaisseur (le diamètre δ), et le « volume » de la paille entière est δ² · 1 = δ² (la surface de la section transversale de la paille fine multipliée par sa longueur). Lorsque δ est très petit (la paille est très fine), le volume d’une seule paille δ² est également très petit ; le volume de dix mille pailles fines additionnées ne sera que de δ² · 10000, ce qui ne semble pas beaucoup — mais l’article doit prouver que lorsque les pailles satisfont la condition de « ne pas se regrouper dans un ensemble convexe », le volume de l’ensemble des dix mille pailles fines ne peut être que de ~10000 · δ², et pas plus ; cela signifie qu’elles sont vraiment disposées « presque sans se chevaucher », sans un grand nombre de chevauchements.
L’axiome de Wolff doit son nom à l’article de Wolff de 1995 [27] qui a introduit ces conditions « non centralisées » : si vous prenez un rectangle de dimensions a × b × 2 et que vous essayez de le remplir avec des tubes, le nombre de tubes qu’il peut contenir ne doit pas être trop supérieur à la surface de la section du rectangle multipliée par 1/δ². En d’autres termes, les tubes ne doivent pas être « trop serrés ».
En langage courant, cette condition s’appelle«** limitation du flux dans les supermarchés ».Imaginez dix mille pailles flottant dans un immense centre commercial, chacune ayant sa propre orientation. Le postulat de Wolff stipule que si vous coupez un petit cube de a × b × 2 (dont la surface de coupe est a × b), ce petit cubene peut contenir qu’environ a · b / δ² pailles**— la surface de coupe du cube détermine la « limite supérieure » du nombre de pailles qu’il peut contenir, indépendamment de l’orientation des pailles. Si vous prenez un petit cube de 1 × 1 × 2 et qu’il contient soudainement 100 fois plus de pailles que la limite supérieure de la surface de coupe, cela contrevient au postulat de Wolff. Le postulat de Wolff est essentiellement une contrainte rigide de**« dispersion » » : les pailles ne doivent pas s’entasser.
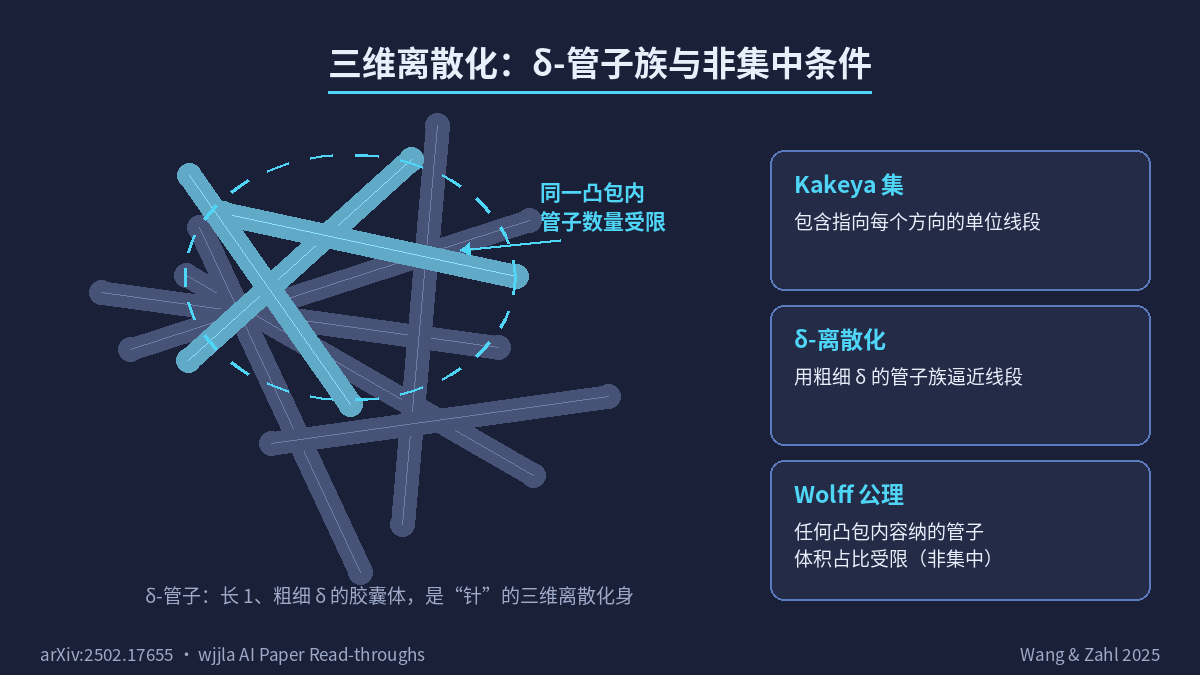
Comprendre intuitivement : Imaginez que vous avez des dizaines de milliers d’aiguilles fines, une dans chaque direction. Le théorème de Wolff dit que « ces aiguilles ne se rassembleront pas soudainement 100 fois dans un petit boîtier de a × b × 2 » - c’est une contrainte rigide de « dispersion ».
Kakeya satisfait exactement cette condition : une aiguille dans chaque direction (les directions séparées par δ), donc dans n’importe quel cube de taille a × b × 2 à l’intérieur de la boule unité, on peut en insérer au maximum ~ab/δ² (déterminé par la section transversale). Par conséquent,le théorème 1.2 démontre directement le théorème 1.1— c’est la valeur ajoutée de l’expression « en conséquence » dans le titre de l’article.
IV. Quatre étapes pour la réflexion centrale : l’axiome de Wolff → la décomposition des ensembles convexes → les grains à deux échelles → les trois mouvements → l’induction à l’échelle.
Le cadre de l’argumentation de 127 pages peut être résumé en quatre étapes. Je vais utiliser les numéros des figures de mon propre article pour vous guider dans mon explication.
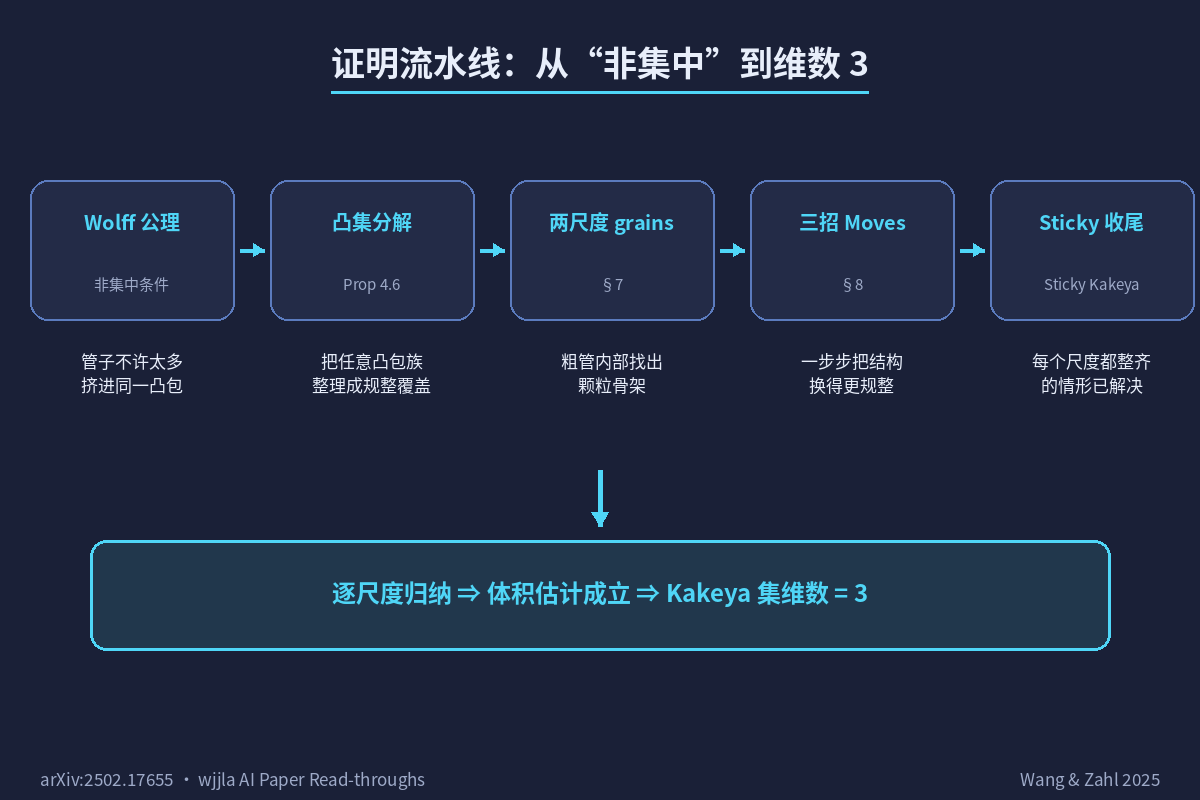
Cette figure présente les quatre étapes à suivre : l’axiome de Wolff contraint la distribution des tubes → la décomposition des ensembles convexes transforme la « famille de tubes » en un « ensemble convexe d’emballage » → les grains à deux échelles alignent les tubes en particules rectangulaires → les trois mouvements « poussent » les particules en place → l’induction d’échelle réduit ω à zéro.Rappelez-vous ces cinq étapes, et l’ensemble du document ne sera plus une forêt de termes techniques.
Étape 1 : Axiome de Wolff + Décomposition des ensembles convexes(§4)
Quel est l’intérêt de cette étape : Tout d’abord, remplacer « les tubes » par un langage plus général - un ensemble convexe qui est équivalent à n’importe quel ensemble.Pourquoi est-ce indispensable: Parce que traiter directement le δ-tube est trop spécifique, et la relation géométrique entre les « tubes » et les « tubes » qui se chevauchent est difficile à décrire. En remplaçant par des ensembles convexes, on peut utiliser des relations plus « linéaires » entre les ensembles convexes pour organiser la preuve.
Définissons deux constantes de Wolff : la constante convexe de Katz-Tao (CKT-CW), qui mesure « l’incapacité à s’entasser dans un ensemble convexe quelconque W », et la constante de slab de Frostman (CF-SW), qui mesure « l’incapacité à s’entasser dans des tranches de slab ». La constante de Frostman est « héritée vers le haut », tandis que la constante de Katz-Tao est « héritée vers le bas » — cette relation de dualité est le moteur de toutes les décompositions qui suivent. La proposition 4.6 est l’outil clé de cette étape : étant donnée une famille d’ensembles convexes, on peut toujours trouver une famille d’ensembles convexes « d’emballage » W qui contrôlent U par le bas avec Frostman et par le haut avec Katz-Tao, avec une erreur K (absorbable).
En un mot, chaque symbole peut être expliqué comme suit :CKT-CW est un indicateur normalisé qui mesure le nombre de tubes contenus dans l’ensemble convexe W; plus la valeur est faible, moins les tubes sont concentrés dans W.CF-SW est une version « en tranches fines » du même concept, mais pas pour n’importe quel ensemble convexe W, mais pour une tranche (slab) de même épaisseur.L’héritage ascendant de Frostmansignifie que la dispersion à grande échelle peut être transmise à des sous-échelles plus fines, tandis quel’héritage descendant de Katz-Taofait le contraire : la dispersion à petite échelle peut contraindre la dispersion à grande échelle. Ces deux relations d’héritage ascendant et descendant, comme les deux extrémités d’un ressort, sont le moteur de toutes les décompositions ultérieures.
Étape 2 : Décomposition des grains à deux échelles(§7)
Quel est l’intérêt de cette étape : Après avoir obtenu la « famille de convexes emballés » à l’étape 1, il faut à nouveau structurer les tubes contenus dans chaque convexe en les organisant en « grains » cubiques.Pourquoi est-ce indispensable: Parce que les relations entre les tubes sont trop complexes (chaque tube pointe dans une direction différente et s’entrecroise avec les autres), tandis que les relations entre les grains cubiques ne sont que de « contenu / chevauchement partiel / non intersection », ce qui est beaucoup plus facile à gérer.
Cette étape est une amélioration de l’idée des grains de Guth [9]. Dans [9], Guth a prouvé que, sous l’hypothèse « large », les tubes peuvent être décomposés en particules rectangulaires (appelées grains) de taille δ × t × t, où t ≥ 1/√(#T). L’article le présente sous uneversion à deux échelles: on choisit d’abord une échelle intermédiaire ρ et on remplit les tubes δ avec des tubes ρ ; on effectue ensuite une décomposition des grains dans chaque tube ρ pour obtenir des particules de taille δ/ρ × c × c ; enfin, on réduit à nouveau l’échelle pour obtenir une famille de grains δ × ρc × c, appelée G. L’apparition simultanée des deux échelles (δ et ρ) est un prérequis pour les « trois mouvements » qui suivent.
Le motgrainspeut être comparé dans la vie quotidienne àdes brochettes de sucettes— des morceaux de hawthorn (grains) de taille similaire sont empilés sur une tige de bambou (dans le sens de la tige). Les longs côtés des grains s’étendent le long de la tige de bambou.**Pourquoi transformer la tige en brochette de sucettes **?Parce qu’une brochette de sucettes est plus facile à gérer qu’un tas de hawthorns éparpillés : vous pouvez compter le nombre de brochettes, le nombre de grains par brochette et la taille de chaque grain. Toutes ces « tailles » et « quantités » peuvent être intégrées dans une formule pour faire des estimations.
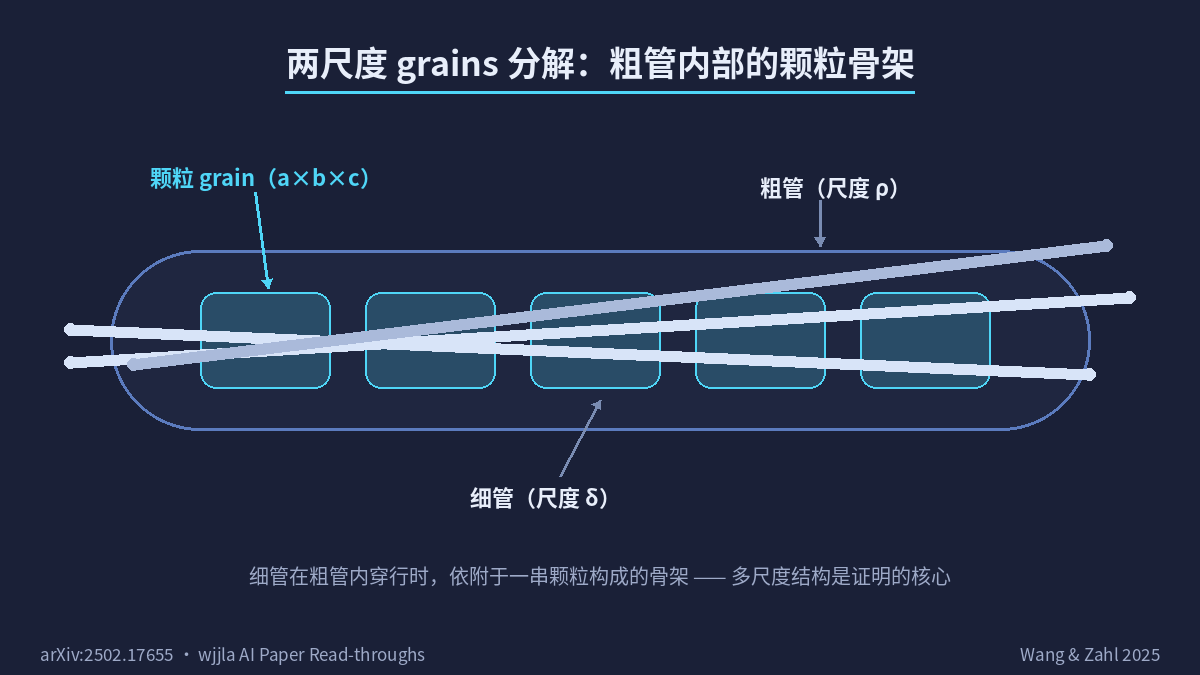
Le c dans la taille des particules n’est pas défini au hasard : c ≥ 1/√(#T[Tρ]) — La taille des particules est inversement proportionnelle au nombre de tubes δ insérés dans le tube ρ. Plus le nombre est faible, plus les particules s’étirent. Cette formule (L950, §2.2) est la pierre angulaire de toutes les estimations d’ordre de grandeur qui suivent.Ici, #T est l’abréviation de “nombre total de tubes”, et Tρ est “un sous-ensemble dans une certaine plage de ρ-tubes” — Ces deux symboles signifient que “la taille des particules à l’échelle actuelle est limitée par le nombre de tubes fins insérés dans le tube épais de l’échelle précédente”.
Étape 3 : Trois mouvements(§8)
Quel est l’objectif de cette étape : À l’étape 2, les grains obtenus ne sont pas encore « en place » - certains sont trop longs, d’autres trop courts, et d’autres trop étroits.Pourquoi c’est indispensable: L’induction des mesures ultérieures impose des exigences strictes quant à la « forme » des grains (6 propriétés (i) à (vi)). Si ces trois étapes ne sont pas effectuées, les entrées de l’induction ne satisferont pas aux conditions et la preuve ne pourra pas être poursuivie.
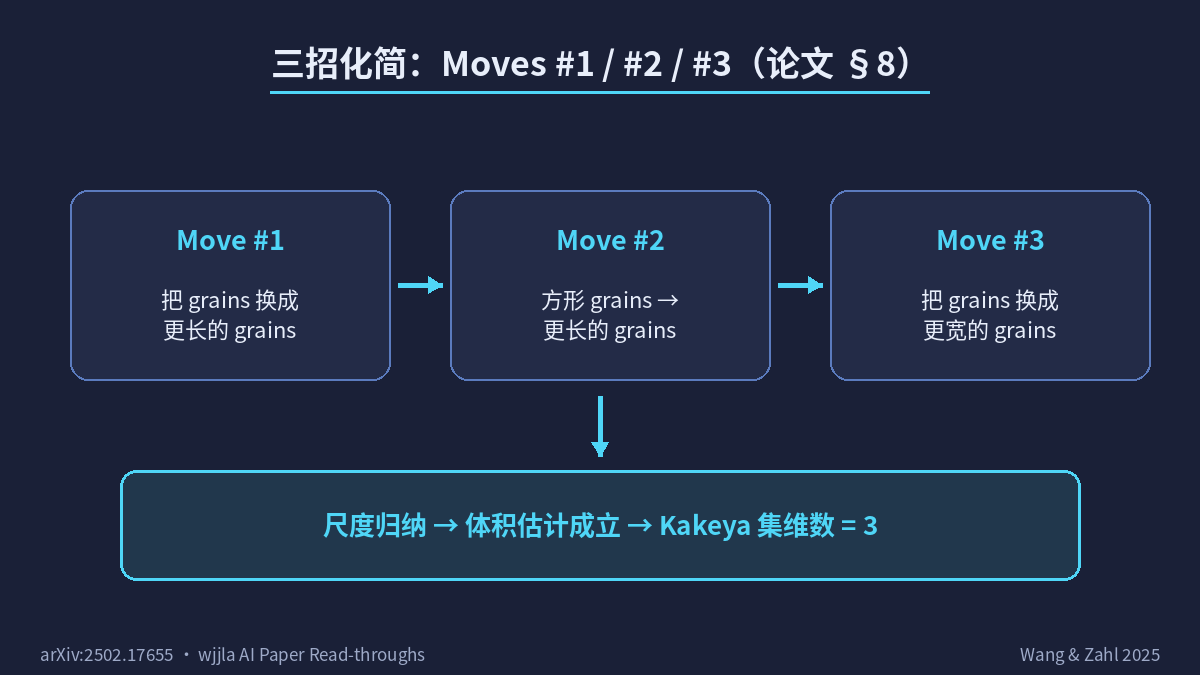
L’auteur a fait trois choses pour « mettre en place les grains » - ces trois étapes combinées sont commeles trois actions pour organiser une étagère: redresser les livres penchés (Étape n°1), aligner les livres de hauteur inégale (Étape n°2), et regrouper les livres voisins et connexes en un seul livre plus épais (Étape n°3).
Plus précisément :
- Étape n°1(§8.1) : Remplacez les grains par des grainsplus longspour s’assurer que c satisfait c ≥ δ^ζ · ρ·#Tρ / #T.Que fait-on à cette étape: On refait les brochettes de bonbons « trop petites » en brochettes « suffisamment grandes », en s’assurant que la formule de taille des grains respecte sa limite inférieure.Pourquoi les jeter et recommencer si elles ne le sont pas: Parce que toutes les estimations suivantes dépendent de cette limite inférieure. Si elle n’est pas respectée, les estimations deviennent indéfinies (et n’ont plus de sens). Si ce n’est pas le cas, abandonnez simplement ces grains et recommencez avec les entrées de la décomposition de Guth — c’est un « recommencement forcé » au niveau algorithmique.
- Étape n°2(§8.2) : Si les grains sont « carrés » (avec une section a × b × c où b/c est trop grand), utilisez une estimation L² de style Cordoba pour les remplacer par des grainsplus longs— de taille δ^(-ω/100).Que fait-on à cette étape: On traite le cas où « la section des grains est trop carrée et la longueur verticale est insuffisante » — les brochettes de bonbons sont trop « bombées », et chaque goyave doit être allongée.Pourquoi utiliser l’estimation L²: Parce que c’est un outil d’inégalité « intégrable au carré » appliqué à la géométrie des grains, qui permet justement de réduire le rapport « section / longueur verticale ».
- Étape n°3(§8.3) : Si CKT-CW est trop grand, chaque grain peut être étendu à un « peigne » à l’aide de l’argument L² : en utilisant un voisinage δ̃, on englobe tous les grains environnants pour obtenir un grainplus large.Que fait-on à cette étape: Lorsque l’indicateur de « dispersion » à une certaine échelle s’est dégradé (les tubes commencent à s’entrecroiser), on fusionne les grains voisins en un « peigne » plus large — on combine plusieurs petites brochettes de bonbons en une grande.Pourquoi ne pas simplement supprimer ces grains: Parce qu’ils contiennent des informations géométriques réelles, et les supprimer reviendrait à perdre la structure ; on ne peut que les fusionner, pas les supprimer.
À chaque fois qu’un mouvement est effectué, soit c augmente considérablement, soit ρ augmente considérablement, mais les deux sont plafonnés à 1, de sorte que ce processus d’itération doit nécessairement s’arrêter après un nombre limité d’étapes —c’est la procédure classique de convergence monotone et bornée. Lorsque l’arrêt a lieu, les grains satisfont les six propriétés (i) à (vi) (L948-970), qui constituent l’entrée de l’induction à l’échelle qui suit.
Étape 4 : Résumé à l’échelle fine(§9 + §11)
Quel est l’intérêt de cette étape : effectuer une nouvelle réduction plus fine des « grains idéaux » de l’étape 3 - appliquer E(σ, ω) àdeux niveaux, et pas seulement une fois.Pourquoi est-ce indispensable: l’estimation du volume donnée par E(σ, ω) une seule fois n’est pas suffisamment précise (elle suffit seulement à réduire ω d’un peu, mais pas à le ramener à zéro) ;il faut l’utiliser deux foispour que l’estimation prenne la forme d’unproduit, ce qui est plus précis qu’une seule utilisation.
Après avoir obtenu les « grains idéaux » de l’étape 3, l’article a effectué une étape plus détaillée : appliquer E(σ, ω) àdeux niveaux— à la fois sur le δ-tube à l’intérieur de chaque ρ-tube (à petite échelle) et sur la famille de ρ-tubes réduite de chaque grain (à grande échelle). En utilisant les deux niveaux une fois, l’estimation du volume collectif obtenue est sous la forme d’un « produit à deux niveaux », ce qui est plus efficace que d’utiliser uniquement D(σ, ω). C’est le cœur de la Proposition 1.7 — elle stipule que chaque induction réduit ω d’un g(σ, ω) > 0, et en fixant ω et en l’utilisant de manière répétée, on peut réduire σ jusqu’à 0.
L’esprit de cette induction est de « monter les escaliers »: chaque marche de l’escalier est légèrement plus basse que la précédente. Tant que chaque pas permet vraiment de descendre, même un peu (g(σ, ω) > 0), et que l’on continue à le faire, on finira par atteindre le sol (σ = 0).Pourquoi faut-il « deux étages » plutôt qu’un seul »: l’induction à un seul étage permettrait à ω de diminuer trop lentement, le nombre d’itérations ne serait pas suffisant et σ ne pourrait pas atteindre 0 ; sous forme de produit, la vitesse de diminution est multipliée, ce qui permet une véritable convergence.Que signifient les deux symboles σ et ω: en gros, σ est un « indicateur de déficit de dimension » (plus il est proche de 0, plus il est proche de la dimension complète), et ω est un « indicateur de dégradation de la dispersion » (plus il est grand, plus les tuyaux sont regroupés, et plus il est petit, plus les tuyaux sont dispersés) ; l’induction doit réduire ces deux paramètres à (0, 0) en même temps.
Conclusion de Sticky Kakeya(§10 + §2.4)
L’étape la plus cruciale : supposons que D(σ, ω) soit compact pour un ensemble de σ et ω > 0. Grâce à l’étape 4, on peut déduire que T doit être auto-similaire à plusieurs échelles, ce qui répond aux conditions d’entrée du théorème de Sticky Kakeya ; cependant, [25] a démontré que la dimension des ensembles de Sticky Kakeya est égale à 3, ce qui contredit l’hypothèse de compacité de D(σ, ω). Par conséquent, les valeurs de σ et ω doivent être nulles en même temps, c’est-à-dire que D(0, 0) et E(0, 0) sont tous deux vrais, ce qui constitue le théorème 1.9.
Le mot « collant » peut être comparé dans la vie quotidienne à une matriochka : la poupée extérieure enveloppe celle qui se trouve à l’intérieur, et celle-ci enveloppe à son tour une autre poupée à l’intérieur ; la structure de l’ensemble Kakeya collant est similaire : à chaque échelle (en regardant de manière grossière, détaillée ou encore plus détaillée), cet ensemble semble « ressembler à lui-même » — il y a des petites échelles dans les grandes, et des échelles encore plus petites dans les petites, avec une auto-similarité à chaque niveau.**Pourquoi cette structure de matriochka permet-elle de déduire une contradiction **?Parce qu’une fois qu’on a déterminé qu’un contre-exemple est collant, [25] il a été prouvé que la dimension de l’ensemble Kakeya collant doit être égale à 3 ; mais on suppose que la dimension est inférieure à 3 (le contre-exemple existe), donc le contre-exemple ne peut pas être collant — mais on a précédemment déduit que le contre-exemple doit être collant, ce qui est contradictoire.
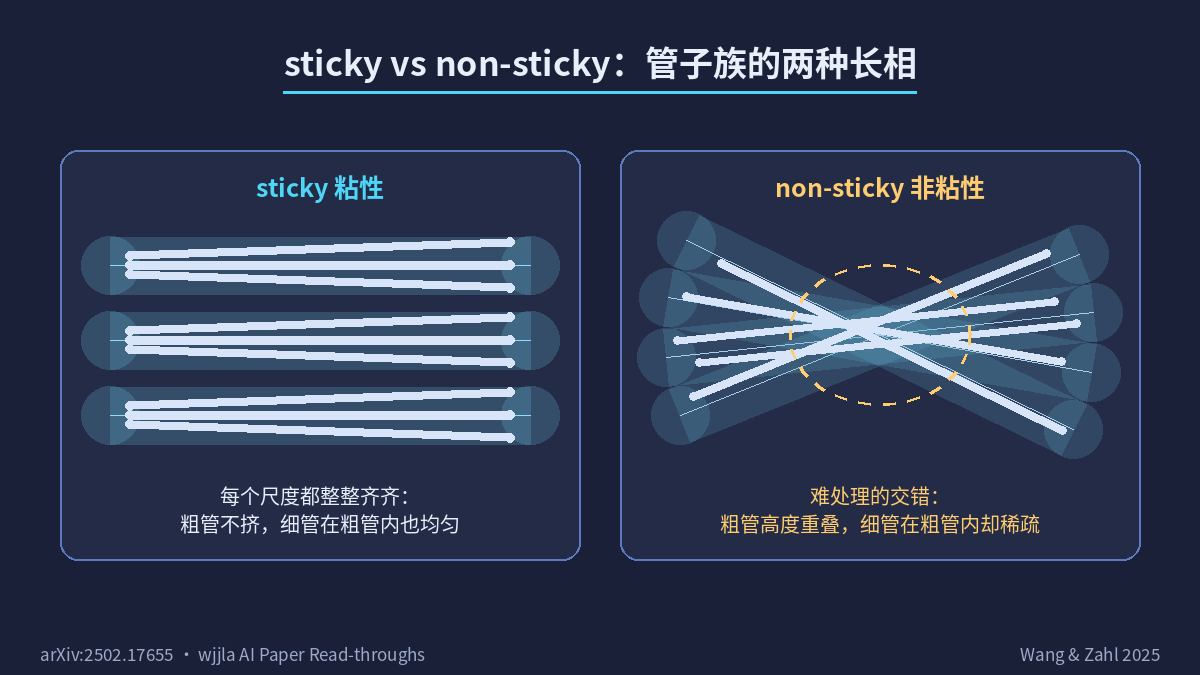
L’outil utilisé dans cette étape est la factorisation de Nikishin-Stein-Pisier (§10.1, L5910) : il sert à compléter un ensemble T rare (nombre « δ^(-2)) à δ^(-2) éléments, afin que le théorème de Sticky Kakeya puisse être appliqué.L’esprit de cet outilest de «tendre l’élastique au maximum» — vous avez un ensemble de tubes trop rare (nombre « δ^(-2)), et le théorème de Sticky nécessite δ^(-2) éléments pour fonctionner ; Nikishin-Stein-Pisier permet de « multiplier » les tubes rares pour obtenir une version dense, ce qui équivaut à tendre un élastique — l’ensemble rare est étendu de manière rigide en un ensemble dense, dont la « densité » atteint le seuil minimum requis par le théorème de Sticky.
- Deux résultats inattendus : le tube doublé et la conjecture de Keleti ont été résolus ensemble.
Vous pensiez que c’était la fin après avoir lu cela ? Non, le document a prouvé de manière simple le conjecture du doublement des tubes en trois dimensions (Théorème 1.12, L685) et la conjecture de l’extension des segments de ligne de Keleti (Théorème 1.14, L698).
Ledoublement de tubeconsiste à « épaissir deux fois » un ensemble de δ-tubes (les transformant en 2δ-tubes). Après cet épaississement, le volume global est au maximum réduit d’un facteur sous-polynomial δ^(-ε) par rapport à l’original. La version en deux dimensions était déjà connue (décrite au §1.6 de l’article), mais la version en trois dimensions restait un problème ouvert. Wang et Zahl ont résolu ce problème en utilisant les axiomes de Wolff et la décomposition des ensembles convexes.
Leconjecture de Keletistipule que si un ensemble de segments de ligne est allongé pour devenir des droites, la dimension de ces droites est égale à la dimension de l’ensemble des segments de ligne d’origine. Keleti-Máthé ([23]) a prouvé en 2022 que la conjecture du Kakeya n-dimensionnel implique la conjecture de Keleti n-dimensionnelle. Par conséquent, Wang et Zahl offrent gratuitement une version tridimensionnelle de la conjecture de Keleti.
Les deux déductions ne sont pas des « déductions évidentes ». Le §12 de l’article fournit une preuve complète du Tube Doubling en utilisant le même théorème de structure multi-échelle du §11 + la factorisation de Nikishin-Stein-Pisier.
6. Frontières : n ≥ 4, pourquoi ne pas fermer la porte derrière vous ?
Le document ne le précise pas, mais je vais le mentionner après avoir lu la section 1. Il y a au moins trois endroits dans l’ensemble de l’argumentation qui dépendent spécifiquement de la troisième dimension :
1.La brosse à cheveux de Wolff est liéeet donne un indice δ^(1/2) en trois dimensions (près de L240) — c’est précisément le point de départ de la Proposition 1.8 « D(1/2, 0) est vraie », et le point de départ de l’ensemble de l’itération dépend de cet indice en trois dimensions. 2.La décomposition des grains de Guthest un outil en trois dimensions ([9], L487, §1.5) ; il n’est pas question dans l’article de savoir s’il existe un équivalent en dimensions supérieures. 3.L’assertion que la plage d’indice σ ∈ [0, 2/3] équivaut à D/E(L302, Proposition 1.6), ce 2/3 vient de la démonstration en trois dimensions de cet article ; comment cette plage varie en dimensions supérieures et si l’itération peut encore fonctionner, ce n’est pas abordé dans l’article.
Donc, strictement parlant :n ≥ 4 est toujours une question ouverte. La méthodologie de l’article peut fournir un modèle pour les travaux futurs, mais ne fournit pas directement de résultats.
L’hypothèse d’extension de la ligne droite de Keleti (Théorème 1.14) et le doublage du tube (Théorème 1.12) ont également été confinés en trois dimensions - c’est un sous-produit spécifique aux trois dimensions, qui ne peut pas être étendu aussi simplement aux n dimensions comme dans le cas de Kakeya.
VII. Critique critique : En quoi cet article est-il remarquable, quelles sont ses difficultés et vaut-il la peine d’être étudié ?
Les avantages :
- Pas de raccourcis. Le programme Katz-Tao a été proposé en 2014 et existe depuis 12 ans. Pendant ce temps, certains ont essayé de « contourner l’étape de la stickiness », mais sans succès. Cet article traite honnêtement de la stickiness ; il s’appuie sur une nouvelle observation (résumée au § 2.4) selon laquelle « si D(σ, ω) est compact, le contre-exemple doit être sticky », ainsi que sur la factorisation de Nikishin-Stein-Pisier pour compléter les ensembles épars. Ma plus grande impression après avoir lu le schéma de preuve du § 2 est que les arguments sont extrêmement bien articulés, chaque étape étant dérivée de la structure précédente, sans « sauts d’inspiration ».
- Lethéorème de structure à plusieurs échelles(Proposition 7.5 du § 7) est un outil indépendant et utilisable. Même si vous ne vous intéressez pas à Kakeya, cette « décomposition en grains à deux échelles + six propriétés » constitue en soi un élément réutilisable dans la théorie de la mesure géométrique.
- Une écriture claire. Dans un article de 127 pages, les 22 premières présentent la structure ; la Définition 1.3 (conditions non concentrées), l’Affirmation 1.5 (D/E), le Théorème 1.2 + le Théorème 1.9 + le Corollaire sont tous présentés au § 1, et le § 2 donne le schéma de preuve. Les § 3 à § 12 ne traitent que des détails. Cette méthode consistant à « présenter d’abord les conclusions, puis la preuve » est nécessaire pour un article de 127 pages.
Quelle est la difficulté ?
- 3 constantes de Wolff + 5 mouvements/propriétés + 7 combinaisons de dimensions de grains, il suffit de se rappeler les noms pour dresser un grand tableau. Le document §3.2 contient un tableau de notations, mais il est facile de s’y perdre lors de la première lecture.
- Lafactorisation de Nikishin-Stein-Pisier(§10.1) est un nouvel outil pour la plupart des lecteurs (y compris moi-même) - il s’agit essentiellement d’une démonstration probabiliste qui « complète les ensembles rares à l’aide de transformations aléatoires de corps rigides », nécessitant une double base en probabilité et en géométrie convexe.
- Les127 pages ne sont pas un gimmick marketing. La « polychotomie à 4 voies » (L884-901, éléments (A)-(D)) du §6 (assertions D et E équivalentes) nécessite le traitement complet des cas (A)-(D), chacun d’entre eux étant l’équivalent d’un chapitre entier. Cette partie est assez éprouvante à lire.
Est-ce que ça vaut la peine de s’y atteler ?
Si vous travaillez en analyse harmonique / géométrie des mesures / équations aux dérivées partielles, cet article est l’un des plus importants de 2025 et vaut vraiment la peine d’être étudié — et il est conseillé de commencer par les esquisses de preuves des sections 1 et 2 (en seulement 22 pages), avant de décider d’approfondir les détails des sections 4 à 12.
Si vous travaillez dans un domaine voisin (ensembles, probabilités), lisez au moins les sections 1 et 1.4 pour comprendre le contexte historique, ainsi que la section 1.6 pour les déductions (14 pages au total), ce qui vous permettra d’avoir une idée de « l’importance des résultats de cette étude ».
Si vous êtes simplement un passionné de mathématiques, j’ai écrit la section 2 de la manière décrite ci-dessus, qui constitue essentiellement l’intrigue principale. Avec huit images pour la parcourir, l’idée centrale sera claire.
8. Résumé en une phrase
La dimension du Kakeya-ensemble tridimensionnel est 3. Cette question a été définitivement résolue au début de 2025 par un article de 127 pages utilisant le théorème de Wolff + la décomposition des ensembles convexes + les grains à deux échelles + les trois mouvements + la factorisation de Nikishin-Stein-Pisier. Un problème de géométrie japonais datant de 108 ans a été résolu par un mathématicien chinois diplômé de l’Université de Pékin en 2011 et un collaborateur de l’Université de la Colombie-Britannique. n ≥ 4 est toujours ouvert, mais la boîte à outils est maintenant prête.
Liste des emplacements des figures annexes :
- fig01(Hang-Gu-Zhuan-Zhi-Problem) correspond à la première moitié de la première section de cet article.
- fig06(What is Dimension) correspond à la seconde moitié de la première section de cet article, où le concept de « dimension » est introduit.
- fig02(Tubes Family and Non-Concentration Condition) correspond à la fin de la troisième section de cet article.
- fig05(Historical Progress of Dimension Lower Bound) correspond à la fin de la deuxième section de cet article.
- fig07(Proof Pipeline Overview) correspond au début de la quatrième section de cet article.
- fig03(Two-Scale Grains Decomposition) correspond à la fin de l’étape 2 de la quatrième section de cet article.
- fig04(Three Moves Process) correspond à la fin de l’étape 3 de la quatrième section de cet article.
- fig08(Sticky vs. Non-Sticky Comparison) correspond au paragraphe final de la section Sticky de la quatrième section de cet article.