Imaginons que vous recrutez un stagiaire pour vous aider à réserver des billets d’avion, à remplir des formulaires et à classer des documents.
Mais vous lui avez imposé une règle : il n’est autorisé qu’à regarder l’écran et à utiliser la souris et le clavier, et il n’est pas autorisé à regarder les interfaces en arrière-plan du logiciel.
Cela peut sembler exigeant. Mais c’est exactement ce que fait l’article « Qwen-CUA : l’utilisation native de l’ordinateur pour (presque) tout », soumis le 4 août 2026 sur arXiv (numéro 2608.02352). Publié conjointement par l’équipe Qwen et le Xlang Lab de l’Université chinoise de Hong Kong, il compte plus de 30 auteurs et le dépôt GitHub est disponible sur xlang-ai/Qwen-CUA.
Aujourd’hui, cet article répond à une question :Les stagiaires formés selon cette règle peuvent-ils vraiment être préparés à travailler ?
Pourquoi faut-il que les règles soient si strictes ?
Si l’on veut travailler dans le monde numérique, il n’y a en fait que trois voies possibles : écrire du code, ajuster des interfaces et utiliser des interfaces graphiques. Les deux premières voies sont déjà très bien maîtrisées par les modèles de données volumineuses de ces dernières années, car elles sont capables de comprendre le texte et de manipuler les outils.
Mais dans la réalité, une grande partie du travail n’est pas effectuée dans les deux premiers domaines. Les logiciels de bureau, les anciens systèmes et les outils professionnels n’affichent que des fonctions sur l’écran, que les machines ne peuvent pas lire. Par conséquent, « ne regarder que l’écran et n’utiliser que la souris et le clavier » n’est pas une forme d’auto-torture, mais la seule façon de pouvoir utiliser tous les logiciels sans exception.
Mais il y a trois gros problèmes sur cette voie :l’état de l’interface n’est visible qu’à moitié, les erreurs s’accumulent et les preuves sont éparpillées dans des dizaines de captures d’écran.Le document 1 Introduction explique très clairement ces trois problèmes. Comment Qwen-CUA a-t-il réussi à franchir chaque étape ? Il faut commencer par les « yeux et les mains ».
Premier niveau : assembler une paire d’yeux et une main.
La section 2.1 du document fournit un équipement minimal aux stagiaires, illustré dans la Figure 2.
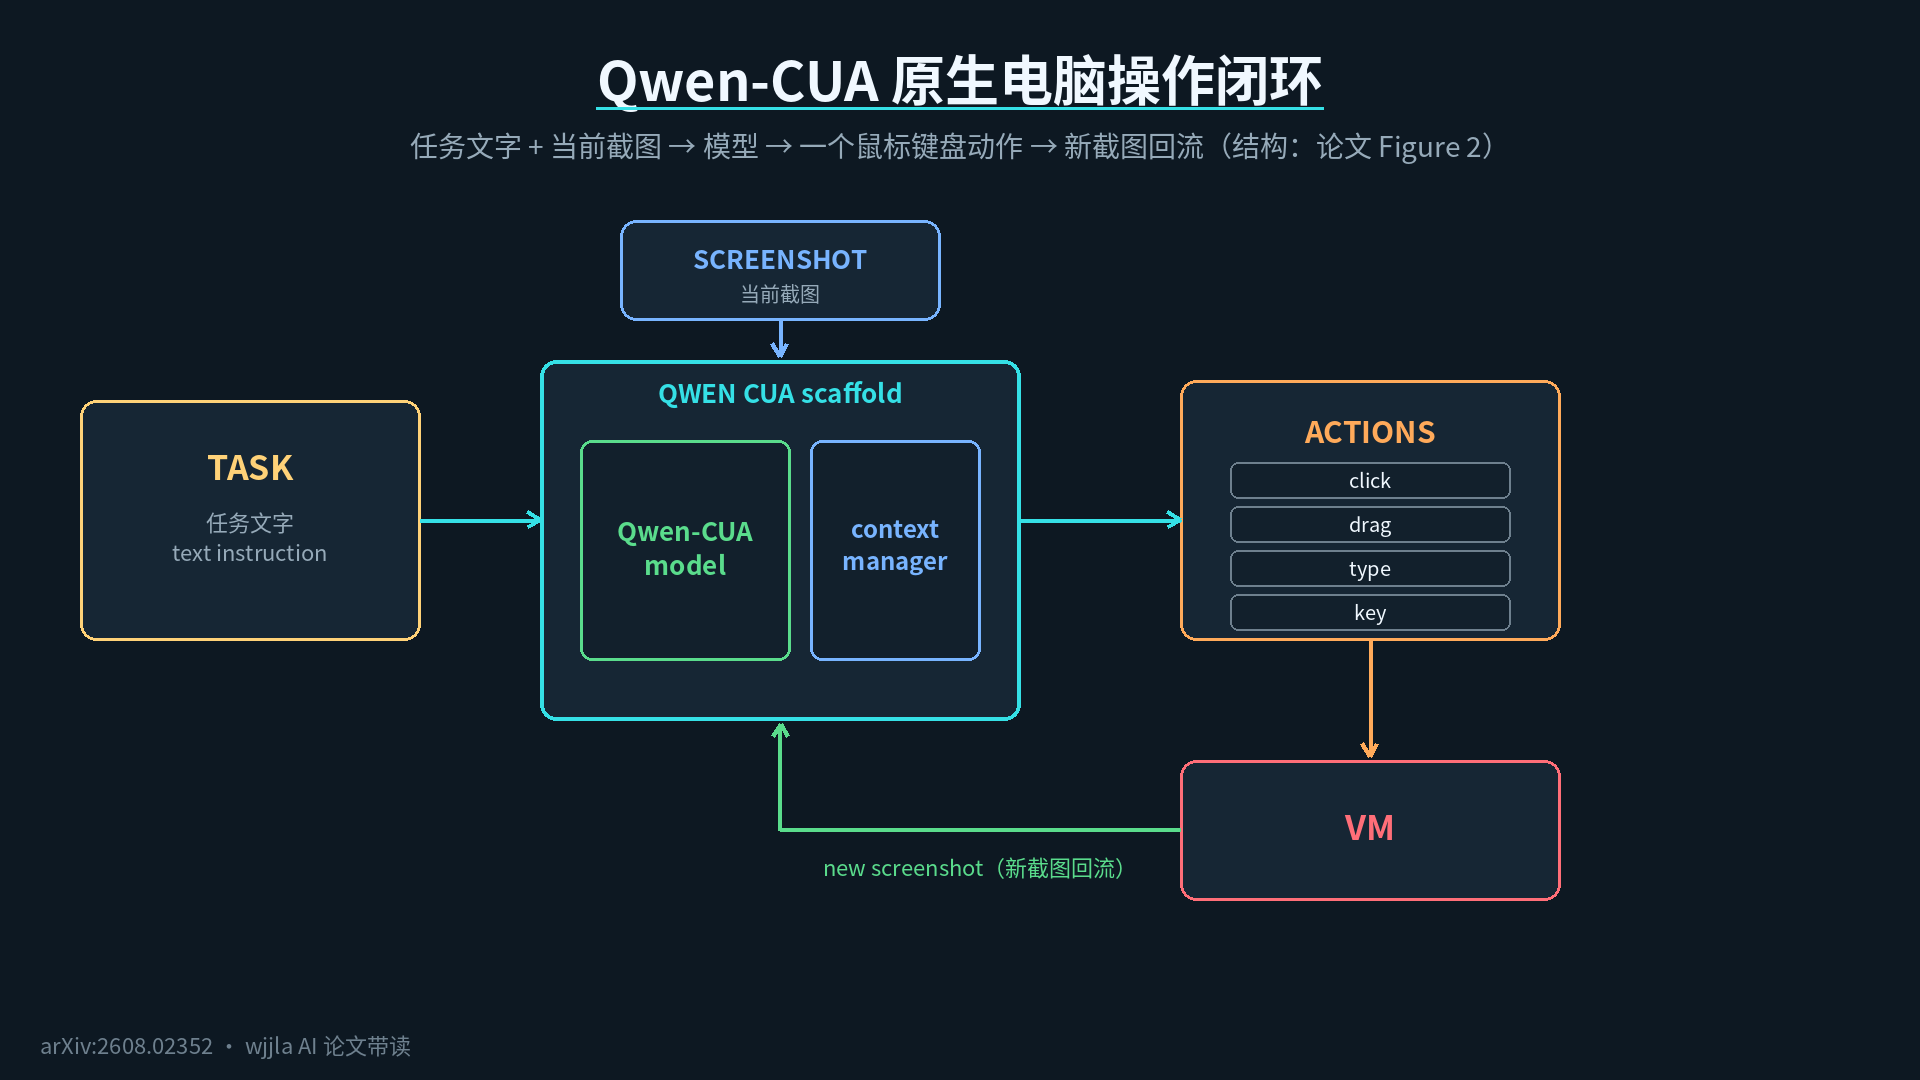
Le cycle de travail complet peut se résumer en une phrase :saisir un texte de tâche, afficher une capture d’écran actuelle et générer un mouvement de souris et de clavier.Les mouvements se répartissent en trois catégories : souris (déplacement, clic gauche/droit/central, double-clic et triple-clic, glisser-déposer, défilement), clavier (combinaison de touches, appui/relâchement, saisie de texte) et contrôle (capture d’écran, attente, interruption, appel à l’utilisateur). L’annexe A présente la liste complète des mouvements.
Il y a quelque chose appelé « échafaudage » au milieu. Vous pouvez le considérer comme un coordinateur sur le poste de travail : attribuez des tâches au modèle, fournissez des captures d’écran, exécutez des actions sur la machine virtuelle, puis récupérez de nouvelles captures d’écran. Vous n’avez pas besoin de vous soucier des détails internes ; faites une chose à la fois à chaque tour.
Il y a une phrase dans l’article que je dois traduire en langage clair :Cet équipement peut être utilisé sur tous les navigateurs et toutes les applications de bureau sans modifier une seule ligne de configuration.Il n’utilise pas d’arbre DOM, ni de métadonnées d’accessibilité, ni aucune API spécialisée. C’est juste un « œil humain + une main humaine » standard.
Trouver la bonne paire de lunettes et la bonne taille de gants n’est que la première étape. Le vrai problème est que, une fois le travail commencé, ils n’arrivent plus à se rappeler quoi que ce soit.
Deuxième niveau : Si vous n’avez pas une bonne mémoire, les mémos peuvent vous aider.
Le point 2.2 traite du problème de mémoire.
Les tâches longues peuvent générer des dizaines ou des centaines de captures d’écran, qui sont toutes stockées dans la mémoire à court terme du cerveau, qui ne peut en contenir qu’un nombre limité. L’approche de Qwen-CUA est similaire à celle d’un bloc-notes :
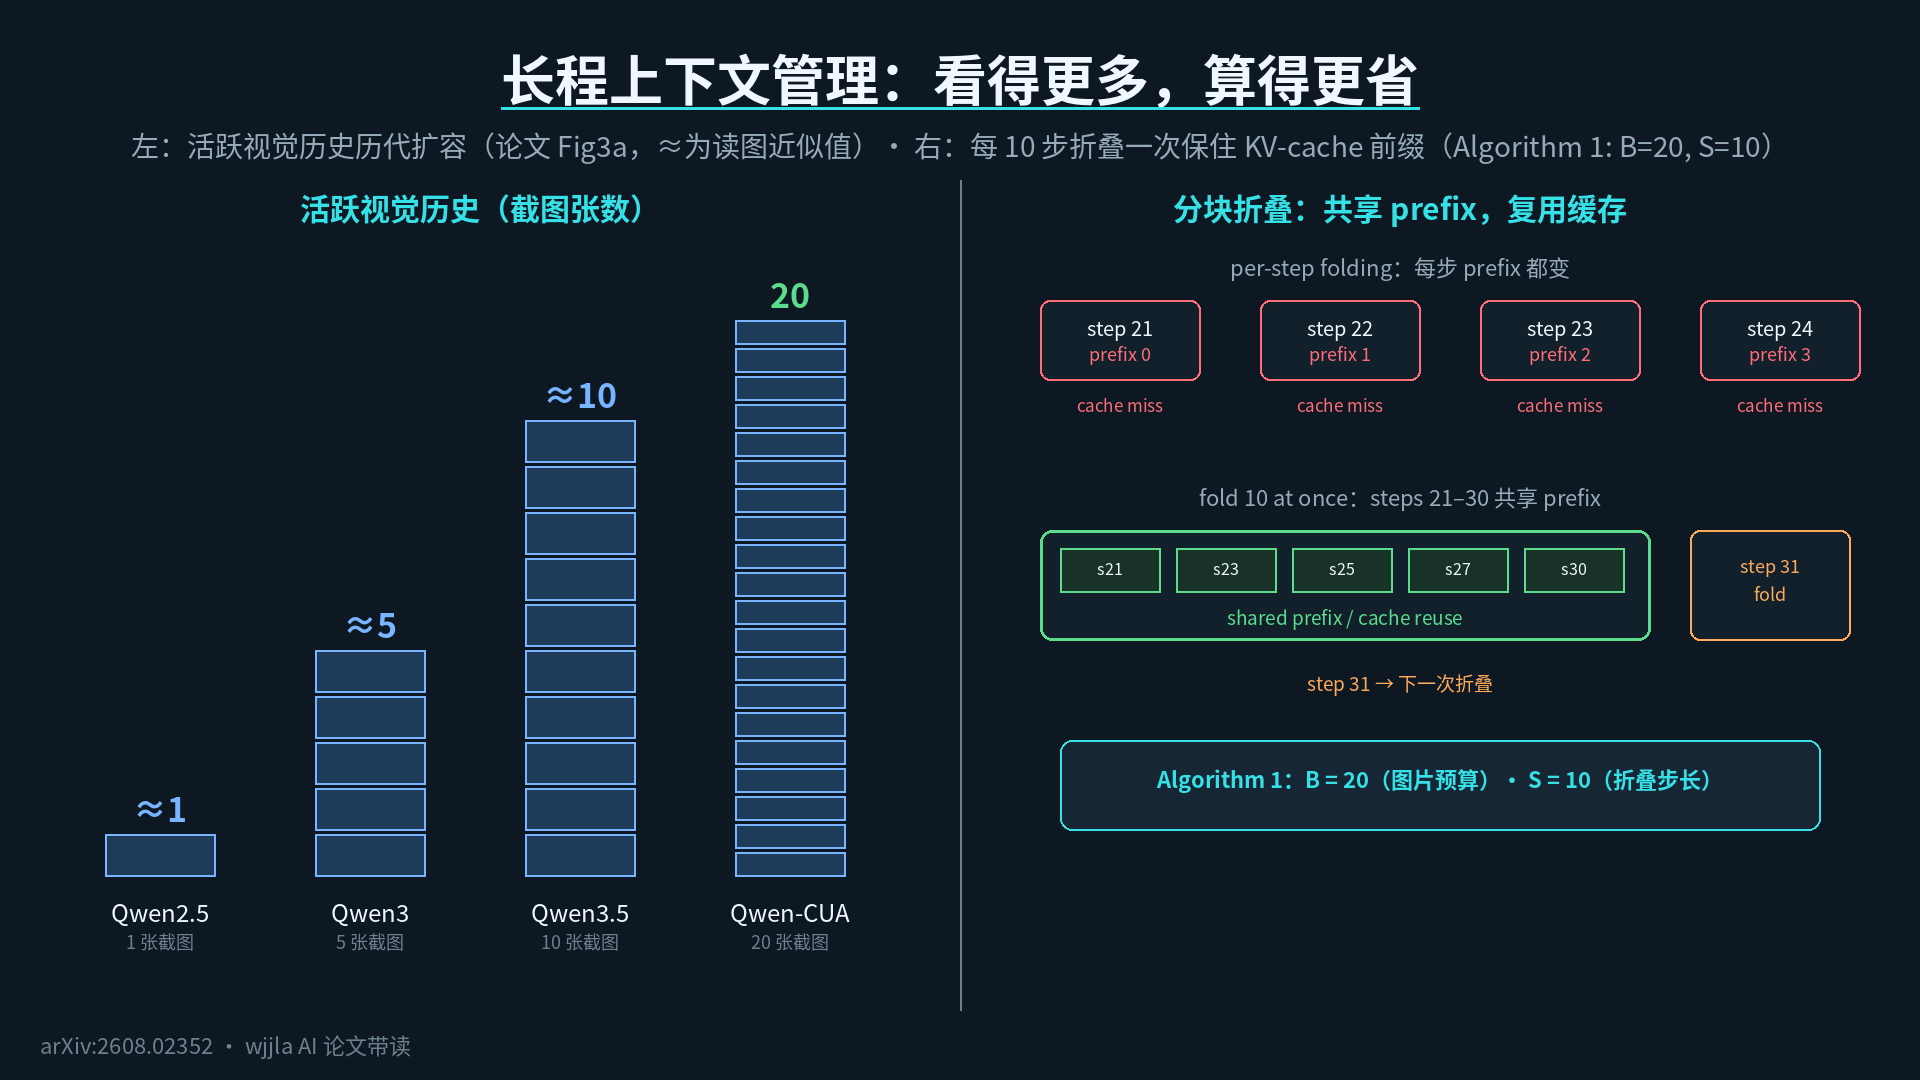
- Un historique visuel actif de 20 captures d’écran maximum. Les 20 dernières sont affichées sur la table pour être consultées à tout moment.
- Chaque fois que vous atteignez les 10 captures d’écran, repliez-les vers l’avant. Plier les captures d’écran ne signifie pas les jeter, mais les remplacer par un texte récapitulatif : « Il y avait ici une capture d’écran, qui a été réalisée lorsque j’ai fait X », mais l’action effectuée et la réflexion de l’époque restent toutes dans le contexte.
La Figure 3(a) montre que le « dessus de table » de Qwen s’est agrandi au fil des générations : Qwen2.5 ne prend qu’une seule feuille, Qwen3 en prend cinq, Qwen3.5 en prend dix, et Qwen-CUA va directement jusqu’à vingt. La Figure 3(b) compare deux méthodes de pliage : soit réordonner à chaque étape (le préfixe change constamment), soit ne le faire qu’une fois tous les dix étapes – dans ce dernier cas, le préfixe est partagé et le cache KV est réutilisé directement, ce qui permet d’économiser de la puissance de calcul.
Il y a également un détail de formation : l’apprentissage par renforcement utilise le même opérateur de repliement. Une longue trajectoire est découpée en plusieurs tranches délimitées par un contexte, chaque tranche héritant de la même récompense de fin. De cette façon, il n’est pas nécessaire d’attribuer manuellement des récompenses aux étapes intermédiaires, et les signaux de supervision peuvent être transmis de l’état final aux décisions intermédiaires.
Les yeux, les mains et le bloc-notes sont prêts – passons maintenant à la question centrale :comment cet apprenti est-il devenu si compétent ?
Troisième étape : comment s’entraîner - Construisez d’abord une “auto-école” de 100 000 cœurs.
Le plus difficile lors de l’entraînement d’un agent intelligent à utiliser un ordinateur n’est pas le modèle, mais plutôt le fait qu’il doit avoir un endroit où il peut essayer et échouer à plusieurs reprises.
L’auteur a simplement créé une « auto-école », hébergée sur Alibaba Cloud ECS, avecprès de 100 000 cœurs de CPU virtuelsetpouvant déployer des dizaines de milliers d’environnements simultanés. Chaque ordinateur virtuel est un poste de travail indépendant, qu’il peut utiliser comme il le souhaite.
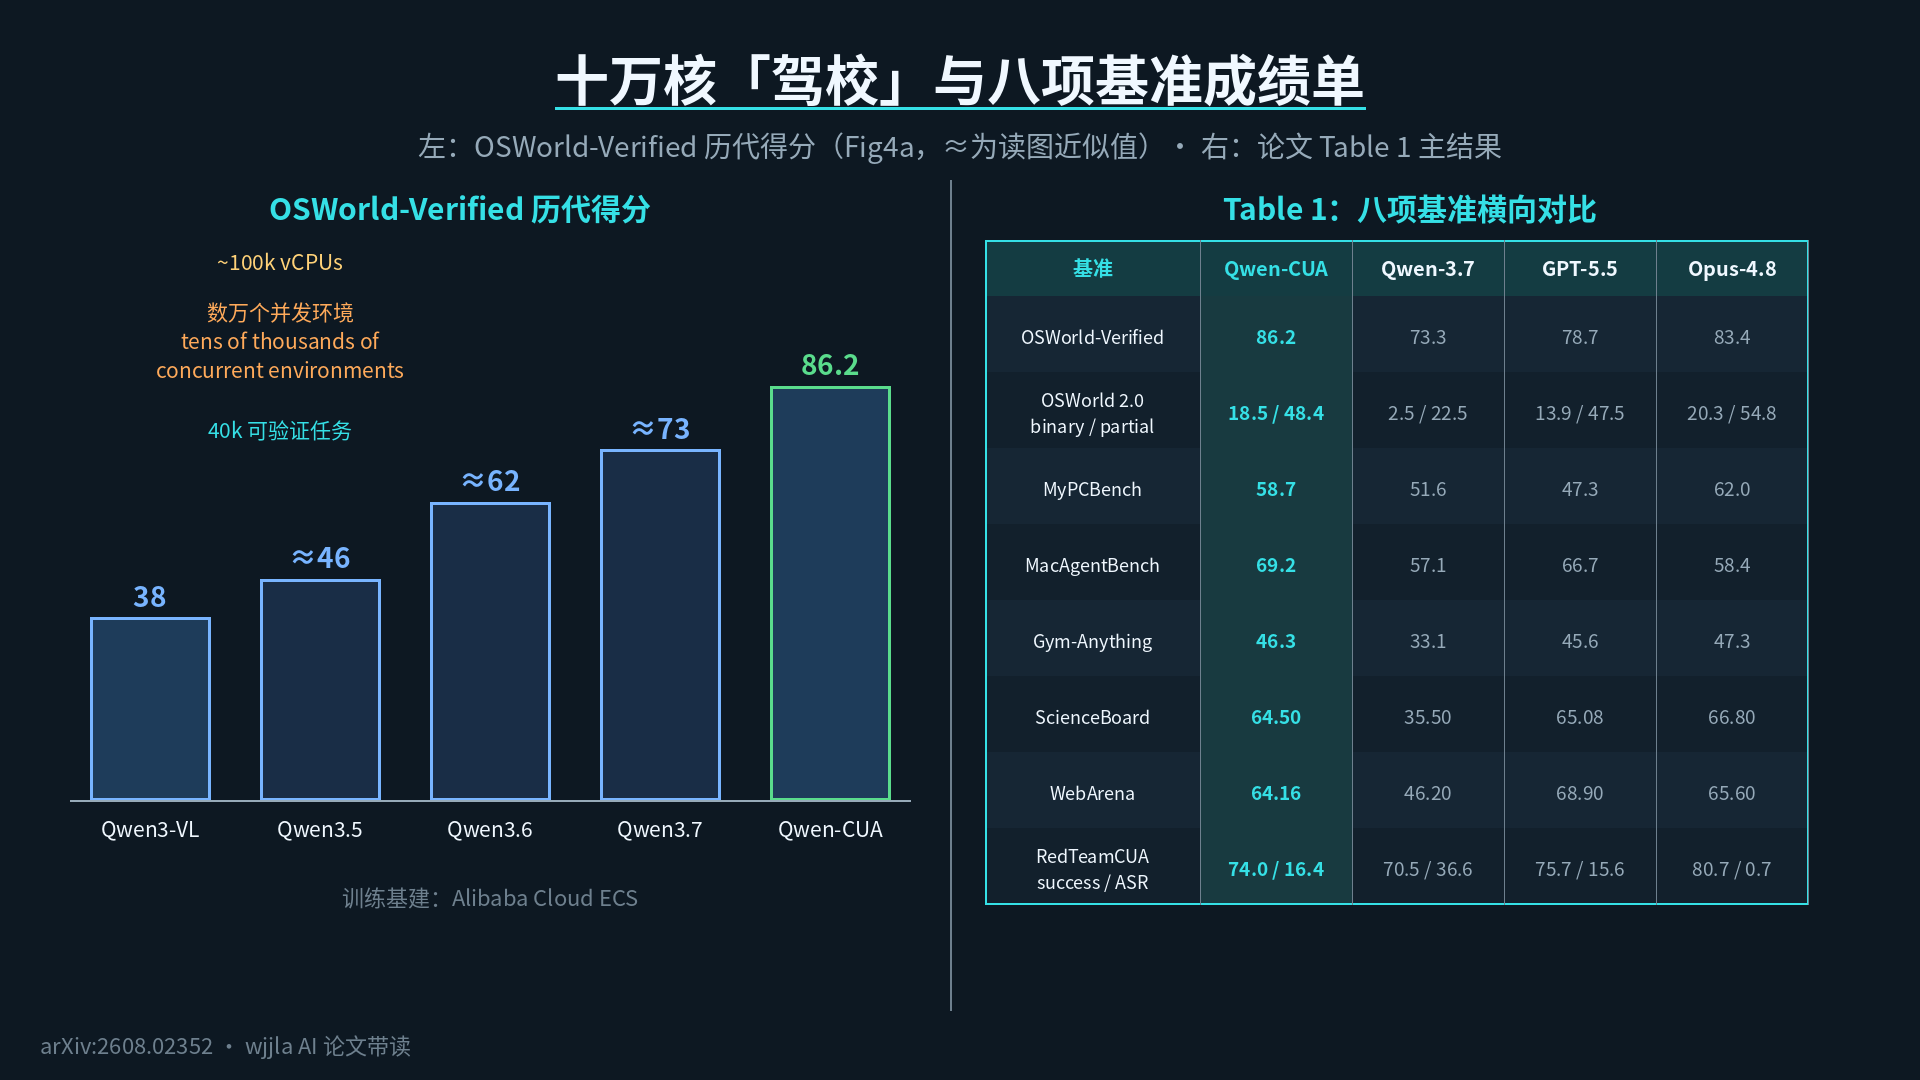
La Figure 4(a) est très parlante : les scores de Qwen sur OSWorld-Verified au fil des générations, passant de 38 pour Qwen3-VL à 46 pour Qwen3.5, 62 pour Qwen3.6, 73 pour Qwen3.7, et enfin 86,2 pour Qwen-CUA. Trois jalons sont également indiqués sur le graphique :environ 40 000 tâches vérifiables, environ 100 000 vCPU et des dizaines de milliers d’environnements concurrents.
Les auto-écoles et les examens sont en place, mais où se trouvent les manuels ? C’est la prochaine étape.
Quatrième étape : manuels scolaires - trois types d’exercices et un type d’enseignement par un professeur.
Les manuels scolaires sont divisés en trois types d’exercices, plus un type « mentorat », et je vous aiderai à les compiler en un horaire de cours :
- Questions d’interaction avec l’environnement(première catégorie) - Apprendre à reconnaître les boutons, les menus et les changements d’état dans le logiciel.
- Questions d’interaction avec l’utilisateur(deuxième catégorie) - Décrire la tâche de manière incomplète pour voir si l’utilisateur prend l’initiative de poser des questions. Cette série de questions utilise l’idée de « simuler un utilisateur » d’OSWorld 2.0 : le simulateur d’utilisateur ne répond que lorsque l’utilisateur pose une question.
- Questions de long processus(troisième catégorie) - Diviser une tâche complexe en petites étapes pouvant être notées automatiquement. C’est comme un relais où chaque étape a un état final vérifiable, et une fois cette étape terminée, l’état est sérialisé et sert de point de départ à l’étape suivante. Cette technique est appelée « chaînage d’états par phases », qui est expliquée en détail dans la section 3.2 du document.
- Formation avec un tuteur humain(quatrième catégorie) - Demander à une personne réelle d’effectuer une tâche réelle sur son ordinateur : réserver un billet d’avion, remplir un formulaire, utiliser AutoCAD ou Blender. Le modèle ajoute ensuite un « monologue intérieur » (chaîne de pensée) à chaque étape et filtre les réponses en fonction de deux critères : qu’elles correspondent aux captures d’écran et aux actions effectuées par la personne réelle.
Les quatre catégories réunies constituent l’ensemble du matériel pédagogique de l’auto-école.Mais pour entraîner un agent intelligent à effectuer des opérations informatiques, le plus rare n’est pas les données, mais un algorithme capable de commettre des erreurs et de s’améliorer en apprenant de ces erreurs.
Le cinquième niveau : la méthode du coach - Gagner des points en faisant des essais et des erreurs
Le paragraphe 3.3 traite de l’apprentissage par renforcement, et l’algorithme s’appelle SAPO, qui signifie Soft Adaptive Policy Optimization. Il n’est pas nécessaire de mémoriser le nom, il suffit de savoir que c’est l’une des dernières méthodes d’entraînement qui consiste à « pénaliser les erreurs et récompenser les bonnes réponses ».
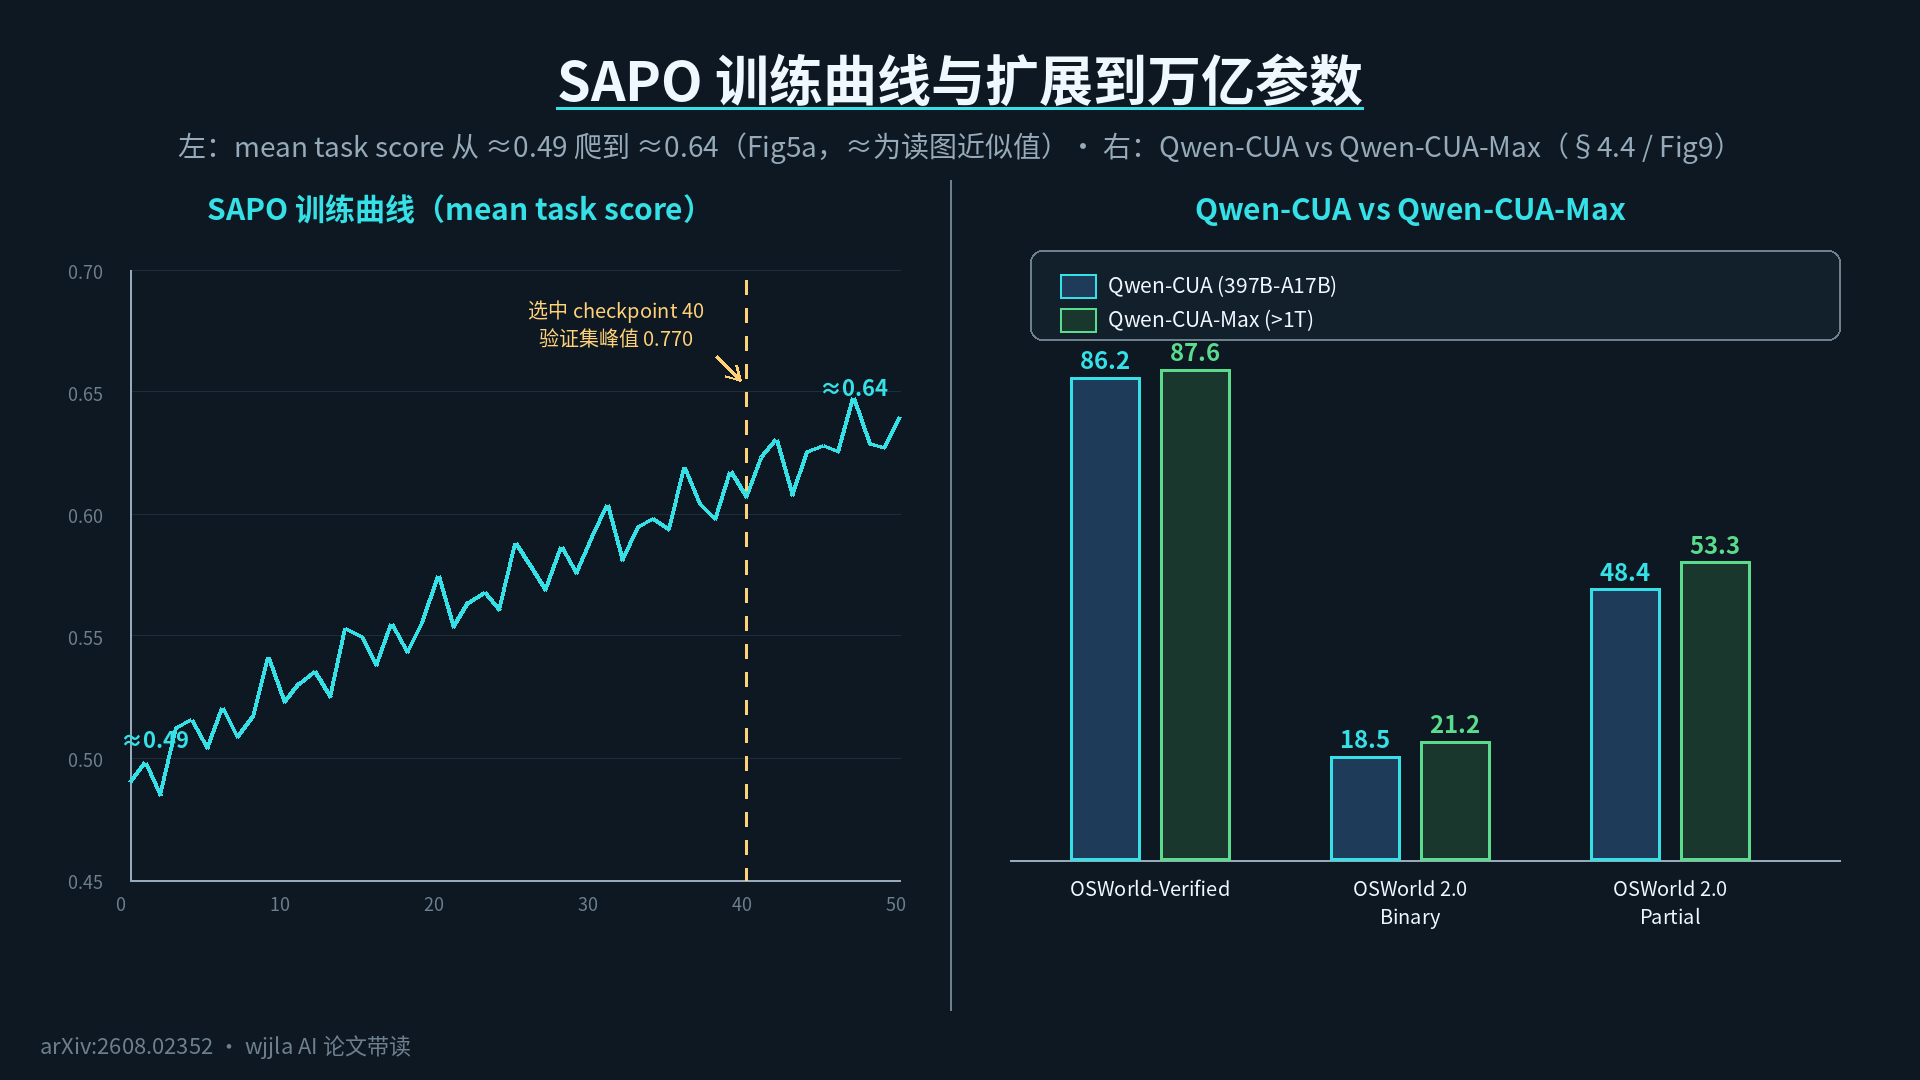
La Figure 5 est une courbe d’entraînement. Nous allons simplement observer la tendance :
- Lescore de formationest passé de 0,49 au départ à 0,64, avec des fluctuations intermédiaires, car chaque lot de questions d’examen est différent.
- Lescore de validation croiséeest passé de 0,734 avant l’apprentissage par renforcement à un pic de 0,770 aupoint de contrôle 40 (c’est-à-dire la 800e mise à jour), et l’auteur a choisi cette version comme modèle final. L’ensemble de la formation a atteint le nombre maximum de 1000 mises à jour, et au point de contrôle 50, le score était de 0,762.
Le paragraphe 3.4 explique également la logique de l’entraînement itératif :à chaque tour, utiliser le dernier modèle pour révéler de nouveaux problèmes, ajouter de nouvelles questions et entraîner le modèle pour le tour suivant. La procédure est en deux étapes : la première consiste à faire exécuter le dernier modèle sur les questions SFT existantes et à compter celles qu’il ne peut pas résoudre - ces questions sont recréées en utilisant la stratégie de l’enseignant. La deuxième étape consiste à effectuer un « filtrage de difficulté » sur les questions candidates de l’apprentissage par renforcement : huit essais de déploiement sont effectués, et les questions qui ne sont pas réussies (trop difficiles) et celles qui ont été réussies huit fois (trop faciles) sont éliminées, ne laissant que celles qui se situent au milieu. Cette logique de « sélection automatique des questions » permet à l’entraînement de rester toujours à la pointe.
À ce stade, les stagiaires sont prêts à passer l’examen final et à entrer dans le monde professionnel.
Le sixième niveau : les résultats des huit examens majeurs.
Il y a un total de huit projets dans la salle d’examen, et le tableau 1 du mémoire est le principal bulletin de notes.
Le test le plus important s’appelleOSWorld-Verified: Qwen-CUA a obtenu un score de 86,2, tandis que son prédécesseur Qwen3.7 avait obtenu un score de 73,3. Il y avait également des concurrents propriétaires : GPT-5.5 a obtenu un score de 78,7 et Claude Opus 4.8 a obtenu un score de 83,4. Parmi les huit tests, Qwen-CUA a obtenu les scores les plus élevés dans OSWorld-Verified et MacAgentBench (69,2), tandis que dans les autres tests, il s’est mesuré de manière serrée avec les concurrents propriétaires - par exemple, sur OSWorld 2.0 et RedTeamCUA, Opus 4.8 l’a toujours devancé.
Lelong test OSWorld 2.0le plus difficile : Qwen-CUA a obtenu untaux de réussite binaire de 18,5 + un taux de réussite partielle de 48,4, distançant de loin les scores précédents de 2,5 et 22,5 — le taux de réussite binaire a presque été multiplié par 7.
La Figure 1 présente un graphique à barres des résultats de huit examens. Le groupe de couleur la plus foncée est Qwen-CUA-Max, qui sera expliqué séparément plus loin.
Rappelez-vous une chose : pour les huit projets, il a tous dépassé son prédécesseur.
Mais ne vous précipitez pas pour applaudir - est-ce qu’il a peut-être réussi grâce au fait qu’il réfléchit longtemps et parle beaucoup ?
Le septième niveau : Y a-t-il de la tricherie dans les notes ? - Vérification de l’efficacité.
Cette question est très pertinente, et la section 4.1 de l’article est consacrée à une analyse de l’efficacité pour y répondre, présentée dans la Figure 6.
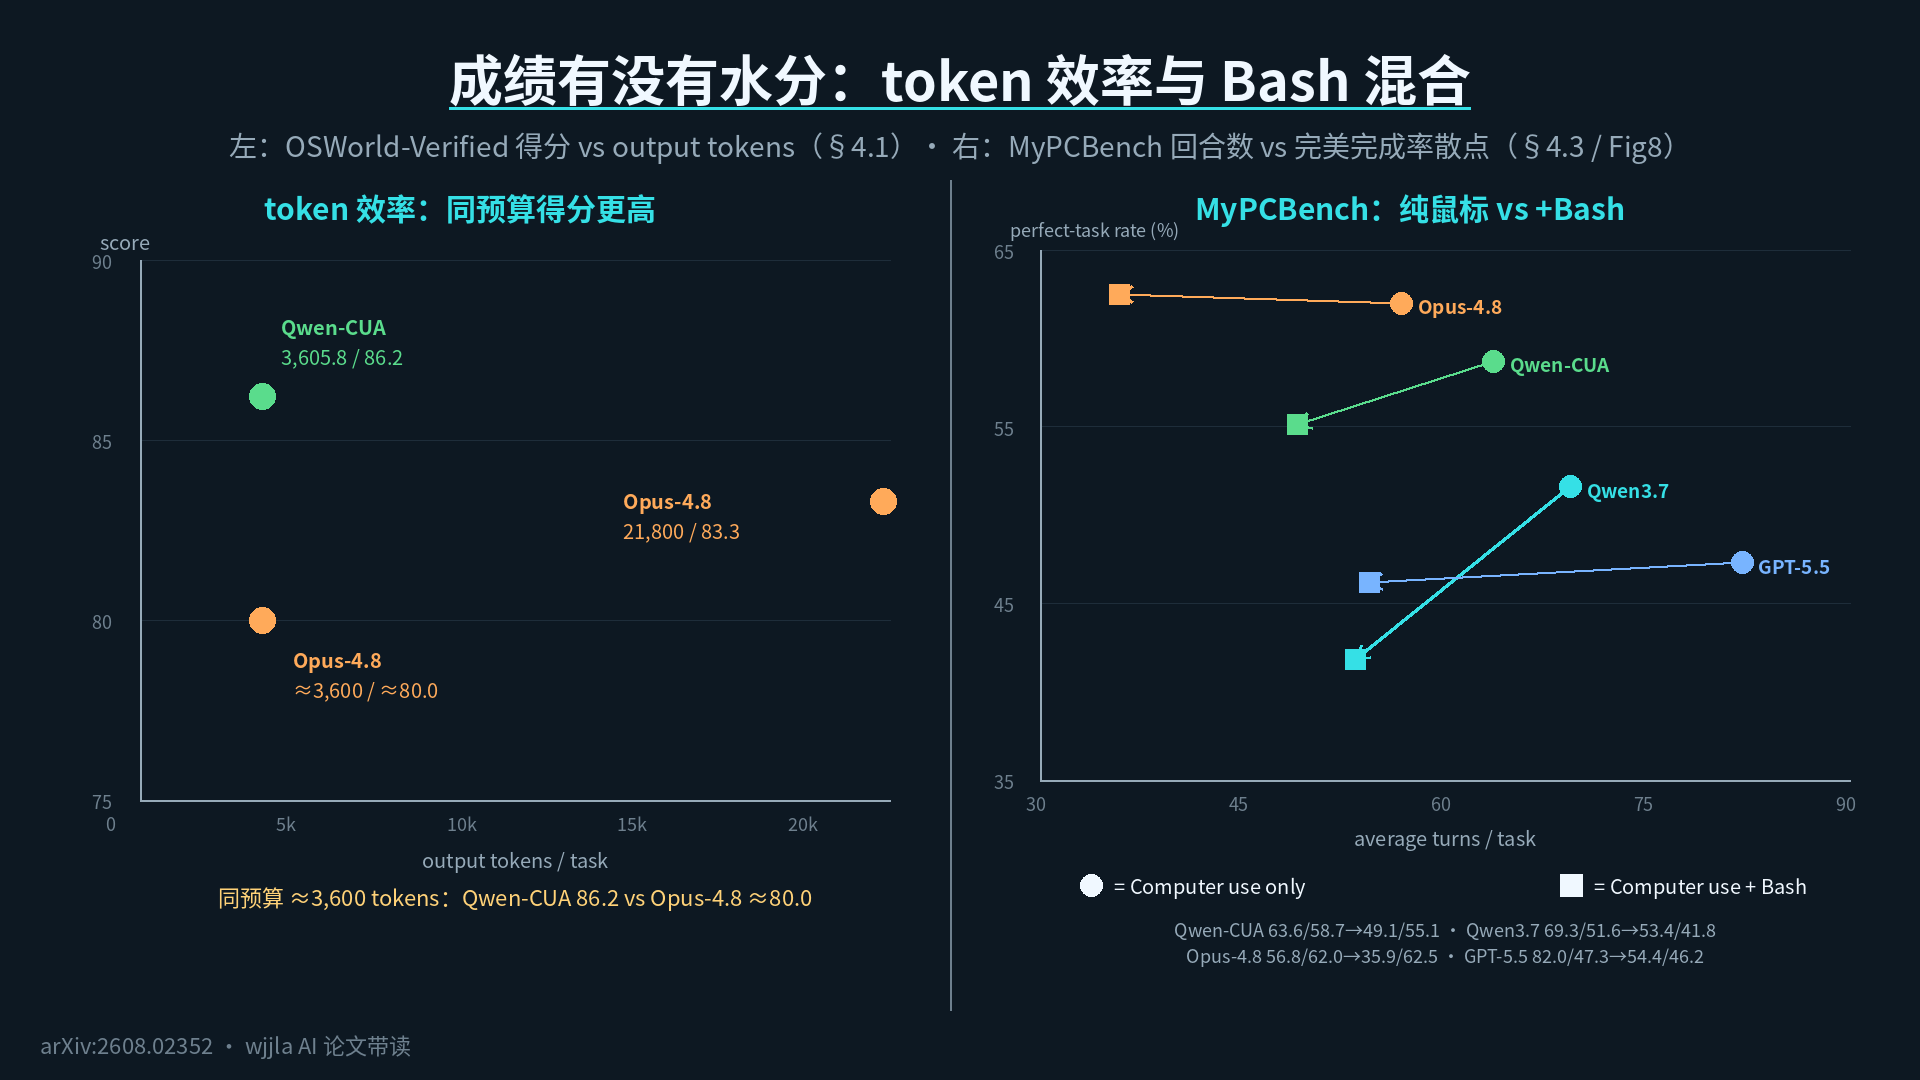
L’image de gauche montre l’efficacité des jetons.L’axe horizontal est le nombre de mots produits par le modèle pour chaque question, et l’axe vertical est le score OSWorld-Verified. Qwen-CUA a obtenu un score de 86,2 en utilisant seulement3 605,8 jetons de sortie. Avec le même budget, Claude Opus 4.8 n’a obtenu qu’un score de 80,0 ; Opus 4.8 a dû utiliser 21 800 jetons pour obtenir un score de 83,3. L’amélioration de Qwen-CUA ne vient pas de la « répétition ».
L’image de droite montre l’efficacité des interactions.L’axe horizontal représente le nombre de tours, et Qwen-CUA sur OSWorld 2.0 a une moyenne de218,9 tourspar question, ce qui est bien supérieur aux 83,5 de GPT-5.5. Cependant, l’auteur tient à préciser que les systèmes fermés peuvent exécuter plusieurs actions par tour, tandis que Qwen-CUA n’en exécute qu’une par tour. Par conséquent, la différence de nombre de tours est due à la granularité de l’interface et non au fait que Qwen-CUA soit « moins performant ».
L’efficacité est importante. Mais être capable de travailler n’est pas suffisant - peut-on compter sur quelqu’un quand il travaille ?
Le huitième niveau : Peut-on lui faire confiance ? - Test anti-phishing
Il y a un piège particulier avec les interfaces informatiques :le contenu de l’écran peut être un leurre délibérément mis en place par des personnes malintentionnées.Par exemple, un faux bouton « Obtenez une subvention » sur une page web peut en réalité permettre un transfert d’argent.
Le benchmark RedTeamCUA est spécialement conçu pour cela, en examinant deux chiffres : le travail effectué et les cas d’escroquerie. Les deux indicateurs de Qwen-CUA se sont améliorés :
- Letaux de réussite des missionsest passé de 70,5 à74,0pour Qwen3.7 ;
- Letaux de réussite des attaques (ASR)est passé de 36,6 à 16,4, soit une baisse de 20,2 points de pourcentage.
Un rare double avantage : travailler mieux et être moins susceptible d’être victime d’escroqueries. Cette amélioration est cohérente sur trois plateformes : le cloud personnel, la messagerie instantanée et Reddit (Tableau 2).
Cependant, l’auteur est honnête :l’ASR de 16,4 reste un risque résiduel, et non une garantie de sécurité.Sur Rocket.Chat, il faut regarder l’ASR en même temps que le taux de réussite des tâches – certains échecs sont dus à des blocages, et non à la détection d’escroqueries.
Après avoir montré sa performance dans la salle d’examen, peut-on aussi bien performer dans le monde réel d’Internet après avoir quitté la salle d’examen ?
En pratique : le véritable plug-in Qwen pour Chrome.
4.2. Après avoir quitté la salle d’examen, j’ai accédé à Internet réel. La Figure 7 est une capture d’écran du navigateur : un nouveau volet Qwen est apparu sur le côté droit de l’écran. Il s’agit deQwen pour Chrome, un plug-in interne de Chrome.
Il fonctionne sur le site Web réel et vous montre chaque étape du processus, sans aucune opération secrète. Pour lesopérations critiquestelles que le paiement ou la suppression de fichiers, une fenêtre contextuelle vous demande de confirmer avant de procéder.
L’annexe E contient également un cas de bout en bout : demander à l’agent d’acheter lui-même un serveur cloud dans un navigateur, de configurer l’environnement et de cliquer sur les boutons pour effectuer l’opération. L’intérêt de cette démarche est qu’il ne s’agit pas de répondre à un questionnaire, mais de travailler dans le monde réel.
Mais dans le monde du travail réel, est-ce que savoir utiliser une souris suffit ? Les anciens programmeurs le savent bien : il y a aussi la ligne de commande.
Le neuvième niveau : Devrais-je lui donner une ligne de commande ? — Une surprise avec Bash.
Le paragraphe 4.3 pose une question pertinente : au-delà de la souris et du clavier, faut-il activer Bash pour l’agent ?
La réponse est :Avec Bash, le chemin vers le succès est plus court, mais le taux de réussite est un peu plus faible.
La Figure 8 de l’article est clairement représentée sous forme de diagramme de dispersion (remarque : un diagramme de dispersion, pas un diagramme à barres) :
- Avec Bash, lenombre moyen de tours de MyPCBench de Qwen-CUA est passé de 63,6 à 49,1;
- mais letaux de réussite parfait est passé de 58,7 à 55,1.
Qwen3.7 suit la même tendance : 69,3 → 53,4 tours, 51,6 → 41,8 taux d’achèvement.
L’auteur explique que**ce n’est pas que la ligne de commande ne devrait pas être utilisée, mais que le modèle n’a pas encore appris « quand il faut passer à autre chose **».Bash offre une solution plus simple, mais des changements inutiles ou malvenus peuvent nuire à la précision. L’auteur classe cela comme un « problème d’optimisation », et non comme une « limite des interfaces mixtes », et affirme clairement que « dans le futur, l’entraînement conjoint et la supervision explicite du routage des outils permettront de retrouver la précision tout en conservant l’efficacité ».
C’est un rappel très important :la richesse de l’interface n’équivaut pas à la maturité de l’utilisation.
Le dixième niveau : Trouver un cerveau plus grand - Qwen-CUA-Max
4.4 Changer de voie : Amplifier directement le 397B-A17B jusqu’àplus de 100 milliards de paramètres, et le nommerQwen-CUA-Max. Avec la même méthode de culture, nourrir un cerveau plus grand.
Résultat :
- OSWorld-Verified : 86,2 → 87,6;
- Taux d’achèvement binaire d’OSWorld 2.0 : 18,5 → 21,2;
- Taux d’achèvement partiel d’OSWorld 2.0 : 48,4 → 53,3(la plus grande amélioration).
En d’autres termes, cette formule de formation n’est pas dépassée - en ajoutant davantage de paramètres, on peut continuer à améliorer les scores.
Nous avons abordé les sujets de la salle d’examen, de la pratique, de l’équipement et de la version améliorée. Revenons à la question initiale.
Quelques points qui, après les avoir lus, méritent d’être rappelés.
Premièrement, l’approche « seulement pour l’écran » est possible, mais lente et coûteuse. L’approche par pixels est naturellement plus lente que l’approche par DOM : à chaque étape, il faut renvoyer la capture d’écran au modèle pour un nouveau traitement, et chaque traitement prend de quelques dizaines à quelques centaines de millisecondes. La conclusion de l’article admet : « L’universalité n’implique pas l’optimisation ». La plus grande valeur de cette approche est sa universalité — elle peut traiter les logiciels de bureau, les pages web dynamiques et les outils professionnels, plutôt que la vitesse. Si votre travail peut être effectué dans le code ou via une API, cette approche est moins coûteuse.
Deuxièmement,le taux de tromperie de 16,4 % n’est pas nul. Le fait que Qwen-CUA de RedTeam CUA ait réduit le taux de réussite des attaques de 36,6 % à 16,4 % constitue une amélioration considérable, mais cela signifie néanmoins que dans 100 cas où un « appât est affiché à l’écran », 16 agents seront trompés. Ces chiffres doivent être pris en compte dans le déploiement en entreprise ; c’est la raison pour laquelle Qwen pour Chrome est conçu pour « confirmer les opérations critiques par une fenêtre contextuelle », non pas pour impressionner techniquement, mais parce que c’est vraiment nécessaire.
Troisièmement,Bash a perdu des points en raison de sa complexité et c’est un avertissement pour l’ensemble de la communauté des outils d’IA. Le fait d’avoir « plus d’outils à ajuster » n’équivaut pas à « de meilleurs résultats ». Qwen-CUA n’a pas encore appris quand utiliser tel ou tel outil, et c’est le prochain défi majeur de l’apprentissage par renforcement hybride humain (RLHF) et de l’apprentissage par renforcement agentique (agentic RL). Le document ne présente pas cela comme un résultat, mais indique simplement « un écart d’optimisation », et cette honnêteté mérite d’être saluée par les collègues chercheurs.
Quatrièmement,les plug-ins internes ne sont pas accessibles au public. Qwen pour Chrome est utilisé en interne au sein de l’équipe et aucune date de téléchargement n’a été annoncée dans l’article. Il s’agit d’une limitation non abordée dans l’article : même si le modèle est très performant, s’il n’est pas mis à la disposition des développeurs, son impact restera limité au nombre de publications dans les articles scientifiques. Pour les lecteurs qui se demandent « peut-on l’utiliser aujourd’hui », l’article fournit une référence pour la limite des capacités, mais non un calendrier de lancement du produit.
Cinquièmement,le modèle Max avec des paramètres de 1 To n’est qu’une mention en passant. Le document ne consacre pas de chapitre distinct à l’analyse des coûts de formation, des délais d’inférence ou de l’écart entre Max et la version de base. D’un point de vue technique, un modèle de 1 To est une « petite amélioration » de l’ère des modèles géants, mais les coûts de formation de l’apprentissage par renforcement, l’occupation du cache KV et la pression sur la mémoire vidéo pour l’inférence de longues trajectoires ne sont pas précisés. Pour reproduire les résultats de Max, les informations fournies dans le document ne sont pas suffisantes.
Résumé en une phrase
Lorsque l’on limite l’IA à regarder l’écran et à utiliser la souris et le clavier, elle peut effectivement apprendre à travailler - elle dépasse globalement les huit critères de référence et rivalise avec les meilleurs systèmes propriétaires. Cependant, être capable d’apprendre ne signifie pas être prêt à l’utiliser : le taux de tromperie de 16,4 % persiste, la méthode des pixels est coûteuse et lente, et l’utilisation mixte des outils n’est pas toujours appropriée. Qwen-CUA ne propose pas une solution définitive, mais une démonstration concrète de l’idée d’une « couche visuelle universelle » en tant que composant de base des agents hybrides.
Article : Qwen-CUA : l’utilisation native de l’ordinateur pour (presque) tout arXiv : https://arxiv.org/abs/2608.02352 Page d’accueil du projet : https://github.com/xlang-ai/Qwen-CUA