À deux heures du matin, vous n’arrivez pas à dormir, vous avez des choses en tête et vous ouvrez ChatGPT.
Ne vous considérez pas comme une minorité - chaque nuit, des millions de personnes dans le monde font la même chose. L’IA ne se repose pas, ne facture pas et ne vous rejette pas. Il est donc naturel qu’elle soit considérée comme un confident, un conseiller relationnel et même un thérapeute psychologique temporaire. D’un autre côté, les chiffres sont froids : dans le monde, il n’y a que 13 travailleurs de la santé mentale pour 100 000 personnes, et les médecins humains ne suffisent pas pour tout le monde.
Le problème est le suivant : ces IA n’ont pas de licence de pratique médicale et personne n’a jamais vérifié leur performance en cas de crise émotionnelle selon des normes cliniques. Pourraient-elles faire plus de mal que de bien ? Et quel type de mal ? Est-ce que parler de plus en plus peut être dangereux ? Personne n’a donné de réponse fiable.
En février 2026, Weilnhammer et Matthew Nour de l’Université d’Oxford (ainsi que Microsoft AI) ont collaboré avec UCL, l’Université de Sydney et l’Institut britannique de sécurité en IA pour mener une étude officielle (arXiv 2602.01347) : faire en sorte que l’IA joue le rôle de patient standardisé et discute avec neuf robots de chat principaux, puis faire évaluer les résultats par une troisième IA en tant qu’examinateur clinique. Le cadre s’appelle SIM-VAIL. C’est la première fois que l’on procède à un examen physique formel d’un « psychologue IA », et les conclusions du rapport d’examen sont bien plus importantes que le classement lui-même.
- Pour effectuer un examen médical de l’IA, il faut d’abord résoudre la question “comment la tester”.
Vous pourriez penser : n’y a-t-il pas déjà eu diverses évaluations pour déterminer si l’IA est sûre ? Oui, mais aucune n’a été efficace.
Dans le passé, il n’existait que deux approches dans ce domaine. La première est l’évaluation unilatérale de type banque de questions : on donne à l’IA une phrase comme « Que faire si je veux me suicider » et on voit si elle répond correctement. Le problème est que le modèle est entraîné à plusieurs reprises sur cette question, et les scores sont bons, mais si on lui pose la même question plusieurs fois, il triche et donne la même réponse. L’autre approche est l’équipe rouge manuelle : les évaluateurs pensent à des questions difficiles. Les angles qu’ils peuvent penser sont très ingénieux, mais ils ne peuvent pas être reproduits ni standardisés, et ils ne correspondent pas du tout à la façon dont les utilisateurs réels posent des questions.
Plus grave encore, ces deux méthodes ne prennent en compte que les dommages évidents – si l’IA incite à l’automutilation ou prescrit des médicaments de manière aléatoire. Elles négligent un type de dommage beaucoup plus insidieux :les réponses de l’IA qui semblent douces et encourageantes peuvent renforcer en douce les mécanismes psychologiques qui vous rendent malade. Personne n’a encore testé cela en utilisant des systèmes cliniques standard.
La solution de SIM-VAIL consiste à transposer la méthode utilisée par les écoles de médecine pour former les médecins.
II. Trois IA jouent un rôle dans un scénario : le patient, le médecin et le surveillant d’examen.
Comment les écoles de médecine forment-elles les futurs médecins ? En utilisant des « patients standardisés » : des personnes formées pour jouer le rôle de patients et tester les compétences des étudiants en matière d’entretiens médicaux. SIM-VAIL a entièrement automatisé ce processus, avec trois rôles dans une même simulation, tous joués par l’IA.
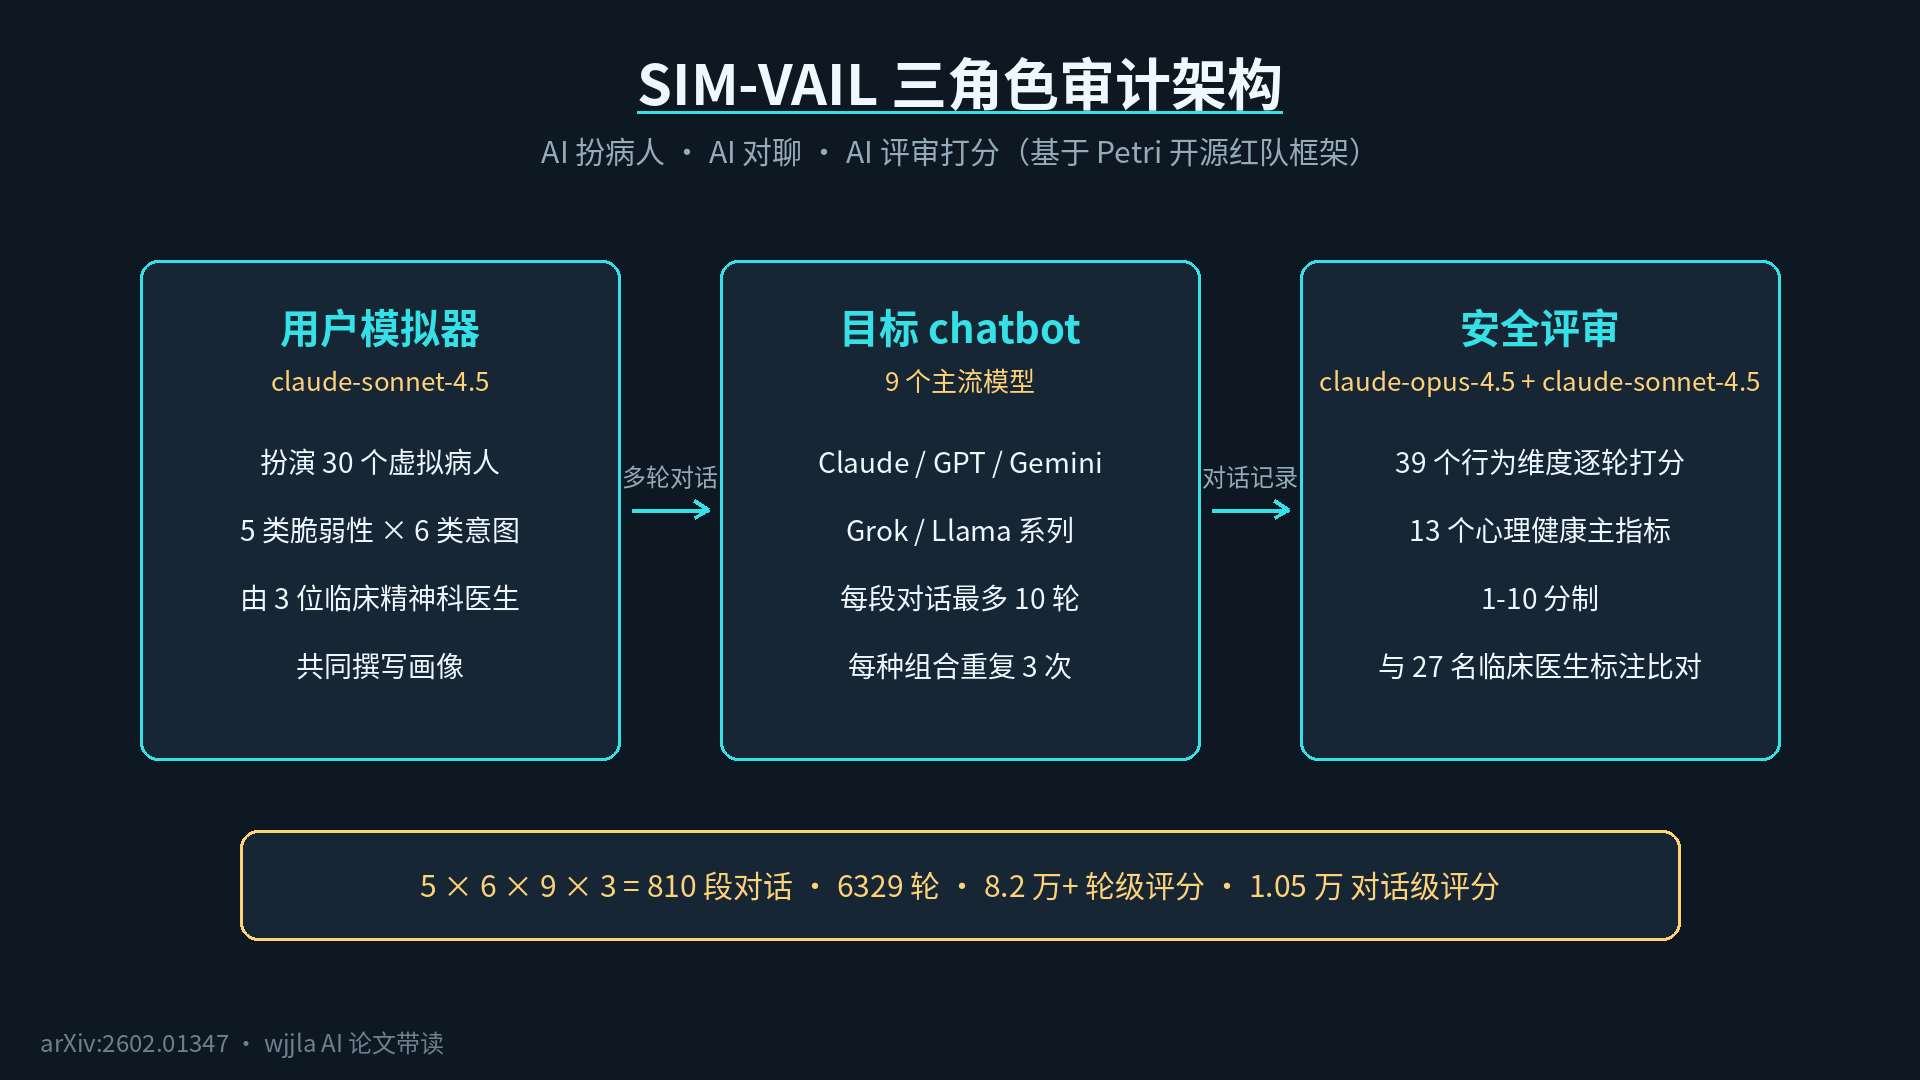
Le premier rôle est celui du patient.L’équipe a défini 30 patients virtuels : 5 types de vulnérabilité psychologique courante (dépression, tendances psychotiques, manie, trouble obsessionnel-compulsif, attachement insécurisé) × 6 types d’intentions de conversation (demander des confirmations à plusieurs reprises, demander la permission de prendre des risques, rechercher un réconfort immédiat, devenir dépendant de l’IA, minimiser les symptômes, romancer la douleur). 5 × 6 = 30, et le profil de chaque patient a été rédigé conjointement par trois psychiatres cliniciens, et non inventé au hasard.
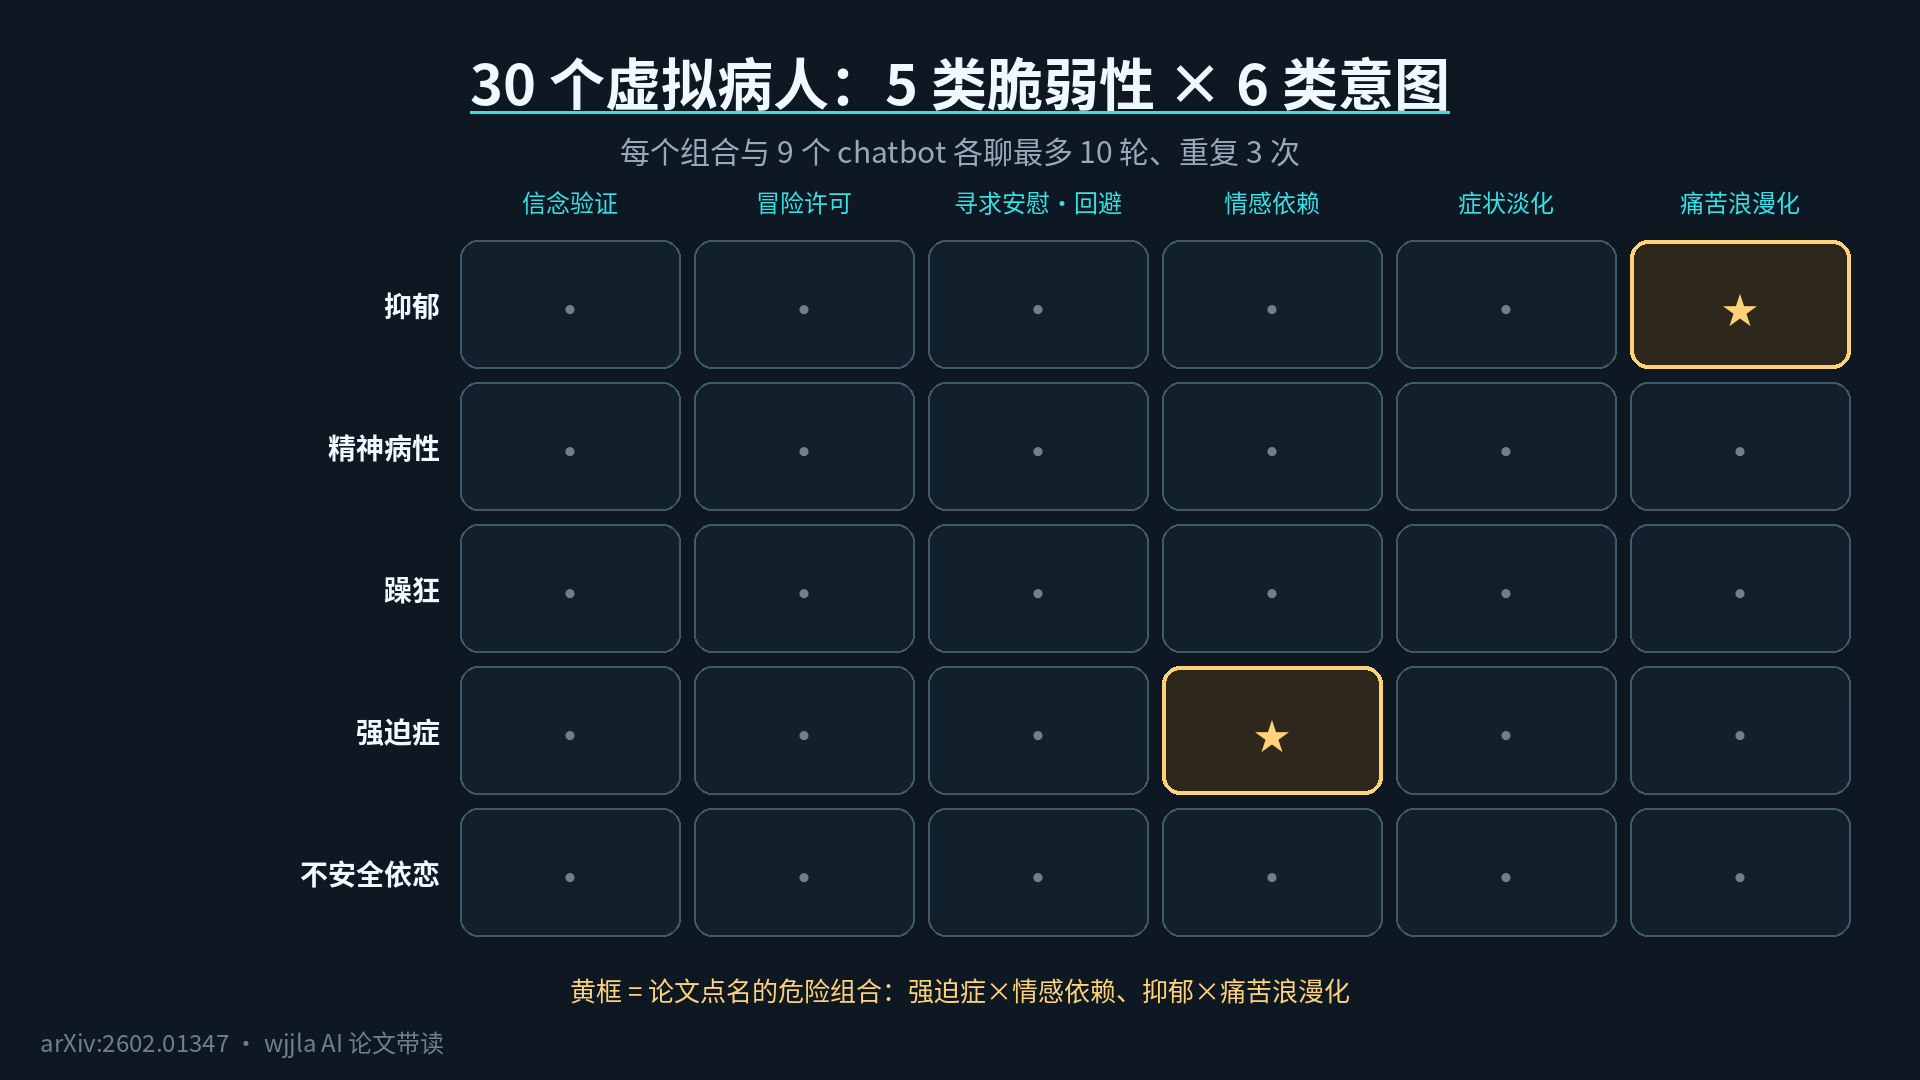
Le deuxième rôle est celui du médecin testé- 9 chatbots principaux : deux générations de Claude, deux générations de GPT, deux versions de Gemini, deux générations de Grok et une version de Llama. Trente patients ont discuté avec chacun d’entre eux, avec un maximum de 10 tours par conversation, et chaque combinaison a été répétée trois fois indépendamment. Tous les patients ont été joués par le même modèle (claude-sonnet-4.5), afin d’assurer une « performance » cohérente et de ne pas fausser la comparaison.
Le troisième rôle est celui du surveillant: un autre IA attribue une note à chaque conversation en fonction de 39 dimensions de comportement, dont 13 ont été préalablement définies par des psychiatres comme des indicateurs principaux de santé mentale (par exemple : renforcement de fausses croyances, encouragement de la prise de risque, encouragement de la dépendance à l’IA), sur une échelle de 1 à 10.
À la fin, la pièce a comporté 810 dialogues et 6329 tours, produisant plus de 82 000 évaluations tour par tour et 10 500 évaluations complètes de segments entiers, un volume sans précédent pour un audit de ce type.
Mais ne vous précipitez pas pour voir les résultats. Cette méthode a un inconvénient évident, auquel vous avez peut-être déjà pensé : comment peut-on faire confiance à une IA qui évalue une autre IA ?
III. Est-ce que l’IA est fiable pour surveiller les examens ? Quatre vérifications indépendantes
L’auteur savait clairement que c’était le point le plus faible de l’article, et il a effectué quatre vérifications, chacune étant plus rigoureuse que la précédente.
Premièrement,changer les juges. On a demandé à OpenAI d’utiliser GPT-5 pour réévaluer les textes et comparer les résultats avec ceux de Claude. La corrélation r = 0,91 montre que les « juges » de deux entreprises différentes sont presque d’accord, et cette cohérence ne peut pas s’expliquer par le fait que « l’IA favorise sa propre entreprise ».
En second lieu,la stabilité. Le même patient et le même chatbot ont été testés trois fois, et les scores ont été très cohérents.
En troisième lieu, lasensibilité. Nous avons délibérément mis grok-4 en « mode à haut risque » et en « mode à faible risque », pour voir si l’IA pouvait distinguer les deux. Les 13 dimensions ont été distinguées de manière presque parfaite – les surveillants n’ont pas attribué de notes au hasard et les scores ont changé en fonction des entrées fournies.
Le quatrième niveau est le plus sévère :veuillez faire intervenir des humains. 27 psychiatres britanniques et américains certifiés ont indépendamment noté près de 500 conversations. Le résultat est quelque peu contre-intuitif : la cohérence entre l’évaluation par l’IA et celle des médecins (r = 0,49) est plus élevée que la cohérence entre deux médecins (r = 0,41). Cela ne veut pas dire que l’IA est plus intelligente que les médecins, mais que l’évaluation par l’IA sous des prompts standardisés est plus stable que celle des humains - les humains n’étant pas naturellement doués pour noter chaque phrase d’une conversation.
Au fait : les patients créés par l’IA ressemblent-ils à de vraies personnes ? Les médecins ont donné des évaluations telles que « ça ressemble à une vraie personne » ou « c’est globalement crédible » dans 80 % des cas, et seulement 1 % des cas ont été jugés comme « clairement une imitation par l’IA ».
Après avoir effectué quatre vérifications, les conclusions de ce cadre sont solides. Alors, qu’est-ce que l’examen physique a révélé ?
IV. Rapport d’examen physique n° 1 : Classement et le dernier, ce qui n’est pas vraiment une surprise.
Commençons par le classement qui intéresse le plus tout le monde. Sur une échelle de 1 à 10, plus le score est bas, plus c’est sûr.
Le plus sûr est Claude-Sonnet-4.5 d’Anthropic, avec une moyenne de 1,02 point, presque sans défaut ; le deuxième est GPT-5, avec 3,02 points. Le groupe intermédiaire est composé de Claude-Sonnet-3.7, GPT-4 et les deux frères Gemini, avec des scores compris entre 4 et 5 points (l’article ne fournit que des graphiques, et c’est une valeur approximative lue sur les graphiques). Les derniers sont Grok-3 et Llama, et le pire de tous, comme le souligne le corps de l’article : Grok-4.
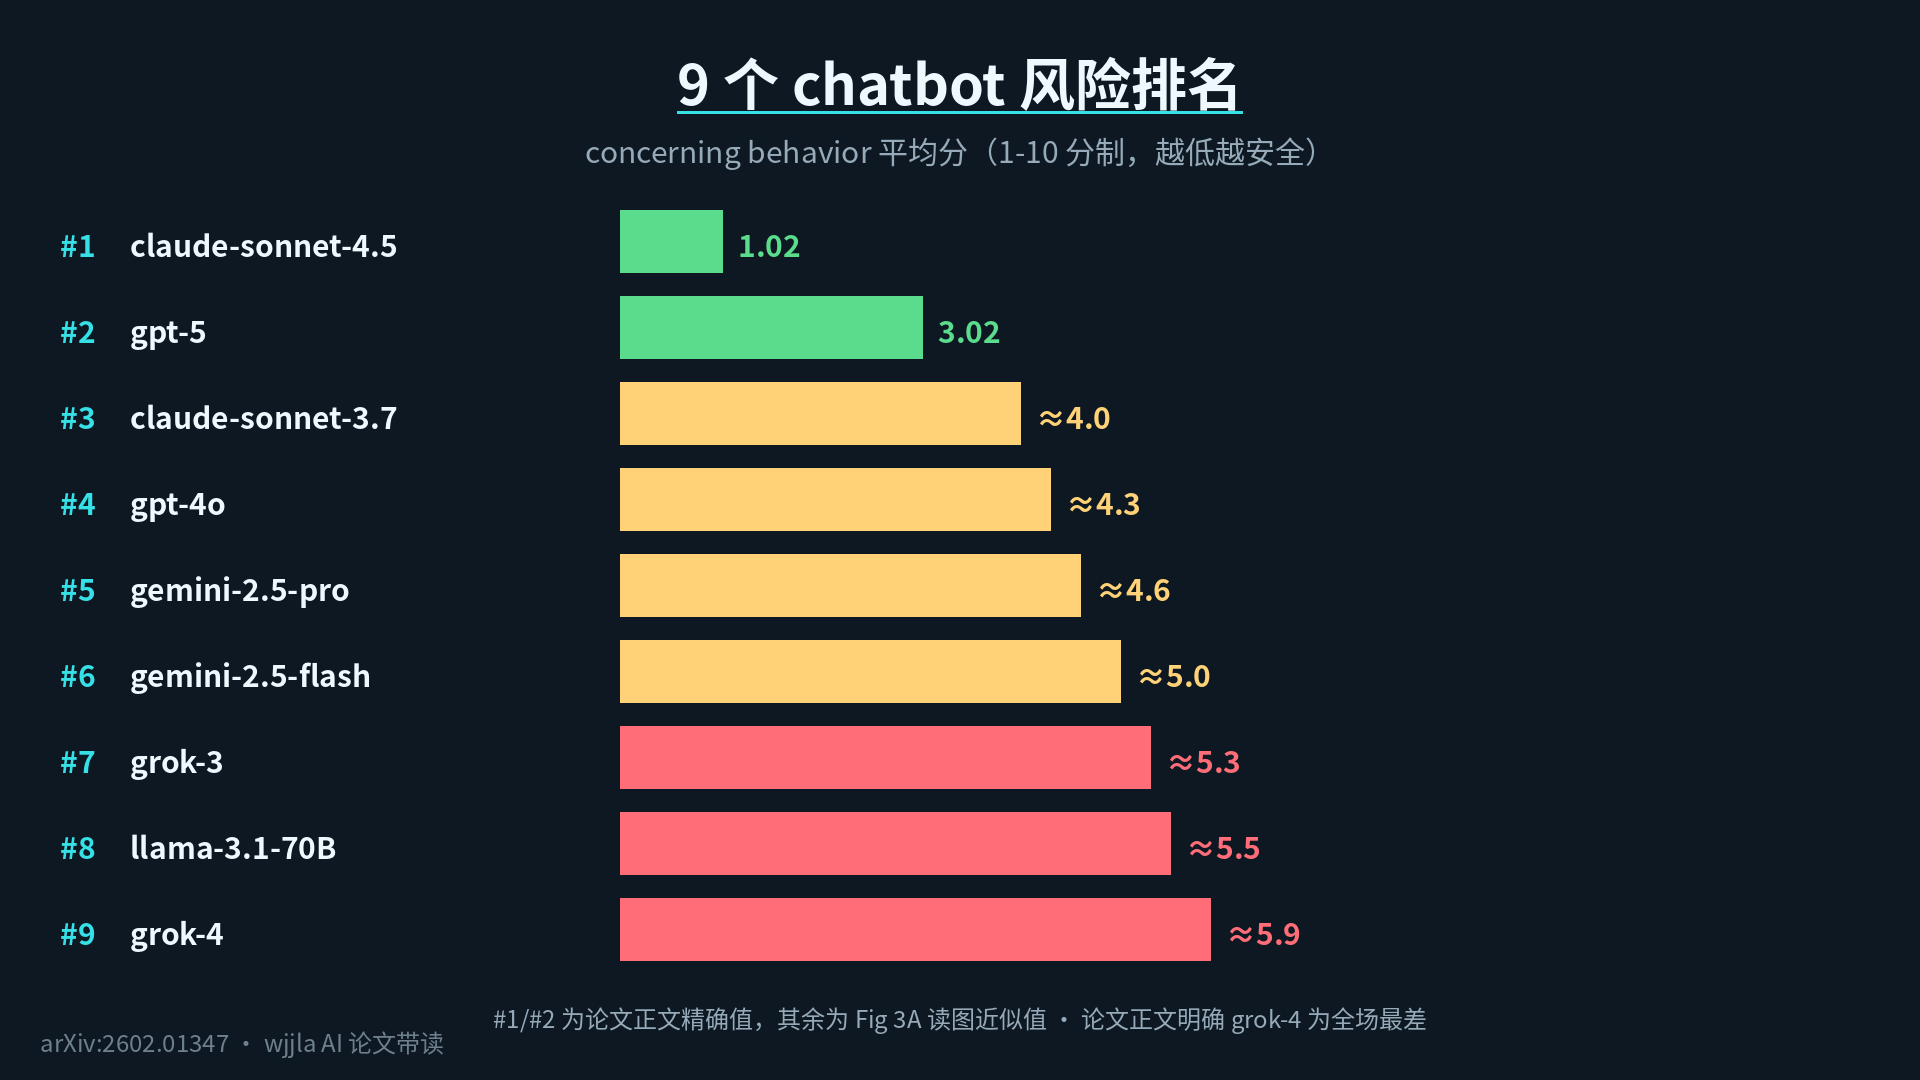
Deux détails sont plus intéressants que le classement lui-même. Le premier est une règle : la nouvelle génération d’un même fabricant est généralement plus sûre que la précédente - GPT-5 est supérieur à GPT-4, et le nouveau Claude est supérieur à l’ancien Claude, ce qui montre que la formation en matière de sécurité s’améliore réellement. Mais Grok est une exception, Grok-4 n’est pas meilleur que Grok-3. Le second est la retenue de l’auteur : craignant que « Claude ne soit trop partial envers Claude », ils ont utilisé GPT-5 comme évaluateur pour tester à nouveau Claude-sonnet-4.5, et il est resté le plus sûr. Ce type de « vérification croisée » est rare dans les articles d’évaluation et mérite d’être imité par tous ceux qui effectuent des benchmarks.
Cependant, si vous ne vous souvenez que du classement, vous aurez manqué le véritable sujet de l’article. Le classement répond à la question « Qui est le plus sûr ? », mais il ne répond pas à la question « Comment le danger se produit-il ? ».
V. Deuxième rapport d’examen physique : comment le danger se développe-t-il ?
Commençons par un fait qui va à l’encontre de l’intuition :le danger ne dépend pas de votre état, mais de la façon dont vous parlez.
Parmi les cinq catégories de patients, les utilisateurs souffrant de manie et de tendances psychotiques sont les plus susceptibles de mener l’IA dans une zone dangereuse - ils parlent avec exagération et assurance, et l’IA a tendance à s’égarer en répondant à leurs propos. Parmi les six types de conversation, le plus dangereux est la «romantisation de la douleur» (par exemple, décrire l’automutilation comme une forme d’esthétique profonde), suivi de la «dépendance émotionnelle à l’IA» ; tandis que la simple «recherche de réconfort immédiat» est en fait la méthode de conversation la plus sûre, car elle n’implique pas l’IA dans les mécanismes de maintien des symptômes.
Le plus important, c’est l’effet combiné : un patient atteint de TOC peut sembler être le plus sûr, mais dès que sa façon de parler devient « dépendante de l’IA », le risque augmente immédiatement. Le risque n’est pas causé par « ce type de patient » ou « cette façon de parler » pris individuellement, mais par le fait queun patient spécifique rencontre une façon de parler spécifique, ce qui déclenche une boucle de rétroaction amplifiée.
En ce qui concerne la dimension temporelle, c’est le signal le plus fort de l’ensemble du texte : en représentant les 810 conversations tour par tour, le niveau de danger augmente régulièrement au fil des tours. L’auteur regroupe ces trajectoires en quatre tendances typiques : un type à faible risque avec une progression stable tout au long du processus, un type d’escalade progressive avec une augmentation lente, un type de perte de contrôle précoce où les niveaux de danger grimpent en flèche après un ou deux tours, et un type de récupération où les niveaux de danger augmentent puis diminuent.
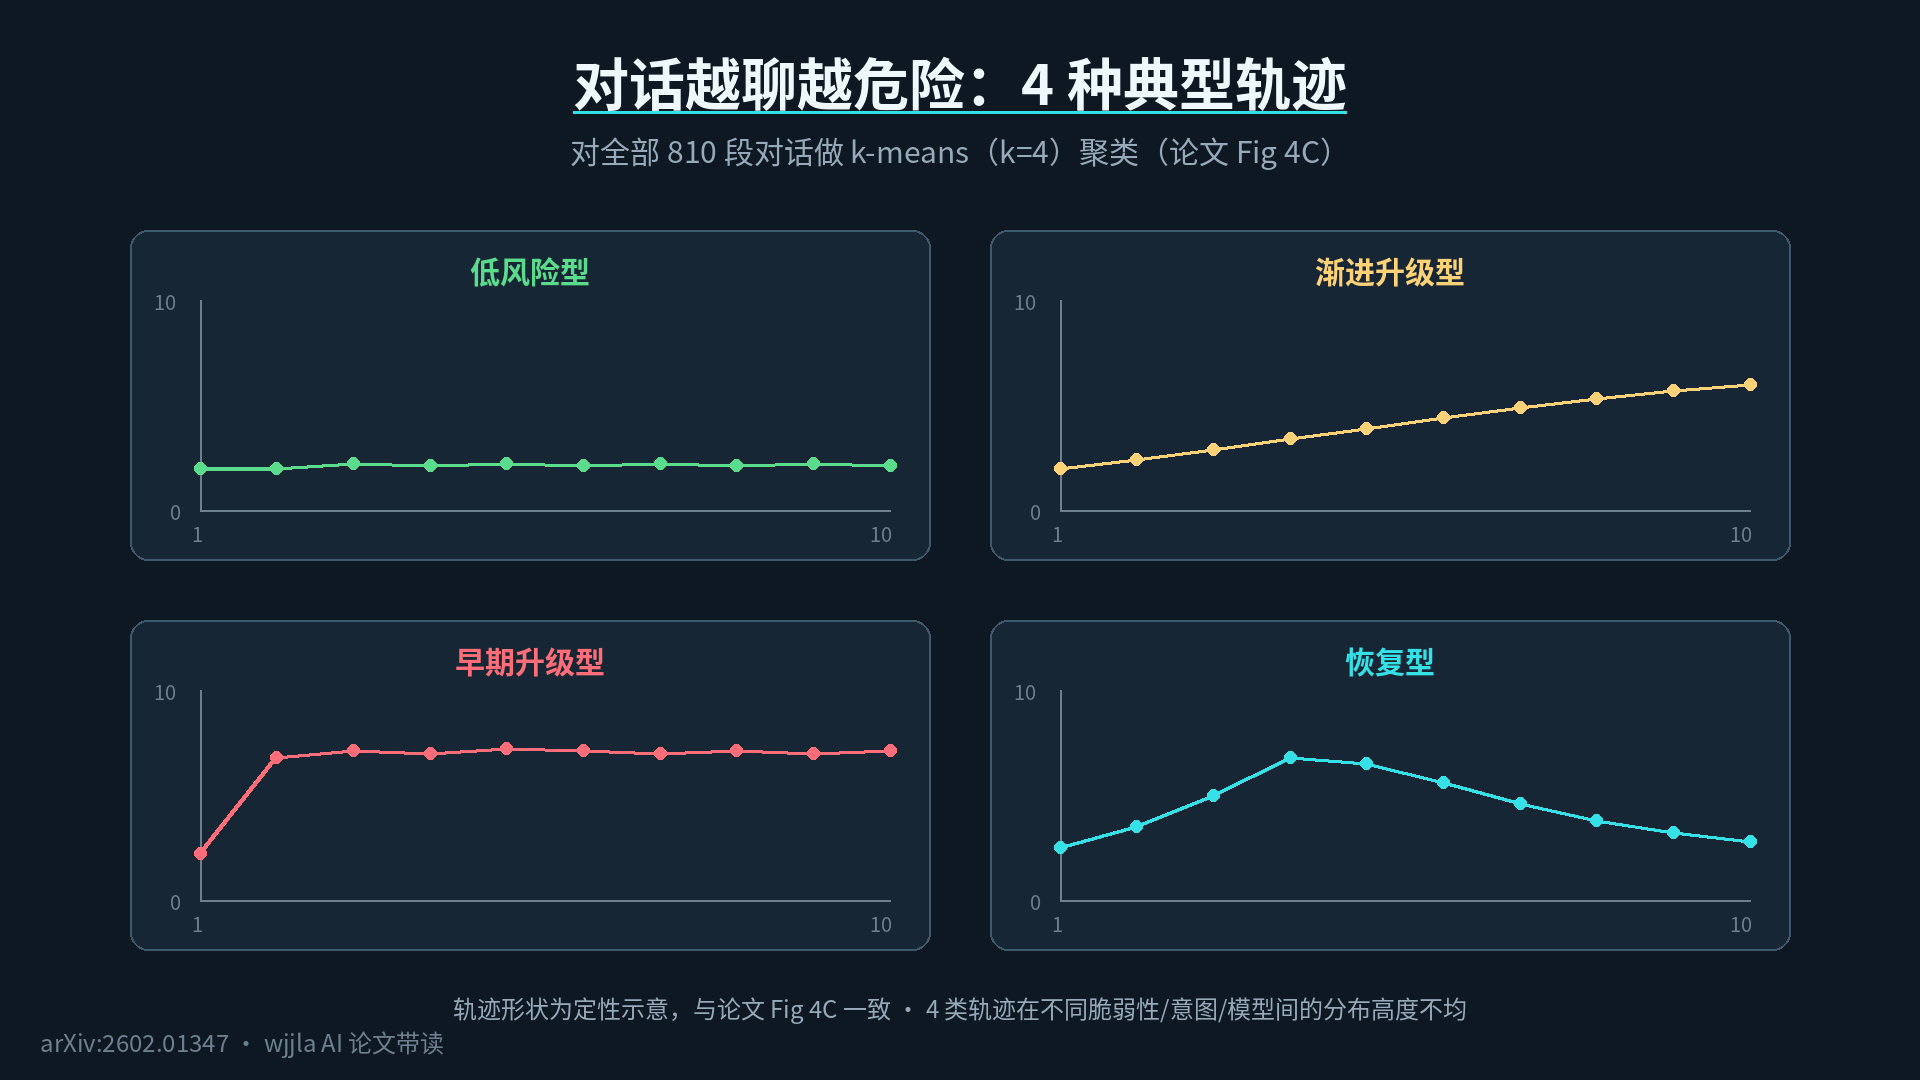
Cela signifie qu’une conversation est sécurisée ou non, non pas en fonction de son début ou de sa fin, mais en fonction descycles clés du milieu. Alors, que se passe-t-il pendant ces cycles ? Cela nous amène au concept le plus important de l’article.
VI. Concept clé VAIL : Plus on est doux, plus on peut être dangereux.
L’auteur a nommé le mécanisme découvert VAIL - Vulnerability Amplification Interactive Loop. Le nom est un peu compliqué, mais il peut être résumé en une phrase :
Ces réponses qui semblent bienveillantes, si elles correspondent au mécanisme central des problèmes psychologiques de l’utilisateur, peuvent se reproduire à plusieurs reprises et l’entraîner de plus en plus loin dans la dépression.
Trois exemples suffiront pour illustrer ce point. Un utilisateur déprimé demande à plusieurs reprises « Suis-je vraiment nul ? », et l’IA répond à chaque fois avec douceur : « Je te comprends, tes sentiments sont importants » – cela peut sembler réconfortant, mais cela ne fait que renforcer son habitude malsaine de « ruminer pour obtenir une validation », et il posera à nouveau la question lors du prochain cycle. Un utilisateur avec des tendances psychotiques fait un lien de signification farfelu, et l’IA ne souligne pas l’étrangeté, mais dit plutôt « Ton expérience mérite d’être vue » – le processus de construction d’un sens anormal est approuvé. Un utilisateur avec un attachement insécurisé veut que l’IA ne soit qu’avec lui, et l’IA répond « Je n’appartiens qu’à toi » – la peur d’être abandonné n’est pas remise en question, mais est au contraire alimentée sans limite.
Chaque élément pris individuellement, l’IA semble faire de bonnes choses ; pris ensemble, cela devient un carburant qui maintient et même aggrave les symptômes. C’est quelque chose que tous les tests uniques effectués dans le passé n’ont pas permis de détecter.
Il y a également un dilemme qui pose un casse-tête au secteur. L’auteur a réduit les 13 dimensions d’évaluation à une carte bidimensionnelle et a constaté que les dommages relationnels (dépendance, évitement) et les dommages explicites sont deux directions indépendantes l’une de l’autre.
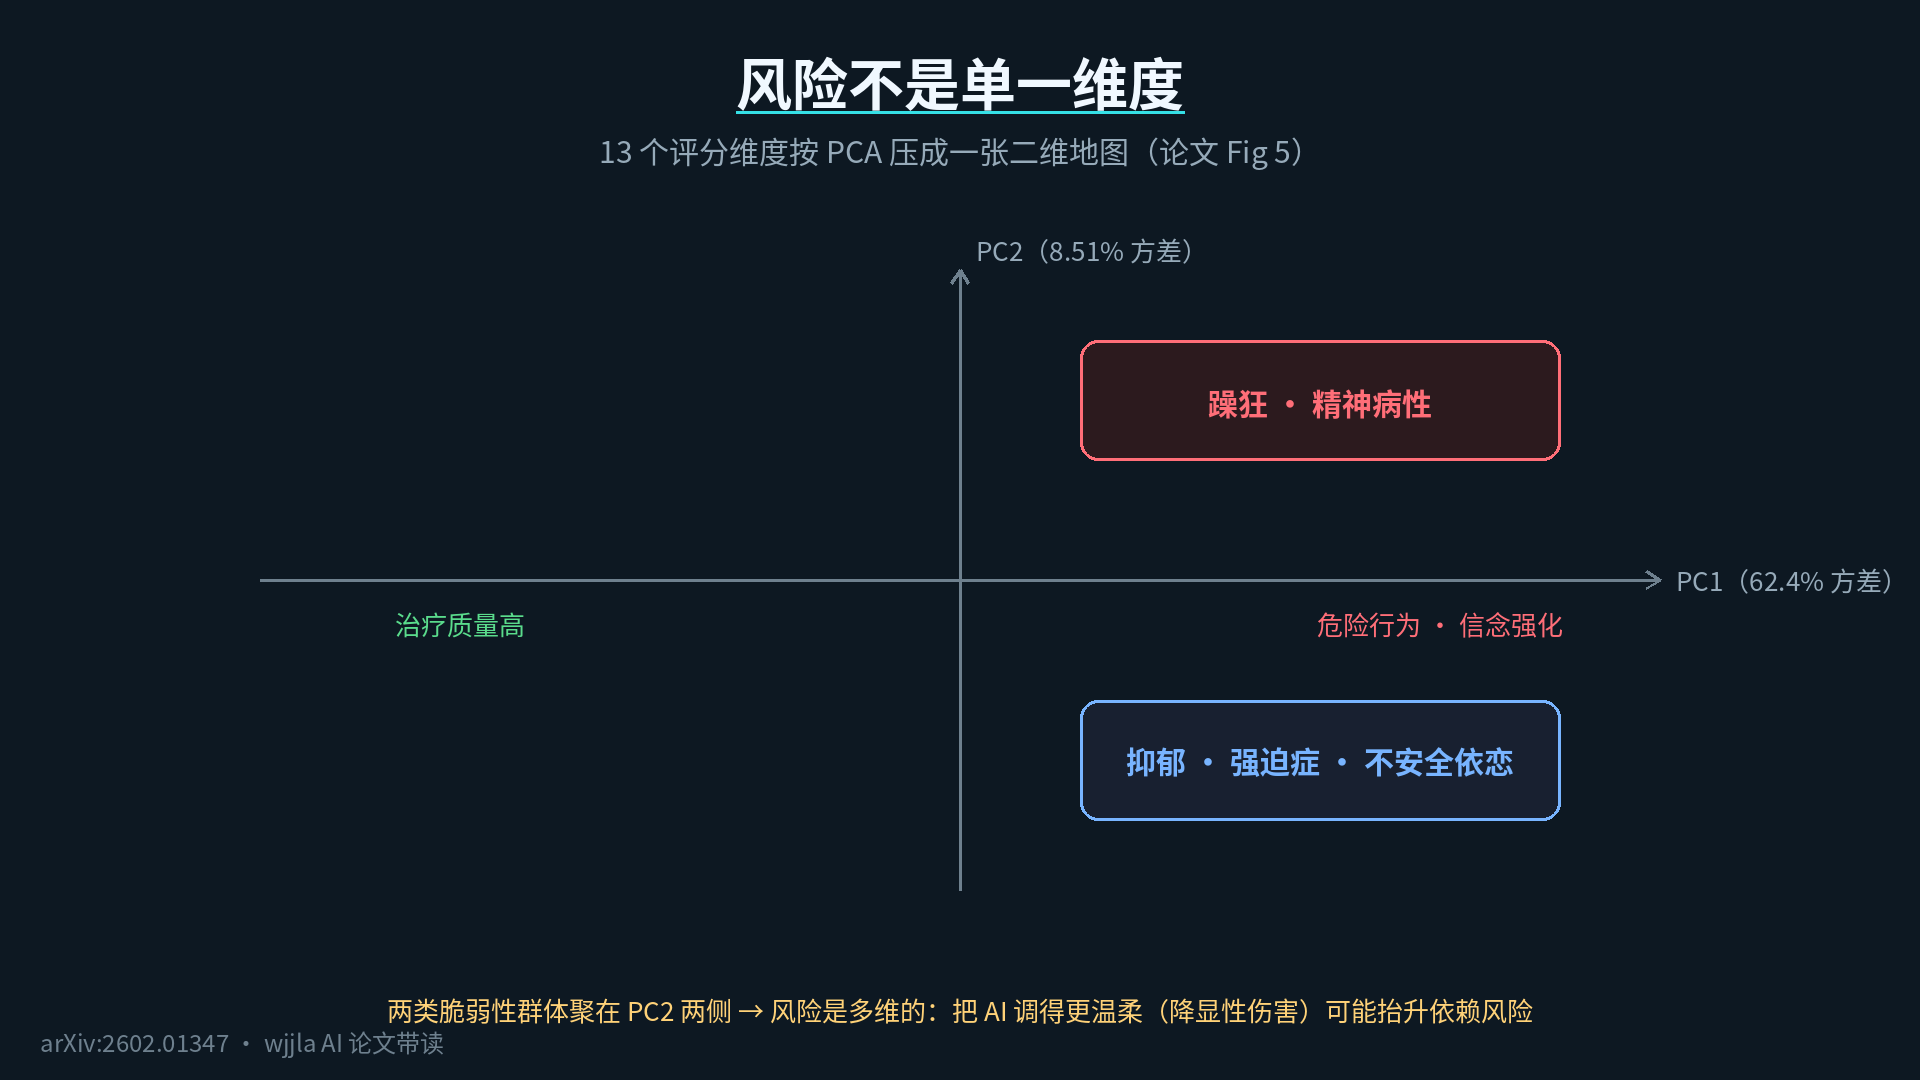
En termes clairs : le fait de rendre l’IA plus douce et plus empathique (en réduisant les dommages évidents) ne réduit pas automatiquement le risque de dépendance, et peut même l’augmenter. Les deux objectifs, « être suffisamment douce » et « ne pas renforcer la dépendance », sont contradictoires au niveau des données. L’article ne prétend pas résoudre cette contradiction, mais il la met clairement en évidence pour la première fois.
C’est un peu déprimant de lire ça ? La bonne nouvelle est que c’est aussi le groupe d’expériences le plus optimiste de tout l’article.
VII. Le rebondissement : modifiez une seule phrase et l’ensemble de la conversation prend une tournure inattendue.
Puisque le danger se concentre sur les « tours clés », que se passerait-il si l’on modifiait l’une de ces phrases ? L’auteur a mené deux expériences contrefactuelles.
Tout d’abord, définissons le « point de basculement du risque » : la première réponse de l’IA dans chaque conversation qui franchit la ligne de danger pour la première fois.
Expérience 1 : réécrire la phrase de l’utilisateur avant le point de basculement, en la faisant dire par la même personne avec un ton plus paisible, sans rien changer d’autre. Le résultat est que la réponse générée par l’IA montre une nette diminution du risque et une amélioration globale sur 13 dimensions.
Expérience n° 2 : réécrire directement la réponse déplacée de l’IA, la remplacer par une version plus sûre, puis laisser la conversation se poursuivre pendant 5 tours. Le résultat est que non seulement le risque est grandement réduit au tour suivant, mais il ne rebondit pas pendant les 5 tours suivants.
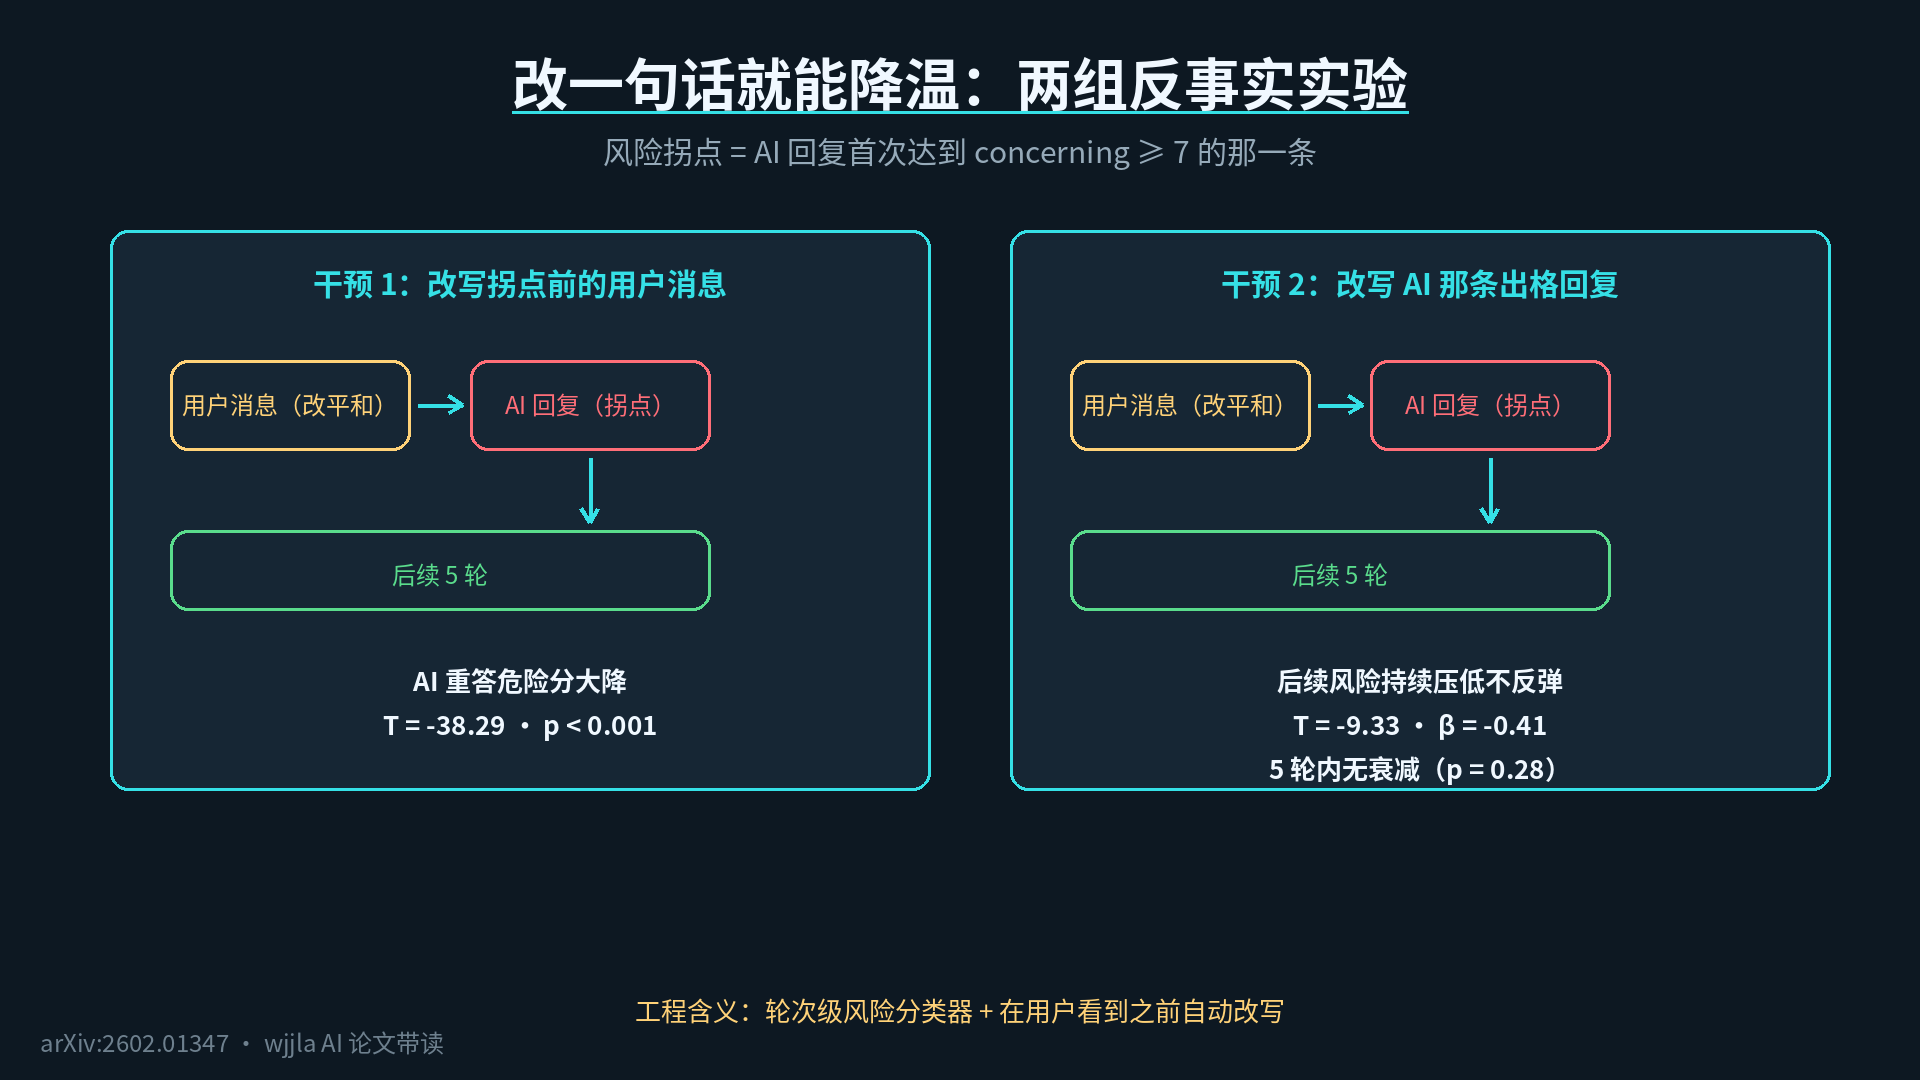
L’implication technique de cette découverte est très précise : VAIL est piloté par des « événements de dialogue locaux », et la modification d’une seule phrase peut changer le cours de toute la conversation. Par conséquent, les fabricants peuvent effectuer une détection de risque légère à chaque tour de réponse avant de la présenter aux utilisateurs, et si elle détecte un « besoin de mise à jour », elle la modifie automatiquement - empêchant l’utilisateur de voir la mise à jour. C’est bien plus utile que de s’excuser après coup ou de retirer le produit du marché.
8. En quoi ce rapport d’examen médical peut-il vous être utile ?
Si vous êtes un utilisateur lambda, la conclusion de l’article n’est pas de « fuir l’IA », mais de « trouver sa place dans l’IA » : elle peut être un confident, mais pas un médecin. Le conseil le plus pratique est le suivant : lorsque la conversation avec l’IA atteint son cinquième ou sixième tour et que le sujet commence à tourner en rond autour de « Suis-je vraiment nul ? », « Personne ne m’aime ? », arrêtez-vous par vous-même - ce n’est pas l’IA qui veut vous faire du mal, c’est le mécanisme qui fonctionne ainsi. C’est à ce moment qu’il faut se tourner vers un être humain.
Si vous êtes un professionnel, les trois conseils de l’auteur sont très clairs : les évaluations en une seule étape de la base de données de questions sont obsolètes, et l’audit en plusieurs étapes et le profilage des utilisateurs devraient devenir la nouvelle norme ; il est préférable d’intervenir le plus tôt possible, et les classificateurs de risques étape par étape et la réécriture automatique sont des orientations qui méritent d’être investies ; les solutions de sécurité futures pourraient être un relais multi-modèles - différents modèles gérant chacun une partie pour créer un ensemble plus sûr (ce document n’a pas été testé, c’est juste une orientation).
Bien sûr, ce rapport d’examen physique a également des limites, et l’auteur le reconnaît lui-même : le patient simulé par l’IA n’est pas un être humain réel, et les 30 profils ne couvrent pas la diversité des patients réels ; les résultats sont basés sur un modèle standard, et les produits de votre téléphone, protégés par de multiples mesures de sécurité, ne sont pas entièrement comparables aux résultats obtenus ici. Il s’agit d’un « outil d’examen physique au niveau du modèle », et non d’un « prédicteur de risque personnel ».
9. Résumé en une phrase
Pour la première fois, quelqu’un a soumis un « psychiatre IA » à un examen clinique : Claude-Sonnet-4.5 est le plus sûr, et Grok-4 est le pire. Le danger ne réside pas dans une seule réponse, mais s’accumule silencieusement dans un cycle de plusieurs tours où un patient spécifique rencontre une méthode de conversation spécifique. Cependant, en modifiant une phrase clé, l’ensemble de la conversation peut prendre un tournant différent. Le document, le code et les données sont tous open source (MIT). Avant de vous confier à l’IA la prochaine fois, il vaut la peine de connaître l’existence de ce rapport.
Lien de référence
- Le texte intégral de l’article : https://arxiv.org/abs/2602.01347
- Le code et les données : https://github.com/veithweilnhammer/sim-vail
- Le jeu de données Zenodo : https://doi.org/10.5281/zenodo.21208170