L’article arXiv publié par l’équipe Qwen d’Alibaba en juillet 2026 (2607.22529) a pour cœur de transformer la « bibliothèque de compétences » en un moteur de curriculum pour l’auto-jeu de formation des LLM. Cet article n’est pas rempli de termes techniques, il suffit de voir ce qu’il résout, comment il le résout et s’il vaut la peine que vous y consacriez du temps.
1. Le véritable problème : l’entraînement en jeu d’auto-apprentissage est bloqué dans une impasse entre la « diversité » et la « vérifiabilité ».
Au cours des deux dernières années, le paradigme de formation LLM est passé de « étiquetage manuel + SFT » à « auto-évolution », l’idée centrale étant de permettre au modèle de générer lui-même les données de formation et de se noter lui-même. Mais en 2026, cette approche s’est heurtée à une contradiction très spécifique :
- L’approche « liée à l’environnement » (environment-bound)(par exemple, demander à un LLM d’écrire du code, puis d’exécuter des tests unitaires) : les retours sont précis, mais le domaine des tâches pouvant être exécutées est très restreint, il s’agit essentiellement de scénarios pouvant être vérifiés par une machine, comme la programmation et les démonstrations mathématiques.
- L’approche « auto-génératrice ouverte » (open-ended self-generation)(demander à un LLM d’écrire une question, puis de la juger lui-même) : le domaine des tâches est large, mais le signal de récompense n’est pas fiable. Le modèle peut facilement apprendre à « tricher avec le juge », et une fois que la récompense est piratée, l’entraînement s’effondre.
Ces deux problèmes représentent chacun la moitié des cas d’échec dans l’industrie. L’approche de Skill Self-Play (ci-après dénommé Skill-SP) est la suivante :la compétence (skill)est naturellement une zone intermédiaire - une compétence est une « capacité d’exécution structurée » réutilisable, suffisamment profonde pour une tâche donnée et hautement vérifiable, qui peut ensuite être étendue à d’autres domaines grâce au routage dynamique.
Après avoir lu l’article, ma plus grande impression est la suivante : il ne s’agit pas de démontrer au niveau philosophique que « les compétences sont une zone intermédiaire » — il considère directement les compétences comme des objets exécutables, en créant une bibliothèque dynamique qui peut être mise à jour, routée et retirée par le cadre RL. Cette idée de « traduire un concept abstrait en un objet d’ingénierie opérationnel » est beaucoup plus concrète que la « frontière des capacités » que le titre de l’article tente d’exprimer.
II. Trois rôles : Proposeur / Résolveur / Contrôleur de compétences
L’architecture de Skill-SP est très simple. Elle repose sur trois rôles qui coévoluent ensemble dans une boucle d’apprentissage par renforcement (RL) :
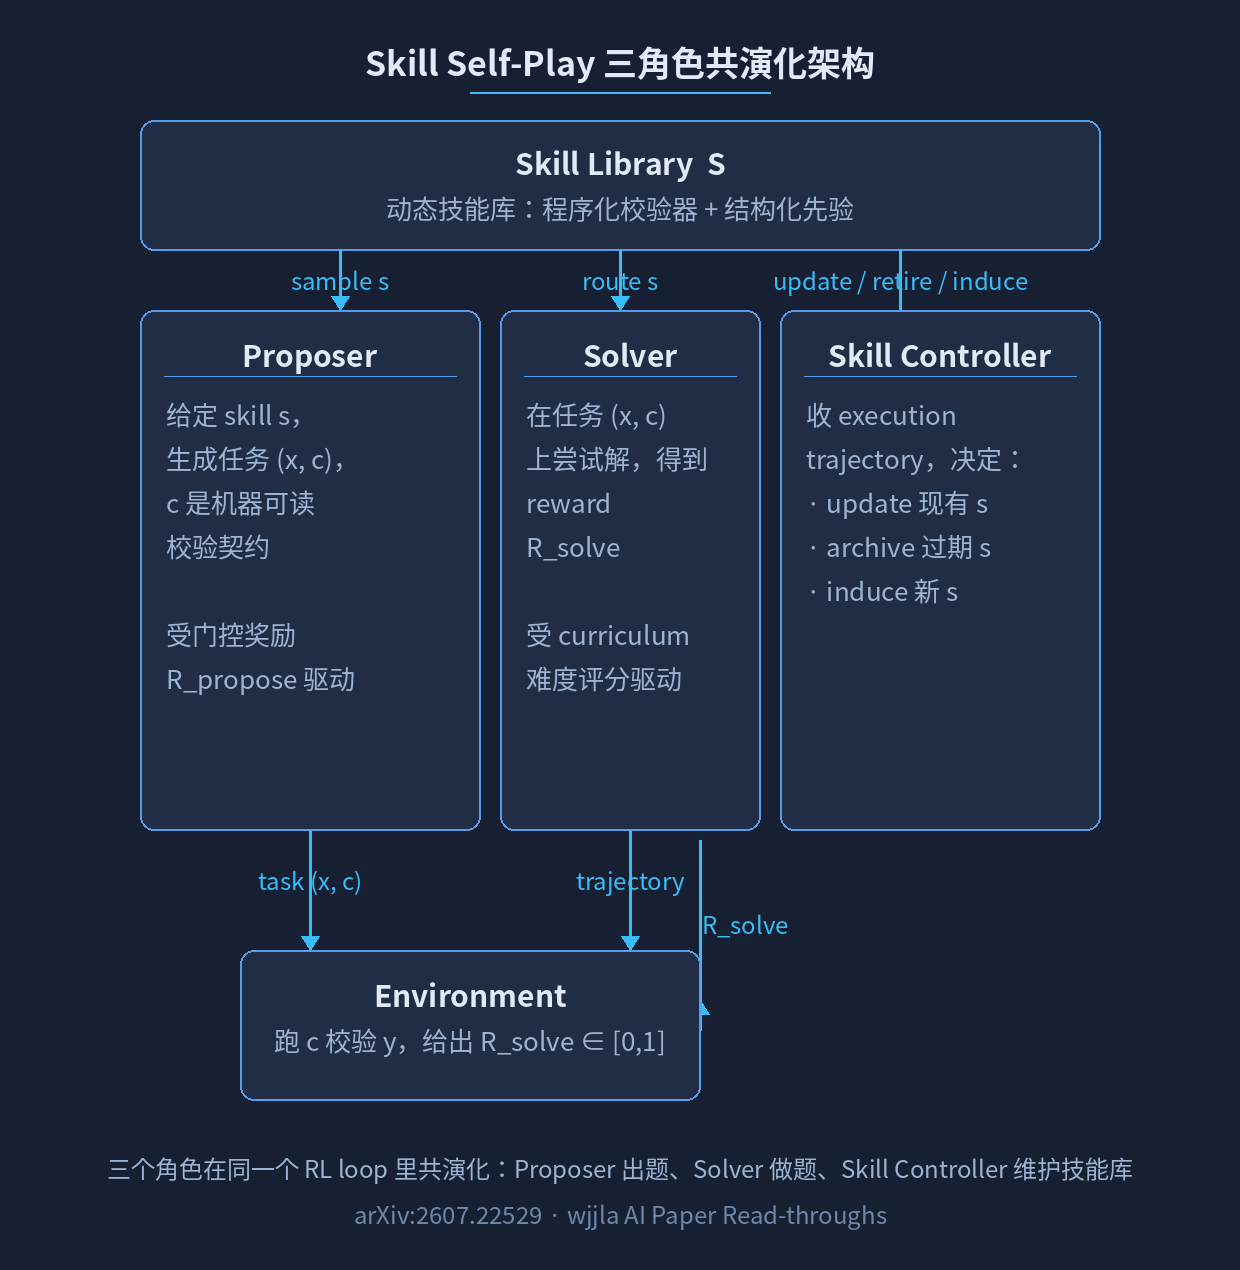
Le rôle duProposeurest très ciblé : étant donnée une compétence s échantillonnée dans la bibliothèque de compétences S, il doit synthétiser un couple (prompt x, contrat de vérification c). c doit être lisible par une machine - les exemples donnés dans l’article sont des tests unitaires et des réponses de référence. La récompense obtenue par le Proposeur ne dépend pas de la difficulté de la tâche, mais d’une récompense de cursus conditionnelle - seuls les contrats de tâche (x, c) structurellement légitimes sont notés en fonction de leur difficulté proche de 0,5, sinon ils sont directement mis à zéro. Cette étape est un élément clé de la conception souligné dans l’article : elle ferme explicitement la porte au « piratage de la récompense », le Proposeur ne peut pas synthétiser « je prétends avoir créé une tâche très difficile », car la validation du contrat précède l’évaluation de la difficulté.
Le rôle duSolverest plus traditionnel : étant donné (x, c), il génère la réponse y, l’environnement exécute c pour la vérifier et renvoie R_solve. L’objectif de l’entraînement du Solver est d’être entraîné par les questions posées par le Proposer — mais les questions posées par le Proposer ne sont pas aléatoires, elles sont guidées par un curriculum score vers la « frontière d’apprentissage » actuelle du Solver (dans l’article, ce score est appelé « score de difficulté moyenne », et la formule est « 1 – 2|v_solve – 0.5| », l’objectif étant de faire en sorte que le taux de réussite du Solver soit proche de 0,5, car c’est exactement la plage dans laquelle le modèle « peut réussir en faisant un effort »).
LeContrôleur de compétencesest la conception technique la plus intéressante de cet article. Il ne s’agit pas d’une liste statique de compétences, mais d’une bibliothèque gérée dynamiquement. Trois types d’opérations :
1.Mise à jour: En fonction de la trajectoire d’exécution de Solver pour une compétence donnée, affiner la logique de validation de cette compétence (par exemple, ajouter des tests pour des cas limites). 2.Archivage: Si une compétence n’est pas déclenchée pendant plusieurs tours consécutifs, la marquer comme obsolète et la retirer de la bibliothèque principale. 3.Induction: Découvrir de nouvelles structures réutilisables dans le flux de génération ouvert, les empaqueter automatiquement en nouvelles compétences et les ajouter à la bibliothèque.
Les tests pratiques dans l’article montrent que, après cinq itérations, le nombre de compétences efficaces (pondéré par l’entropie de Shannon) est passé de 1 à 46, et le nombre de compétences actives est passé à 86 — ce qui signifie que la base de compétences s’est réellement élargie pendant l’entraînement, et que le Proposeur n’a pas tourné en rond sur quelques compétences fixes.
III. La conception d’ingénierie la plus essentielle : comment éviter que la bibliothèque de compétences ne subisse un « effondrement de modèle » ?
Le mode d’échec classique de l’entraînement de jeu s’appelle lemode collapse: le Proposer découvre qu’un certain skill produit des questions pour lesquelles le Solver donne des réponses très stables, et l’utilise donc à plusieurs reprises, ce qui réduit la distribution des données d’entraînement à quelques skills très fréquents. Skill-SP a mis en place trois niveaux de protection contre ce problème :
3.1 Échantillonnage à double flux (dual-stream)
Il ne s’agit pas d’extraire 100 % des tâches de la bibliothèque de compétences. Le ratio réel dans l’article (extrait de l’expérience d’ablation de la Figure 4) est le suivant :
- Flux de compétences: Échantillonner une compétence s dans la bibliothèque de compétences S, et le Proposeur génère une tâche autour de celle-ci. Cette partie est responsable de « maintenir la difficulté à la pointe du Solver ».
- Flux d’exploration: Non lié à la compétence, le Proposeur génère librement — préservant la diversité des tâches et évitant l’effondrement.
Je n’ai pas trouvé de chiffres précis dans l’article pour les tests pratiques, mais les résultats montrent que : l’entraînement purement axé sur les compétences (100% de flux de compétences) entraîne une baisse moyenne de 4,1 points ; l’entraînement purement axé sur les points de compétence non guidés (0% de flux de compétences) entraîne une baisse moyenne de 2,6 points ; seul le flux mixte (dont le pourcentage n’est pas précisé, mais le titre de l’article suggère qu’il existe) permet une amélioration stable. Cela montre que Skill-SP ne supprime pas l’auto-génération ouverte, mais utilise les compétences comme une « soupape de régulation » pour contrôler l’équilibre entre la difficulté et la diversité des tâches.
3.2. Le contrôle des scores de difficulté (récompense du programme d’études modulable).
C’est le point le plus crucial des mathématiques dans cet article, je vais donc l’expliquer séparément :
La fonction de récompense R_propose de Proposer n’est pas simplement « difficile = bonne », mais plutôt :
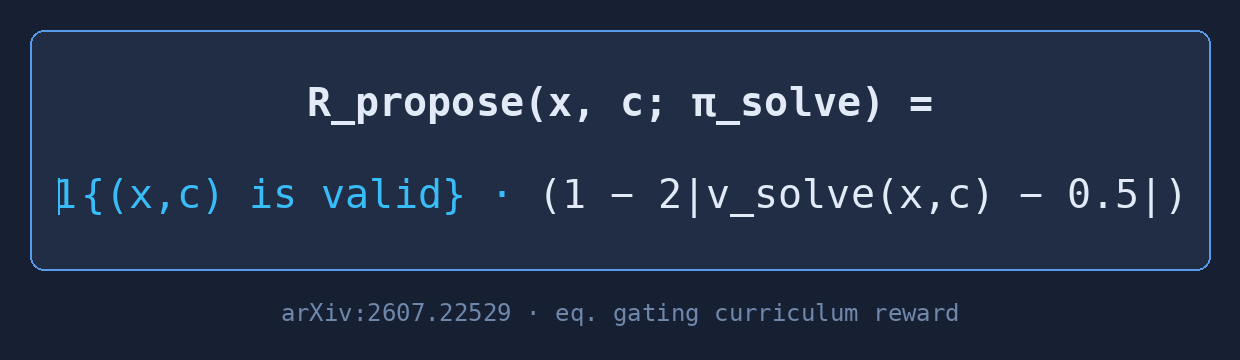
Le premier élément, « 𝟙 {(x, c) est valide », est un filtre binaire : le contrat de tâche (x, c) doit être structuré légalement (la machine doit pouvoir exécuter la validation c) pour que des points soient attribués, sinon le score R_propose est égal à zéro. Le deuxième élément est une notation de difficulté moyenne : plus |v_solve - 0,5| est faible, plus le score est élevé — c’est-à-dire que le Proposeur doit proposer une question qui permet au Solver d’atteindre un taux de réussite proche de 0,5.
Pourquoi 0,5 et pas 0,1 (très difficile) ou 0,9 (très facile) ? Parce que :
- C’est trop difficile (v_solve ≈ 0) : le solveur ne reçoit pas de signal d’apprentissage et la récompense est très variable.
- C’est trop simple (v_solve ≈ 1) : on n’apprend rien, c’est comme résoudre des exercices sans but.
- 0,5 est le point idéal où « en faisant un effort, on peut réussir », et l’apprentissage par renforcement converge le plus rapidement.
Le contrôle d’accès est la clé. Sans lui, le Proposeur apprendrait à « créer des questions qui semblent complexes mais qui sont en réalité vides de sens », et les récompenses seraient directement réduites à zéro, le forçant à créer de vraies questions. C’est ce que le titre de l’article appelle Co-Evolving Skills (Compétences co-évolutives) : ce n’est pas seulement la bibliothèque de compétences qui évolue, mais les trois parties (Proposeur-Compétences-Solveur) qui se « corrigent mutuellement ».
3.3 La mise en œuvre spécifique du contrôleur de compétences
Le document ne fournit pas le code complet (protection des brevets de l’équipe Qwen), mais il présente les trois principes de fonctionnement :
- Mise à jour: Un package de compétences = (modèle exécutable, code de validation, plusieurs exemples) en trois parties. Le contrôleur reçoit la trajectoire de Solver pour cette compétence, et si le mode d’échec est concentré dans une certaine limite, il ajoute automatiquement un cas de test.
- Archivage: Maintenir une « file d’attente de refroidissement », où les compétences qui n’ont pas été échantillonnées par le proposeur pendant N tours consécutifs (je n’ai pas trouvé la valeur exacte de N) sont déplacées vers les archives, libérant de l’espace dans la bibliothèque principale.
- Induction: Cette étape est la plus intéressante. Le contrôleur exécute un clustering léger (avec all-MiniLM-L6-v2 + PCA, voir la description de la Figure 5b), et regroupe automatiquement les « structures programmatiques » générées en grand nombre par le flux d’exploration (comme « toujours demander que la liste soit triée après la déduplication ») en nouveaux packages de compétences.
Ce lien Induce permet de réaliser techniquement la « découverte automatique de préalables réutilisables à partir de la distribution de données » - c’est la même idée que la découverte d’options dans l’apprentissage par renforcement traditionnel ou l’apprentissage hiérarchique, mais appliquée à la synthèse de données LLM, c’est un nouveau point fort en 2026.
IV. Données d’expérimentation : qui profite des avantages et qui n’en profite pas ?
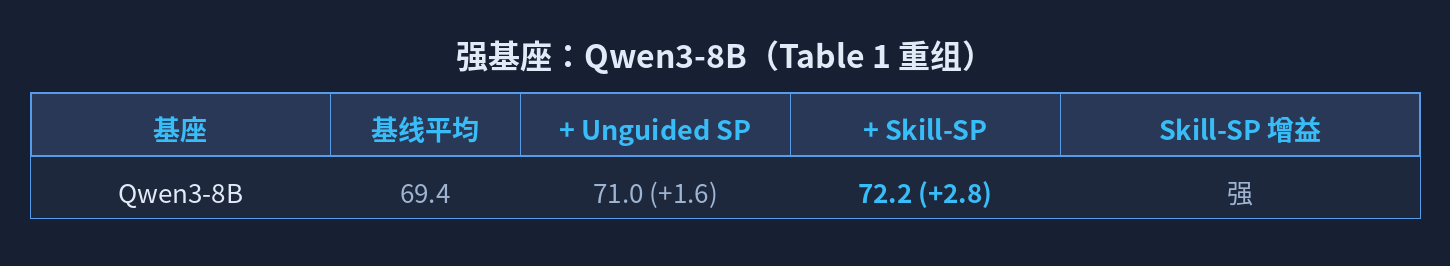
Paper effectue des évaluations dans deux domaines : l’appel d’outils (API-Bank + BFCL en quatre catégories) et le raisonnement logique (ZebraLogic en quatre niveaux de difficulté). Le tableau 1 présente les données principales, que j’ai réorganisées en fonction de la « taille du modèle de base » :
Une base solide au-dessus de 8B (Qwen3-8B)
Un socle faible de moins de 8B (comme le Ministral-3-8B, qui est déjà difficile à entraîner)
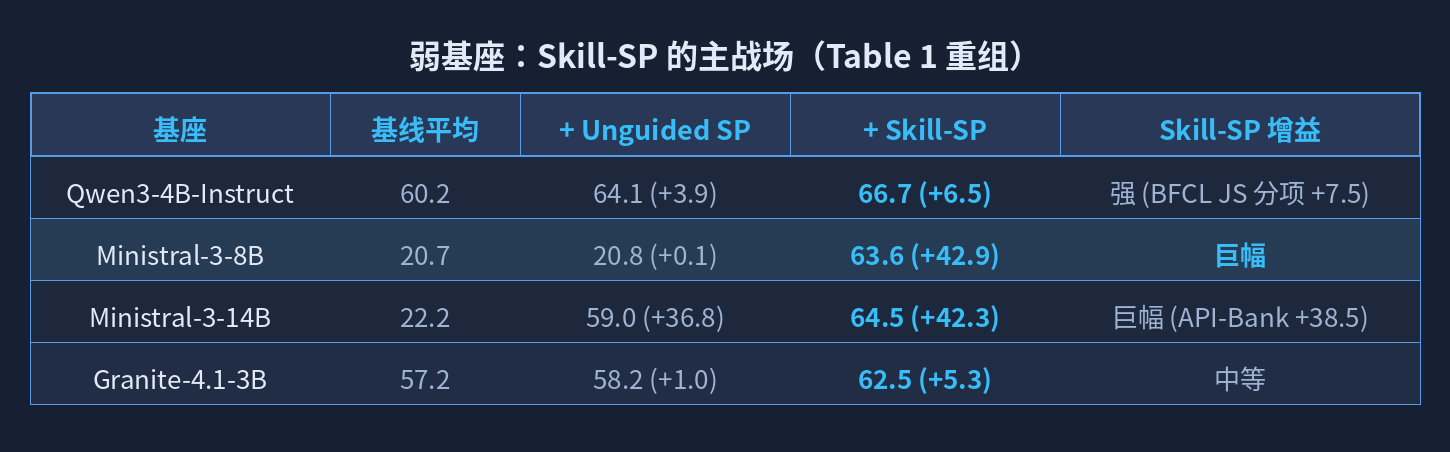
Le passage le plus intéressant de ce tableau est la ligneMinistral-3-8B: le socle n’a que 20,7 points (ce qui signifie qu’il n’est pas très doué pour régler les outils), le SP non guidé est totalement inutile (+0,1), mais le Skill-SP atteint directement 63,6 (+42,9). C’est parce que le Ministral, avec un socle faible, ne sait même pas « quelles questions poser ». Le SP non guidé lui permet de s’exprimer librement = de poser des questions inutiles. Le Skill-SP, avec sa bibliothèque de compétences, équivaut à lui donner une connaissance a priori de « quelles questions d’utilisation des outils je devrais poser », c’est comme lui donner une couche supplémentaire de curriculum.
En comparaison avec Qwen3-8B, qui est déjà une base très puissante, Skill-SP peut également progresser (+2,8), mais l’amélioration est nettement moins importante. Cela confirme un intuition industrielle :le bénéfice marginal de l’entraînement auto-compétitif est inversement proportionnel à la puissance de la base— plus la base est faible, plus elle a besoin d’être guidée par un curriculum, et plus la base est puissante, plus elle peut être autonome. Ce n’est pas un hasard si l’équipe de Qwen a mis l’accent sur le point fort de Skill-SP, qui est ladisponibilité rapide de petits modèles.
V. Expérience de fusion : quel composant va-t-il céder s’il est coupé ?
L’effet de disparition du papier est plutôt subtil, et il est principalement obtenu en jouant sur quatre dimensions :
Coupe 1 : Aucune compétence de routage (SP non guidé)
Il s’agit d’une comparaison de base, que nous avons déjà vue : dans les scénarios de petit modèle, il n’y a pratiquement pas d’augmentation (+0,1 pour Ministral-3-8B), et dans les scénarios de grand modèle, il y a une légère augmentation (+1,6). Conclusion : le routage des compétences est la valeur fondamentale. Le supprimer complètement reviendrait à le réduire à un jeu autonome ordinaire.
Hack 2 : Uniquement en mode Skill-only (100% de flux de compétences, sans exploration)
L’entraînement axé uniquement sur les compétences fait baisser le score sur tous les socles, avec une baisse moyenne de 4,1. Explication intuitive : si les questions sont uniquement basées sur les compétences existantes, la répartition des tâches se rétrécira progressivement à quelques compétences fréquentes. Les solveurs deviendront très compétents dans ces compétences, mais leurs capacités générales se dégraderont (typiquement un surapprentissage de la distribution d’entraînement).
Coupe 3 : Bibliothèque de compétences statiques (compétences gelées)
La compétence gelée (la compétence n’évolue pas dynamiquement pendant l’entraînement) perd en moyenne 2,3 points. Cela montre que les trois fonctions du Skill Controller (mise à jour, archivage et induction) sont réellement opérationnelles et non décoratives.
Coupe 4 : routage uniforme (routage non dynamique basé sur les retours d’exécution)
Le routage uniforme a obtenu une note moyenne de 1,9. Cela montre que le routage dynamique (le contrôleur décide quel compétence doit être entraînée en fonction de la performance réelle du solveur dans différentes compétences) est plus efficace que l’attribution statique.
En résumé, les quatre éléments de dissolution peuvent être résumés en une phrase :Chaque couche de Skill-SP est nécessaire, et la suppression d’une seule couche peut nuire à l’effet, en particulier pour les petits modèles.
六、读完论文后,我认为值得提醒的几点
(Ci-dessous, ce sont mes conclusions basées sur le contenu de l’article, qui ne sont pas toutes celles que l’article lui-même avance.)
1. L’entraînement coûte cher
L’article ne précise pas le nombre exact d’heures GPU, mais 5 itérations × 5 modèles de différentes tailles + deux domaines de tâches, cela représente au minimum plusieurs milliers d’heures GPU. Ce n’est pas quelque chose qu’un développeur individuel peut reproduire directement. Si vous voulez essayer par vous-même, il est conseillé de commencer par utiliser un modèle de niveau 7B pour effectuer 1 à 2 itérations de test, afin de voir si la base de compétences peut se développer de manière stable.
2. La graine initiale de la bibliothèque de compétences est cruciale
L’article n’explique pas en détail comment la base de compétences initiale est créée (les équipes de Qwen ont-elles manuellement étiqueté des centaines de compétences ? Ou les liens d’Induce ont-ils été générés par plusieurs cycles de bootstrap ?), mais il est probable que des équipes comme Qwen utilisent des données de référence manuelles. Si vous voulez le faire vous-même,ce n’est pas l’algorithme d’apprentissage par renforcement qui mérite le plus d’investissement, mais la qualité initiale de la base de compétences. C’est un modèle courant dans les projets industriels de « roue de données » : les données de référence manuelles déterminent le plafonnement initial, tandis que l’évolution automatique assure l’amélioration continue par la suite.
3. Les scénarios d’application ont des limites
Les deux domaines validés par l’article (appel d’outils + raisonnement logique) sont des scénarios avec descontrats clairement vérifiables par machine. Si vous vous intéressez à des scénarios sans contraintes de coût (tels que des conversations ouvertes ou de l’écriture créative), Skill-SP n’est pas directement applicable. Cependant, le principe peut être utilisé : diviser la « qualité de la tâche » en un proxy vérifiable par machine (par exemple, longueur, score de diversité, style d’intégration), appliquer une récompense contrôlée, et l’essence reste la même.
- Ce n’est pas du RLHF, mais c’est complémentaire du RLHF.
L’article utilise des algorithmes d’apprentissage par renforcement (RL) tels que GRPO pour entraîner Proposer + Solver (l’article ne précise pas lequel, mais d’après les références au code, il s’agit du framework VERL). Cela diffère de la « formation du modèle de récompense » de RLHF —— la récompense de Skill-SPprovient directement de l’environnement, sans l’étape du modèle de préférence humaine. Cela le rend plus stable que RLHF dans les scénarios où la « récompense est vérifiable », mais inversement, il doit toujours s’appuyer sur RLHF dans les scénarios où la « récompense nécessite un jugement humain ». Les deux paradigmes ne sont pas en concurrence.
VII. Résumé en une phrase
La philosophie d’ingénierie de Skill Self-Play est la suivante :reconnaître que le LLM génère librement des résultats peu fiables, mais ne pas restreindre complètement sa marge de manœuvre — le placer dans une bibliothèque de compétences vérifiable, évolutive et évolutive, et le laisser s’exprimer librement dans cette bibliothèque. Cette approche est indispensable pour ceux qui s’occupent de la formation du LLM, mais aussi pour ceux qui travaillent sur des systèmes d’agents. Vous n’avez pas besoin du cadre complet Skill-SP, mais l’abstraction “maintenance dynamique d’une bibliothèque de compétences” vous sera probablement utile pour vos propres projets.
Le texte intégral de l’article est disponible sur arXiv : 2607.22529. Conformément aux pratiques de l’équipe Qwen, le code et les pondérations du modèle seront mis à disposition sur HuggingFace. Pour suivre les prochaines versions, rendez-vous sur le dépôt Qwen.
Lien de référence
- Article arXiv : https://arxiv.org/abs/2607.22529
- Page d’accueil de l’équipe Qwen sur Hugging Face : https://huggingface.co/Qwen