Per prima cosa, diamo un’occhiata a tre casi reali di fallimenti clamorosi.
Chiedendo al modello di girare una performance di musica tradizionale cinese, gli strumenti e i caratteri che appaiono sullo schermo non corrispondono a quelli della vera musica tradizionale cinese. Quando gli si chiede di girare un matrimonio nigeriano, gli abiti degli ospiti e gli oggetti cerimoniali sono tutti “generici”, senza alcun accenno di stile nigeriano. Quando gli si chiede di girare una partita di Shogi giapponese, la scacchiera e i pezzi si trasformano direttamente in quelli degli scacchi occidentali.
Le immagini in sé non hanno alcun problema, la luce, il movimento e la nitidezza sono tutti ottimi, ed è proprio questo il problema. I video di Wen Sheng sono così realistici da risultare difficili da distinguere da quelli reali e, quanto più le immagini sono realistiche, tanto più i problemi culturali divengono nascosti e allo stesso tempo evidenti. Un video realizzato per i mercati esteri con abbigliamenti e rituali sbagliati verrebbe immediatamente riconosciuto dagli abitanti del luogo e, nel migliore dei casi, sarebbe motivo di scherno, nel peggiore, di offesa.
Il documento arXiv 2608.01942 intitolato “CultureVidBench: Benchmarking Cultural Understanding in Text-to-Video Generation” ha creato un set completo di domande per questo scopo: 12 Paesi, 1.000 domande, 7 modelli che competono insieme, con un focus specifico sulla comprensione culturale nella generazione di testo in video. L’autore principale, Xianjing Han, proviene dalla Nanyang Technological University, mentre l’autore corrispondente, Bin Zhu, viene dalla Singapore Management University. Tra i collaboratori figurano anche Centrale Supélec e l’Università di Cambridge. L’ho letto per intero e il valore di questo articolo non sta in un singolo punteggio, ma nel fatto che per la prima volta trasforma la domanda “L’IA comprende la cultura?” da una questione intuitiva a un problema ingegneristico quantificabile.
Perché le valutazioni precedenti non riuscivano a misurare la cultura?
I video di recensione di Wensheng non mancano, e utilizza continuamente i principali benchmark come VBench e EvalCrafter. Tuttavia, questi si concentrano su aspetti come la qualità grafica, la fluidità dei movimenti, la plausibilità fisica e la pertinenza del tema. Altri test valutano le conoscenze di fisica o l’affidabilità dei robot, ognuno con un proprio ambito di competenza.
Per quanto riguarda la dimensione culturale, nessuno l’ha praticamente testata in modo sistematico dal lato video. Per quanto riguarda l’aspetto testuale, invece, alcuni lo hanno fatto: ViSAGe e CUBE-1K hanno entrambi esaminato il concetto di cultura, ma le immagini sono statiche, quindi non è possibile verificare se i movimenti siano corretti o se i suoni siano appropriati. La cultura nei video è viva: i rituali hanno una procedura, le scene sono accompagnate da musica e i cartelli recano delle scritte. Questa lacuna è ciò che CultureVidBench intende colmare.
Il primo passo per colmare le lacune è la preparazione dei questionari, e la qualità di questi ultimi determina direttamente la credibilità di tutte le conclusioni successive. Il lavoro svolto per preparare i questionari in questo articolo merita di essere discusso separatamente.
Come è stata creata una prova che copre 12 paesi?
Scegli prima il Paese.L’autore si è ispirato alla mappa culturale del World Values Survey, uno strumento di classificazione culturale comunemente utilizzato nel mondo accademico, per dividere il mondo in otto cerchi culturali, come il cerchio confuciano, il cerchio dei Paesi anglofoni e il cerchio islamico africano. Per ogni cerchio è stato selezionato un rappresentante, per un totale di 12 Paesi sparsi su 6 continenti. È importante notare la scelta deliberata di questa lista: include sia Paesi molto visibili come Stati Uniti, Cina e India, che sono molto presenti su Internet, sia Paesi con scarse risorse come Etiopia, Nigeria e Malesia. Come vedremo in seguito, questa scelta consente di trarre una delle conclusioni più importanti dell’intero testo.
Domanda di ricostruzione.L’autore ha suddiviso la cultura in tre categorie principali: cultura materiale (cibo, abbigliamento, architettura, decorazioni, oggetti visibili e tangibili), pratiche e spettacoli sociali (saluti, pasti, danza, sport, attività religiose, cose che le persone fanno) e cerimonie (matrimoni, funerali, intere procedure). Le tre categorie sono suddivise in 14 aspetti, raccogliendo 828 elementi culturali da materiali culturali di vari Paesi, che sono stati infine trasformati in 1.000 parole chiave - 270 per la cultura materiale, 386 per le pratiche e 344 per le cerimonie, con una media di 12,8 parole inglesi per ciascuna di esse.
La qualità dei titoli è controllata manualmente.Ogni parola chiave viene inserita in un modello per generare un titolo: la cultura materiale è “chi + fa cosa + porta quali elementi culturali + in quale paese”, ad esempio “Una donna sta servendo feijoada su un piatto in un ristorante brasiliano”; per quanto riguarda i rituali, poiché si tratta di una serie di procedure, queste vengono suddivise in attività secondarie, come ad esempio la cerimonia del tè cinese per matrimoni, che viene suddivisa in tre fasi: inginocchiarsi davanti ai genitori, offrire il tè e ricevere i pacchetti rossi. I titoli candidati devono passare attraverso due correttori umani, che verificano se la descrizione è naturale, se la cultura è corretta e se l’immagine può essere realizzata.
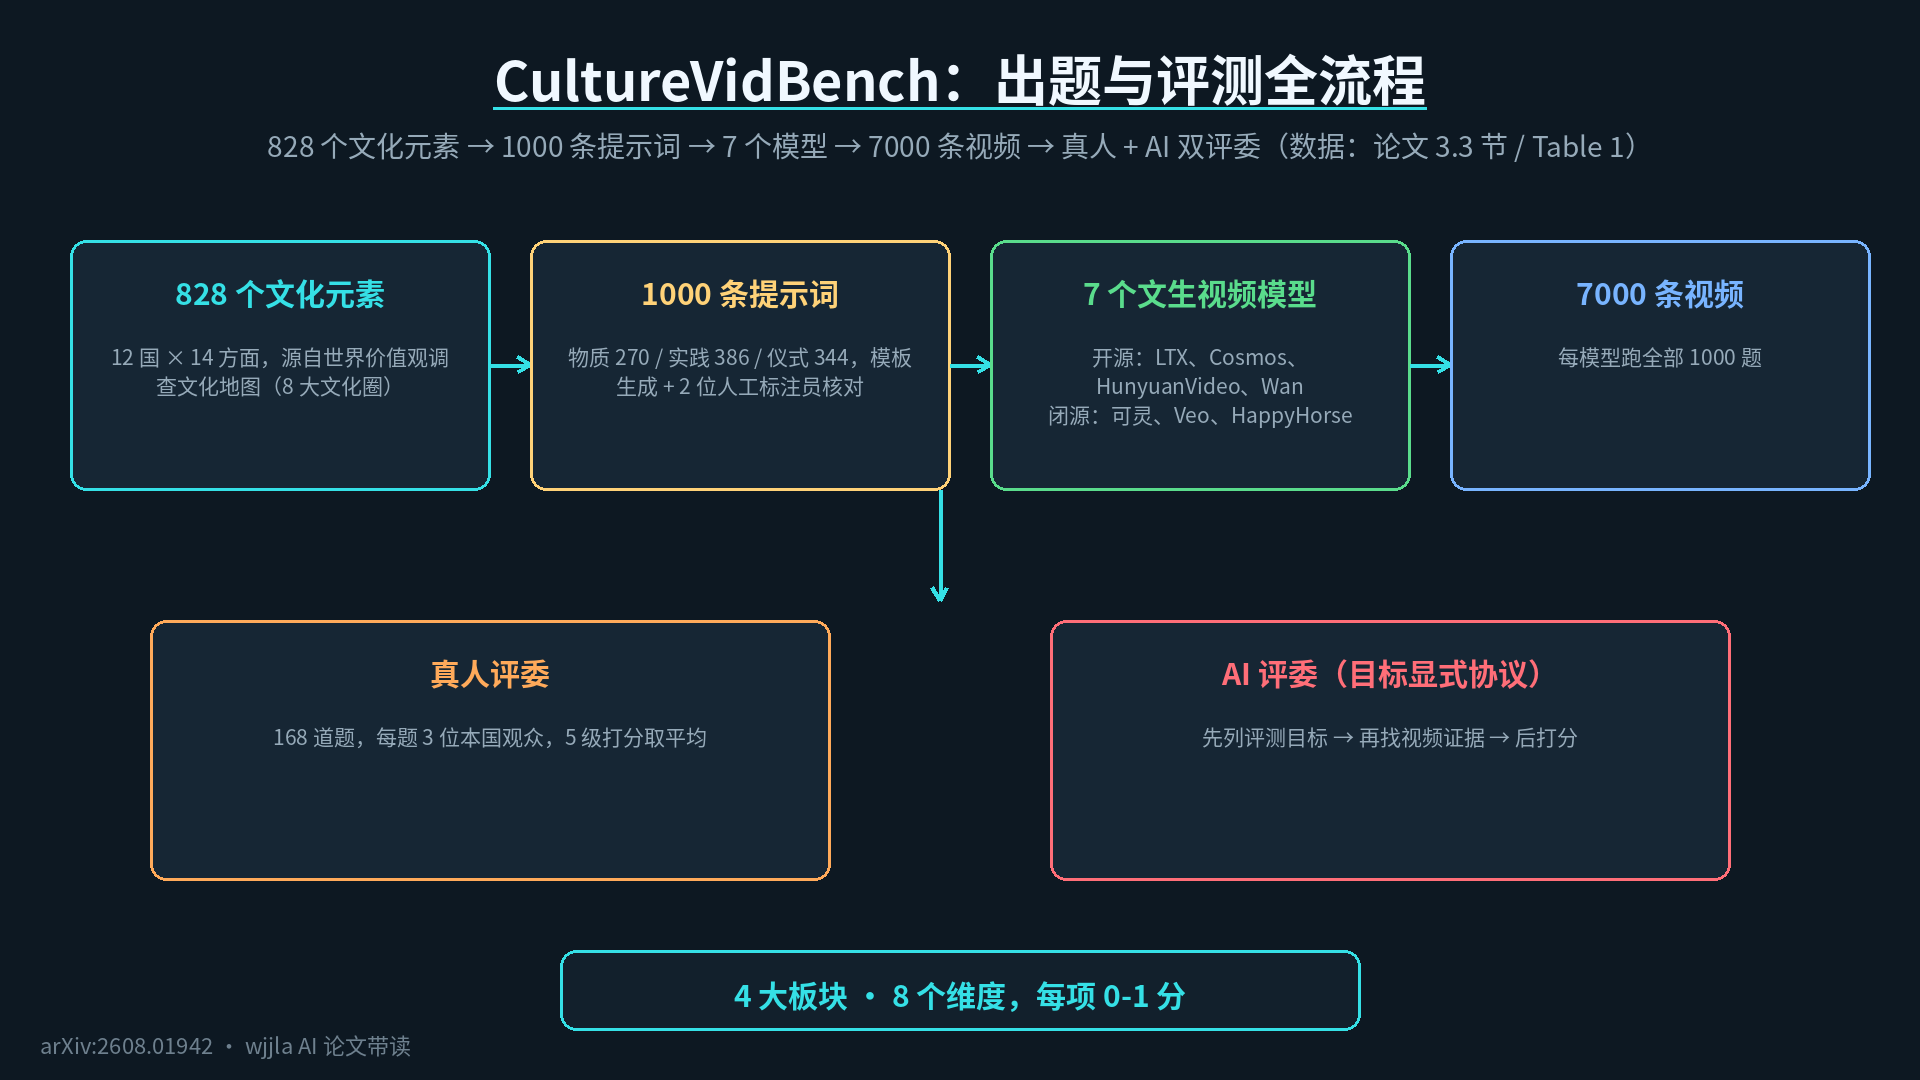
L’intera catena di produzione è illustrata nella figura: 828 elementi culturali → 1000 parole chiave → 7 modelli ciascuno eseguiti una volta per generare 7000 video → due set di giudici, uno umano e uno artificiale, assegnano i punteggi. I candidati sono 4 modelli open source (LTX-2.3-22B, Cosmos-Predict-2.5-14B, HunyuanVideo-1.5, Wan-2.2-14B) e 3 modelli proprietari (Kling-3.0, Veo-3.1-Fast, HappyHorse-1.0 di Alibaba).
Come assegnare un punteggio: due grandi problemi suddivisi in 8 piccole voci.
Il sistema di valutazione è stato progettato in modo chiaro, con ogni video che risponde a due domande principali:
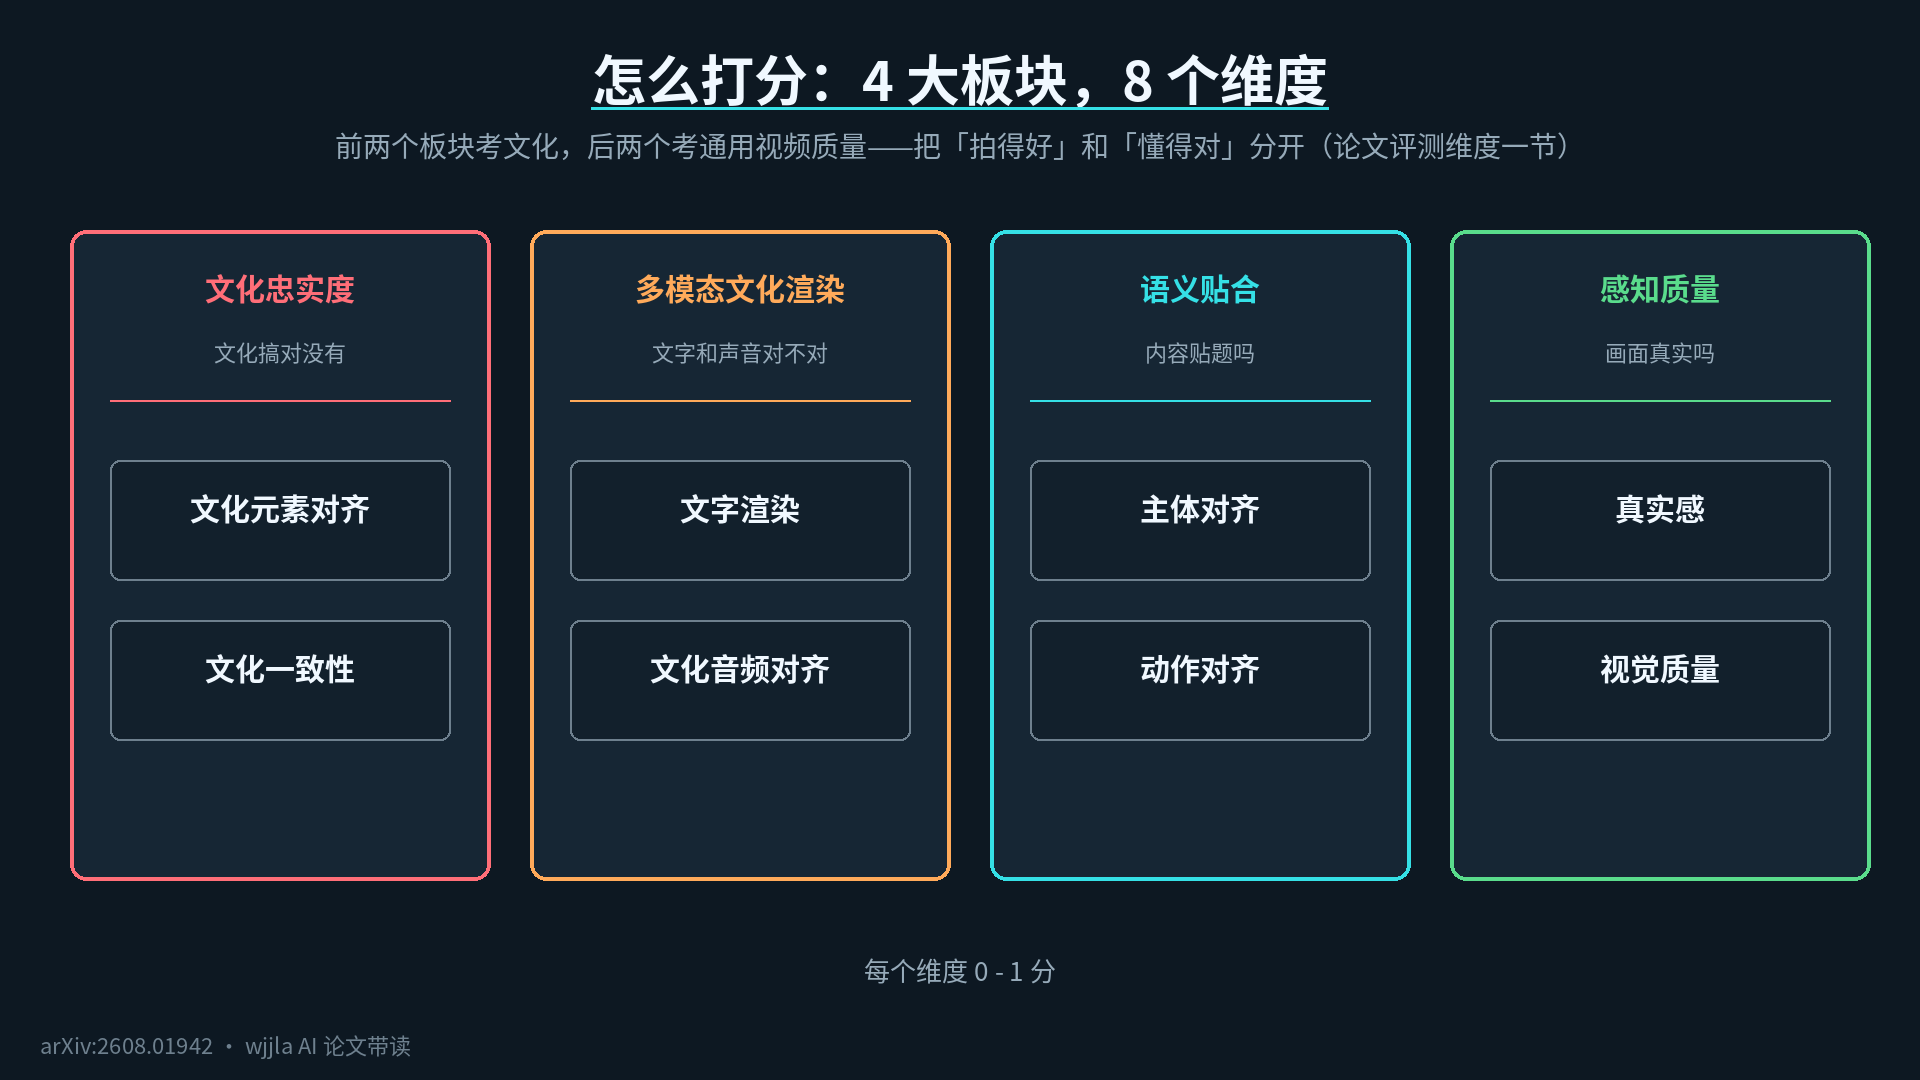
- La cultura è stata gestita correttamente?(Fedeltà culturale): Gli elementi culturali previsti sono presenti (allineamento degli elementi culturali)? Ci sono elementi provenienti da altri Paesi (coerenza culturale)?
- Il video è buono di per sé?(Corrispondenza semantica + qualità percepita): Il soggetto e le azioni sono pertinenti? Le immagini sono realistiche?
Ogni elemento vale da 0 a 1 punto. Inoltre, c’è una sezione separata che valuta la rappresentazione multimodale della cultura: i testi nelle immagini, i suoni sullo sfondo - i cartelli in caratteri cinesi nelle scene giapponesi, la musica tradizionale durante i matrimoni - sono tutti in questa categoria. Il fatto che i testi e i suoni siano elencati separatamente è una caratteristica unica di questo test, che potrebbe creare grandi problemi in futuro.
I giudici sono divisi in due gruppi. I giudici umani hanno selezionato 168 domande (14 aspetti × 12 Paesi), ognuna delle quali è stata valutata con un punteggio da 5 stelle da 3 spettatori locali e la media è stata calcolata: un processo costoso, ma rappresenta lo standard d’oro. I giudici IA hanno utilizzato un protocollo target-explicit progettato dagli autori, che in parole semplici non consente all’IA di assegnare punteggi in base alle proprie sensazioni: nel primo passo, viene indicato all’IA l’oggetto della domanda; nel secondo passo, l’IA deve trovare le prove pertinenti nel video; nel terzo passo, l’IA assegna un punteggio in base alle prove. La validità di questo protocollo è stata verificata in un apposito foglio di calcolo.
Trascrizione dei voti: c’è un abisso tra open source e closed source.
La Tabella 1 della pagina 6 è la tabella più importante di tutto il documento. Iniziamo con le valutazioni in tempo reale della colonna “Elementi culturali allineati”:
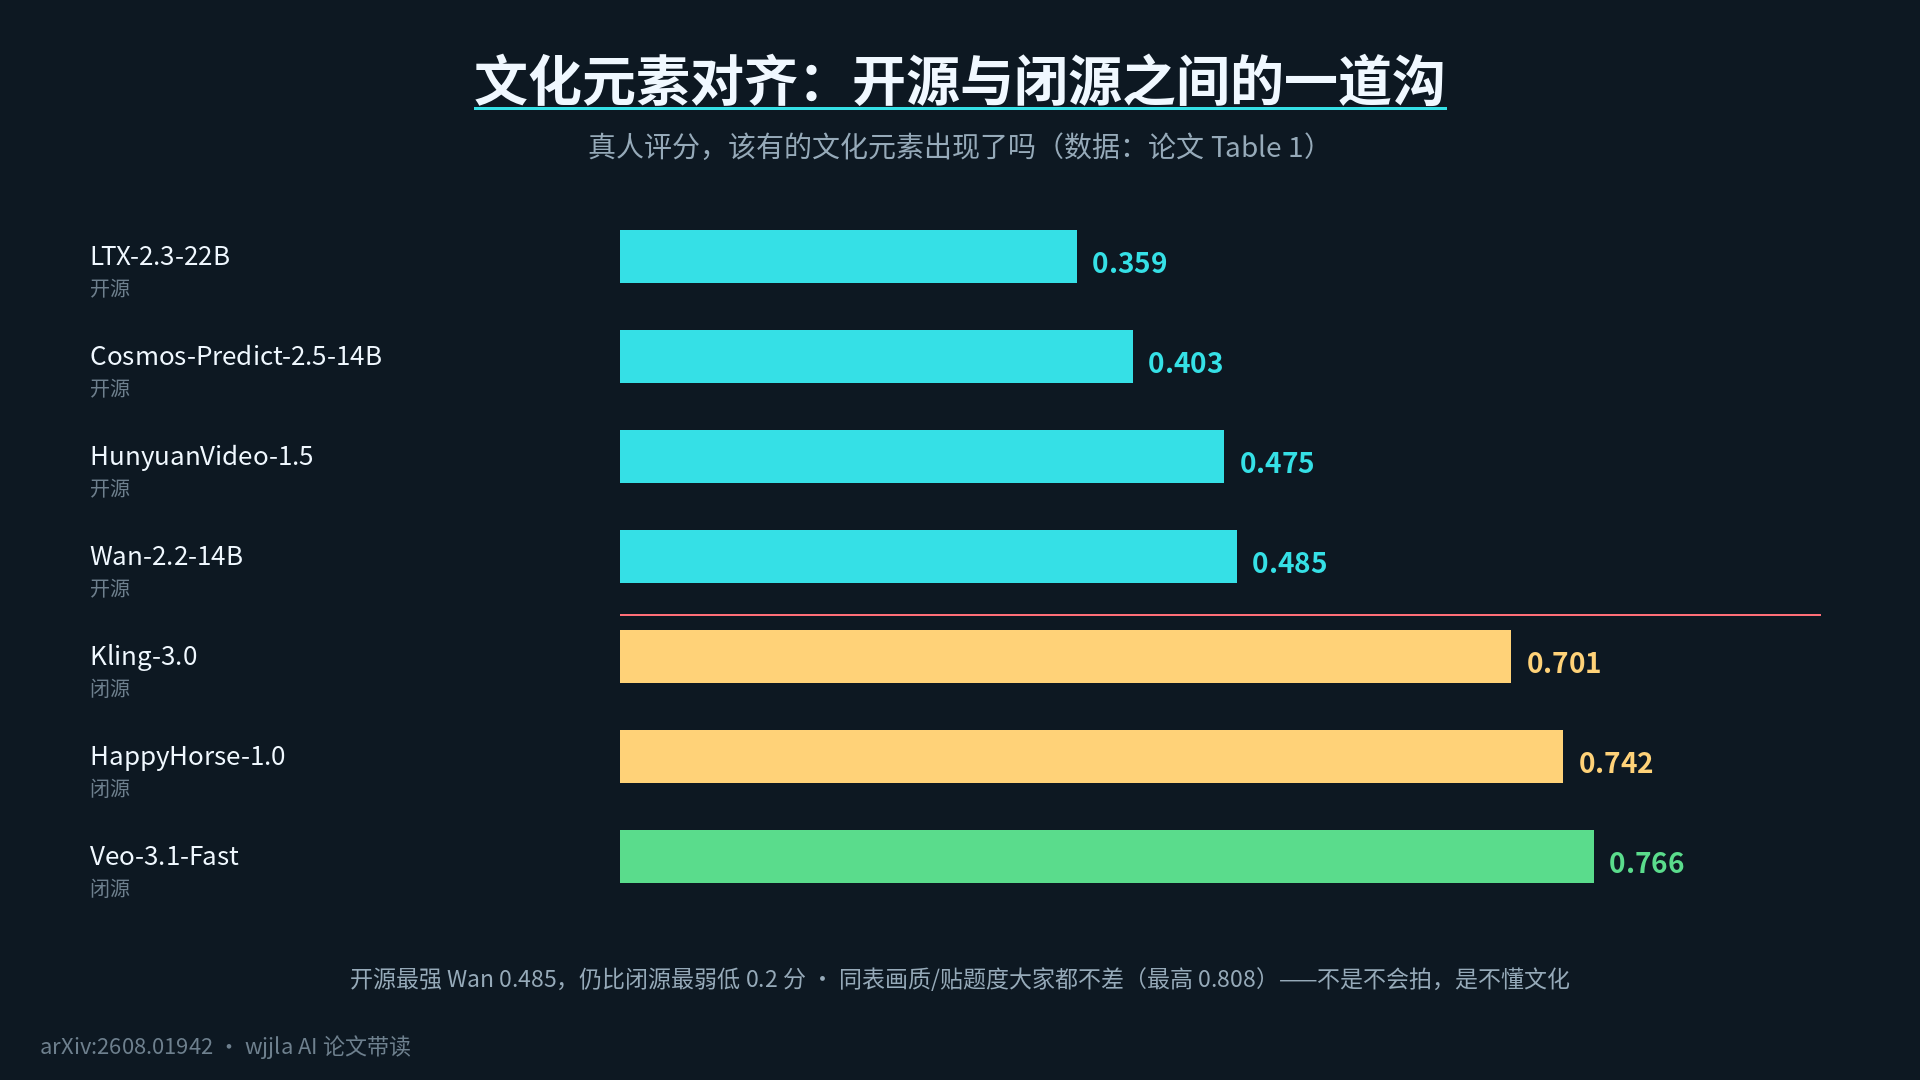
I quattro modelli open source sono tutti compresi tra 0,359 e 0,485, mentre i tre modelli proprietari passano direttamente da 0,701 a 0,766. Il migliore è Veo-3.1-Fast con 0,766, HappyHorse-1.0 con 0,742 e Kling-3.0 con 0,701; il più forte open source, Wan-2.2-14B, ha solo 0,485, che è ancora 0,2 punti inferiore al più debole proprietario. Un divario evidente a occhio nudo.
Ma la stessa tabella nasconde un’altra informazione fondamentale: le capacità generiche come la qualità delle immagini e la pertinenza al tema non sono un problema per nessuno, con punteggi che vanno tutti sopra lo 0,49, raggiungendo un massimo di 0,808. Considerando insieme le due cose, la conclusione è inequivocabile:il modello non è incapace di girare video, ma non capisce veramente la cultura.La mancanza di cultura e la scarsa capacità di generazione sono due cose diverse, ed è proprio questo il motivo per cui il test le ha valutate separatamente.
La colonna più deludente di tutte: la resa del testo.
Nella Tabella 1 c’è ancora una colonna che è ancora più difficile da allineare rispetto alla cultura: la resa testuale delle immagini.
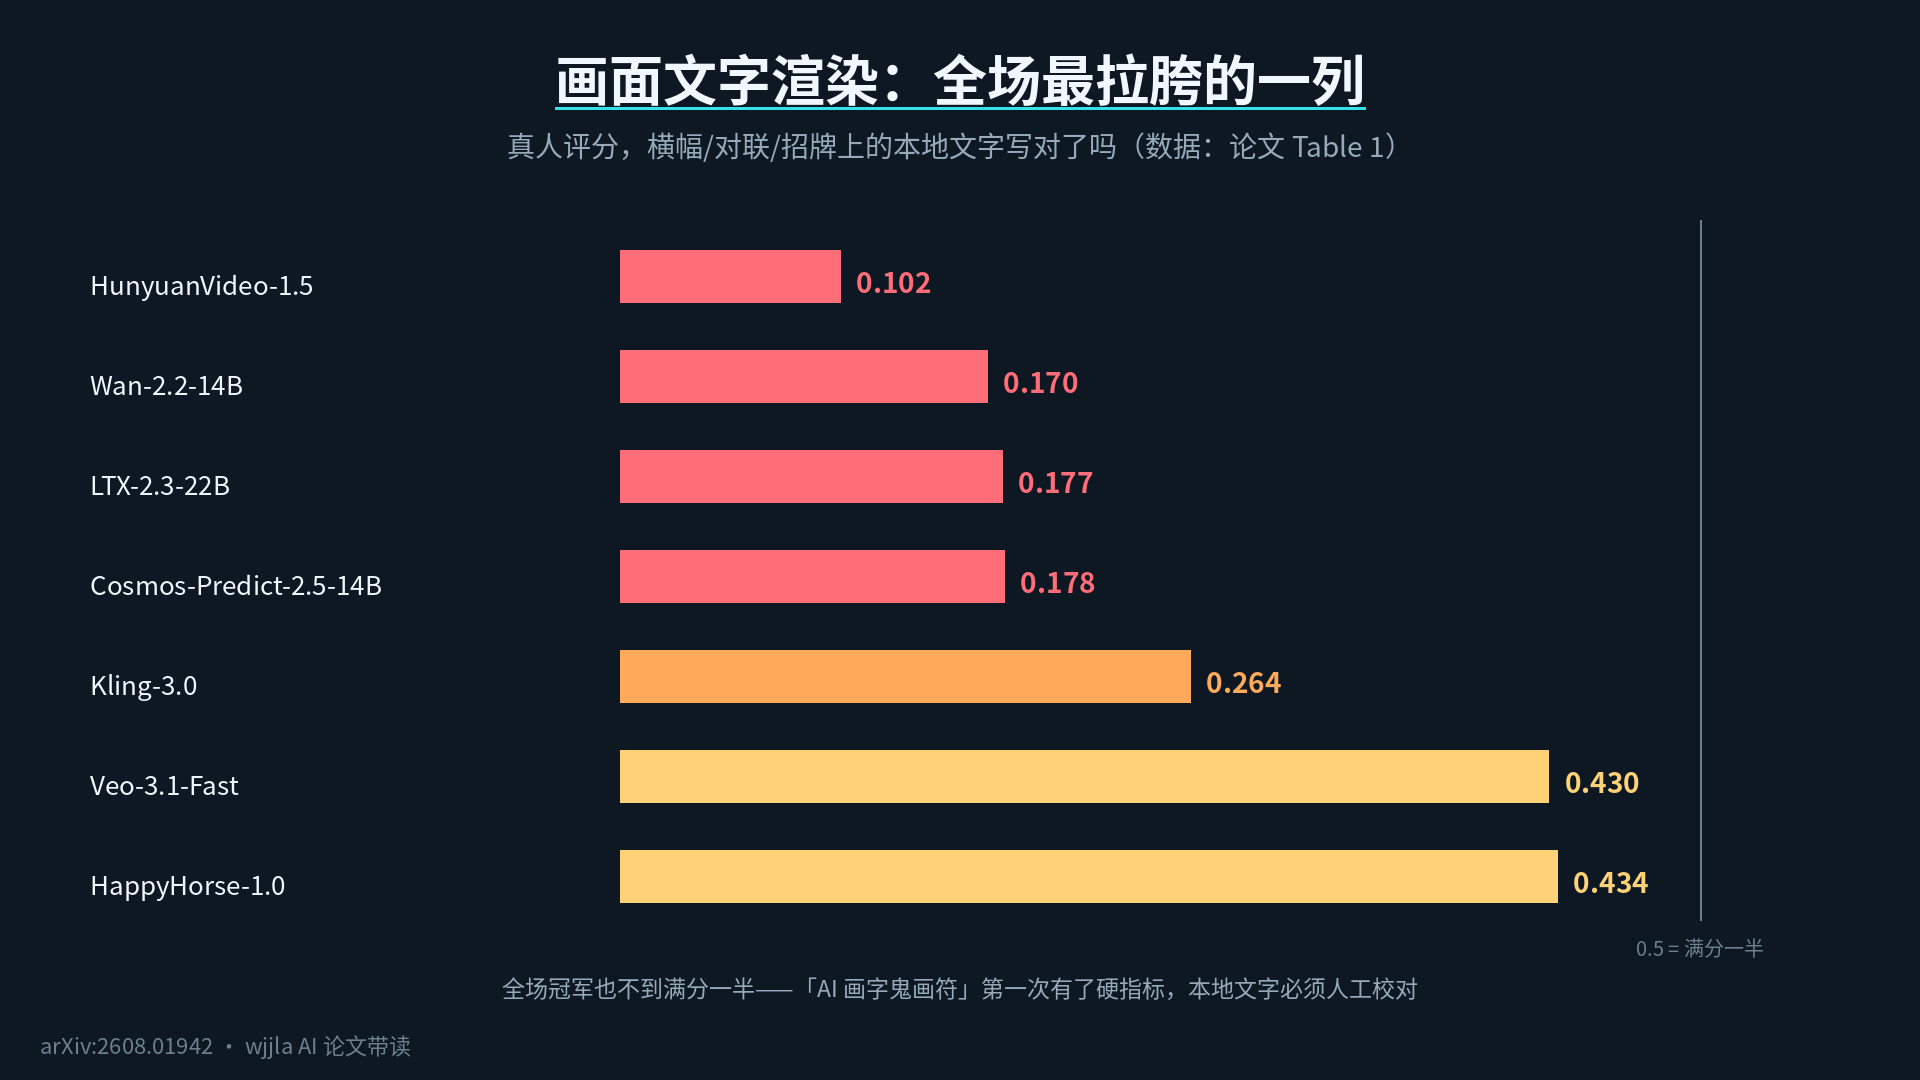
Il miglior risultato del gruppo open source per Cosmos-Predict-2.5-14B è stato di 0,178, mentre quello di HunyuanVideo-1.5 è stato di 0,102; il gruppo proprietario ha ottenuto risultati migliori, con il miglior punteggio di HappyHorse-1.0 che è stato di 0,434, che non raggiunge nemmeno la metà del punteggio massimo. I caratteri locali su banner, distici e insegne non sono stati scritti correttamente dall’IA. La frase “L’IA scrive caratteri come dei geroglifici”, che circola online, ha ora un indicatore concreto. Conclusione pratica: ogni volta che un video contiene caratteri locali, è necessario controllarlo manualmente prima della pubblicazione, poiché al momento nessun modello può sostituire questo controllo.
È possibile fidarsi dei giudici IA? La scommessa di Table 2.
L’uso dell’IA come giudice ha lo scopo di rendere la valutazione su larga scala (la valutazione umana di 168 domande richiede già un investimento considerevole), ma ci si può fidare dei punteggi assegnati dall’IA? La Tabella 2 risponde a questa domanda utilizzando i coefficienti Kendall τ e Spearman ρ medi nazionali: quanto più il valore è vicino a 1, maggiore è la coerenza tra la classifica dell’IA e quella umana.
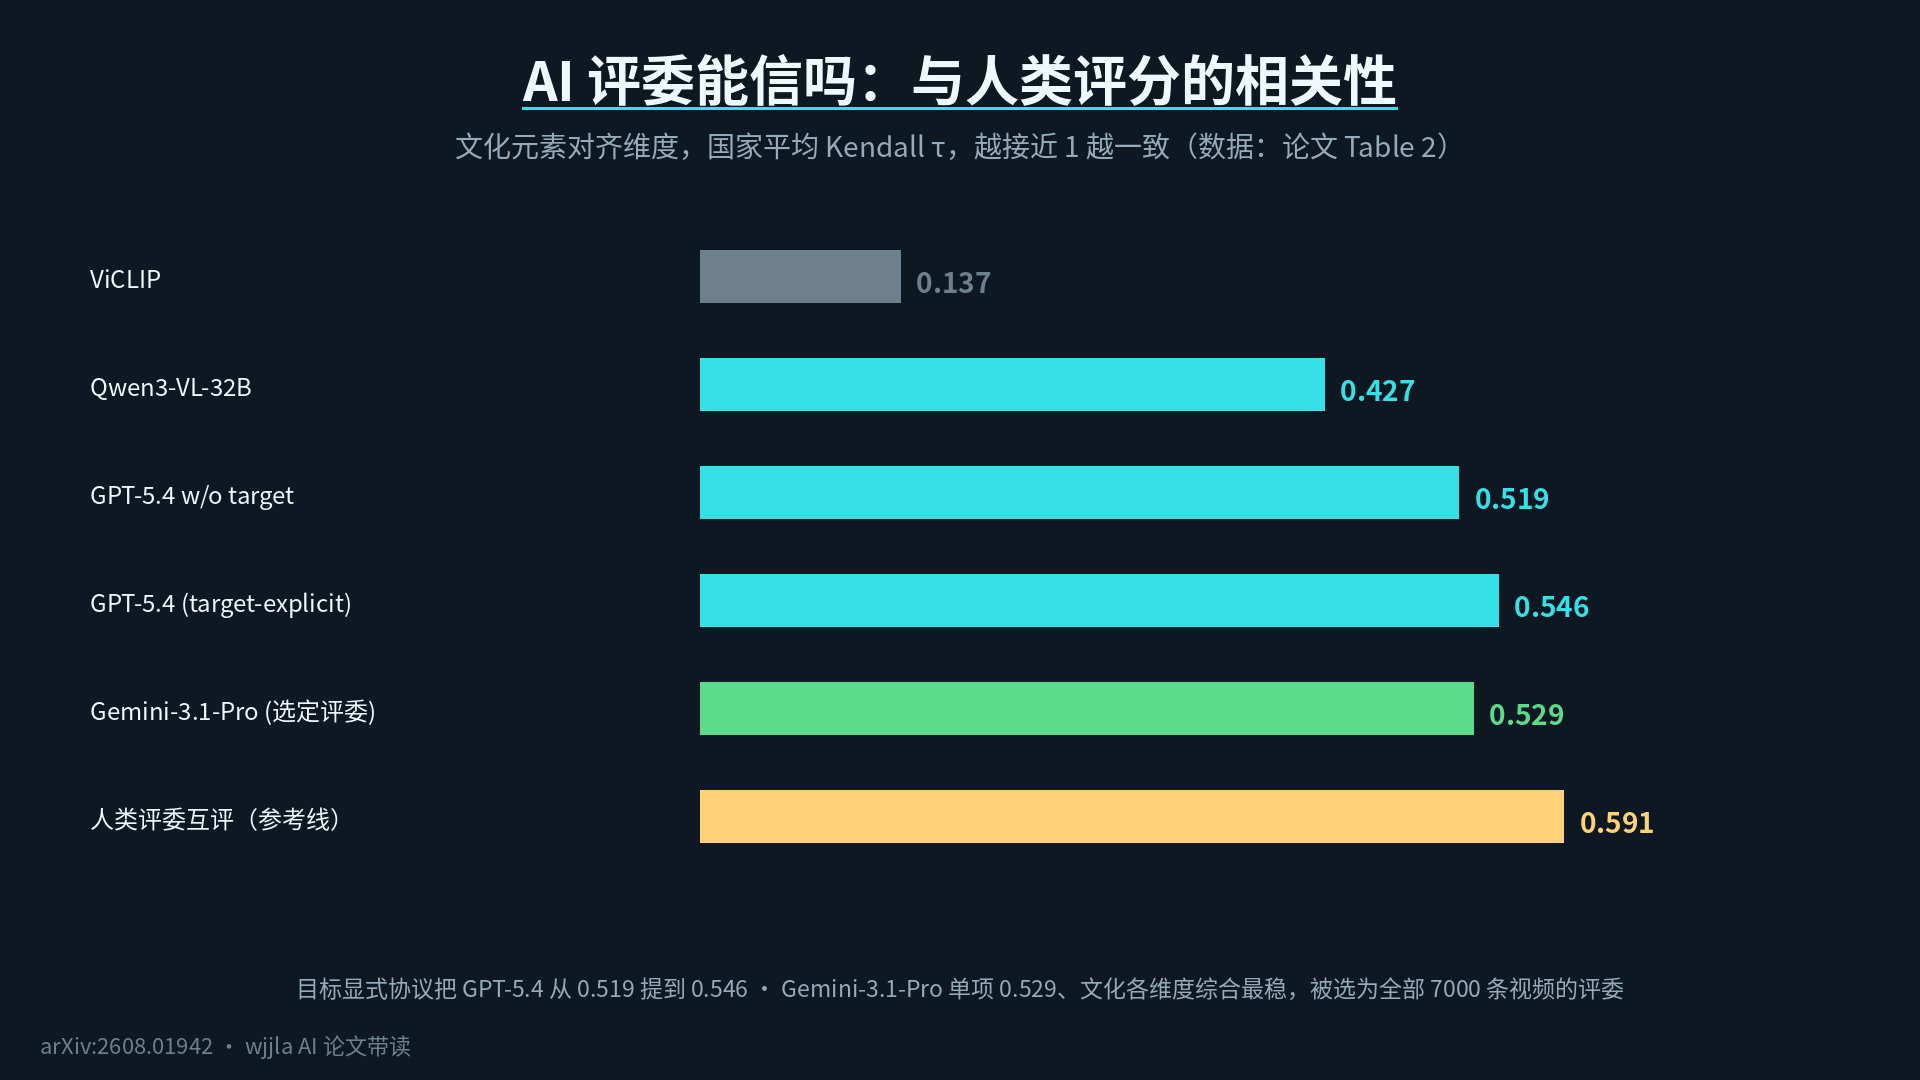
I modelli più piccoli non funzionano molto bene: il modello di piccole dimensioni ViCLIP per la somiglianza tra immagini e testi ha ottenuto un punteggio di soli 0,137, mentre Qwen3-VL-32B ha raggiunto 0,427. Dopo l’utilizzo del protocollo esplicito degli obiettivi, GPT-5.4 ha migliorato l’allineamento degli elementi culturali da 0,519 a 0,546, dimostrando l’efficacia del protocollo stesso. L’autore ha infine scelto Gemini-3.1-Pro come giudice: questo ha ottenuto un punteggio di 0,529. Anche se i singoli punteggi sono leggermente inferiori a quelli di GPT-5.4, l’allineamento complessivo di tutte le dimensioni culturali è più stabile (coerenza culturale 0,521, rendering testuale 0,527). L’autore ha utilizzato questo modello per valutare tutti i 7.000 video.
Il riferimento fondamentale è la correlazione tra i giudici umani: 0,591. Questo significa che i migliori giudici di IA si stanno avvicinando al livello di coerenza tra i giudici umani nella dimensione culturale - la valutazione culturale è passata da “è necessario chiedere a qualcuno” a “è possibile far passare prima l’IA”. Tuttavia, per quanto riguarda le dimensioni soggettive come il Realismo e la Qualità Visiva, la coerenza umana è bassa e l’IA non può ottenere buoni risultati, quindi è meglio non prendere troppo sul serio questi punteggi.
Tra un paese e l’altro: un divario di 0,3 punti.
Nella pagina 7, la Figura 5 ripartisce i punteggi per Paese; questa tabella (i numeri precisi sono riportati nell’appendice) potrebbe essere la pagina più utile di tutto il testo per i professionisti del settore:
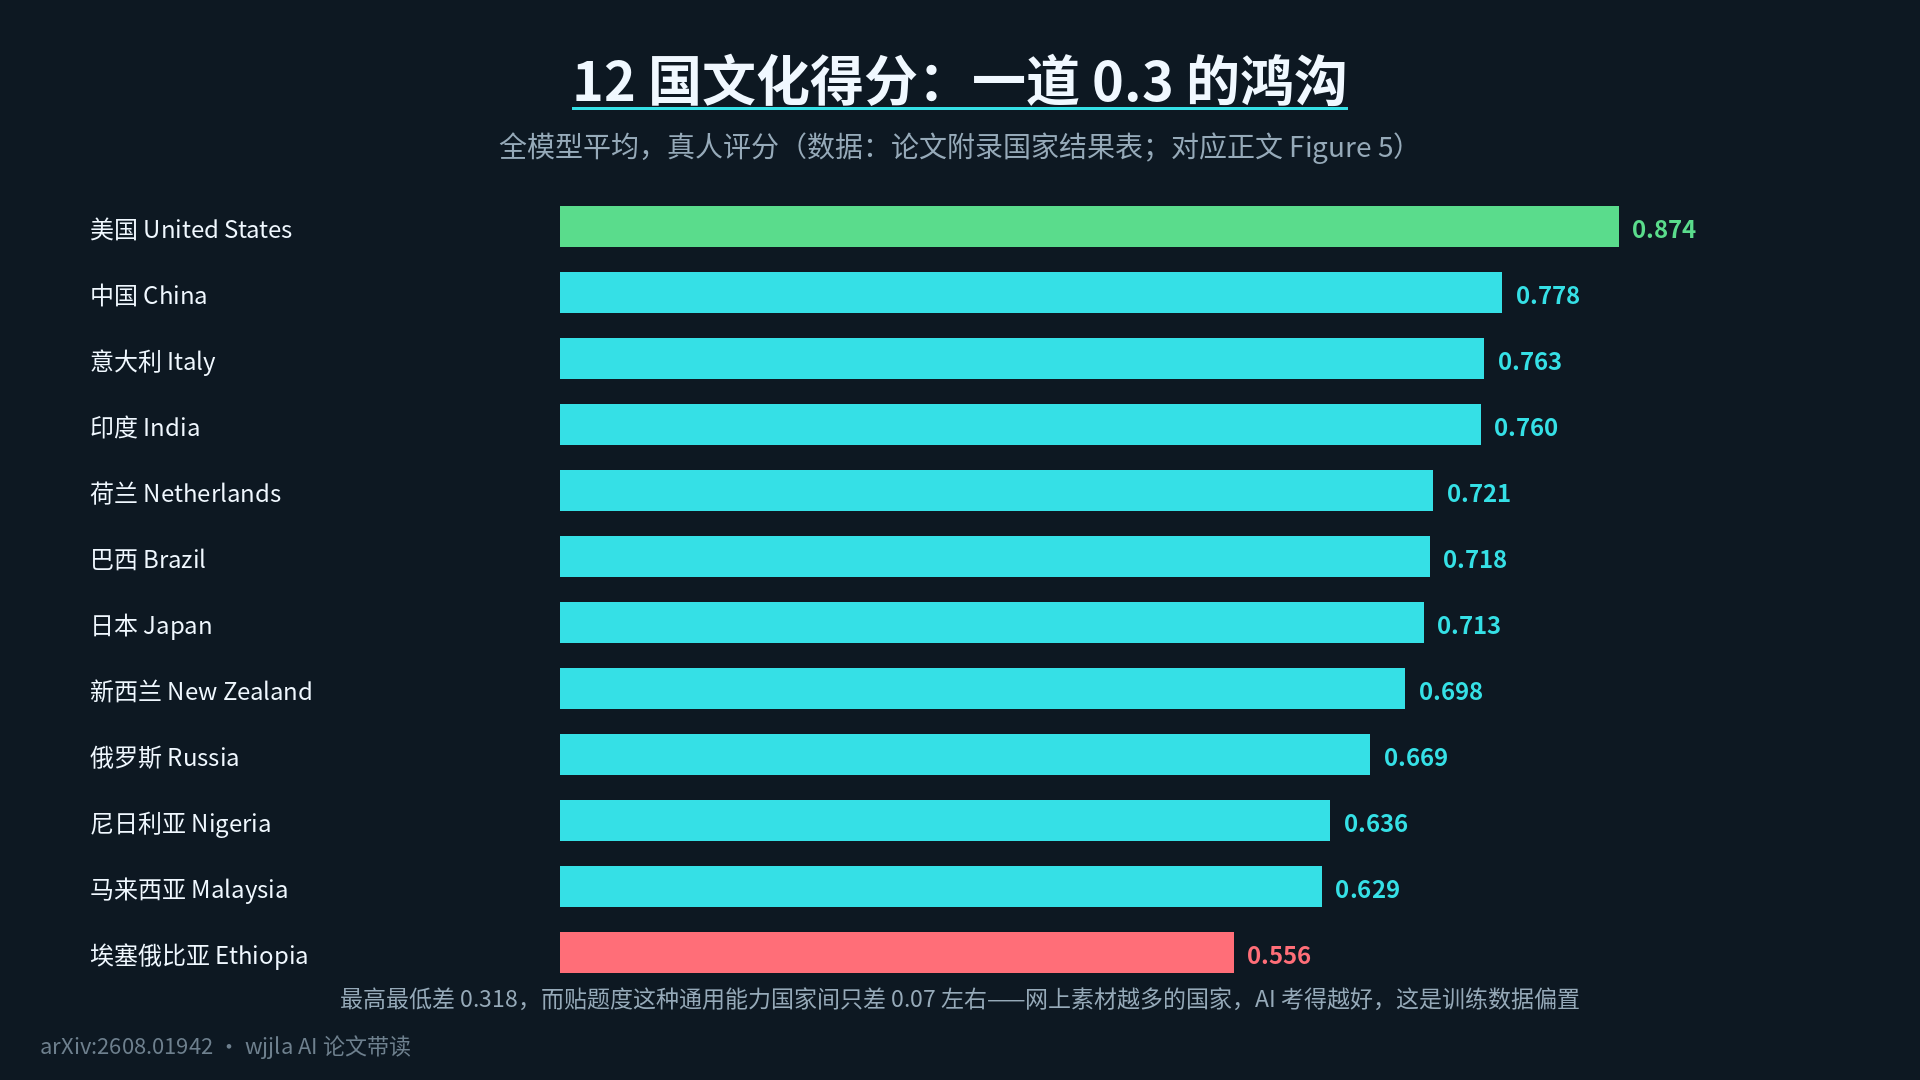
Gli Stati Uniti si trovano al primo posto con un punteggio di 0,874, seguiti dalla Cina con 0,778, dall’Italia con 0,763 e dall’India con 0,760; poi Paesi Bassi con 0,721, Brasile con 0,718, Giappone con 0,713 e Nuova Zelanda con 0,698; successivamente Russia con 0,669, Nigeria con 0,636 e Malesia con 0,629; infine l’Etiopia, che si trova in fondo alla classifica con un punteggio di 0,556.
La differenza tra il punteggio più alto e quello più basso è superiore a 0,3. L’autore ha inoltre calcolato la dispersione tra i Paesi per ogni dimensione: la dimensione culturale è intorno a 0,3, mentre la dimensione generale come la pertinenza al contesto differisce solo di circa 0,07. In altre parole, tutti i modelli sono in grado di riconoscere correttamente “due persone che giocano a scacchi”, ma quando si tratta di dettagli culturali come il saluto alla spalla etiope o gli scacchi giapponesi, i punteggi si differenziano immediatamente. La regola è così evidente da risultare quasi sgradevole:quanto più un Paese ha materiale online, tanto meglio l’IA si comporta nel test. Non si tratta di intelligenza del modello, ma di pregiudizio dei dati di allenamento.
La figura 6 aggiunge un’altra osservazione: i modelli open source perdono più punti nei Paesi a basso reddito come l’Etiopia, la Malesia e la Nigeria, mentre i modelli proprietari perdono anch’essi, ma partono da una base più solida e, dopo la perdita, sono ancora in testa.
Quale cultura è più difficile da fotografare: gli oggetti sono facili, i processi sono difficili.
La Figura 8 classifica i 14 aspetti in base alla categoria culturale: la cultura materiale ottiene il punteggio complessivo più alto, le pratiche sociali e le performance al secondo posto, mentre i rituali e le cerimonie sono i più difficili. La diminuzione dei punteggi culturali rispetto ai punteggi semantici varia da un minimo del -15,6% per la categoria delle celebrazioni a un massimo del -30,9% per la categoria dell’abbigliamento.
Il principio è molto semplice: fotografare un oggetto è una questione di visione statica, mentre fotografare un intero processo spazio-temporale con una serie di fasi e interazioni è di un livello di difficoltà completamente diverso.
Le immagini reali del fallimento della Figura 7 sono la migliore dimostrazione: il gioco giapponese di Shogi, HappyHorse-1.0, ha una scena corretta, ma i caratteri sui pezzi sono tutti sbagliati; la croce ortodossa etiope, tutti i modelli non riescono a riprodurre il gesto di stringere le dita con il pollice; le decorazioni del Festival di Hari Raya in Malesia, HunyuanVideo-1.5, sono state direttamente rese in stile natalizio - i modelli di cultura ad alta risoluzione hanno letteralmente “sottratto il controllo” alle scene di cultura a bassa risoluzione.
Alcuni punti che vale la pena ricordare dopo aver letto
In primo luogo,non confondere il punteggio complessivo con la capacità. Il maggiore contributo metodologico di questo articolo è quello di separare la valutazione di “buona realizzazione” da quella di “buona comprensione”. Un modello con una qualità grafica di 0,8 e una cultura di 0,4 è ottimo per i contenuti locali, ma è un fallimento per i contenuti internazionali. La scelta del modello dipende da ciò che si desidera.
In secondo luogo,il vantaggio del software proprietario è reale, ma non dovrebbe essere idealizzato. Lo 0,766 significa che anche il leader del software proprietario ha più di un venti per cento di elementi culturali non correttamente tradotti; la resa testuale di 0,434 dimostra inoltre che nessun modello può essere completamente affidabile lungo l’intera catena di produzione. Nei progetti multiculturali, la fase di revisione della localizzazione non può essere eliminata.
In terzo luogo,la tabella dei punteggi per paese merita di essere conservata. Per ogni mercato, verificare prima i punteggi del paese: per i mercati ad alta risorsa come Stati Uniti, Cina e India, i modelli principali possono essere considerati affidabili; per i mercati come Etiopia e Malesia, un punteggio compreso tra 0,55 e 0,63 significa che quasi la metà dei dettagli culturali sono errati e richiedono una verifica manuale. L’autore non ha fornito un’analisi causale più approfondita oltre alla matrice completa di ogni modello per ogni paese, ad esempio se è la quantità o la proporzione dei dati di allenamento a fare la differenza, un aspetto che non è stato approfondito nel documento.
Quarto,i giudici di IA sono più importanti di questo punteggio. Una valutazione su scala di 1.000 domande × 7 modelli non potrebbe mai essere completata da un essere umano. Il protocollo di targeting esplicito (elencare prima gli obiettivi, trovare le prove e poi assegnare i punteggi) spinge la pertinenza dei giudici di IA vicino al livello di valutazione reciproca umana, e questo approccio diventerà probabilmente la norma per la prossima ondata di valutazioni multimodali.
In sintesi: per quanto riguarda la realizzazione di video, l’IA ha già raggiunto un livello avanzato; per quanto riguarda la comprensione della cultura, invece, è ancora in fase di apprendimento - e questo articolo fornisce la prima valutazione dei progressi compiuti in questo campo.
Articolo: CultureVidBench: valutazione comparativa della comprensione culturale nella generazione di testo in video arXiv: https://arxiv.org/abs/2608.01942 Pagina del progetto: https://hanxjing.github.io/CultureVidBench/