Wang e Zahl, Stime di volume per unioni di insiemi convessi e la congettura dell’insieme di Kakeya in tre dimensioni, arXiv 2502.17655v1 (presentato il 26 febbraio 2025, 127 pagine). Riassunto in una frase: la dimensione dell’insieme di Kakeya in tre dimensioni = 3 è stata dimostrata, e di conseguenza sono state dimostrate anche la congettura del Tube Doubling in tre dimensioni e la congettura dell’estensione del segmento di linea di Keleti. Ho letto attentamente questo articolo dall’abstract fino alla sezione 12, e ho spiegato tutti i termini tecnici “che sembrano magici” che ho incontrato lungo la strada.
I. Introduzione: due autori e una domanda attesa da 108 anni.
Gli autori sono Hong Wang e Joshua Zahl. Wang Hong è professore presso la NYU Courant e professore permanente presso l’IHES, laureato nel 2011 presso la Peking University e dottorato presso il MIT sotto la supervisione di Larry Guth; Zahl è un docente presso il Dipartimento di Matematica dell’Università della British Columbia. Negli ultimi tre anni, i due hanno pubblicato una trilogia che ha trasformato un problema geometrico rimasto irrisolto per quasi un secolo da “quasi risolto” a “completamente risolto”. Wang Hong ha appena ricevuto il Fields Medal 2026.
La storia inizia nel 1917 in Giappone. Sōichi Kakeya ha posto una domanda che sembrava comprensibile anche per un bambino delle elementari:Qual è l’area minima che la punta di un ago (un segmento di linea unitario) percorre ruotando su un piano?In seguito, questo problema è stato esteso al concetto di insieme di Kakeya: un insieme compatto che contiene un segmento di linea unitario inogni direzioneè chiamato insieme di Kakeya. Nel 1971, Davies ha dimostrato che la dimensione di Minkowski e Hausdorff degli insiemi di Kakeya in due dimensioni è sempre 2 (dimensione piena). Tuttavia, per più di mezzo secolo, non è stato possibile risolvere il problema per più di tre dimensioni.
Si può anche immaginare la cosa in questo modo:il set di Kakeya è come un “parcheggio in cui ogni auto può fare inversione di marcia”- ogni direzione deve avere un “posto auto” in cui può parcheggiare un’auto, anche se quel posto è sottile come un ago, ma la direzione deve coprire 360°. In due dimensioni è facile immaginare che questo parcheggio sia un semplice disco; ma una volta passati alle tre dimensioni, ogni direzione deve avere un ago “tridimensionale” in cui può essere inserita, il che rende la cosa stranamente difficile.
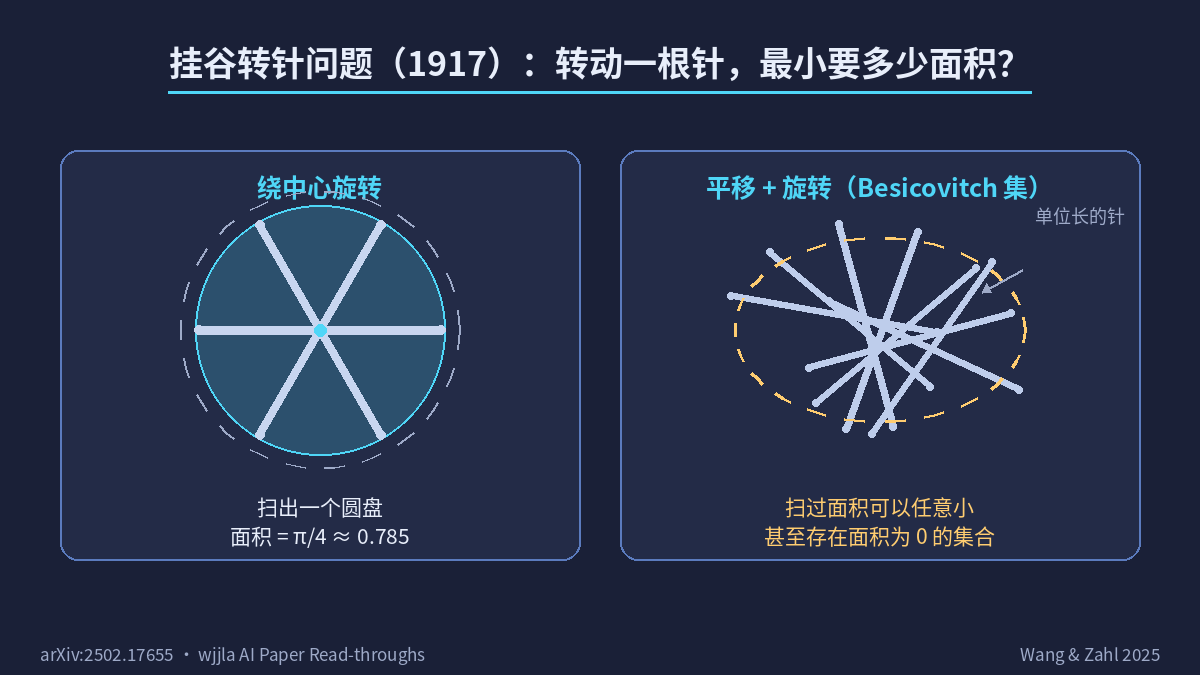
L’immagine sopra rappresenta la motivazione iniziale del problema: l’area scansionata durante una rotazione sembra intuitivamente una circonferenza, ma in realtà esiste una “forma a foglia” con un’area ancora minore; quanto più abile è il movimento di rotazione, tanto più l’area scansionata si avvicina allo 0; Besicovitch ha proposto una costruzione in cui l’area può essere arbitrariamente piccola o addirittura pari a 0 (il paragrafo 1.6 del suo articolo menziona questa costruzione su R², vedi L664). Tuttavia, la congettura della dimensione afferma il contrario: se un insieme “contiene” un ago in ogni direzione, la dimensione di quell’insieme deve essere pari a 3.
Perché “Dimensione = 3” è di per sé una proposizione insolita?Qui dobbiamo fare una pausa e spiegare chiaramente il termine “dimensione”.
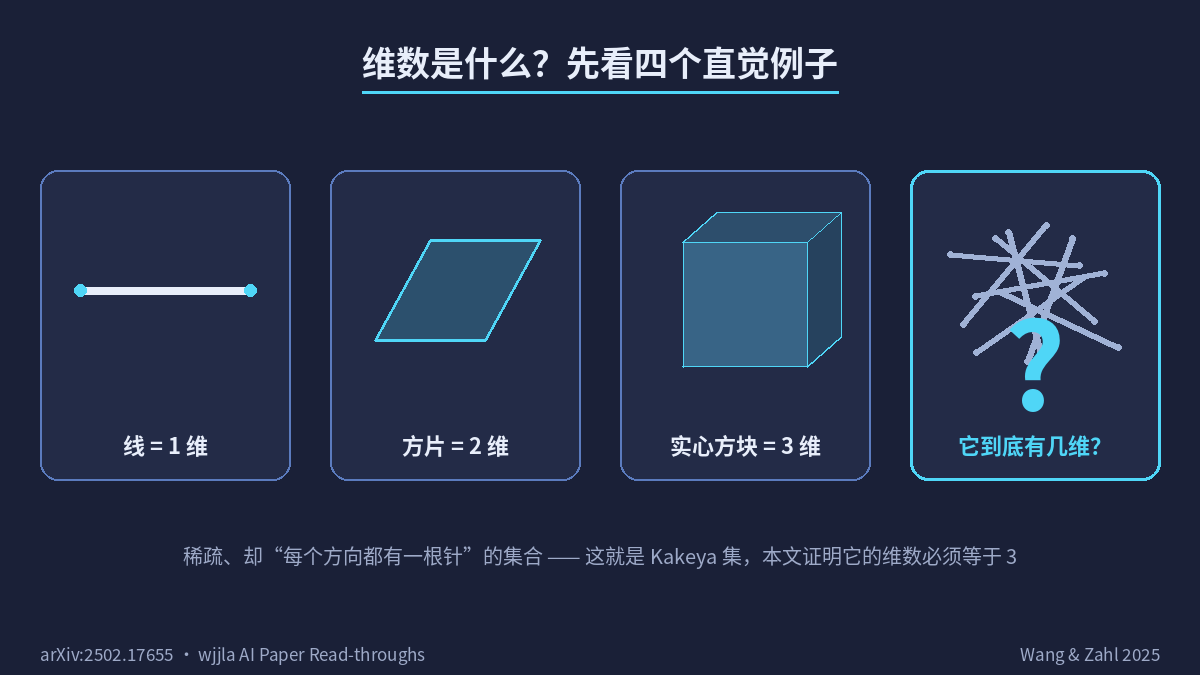
La versione più intuitiva: “ingrandire un insieme di ε volte” per vedere “quanto sembra grande”.La dimensione non misura le dimensioni, ma la “spessore”- ovvero quanto questo insieme “riempie lo spazio” in molte direzioni indipendenti. Una linea sottile è unidimensionale (si estende solo in una direzione), un foglio di carta è bidimensionale (si estende in due direzioni), un cubo solido è tridimensionale (si estende in tre direzioni). La congettura di Kakeya chiede “dimensione = 3”, che significa: un insieme che riempie “ogni direzione” deve essere “abbastanza esteso” in tre direzioni indipendenti e non può essere compresso in un foglio bidimensionale, una linea unidimensionale o un insieme di punti a dimensione zero.
Quindi la domanda fondamentale è “perché non è possibile inserire un ago con una direzione diversa in un foglio di carta sottile?”. È controintuitivo dal punto di vista geometrico, ma nessuno in matematica è riuscito a confutarlo per decenni.
II. Perché la terza dimensione è rimasta bloccata per un secolo: esaminiamo il “bilancio di mezzo secolo”.
I risultati parziali della congettura di Kakeya in tre dimensioni sono stati ottenuti su due fronti: uno è costituito da un indicatore rigido del “limite inferiore della dimensione”, l’altro da uno strumento flessibile della “teoria della struttura”.
Linea guida rigida: Wolff nel 1995 [27] (Rev. Mat. Iberoam. 11) ha dimostrato che la dimensione di Hausdorff dell’insieme di Kakeya tridimensionale è almeno pari a (n+2)/2 = 5/2; successivamente, Katz, Laba e Tao (articolo [16]) hanno aggiunto un piccolo costante positivo c a questa base, arrivando a 5/2 + c. Questa linea guida fornisce un “limite inferiore assoluto”, ma numericamente è ancora lontana da 3.
Strumenti soft: A partire dal 2000 circa, il teorema multilineare di Kakeya di Bennett-Carbery-Tao ([1]) ha dimostrato che qualsiasi “contraddizione” deve essere “planare”: quando gli aghi sono ammassati insieme, devono giacere approssimativamente su un piano; Guth ([9]) ha utilizzato la sua famosa “decomposizione dei grani” per dimostrare che la contraddizione deve essere “granulare”: gli aghi possono organizzarsi in grani cubici; mail passaggio cruciale della “appicciccosità” è rimasto bloccato: si può affermare che la contraddizione è planare + granulare + appiccicosa, e poi? Ci si ferma qui.
Nel 2014, Terence Tao, in una lezione e in un articolo di blog ([24]), ha spiegato il programma Katz-Tao in tre fasi: la prima consiste nel dimostrare che i controesempi devono necessariamente avere tre strutture: planare, granulare e appiccicosa; la seconda consiste nel “multiscalare” queste strutture, ottenendo una descrizione sempre più dettagliata; la terza consiste nell’utilizzare gli strumenti di somma-prodotto discretizzati di Bourgain per “confutare” questa struttura multiscalare.
Wang Hong e Zahl, in due articoli del 2022 e del 2024 [25][26], hanno in realtà saltato il primo passo e hanno fatto direttamente “ipotizzando che il controesempio sia sticky, si ottiene una contraddizione”, e “ipotizzando che il controesempio abbia una dimensione Assouad < 3, si conclude che deve essere sticky”. Tuttavia, questi due passaggi insieme lasciano ancora una lacuna: la dimensione Assouad può essere maggiore della dimensione di Minkowski, quindi [25][26] non ha veramente chiuso la porta alla possibilità che la dimensione di Minkowski sia < 3.
Questo articolo di 127 pagine ha completato l’ultima parte: non presuppone l’esistenza di un controesempio sticky, ma dimostra direttamente che “se D(σ, ω) è compatto, il controesempio deve assomigliare a sticky”. Quindi, utilizzando il teorema di Kakeya su sticky, si dimostra la contraddizione. Con questo passaggio, la dimensione del set di Kakeya tridimensionale = 3 è completamente dimostrata.
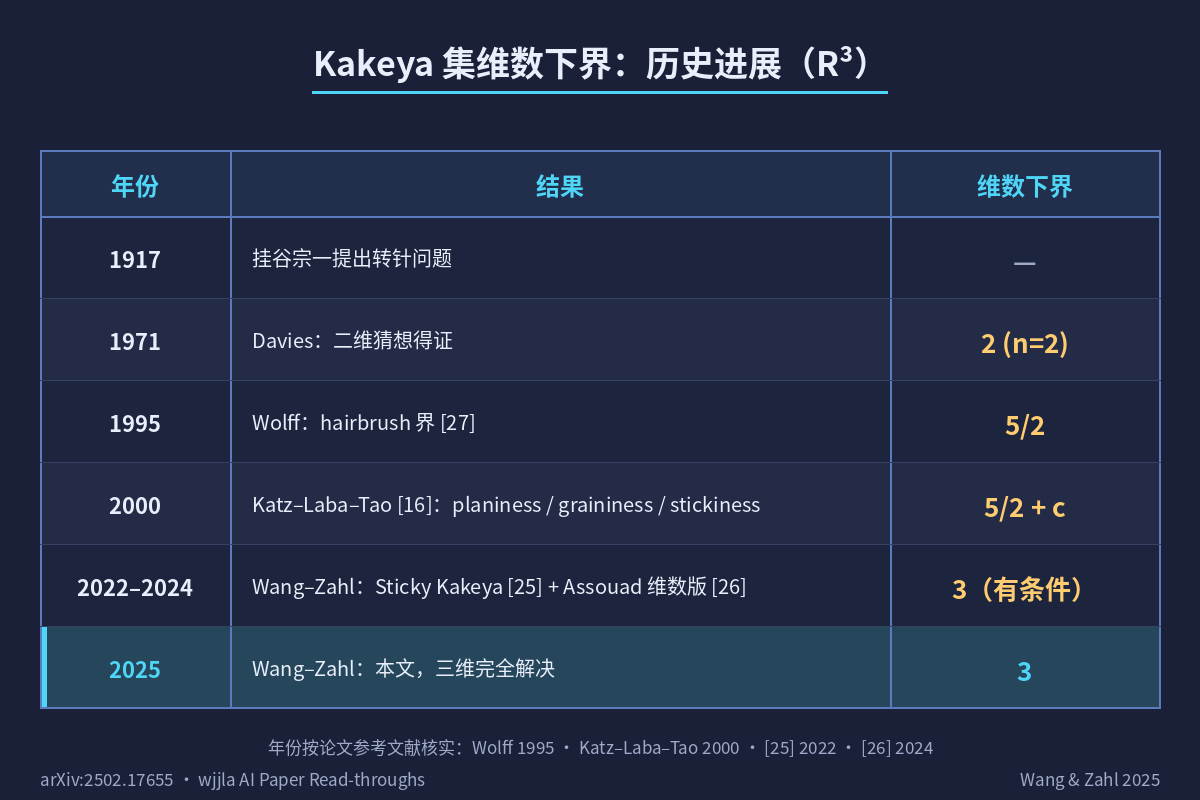
Il salto numerico specifico dal “vecchio limite inferiore al nuovo limite inferiore” è il seguente: da 5/2 di Wolff nel 1995 a 5/2 + c di Katz-Laba-Tao negli anni 2000, e ora un salto diretto a 3. Il lasso di tempo di circa 30 anni tra Wolff e questo articolo, nell’intervallo (5/2, 3), è stato completamente superato da questo articolo all’inizio del 2025.
III. Il vero protagonista di questo articolo è la “stima del volume mediante tubi”, mentre Kakeya è una conseguenza di ciò.
Questo deve essere chiarito prima di tutto, altrimenti la lettura del documento sarà sommersa da termini tecnici. Il titolo del documento è Stime di volume per unioni di insiemi convessi e la congettura dell’insieme di Kakeya in tre dimensioni, Kakeya è solo una deduzione,il vero teorema principaleè il Teorema 1.2 e il Teorema 1.9 (quest’ultimo fornisce il Corollario 1.10), che affermano quanto segue:
Data una serie di tubi delta (con sezione trasversale delta e lunghezza 1), purché non si “accatastino” all’interno di alcun insieme convesso (noto tecnicamente come assioma di Wolff o non-clustering), il volume dell’insieme ottenuto unendo questi tubi sarà “quasi” uguale alla somma dei volumi dei singoli tubi, ovvero questi tubi si sovrapporrannoquasi per nientee non ci saranno grandi sovrapposizioni.
δ-tubeè un termine chiave ricorrente. In parole povere, si tratta di “un ago di lunghezza 1 e spessore δ in una certa direzione”. Per fare un paragone con la vita quotidiana, è come unacannuccia: la cannuccia ha un proprio orientamento (la direzione della lunghezza) e uno spessore (il diametro δ), e il “volume” dell’intera cannuccia è δ² · 1 = δ² (l’area della sezione trasversale della cannuccia sottile moltiplicata per la lunghezza). Quando δ è molto piccolo (la cannuccia è molto sottile), il volume di una singola cannuccia, δ², è anch’esso molto piccolo; il volume di diecimila cannuccie sottili sommate è solo δ² · 10000, che non sembra molto grande; tuttavia, il documento dimostra che quando le cannuccie soddisfano la condizione di “non ammassarsi in nessun insieme convesso”, il volume dell’insieme di diecimila cannuccie sottili è solo ~10000 · δ², non più di questo; in altre parole, sono davvero disposte “quasi senza intersecarsi”, senza sovrapposizioni significative.
Il nomeassioma di Wolffderiva da un articolo del 1995 di Wolff [27], in cui ha introdotto questo tipo di condizioni “non concentrate”: se si prende un qualsiasi parallelepipedo (dimensioni a × b × 2) e lo si utilizza per contenere questo mucchio di tubi, il numero di tubi che possono essere inseriti all’interno del parallelepipedo non deve essere troppo superiore all’area della sezione trasversale del parallelepipedo moltiplicata per 1/δ². In altre parole, i tubi non possono essere “accatastati uno sull’altro”.
Traducendo questa condizione in un linguaggio colloquiale, si ottiene“controllo degli accessi nei supermercati”. Immaginate diecimila cannucce che fluttuano all’interno di un enorme centro commerciale, ognuna con una propria direzione. L’assioma di Wolff afferma che se si taglia un qualsiasi piccolo cubo di a × b × 2 (con un’area di sezione trasversale di a × b), in questo piccolo cubopotranno entrare al massimo circa a·b/δ² cannucce– l’area di sezione trasversale del cubo determina il “limite superiore” delle cannucce che può contenere, indipendentemente dalla direzione delle cannucce stesse. Se si prende un piccolo cubo di 1 × 1 × 2 e si inseriscono improvvisamente al suo interno 100 volte il limite superiore dell’area di sezione trasversale, si violerebbe l’assioma di Wolff. L’assioma di Wolff è essenzialmente un vincolo rigido di“dispersione”: le cannucce non possono ammassarsi.
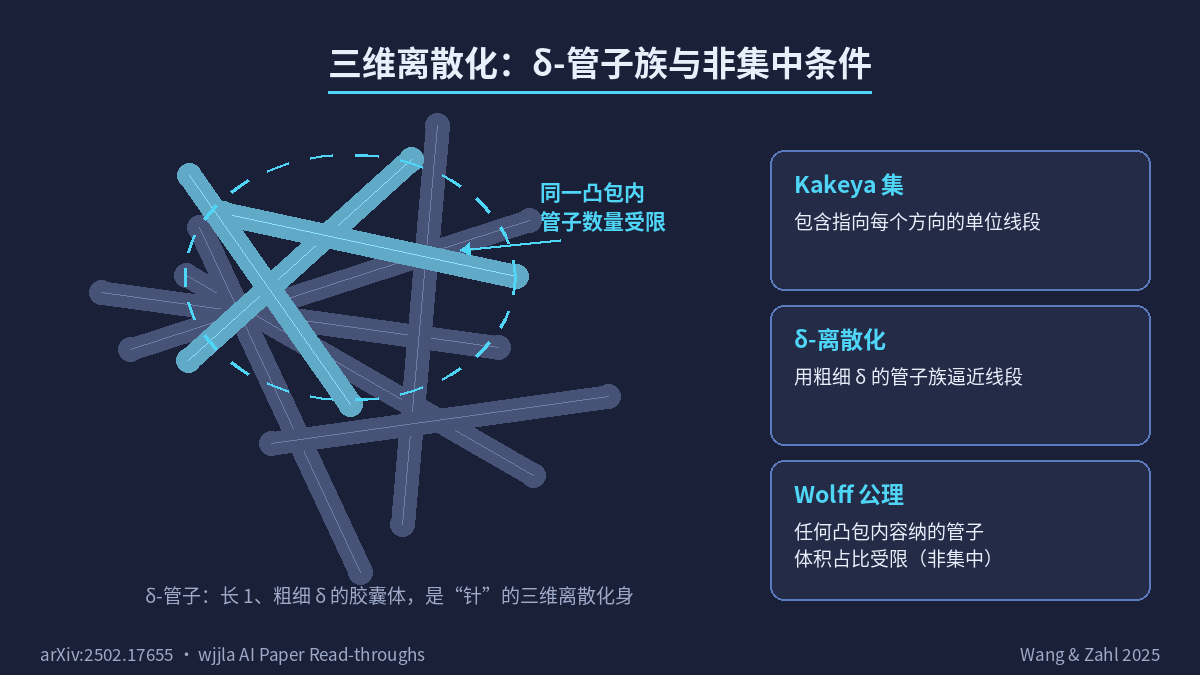
Per una comprensione intuitiva: immaginate di avere decine di migliaia di aghi sottili, uno in ogni direzione. L’assioma di Wolff afferma che “questi aghi non si raggruppano improvvisamente 100 volte in un piccolo contenitore di dimensioni a × b × 2”, che rappresenta un vincolo rigido di “dispersione”.
Kakeya soddisfa esattamente questa condizione: un ago in ogni direzione (direzioni separate da δ), quindi in ogni scatola a × b × 2 all’interno della sfera unitaria possono entrare al massimo ~ab/δ² aghi (determinato dalla sezione trasversale). Di conseguenza,il Teorema 1.2 deriva direttamente dal Teorema 1.1- questo è il valore del “come conseguenza” nel titolo del documento.
IV. Quattro passi per la strategia di base: Axioma di Wolff → Decomposizione degli insiemi convessi → Grani a due scale → Tre mosse → Induzione su scala.
L’intera struttura argomentativa di 127 pagine può essere suddivisa in quattro fasi consecutive. Utilizzerò i numeri delle figure del documento per spiegare ogni fase.
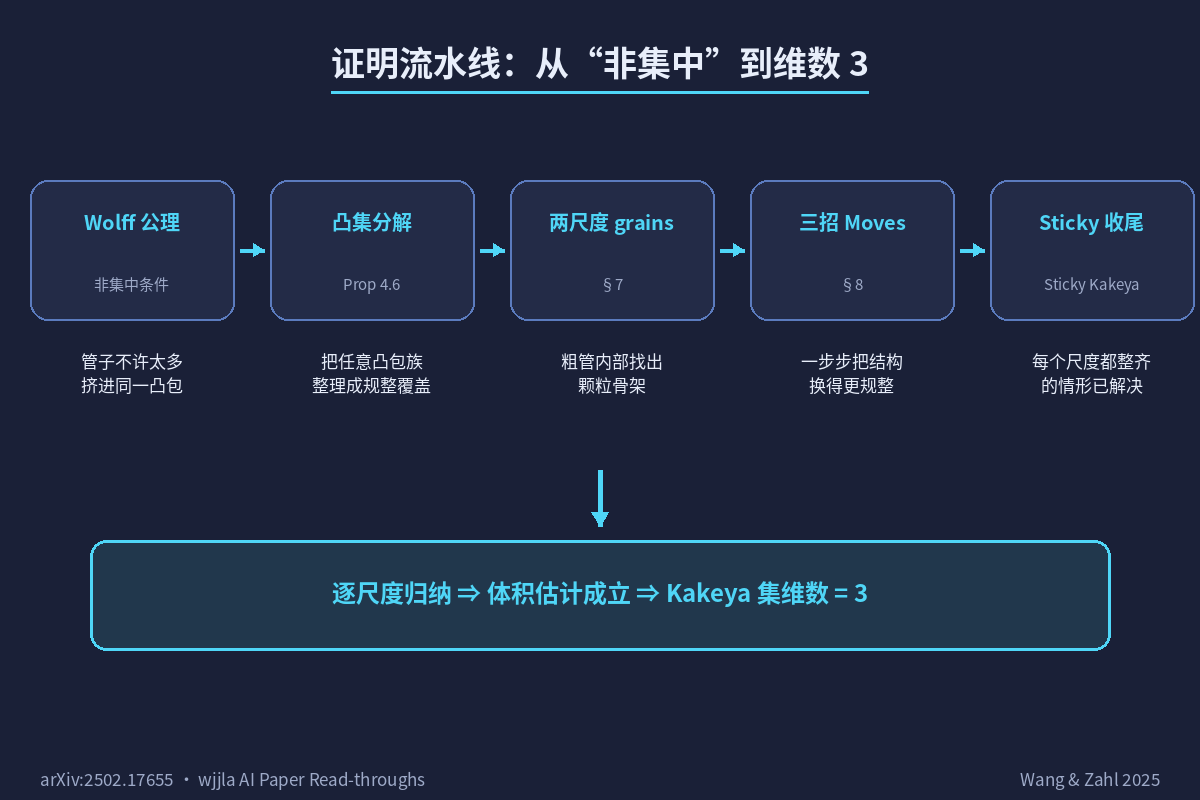
Questa figura illustra i quattro stadi successivi: l’assioma di Wolff limita la distribuzione dei tubi → la decomposizione degli insiemi convessi trasforma la “famiglia di tubi” in un “insieme convesso di imballaggio” → i grani a due scale allineano i tubi in grani rettangolari → i tre movimenti spostano i grani “al loro posto” → l’induzione su scala riduce ω a zero.Ricordando questi cinque stadi, l’intero articolo non sarà più una foresta di termini tecnici.
Passo 1: Assioma di Wolff + Decomposizione di insiemi convessi(§4)
Cosa si fa in questo passaggio: si sostituisce “la famiglia dei tubi” con un linguaggio più generale, ovvero qualsiasi famiglia di insiemi convessi equilibrati.Perché è indispensabile: perché gestire direttamente i δ-tube è troppo specifico e la relazione geometrica tra “tubi” e “tubi” che si intersecano a vicenda è difficile da descrivere; sostituendoli con insiemi convessi, è possibile organizzare la dimostrazione utilizzando relazioni più “lineari” come l’inclusione, la copertura e l’intersezione tra gli insiemi convessi.
Definiamo due costanti di Wolff: la costante di Wolff convessa di Katz-Tao (CKT-CW), che misura “l’incapacità di ammassarsi in qualsiasi insieme convesso W, e la costante di Wolff dello slab di Frostman (CF-SW), che misura “l’incapacità di ammassarsi in uno slab”. La costante di Frostman “eredita verso l’alto”, mentre la costante di Katz-Tao “eredita verso il basso”; questo rapporto duale è il motore di tutte le successive decomposizioni. La Proposizione 4.6 è lo strumento chiave di questa fase: data una famiglia di insiemi convessi, è sempre possibile trovare una famiglia di “insiemi confezionati” W che controllano U sia dal basso che dall’alto con Katz-Tao e Frostman, rispettivamente, con un errore K (assorbibile).
In una frase, spiega ciascun simbolo:CKT-CW è un indicatore normalizzato che misura “quante tubi sono contenuti nell’insieme convesso W”: un valore più basso indica che i tubi sono meno concentrati all’interno di W;CF-SW è una “versione a sezione sottile” con lo stesso significato, ma non di un insieme convesso arbitrario, bensì di un sottile strato (slab) di spessore fisso.L’ereditarietà verso l’alto di Frostmansignifica che la dispersione su larga scala può estendersi a scale più piccole, mentrel’ereditarietà verso il basso di Katz-Taofunziona al contrario: la dispersione su scala ridotta può vincolare la dispersione su scala più ampia. Queste due relazioni duali di “ereditarietà verso l’alto e verso il basso” sono come le due estremità di una molla, che costituiscono il motore che consente a tutte le successive decomposizioni di funzionare.
Passo 2: Decomposizione dei grani a due scale(§7)
Cosa si fa in questo passaggio: dopo aver ottenuto la “famiglia di insiemi convessi imballati” nel Passaggio 1, si procede a una nuovastrutturazionedi ciascun tubo all’interno di ogni insieme convesso, organizzandoli in “grani” (grains) a forma di parallelepipedo.Perché è indispensabile: poiché la relazione tra i tubi è troppo complessa (ogni tubo punta in una direzione diversa e si interseca con gli altri), mentre i grani a forma di parallelepipedo presentano solo relazioni “contenute/parzialmente sovrapposte/non intersecanti”, che sono molto più semplici da gestire.
Questo passaggio rappresenta un ulteriore sviluppo dell’idea dei grani di Guth [9]. In [9], Guth ha dimostrato che, nell’ipotesi “ampia”, i tubi possono essere scomposti in particelle rettangolari δ × t × t (chiamate grani), dove t ≥ 1/√(#T). Il documento lo trasforma in unaversione a due scale: si seleziona prima una scala intermedia ρ e si utilizzano i tubi ρ per contenere i tubi δ; all’interno di ciascun tubo ρ si effettua una scomposizione dei grani, ottenendo particelle δ/ρ × c × c; si ripristina la scala originale e si ottiene una famiglia di grani δ × ρc × c, chiamata G. La presenza simultanea di due scale (δ e ρ) è un presupposto per le “tre mosse” successive.
Il termine “grani”, in termini di vita quotidiana, è paragonabile auna stringa di gamberi allo sciroppo- un bastoncino di bambù (in direzione del tubo) su cui sono infilati pezzi di gamberi di dimensioni simili (grani), i cui lati lunghi si estendono lungo il bastoncino di bambù.Perché trasformare il tubo in una stringa di gamberi allo sciroppo?Perché una stringa di gamberi allo sciroppo è più facile da gestire rispetto a un mucchio di gamberi sparsi: è possibile contare quante stringhe ci sono, quante gamberi ci sono in ogni stringa e quanto sono grandi - tutte queste “dimensioni” e “quantità” possono essere inserite in una formula per fare una stima.
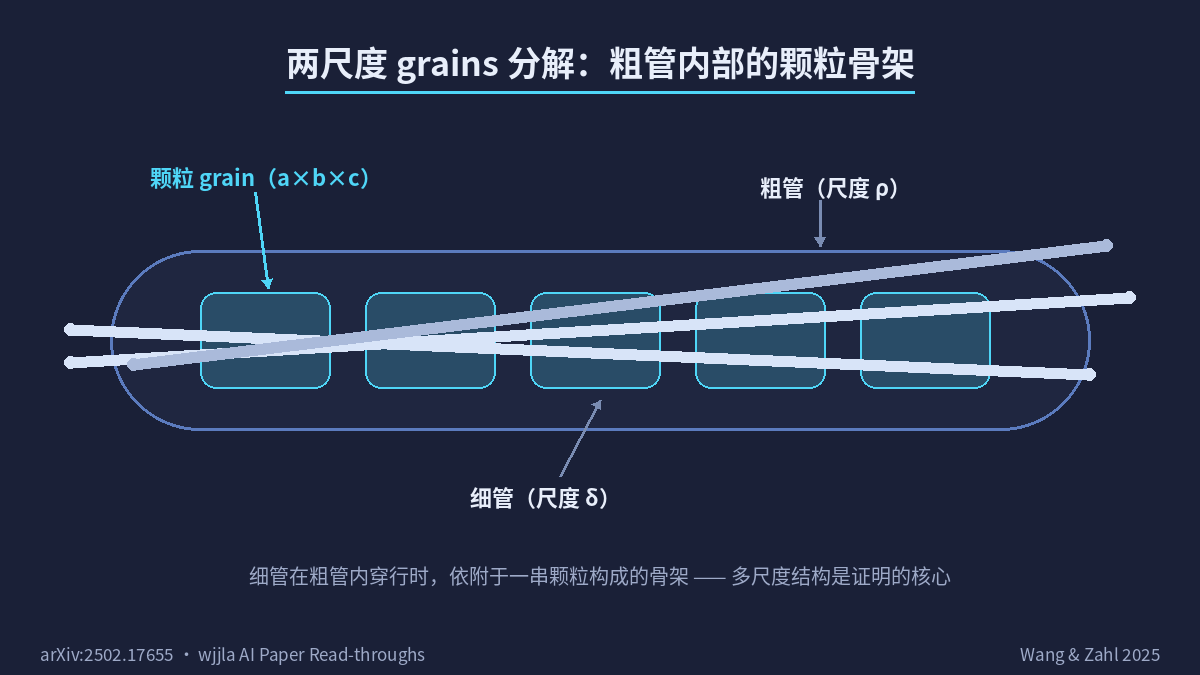
Il valore di c nelle dimensioni delle particelle non è stato definito a caso: c ≥ 1/√(#T[Tρ]) - La dimensione delle particelle è inversamente proporzionale al numero di tubi δ contenuti nel tubo ρ. Quanto più i tubi sono distanziati, tanto più le particelle si allungano. Questa equazione (L950, §2.2) è la base di tutte le stime di grandezza successive.Qui, #T è l’abbreviazione di “numero totale di tubi”, mentre Tρ indica “un sottoinsieme all’interno di un certo intervallo di ρ-tube”. Questi due simboli significano che “la dimensione delle particelle attuale è limitata dal numero di tubi sottili contenuti nel tubo più grande della scala precedente”.
Passo 3: tre mosse(§8)
Cosa si fa in questo passaggio: Nel passaggio 2, i grani ottenuti non sono ancora “pronti” - alcuni sono troppo lunghi, altri troppo corti, altri troppo stretti.Perché è indispensabile: La successiva induzione sui grani ha requisiti rigorosi per quanto riguarda la “forma” degli stessi (6 proprietà da (i) a (vi)). Se queste tre cose non vengono fatte, l’input dell’induzione non soddisfa i requisiti e la dimostrazione non può procedere.
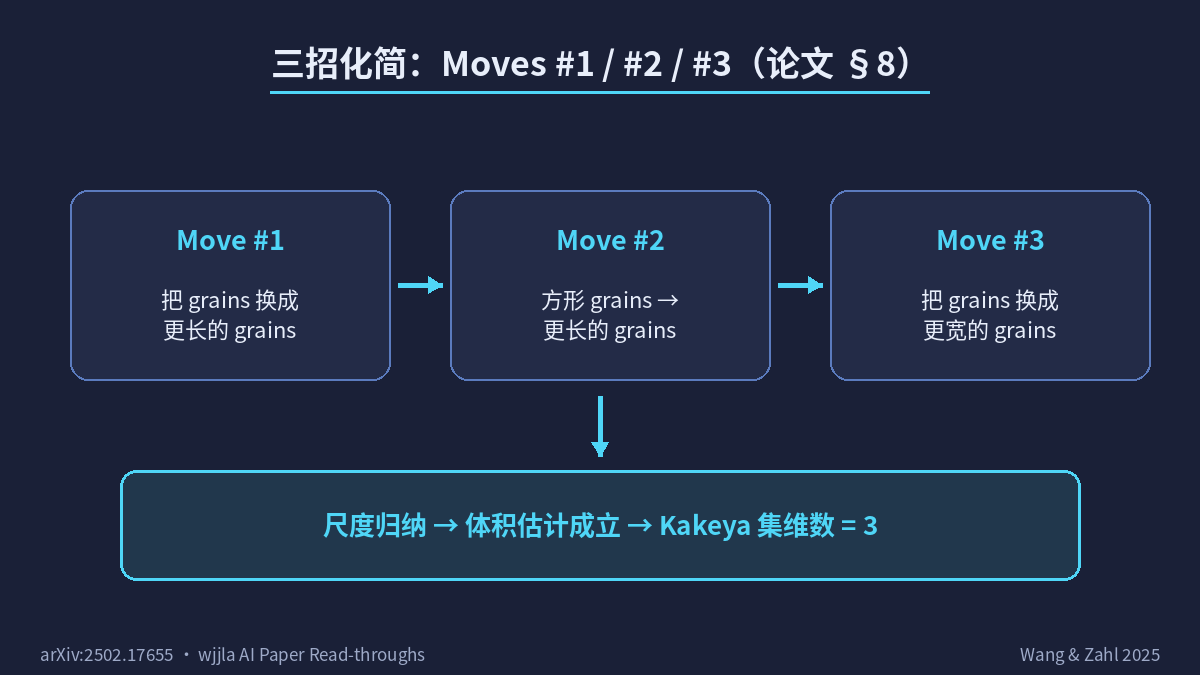
L’autore ha fatto tre cose per mettere a posto i “grani”, e queste tre mosse, insieme, sono cometre azioni per organizzare una libreria: raddrizzare i libri storti (Mossa n. 1), allineare i libri di altezza diversa (Mossa n. 2) e unire i libri correlati in un unico volume più spesso (Mossa n. 3).
Nello specifico:
- Mossa #1(§8.1): Sostituire i grani con granipiù lunghi, assicurandosi che c soddisfi c ≥ δ^ζ · ρ·#Tρ / #T.Che cosa fa questa mossa: Rifare gli spiedini di zucchero “con grani troppo piccoli” in spiedini “con grani abbastanza grandi”, garantendo che la formula per la dimensione dei grani soddisfi il limite inferiore.Perché se non lo soddisfa, si scartano i grani e si ricomincia:Perché tutte le stime successive dipendono da questo limite inferiore; se il limite inferiore non viene soddisfatto, la formula diventa una stima divergente (non ha senso). Se non lo soddisfa, si abbandona semplicemente questo set di grani e si torna all’input della decomposizione di Guth per ricominciare — questo è un “riprovare da capo” algoritmico.
- Mossa #2(§8.2): Se i grani sono “quadrati” (sezione trasversale a × b × c con b/c ≥ δ), sostituire i grani con granipiù lunghiusando una stima L² in stile Cordoba, al livello δ^(-ω/100).Che cosa fa questa mossa: Gestire il caso in cui “la sezione trasversale dei grani è troppo quadrata e la lunghezza verticale non è sufficiente” — gli spiedini di zucchero sono troppo “tondeggianti”, quindi è necessario allungare ogni ciliegina di albicocca.Perché usare la stima L²: Perché questo consiste nell’applicare uno strumento di disuguaglianza “quadrabilmente integrabile” alla geometria dei grani, che permette di ridurre il rapporto “sezione trasversale/lunghezza verticale”.
- Mossa #3(§8.3): Se CKT-CW è troppo grande, ogni grano può essere esteso con una dimostrazione L² in un “spazzolino” (a forma di pettine): usare un δ̃-vicinato per inglobare tutti i grani vicini, ottenendo un granopiù largo.Che cosa fa questa mossa: Quando l’indicatore di “dispersione” a un certo livello è peggiorato (i tubi iniziano ad ammassarsi), si uniscono i grani vicini in un “spazzolino” più grande — si uniscono diversi spiedini di zucchero piccoli in uno grande.Perché non si eliminano semplicemente questi grani: Perché contengono informazioni geometriche reali; eliminarli significherebbe perdere la struttura; si possono solo unire, non eliminare.
Ogni volta che si esegue una mossa, o c aumenta in modo significativo, o ρ aumenta in modo significativo, ma entrambi vengono limitati a 1, quindi questo processo di iterazione si fermerà necessariamente dopo un numero limitato di passaggi —questa è la classica procedura di convergenza monotona e limitata. Quando si ferma, i grani soddisfano tutte e 6 le proprietà da (i) a (vi) (L948-970), che costituiscono l’input per l’induzione su scala che segue.
Passo 4: Induzione su scala precisa(§9 + §11)
Cosa si fa in questo passaggio: si ripassano i “grani ideali” del Passaggio 3 con un’induzione più precisa - si applica E(σ, ω) adue livelli, non una sola volta.Perché è indispensabile: la stima del volume fornita da E(σ, ω) una sola volta non è abbastanza forte (è sufficiente per far diminuire ω di un po’, ma non per farlo scendere a 0);è necessario usare E(σ, ω) una volta per ogni livelloper ottenere una stima in “forma di prodotto”, che è più forte di quella ottenuta usando E(σ, ω) una sola volta.
Dopo aver ottenuto i “grani ideali” di Fase 3, il documento ha fatto qualcosa di più raffinato: ha applicato E(σ, ω) adue livelli- sia sul δ-tube all’interno di ogni ρ-tube (su scala fine), sia sulla famiglia di ρ-tube scalata di ogni grano (su scala grossa). Usando entrambi i livelli una volta, la stima del volume collettivo ottenuta è sotto forma di “prodotto di due livelli”, che è più forte dell’uso separato di D(σ, ω). Questo è il nucleo della Proposizione 1.7 - che afferma: ogni volta che si sottrae un g(σ, ω) > 0 da ω durante l’induzione, fissando ω e ripetendo l’operazione, si può ridurre σ a 0.
Lo spirito di questa induzione è “salire le scale”: ogni gradino delle scale è leggermente più basso del precedente. Se ogni passo consente di scendere anche solo di un pochino (g(σ, ω) > 0), ripetendolo all’infinito si arriverà a terra (σ = 0).Perché è necessario “due piani” anziché “un piano”: l’induzione a un solo piano non consentirebbe a ω di diminuire abbastanza velocemente, il numero di iterazioni non sarebbe sufficiente e alla fine σ non scenderebbe a 0; una volta trasformata in un prodotto, la velocità di diminuzione aumenta e diventa possibile una vera convergenza.Che cosa significano i due simboli σ e ω: in termini generali, σ è un “indicatore di perdita di dimensione” (quanto più si avvicina a 0, tanto più ci si avvicina alla dimensione completa), mentre ω è un “indicatore di degrado della dispersione” (quanto più è grande, tanto più i tubi sono ammassati, e quanto più è piccolo, tanto più i tubi sono dispersi); l’induzione deve ridurre entrambi i parametri a (0, 0).
Conclusione di Sticky Kakeya(§10 + §2.4)
Il passo più fatale: supponendo che D(σ, ω) sia compatto (senza ridondanza) per un certo insieme di σ, ω > 0, tramite il Passo 4 si deduce che T deve essere auto-simile su più scale, soddisfacendo l’input del Teorema di Sticky Kakeya; tuttavia, [25] ha dimostrato che la dimensione delle collezioni di Sticky Kakeya è = 3, il che contraddice l’ipotesi di compattezza di D(σ, ω). Pertanto, σ e ω devono essere entrambi uguali a 0 - ovvero D(0, 0) ed E(0, 0) sono entrambi veri, e questo è il Teorema 1.9.
La parola “sticky”, in termini di vita quotidiana, è paragonabile ale matrioske russe- una bambola esterna che contiene una bambola interna, che a sua volta contiene una bambola ancora più interna; la struttura dell’insieme sticky Kakeya è la seguente: a ogni scala (osservando da vicino, da lontano e ancora più da vicino), l’insieme sembra “simile a se stesso” - grandi scale contengono piccole scale, piccole scale contengono scale ancora più piccole, con auto-somiglianza a tutti i livelli.Perché questa struttura “matrioska” permette di dedurre una contraddizione: poiché una volta stabilito che un controesempio è sticky, [25] ha dimostrato che la dimensione dell’insieme sticky Kakeya deve essere 3; ma se si ipotizza che la dimensione sia < 3 (esistenza del controesempio), allora il controesempio non può essere sticky - ma come precedentemente dimostrato, il controesempio deve essere sticky, creando una contraddizione.
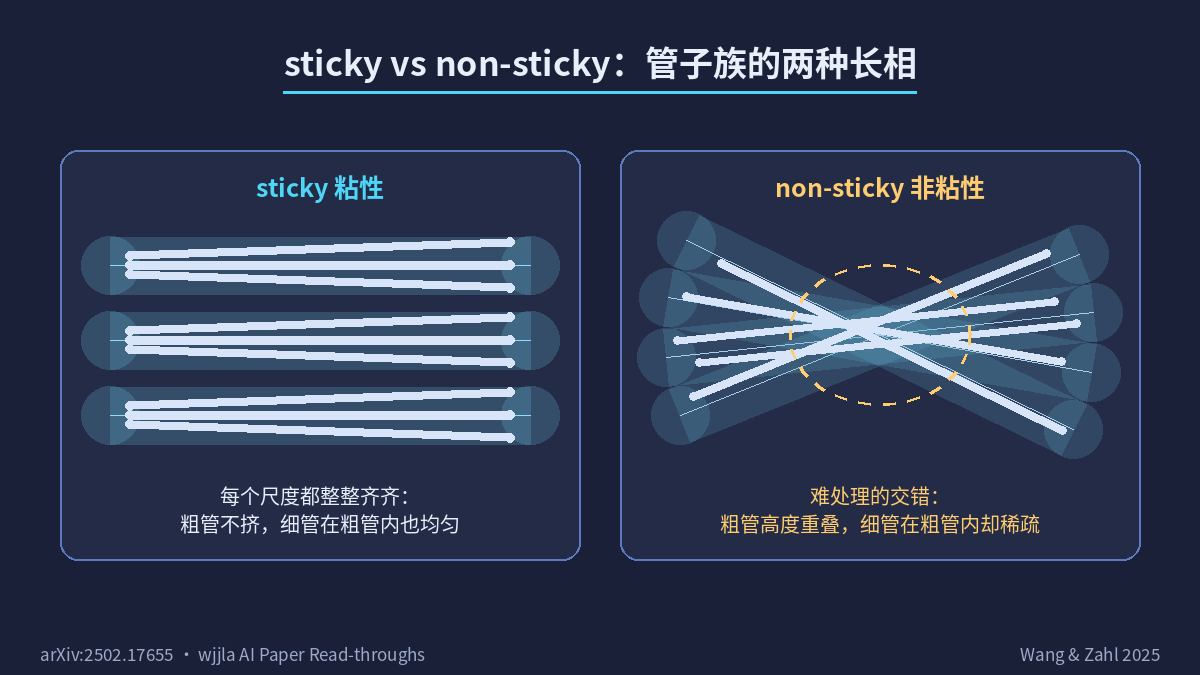
Lo strumento utilizzato in questo passaggio è la fattorizzazione di Nikishin-Stein-Pisier (§10.1, L5910): serve a completare i T scarsi (numero « δ^(-2)) fino a δ^(-2), garantendo che il teorema di Sticky Kakeya funzioni.Lo spirito di questo strumentoè “tirare l’elastico al massimo” - si hanno un sacco di tubi, troppo scarsi (numero « δ^(-2)), e il teorema di Sticky richiede δ^(-2) per funzionare; quanto fa Nikishin-Stein-Pisier è “moltiplicare” i tubi scarsi per ottenere una versione densa, equivalente a tirare un elastico - l’insieme scarno viene espanso rigidamente in un insieme denso, con una “densità” che raggiunge il limite inferiore richiesto dal teorema di Sticky.
- Due scoperte inaspettate: Tube Doubling e la congettura di Keleti sono state entrambe accantonate.
Pensavate che fosse la fine dopo aver letto questo? No, la tesi ha dimostrato con facilità la congettura del raddoppio del tubo tridimensionale (Teorema 1.12, L685) e la congettura dell’estensione del segmento di linea di Keleti (Teorema 1.14, L698).
Ilraddoppio del tuboconsiste nel “raddoppiare lo spessore” di un insieme di δ-tubi (trasformandoli in 2δ-tubi), in modo che, dopo l’ispessimento, il volume collettivo sia al massimo inferiore di un fattore sub-polinomiale δ^(-ε) rispetto all’originale. La versione bidimensionale era già nota (come descritto nella sezione 1.6 del documento), mentre la versione tridimensionale era stata un ostacolo. Il metodo di Wang-Zahl, che utilizza gli assiomi di Wolff e la decomposizione degli insiemi convessi, ha permesso di risolvere il problema.
IlCongettura di Keletiafferma che se un insieme di segmenti di linea viene allungato fino a diventare linee rette, la dimensione di queste linee sarà uguale alla dimensione dell’insieme originale di segmenti di linea. Keleti-Máthé ([23]) nel 2022 ha dimostrato che il Congettura di Kakeya n-dimensionale implica il Congettura di Keleti n-dimensionale, quindi Wang-Zahl ha praticamenteregalatouna versione tridimensionale del Congettura di Keleti.
Nessuna di queste due deduzioni è una “deduzione ovvia”, e la sezione 12 del documento fornisce una dimostrazione completa del Tube Doubling, utilizzando la stessa teoria della struttura multiscala della sezione 11 + la fattorizzazione di Nikishin-Stein-Pisier.
6. Confini: n ≥ 4, perché non chiudere la porta con un gesto naturale?
Questo non è stato esplicitamente menzionato nel saggio, ma vorrei sottolinearlo dopo aver letto la sezione 1. Ci sono almeno 3 punti nell’intera argomentazione chedipendono esclusivamente dalla terza dimensione:
1.La spazzola per capelli di Wolff legatafornisce un indice δ^(1/2) in tre dimensioni (intorno a L240), che è esattamente il punto di partenza della Proposition 1.8 “D(1/2, 0) è vera”, e l’intero set di iterazioni inizia con questo indice tridimensionale. 2.La decomposizione dei grani di Guthè uno strumento in tre dimensioni ([9], L487, §1.5); se esista un equivalente in dimensioni superiori, il documento non lo discute. 3.L’affermazione che l’intervallo di indicatori D/E equivalenti σ ∈ [0, 2/3](L302, Proposition 1.6), questo 2/3 deriva dalla dimostrazione tridimensionale di questo articolo; come varia questo intervallo in dimensioni superiori e se le iterazioni possono ancora funzionare, il documento non lo discute.
Quindi, in senso stretto:n ≥ 4 è ancora una questione aperta. La metodologia del documento potrebbe fornire un modello per i lavori successivi, ma non trasmette direttamente i risultati.
Il teorema 1.14 sull’estensione del segmento di linea a est e il teorema 1.12 sul raddoppio del tubo sono stati entrambi confinati nello spazio tridimensionale: si tratta di un sottoprodotto specifico del 3D, che non può essere esteso semplicemente a n dimensioni come nel caso di Kakeya.
VII. Recensione critica: cosa è buono di questo articolo, cosa è difficile, vale la pena leggerlo?
Quali sono i vantaggi:
- Niente trucchi. Il programma Katz-Tao è stato proposto nel 2014 e da allora sono passati 12 anni, durante i quali alcuni hanno cercato di “aggirare il passo della stickiness”, ma non ci sono riusciti. Questo articolo affronta onestamente la stickiness, grazie alla nuova osservazione che “se D(σ, ω) è compatto, la controesempio deve essere sticky” (riassunta nel §2.4), insieme alla Nikishin-Stein-Pisier factorization che completa l’insieme sparso. La mia impressione più forte durante la lettura del §2 della dimostrazione è stata: questo ragionamento è estremamente compatto, ogni passo deriva dalla struttura precedente, senza “salti ispirati”.
- Ilteorema della struttura multiscala(Proposizione 7.5 del §7) è uno strumento indipendentemente utilizzabile. Anche se non ci interessa Kakeya, questa “decomposizione di grani a due scale + 6 proprietà” è di per sé un pezzo che può essere ripetutamente citato nella teoria della misura geometrica.
- Chiarità di scrittura. In un articolo di 127 pagine, i primi 22 paragrafi spiegano la struttura: la Definizione 1.3 (condizioni non concentrate), la Definizione 1.5 (asserzione D/E), il Teorema 1.2 + il Teorema 1.9 + la conseguente inferenza, tutti presentati nel §1, mentre il §2 fornisce una bozza della dimostrazione. I §3 - §12 sono dedicati ai dettagli. Questo metodo di “prima le conclusioni, poi la dimostrazione” è necessario per un articolo di 127 pagine.
Qual è la difficoltà:
- 3 costanti di Wolff + 5 mosse/proprietà + 7 combinazioni di dimensioni di grano, basterebbe solo ricordare i nomi per disegnare una grande tabella. Nel §3.2 del documento c’è una tabella di notazioni, ma è facile perdersi durante la prima lettura.
- Lafattorizzazione di Nikishin-Stein-Pisier(§10.1) è uno strumento nuovo per la maggior parte dei lettori (me compreso): si tratta essenzialmente di una dimostrazione probabilistica che “completa gli insiemi sparsi con trasformazioni casuali di corpi rigidi”, che richiede una buona conoscenza della probabilità e della geometria convessa.
- Le127 pagine non sono uno stratagemma di marketing. La “polichotomia a 4 vie” (L884-901, voci da A a D) del §6 (Asserzioni D ed E equivalenti) richiede di trattare tutti i casi da A a D, ognuno dei quali occupa un intero capitolo. Questa parte è piuttosto faticosa da leggere.
Vale la pena di impegnarsi per questo?
Se ti occupi di analisi armonica/teoria della misura geometrica/equazioni alle derivate parziali, questo articolo è uno dei più importanti del 2025 e vale assolutamente la pena di studiarlo. Ti consiglio di iniziare con lo schema di prova dei paragrafi 1 e 2 (che occupa solo 22 pagine) e poi decidere se approfondire i dettagli dei paragrafi da 4 a 12.
Se ti occupi di campi adiacenti (combinatoria, probabilità), leggendo almeno la sezione 1 + la sezione 1.4 della storia e la sezione 1.6 delle deduzioni (14 pagine in totale), sarà sufficiente per farti intuire “a che livello sono i risultati di questa materia”.
Se sei solo un appassionato di matematica, ho scritto la sezione 2 come la suddetta analisi, che è fondamentalmente la trama della storia. Con l’aiuto di 8 immagini, l’idea centrale sarà chiara.
8. Riassunto in una frase
La dimensione del Kakeya set tridimensionale è 3, un fatto che è stato definitivamente chiuso all’inizio del 2025 da un articolo di 127 pagine che utilizza la combinazione di assioma di Wolff + decomposizione di insiemi convessi + grani a due scale + tre mosse + fattorizzazione di Nikishin-Stein-Pisier. Un problema geometrico giapponese di 108 anni fa è stato risolto da un matematico cinese laureato nel 2011 presso l’Università di Pechino e da un collaboratore dell’Università della Columbia Britannica. n ≥ 4 è ancora aperto, ma il set di strumenti è ora pronto.
Elenco della posizione delle figure allegate:
- fig01(Hang-Gu-Zhuan-Zhi-Problema)corrisponde alla prima metà della prima sezione di questo articolo.
- fig06(Che cos’è la dimensione?)corrisponde alla seconda metà della prima sezione di questo articolo, che introduce il concetto di “dimensione”.
- fig02(Familia di tubi e condizioni non concentrate)corrisponde alla fine della terza sezione di questo articolo.
- fig05(Progressi storici nella dimensione inferiore)corrisponde alla fine della seconda sezione di questo articolo.
- fig07(Panoramica della linea di prova)corrisponde all’inizio della quarta sezione di questo articolo.
- fig03(Decomposizione a due scale dei grani)corrisponde alla fine del Passo 2 della quarta sezione di questo articolo.
- fig04(Flusso di tre mosse)corrisponde alla fine del Passo 3 della quarta sezione di questo articolo.
- fig08(Confronto tra sticky e non sticky)corrisponde al paragrafo finale della sezione Sticky della quarta sezione di questo articolo.