Immagina di assumere uno stagista per aiutarti a prenotare i biglietti aerei, compilare i moduli e organizzare i documenti.
Ma tu gli hai imposto una regola: può solo guardare lo schermo, usare il mouse e la tastiera, e non può vedere nessuna interfaccia del software di back-end.
Sembra molto impegnativo. Ma questo è esattamente ciò che fa il documento “Qwen-CUA: Native Computer Use for (almost) Everything”, presentato su arXiv il 4 agosto 2026 (con il numero di riferimento 2608.02352). Il team di Qwen e il Xlang Lab dell’Università di Hong Kong lo hanno pubblicato insieme, con oltre 30 autori, e il repository GitHub è disponibile all’indirizzo xlang-ai/Qwen-CUA.
Oggi l’intero articolo risponderà a una domanda:Gli stagisti formati secondo questa regola sono davvero in grado di svolgere un lavoro efficace?
Perché è necessario stabilire regole così severe?
L’IA vuole lavorare nel mondo digitale, ma in realtà ci sono solo tre percorsi: scrivere codice, regolare le interfacce e utilizzare interfacce grafiche. I primi due percorsi sono già stati padroneggiati dai grandi modelli negli ultimi anni, poiché sono in grado di comprendere il testo e di gestire gli strumenti.
Ma nella realtà, gran parte del lavoro non rientra nelle prime due categorie. I software desktop, i vecchi sistemi e gli strumenti professionali hanno funzionalità che vengono visualizzate solo sullo schermo e che non possono essere lette dalla macchina. Quindi “guardare solo lo schermo e usare solo il mouse e la tastiera” non è una forma di auto-punizione, ma l’unico modo per utilizzare tutti i software in modo efficiente.
Ma questo percorso ha tre grandi difficoltà:lo stato dell’interfaccia è visibile solo a metà, gli errori si accumulano e le prove sono sparse su decine di schermate.Il documento 1 Introduzione descrive molto chiaramente questi tre problemi. Come ha fatto Qwen-CUA a superare ogni livello? Bisogna iniziare con “occhi e mani”.
Primo livello: assemblare un paio di occhi e una mano.
La sezione 2.1 del documento fornisce ai tirocinanti un set di attrezzature molto semplici, illustrate nella Figura 2.
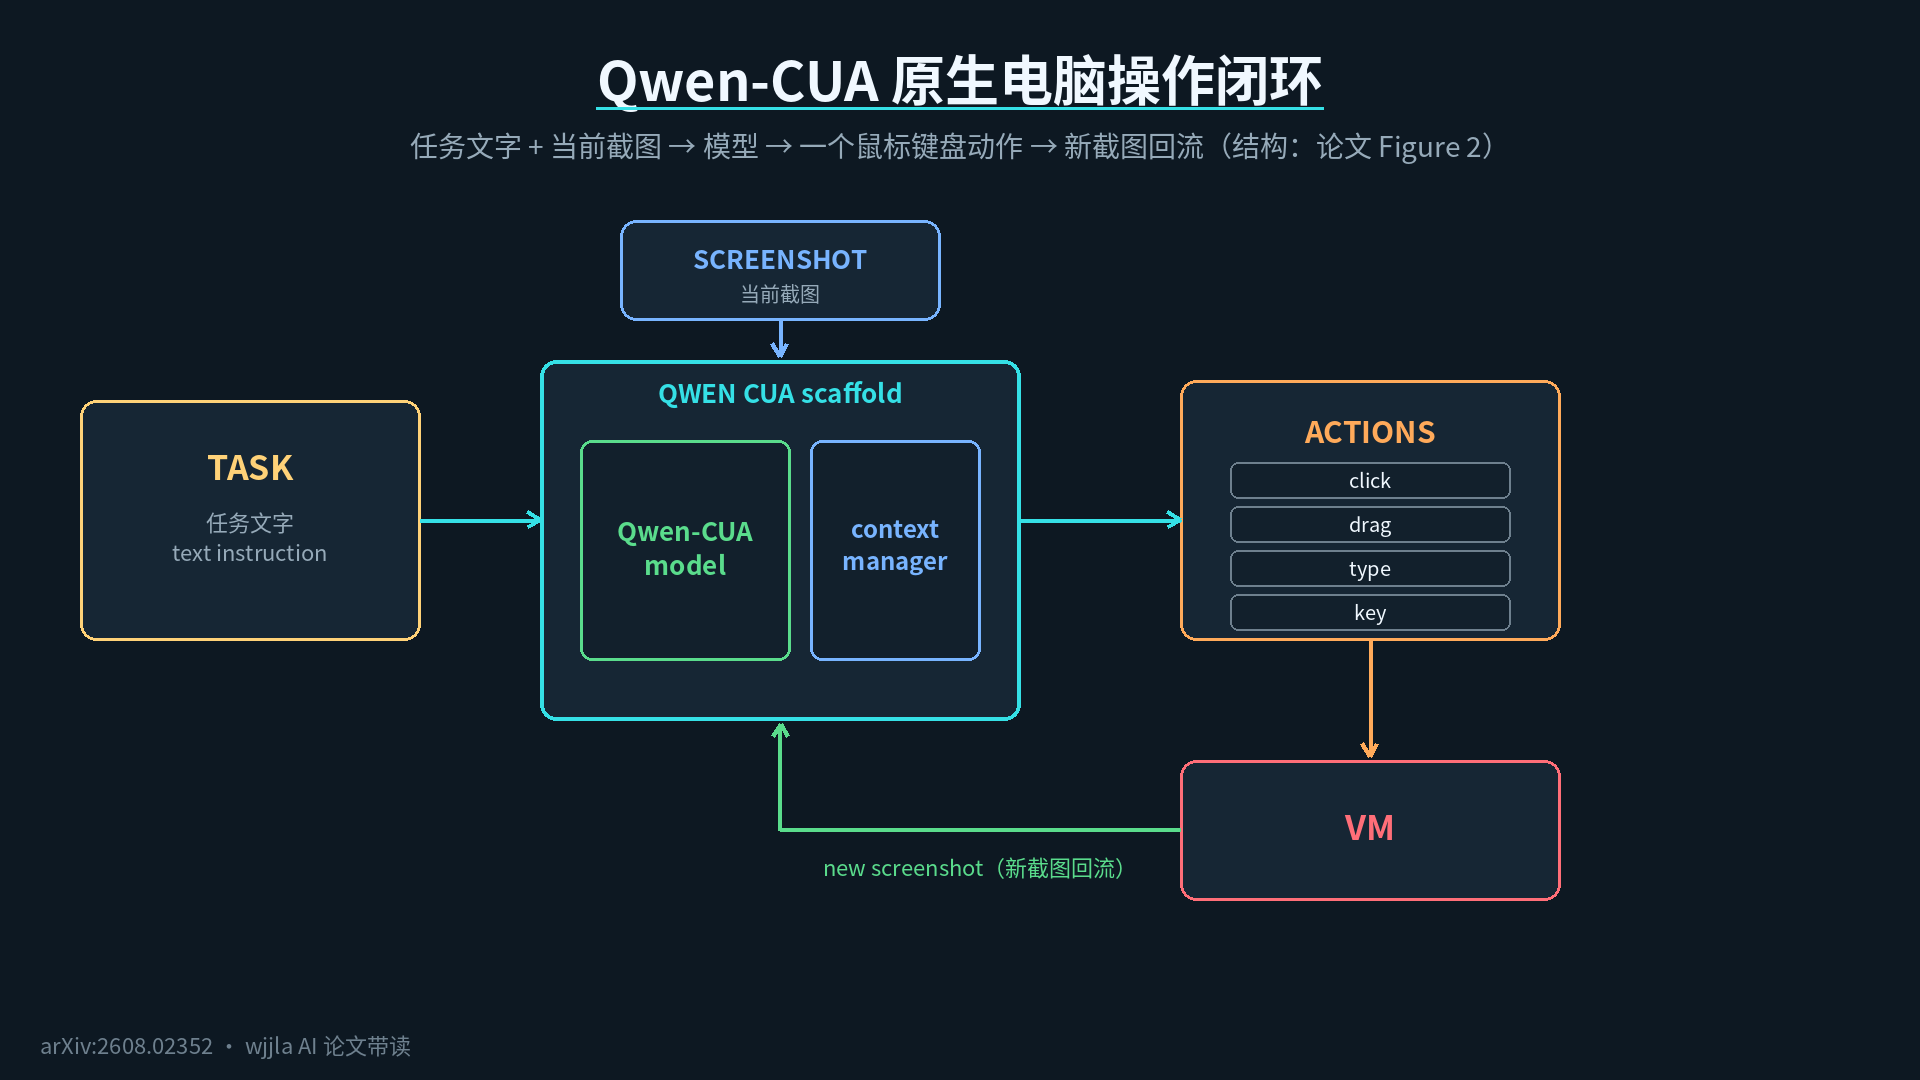
L’intero ciclo di lavoro può essere riassunto in una frase:immettere un testo di attività, visualizzare una schermata corrente e generare un’azione del mouse e della tastiera. Le azioni sono divise in tre categorie: mouse (movimento, clic con il tasto sinistro/destro/centrale, doppio clic e triplo clic, trascinamento e scorrimento), tastiera (combinazioni di tasti, tenere premuto/rilasciare, immissione di testo) e controllo (cattura schermo, attesa, interruzione e chiamata all’utente). L’Appendice A elenca l’elenco completo delle azioni.
Al centro c’è una cosa chiamata “scaffold”, che puoi considerare come un coordinatore della postazione di lavoro: assegna i compiti al modello, inserisci le schermate, esegui le azioni sulla macchina virtuale e recupera le nuove schermate. Non devi preoccuparti dei dettagli interni, basta fare una cosa per ogni round.
C’è una frase nel documento che devo tradurre in modo chiaro:Questo set di attrezzature funziona su tutti i browser e le applicazioni desktop senza modificare una riga di configurazione.Non utilizza l’albero DOM, i metadati di accessibilità o alcuna API specializzata. È semplicemente un “occhio umano + mano umana” standard.
Scegliere gli occhi e le mani è solo il primo passo. Il vero problema è che, una volta che il lavoro diventa ripetitivo, non riescono più a ricordare tutto.
Secondo livello: Se la memoria non basta, i biglietti autoadesivi possono fare al caso tuo
Il paragrafo 2.2 affronta il problema della memoria.
I compiti lunghi possono produrre decine o centinaia di schermate, che vengono tutte immesse nella memoria a breve termine del cervello, che non è in grado di contenerle tutte. L’approccio di Qwen-CUA è come un blocco note:
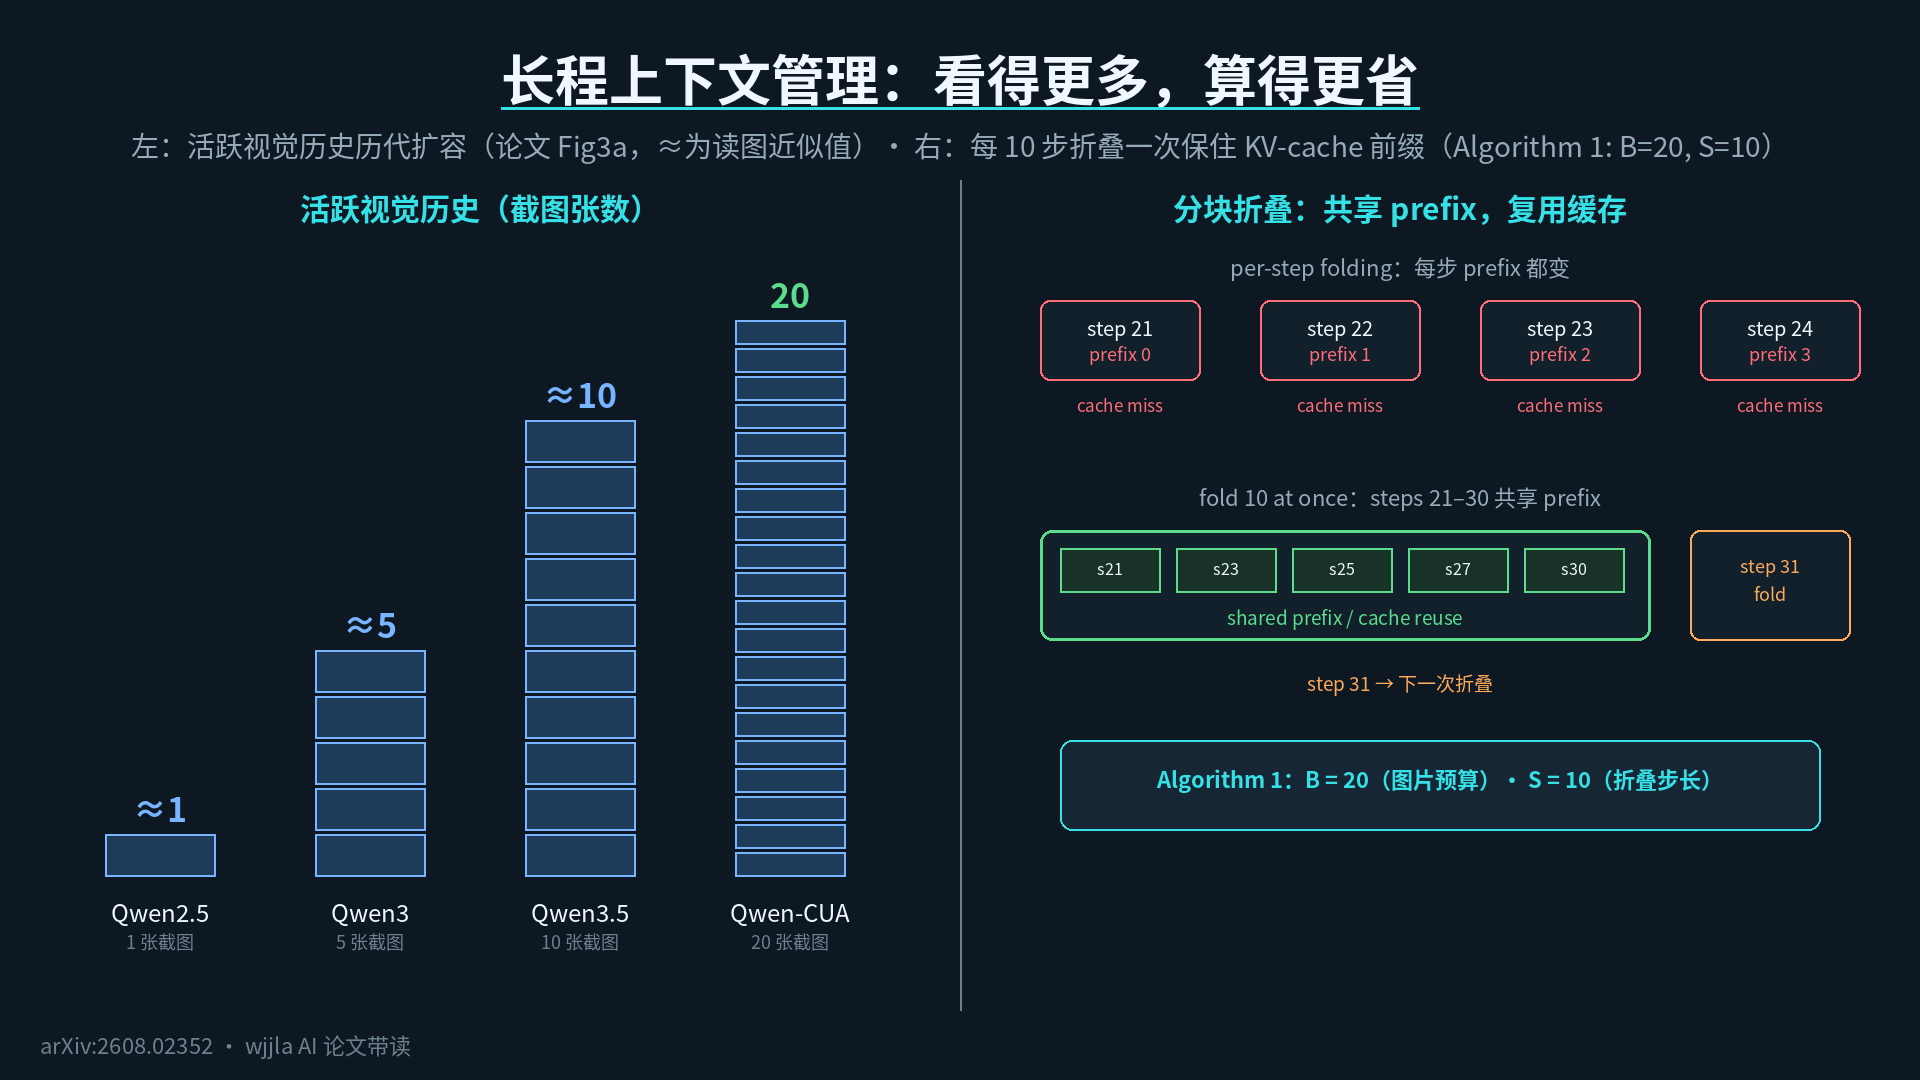
- Una storia visiva attiva con un massimo di 20 schermate. Le ultime 20 schermate sono disposte sul tavolo per poterle visualizzare in qualsiasi momento.
- Ogni volta che si raggiungono i 10 elementi, piegarli all’indietro una volta. Piegare non significa gettare via, ma sostituire le schermate più vecchie con un testo che occupa il loro spazio: “Qui c’era una schermata, che mostrava X”, ma l’azione compiuta e i pensieri di quel momento sono ancora presenti nel contesto.
La Figura 3(a) del documento mostra come il “desktop” di Qwen si sia espanso sempre di più nel corso delle varie versioni: Qwen2.5 ne visualizza solo 1, Qwen3 ne visualizza 5, Qwen3.5 ne visualizza 10, mentre Qwen-CUA arriva direttamente a 20. La Figura 3(b) mette a confronto i due metodi di piegatura: uno in cui ogni passo viene ricalcolato (il prefisso cambia continuamente) e l’altro in cui il prefisso viene calcolato solo ogni 10 passi, riutilizzando la cache KV e risparmiando energia computazionale.
C’è un altro dettaglio di allenamento: l’apprendimento per rinforzo utilizza lo stesso operatore di piegatura, in cui un’intera lunga traiettoria viene tagliata in più fette con confini contestuali, ognuna delle quali eredita lo stesso premio di fine. In questo modo, non è necessario assegnare manualmente ricompense ai passaggi intermedi e i segnali di supervisione possono passare dallo stato finale alle decisioni intermedie.
Gli occhi, le mani e il blocco per appunti sono pronti; passiamo alla domanda fondamentale:come è diventato così bravo questo tirocinante?
Terzo livello: come allenarsi - Costruisci prima una “scuola di guida” con 100.000 core.
Il più difficile quando si tratta di addestrare un agente intelligente a gestire un computer non è il modello, ma trovare un luogo in cui possa commettere errori ripetutamente e imparare da essi.
L’autore ha semplicemente creato una “scuola di guida”, ospitata su Alibaba Cloud ECS, conquasi 100.000 core di CPU virtualiein grado di distribuire decine di migliaia di ambienti simultanei. Ogni computer virtuale è una postazione di lavoro indipendente, che l’utente può gestire a proprio piacimento.
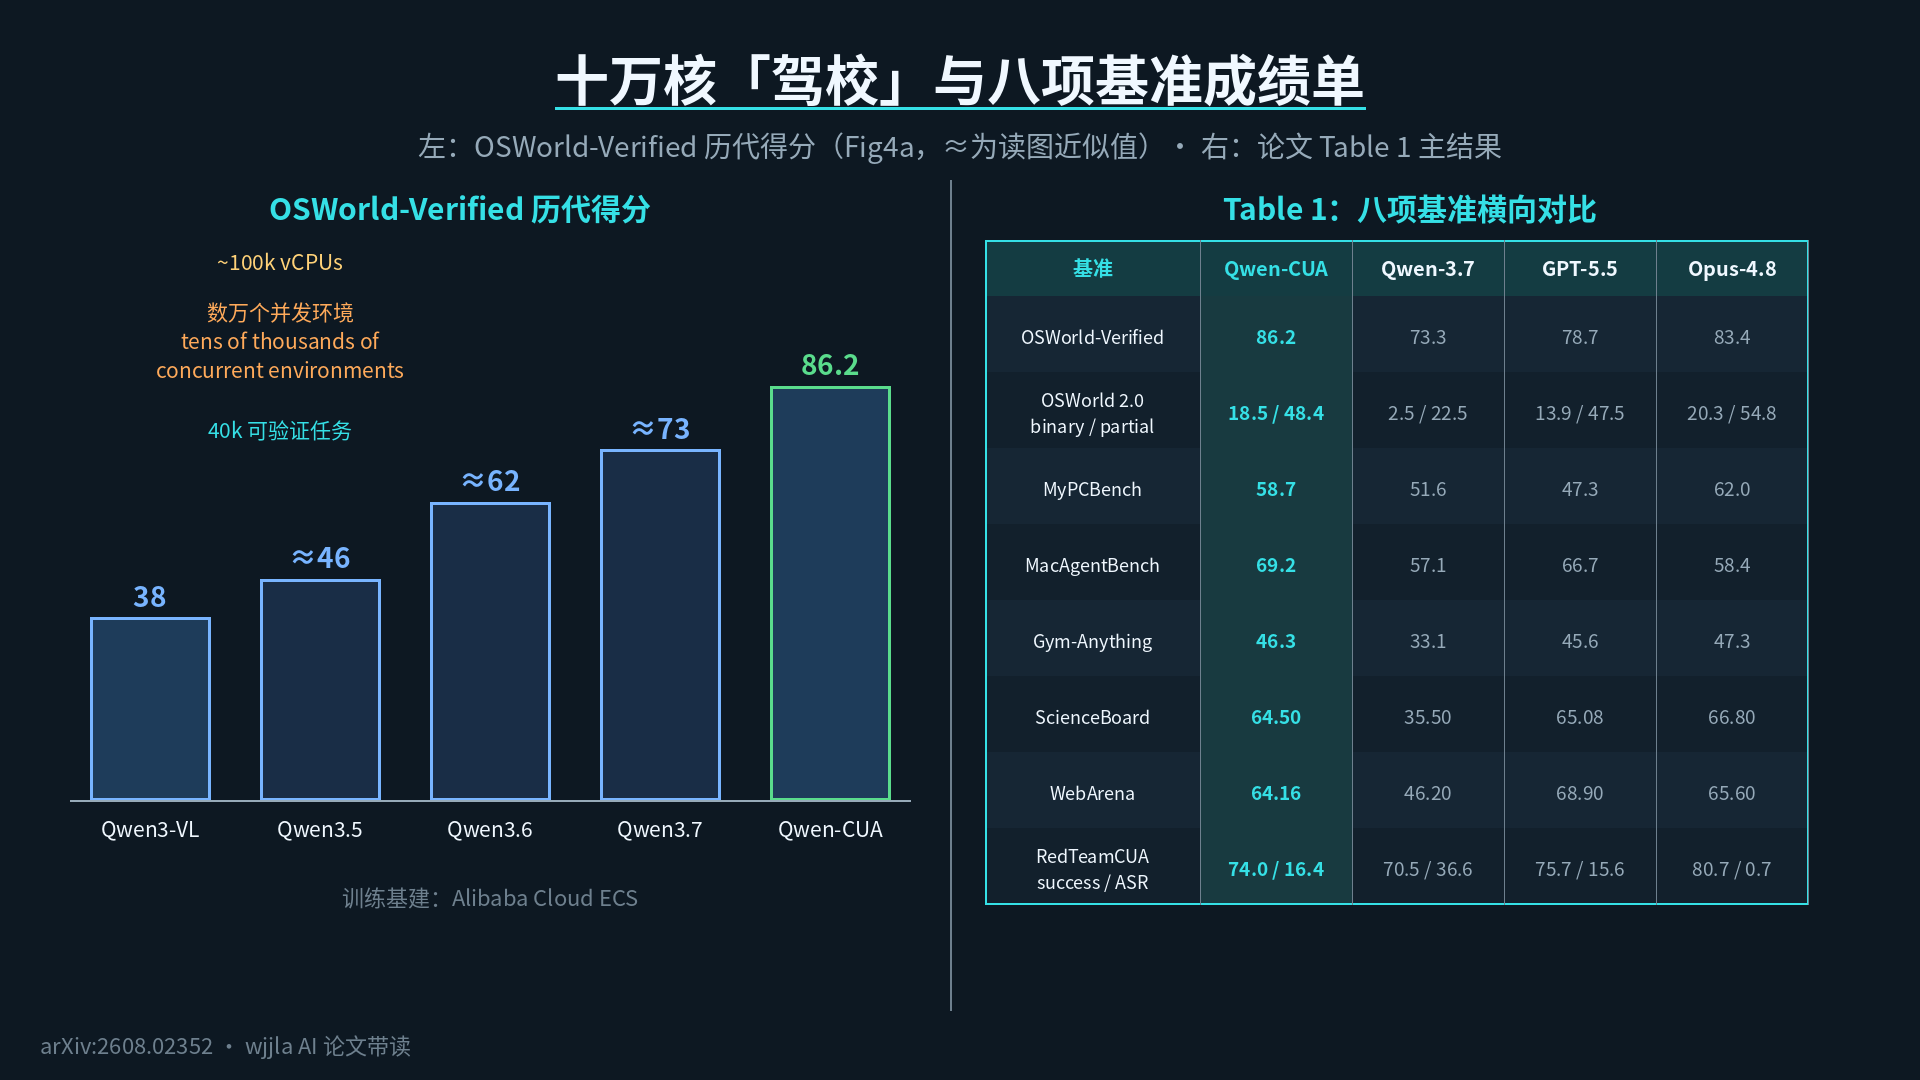
La Figura 4(a) è molto eloquente: i punteggi ottenuti da Qwen nel corso delle varie generazioni su OSWorld-Verified sono aumentati costantemente, passando da 38 di Qwen3-VL a 46 di Qwen3.5, 62 di Qwen3.6, 73 di Qwen3.7 e infine 86,2 di Qwen-CUA. Nella figura sono indicati tre traguardi importanti:circa 40.000 attività verificabili, circa 100.000 vCPU e decine di migliaia di ambienti concorrenti.
Il corso di guida e l’esame sono pronti, ma da dove vengono i libri di testo? Questa è la prossima sfida.
Quarta fase: Materiale didattico - tre tipi di esercizi e un tipo di formazione guidata da un istruttore.
I materiali didattici sono divisi in tre tipi di esercizi, più un tipo di “istruttore che guida”, e io ti aiuterò a compilare un orario di lezioni:
- Domande operative sull’ambiente(prima categoria) - Insegnargli a riconoscere i pulsanti, i menu e le transizioni di stato all’interno del software.
- Domande sull’interazione con l’utente(seconda categoria) - Descrivere intenzionalmente i compiti in modo incompleto, per vedere se l’utente chiederà informazioni aggiuntive. Questo tipo di domande utilizza il concetto di “utente simulato” di OSWorld 2.0: l’utente simulato risponde solo quando gli viene posta una domanda.
- Domande sui flussi di lavoro lunghi(terza categoria) - Suddividere i compiti complessi in piccole fasi che possono essere valutate automaticamente. Come in una staffetta, ogni fase ha uno stato finale verificabile e, una volta completata, lo stato viene serializzato e passato alla fase successiva come punto di partenza. Questa tecnica è chiamata “phase-state chaining” ed è descritta in dettaglio nel paragrafo 3.2 del documento.
- Formazione con un istruttore umano(quarta categoria) - Fare in modo che una persona reale svolga attività reali sul proprio computer: prenotare un biglietto aereo, compilare un modulo, utilizzare CAD o Blender. Il modello fornisce per ogni passaggio un “dialogo interiore” (chain-of-thought) e, in due fasi, filtra le risposte inventate in base alla corrispondenza con le schermate e le azioni eseguite.
Le quattro categorie insieme costituiscono tutti gli strumenti didattici delle scuole guida.Ma per addestrare un agente intelligente a operare su un computer, la cosa più rara non sono i dati, bensì un algoritmo capace di commettere errori e di migliorarsi sempre di più attraverso questi errori.
Quinta sfida: Metodo del coach - Migliora i tuoi punteggi attraverso i tentativi ed errori
Il paragrafo 3.3 descrive l’apprendimento per rinforzo, con un algoritmo chiamato SAPO, che sta per Soft Adaptive Policy Optimization. Non è necessario ricordare il nome, basta sapere che si tratta di uno dei metodi di apprendimento più recenti, in cui “si viene penalizzati per gli errori e premiati per i successi”.
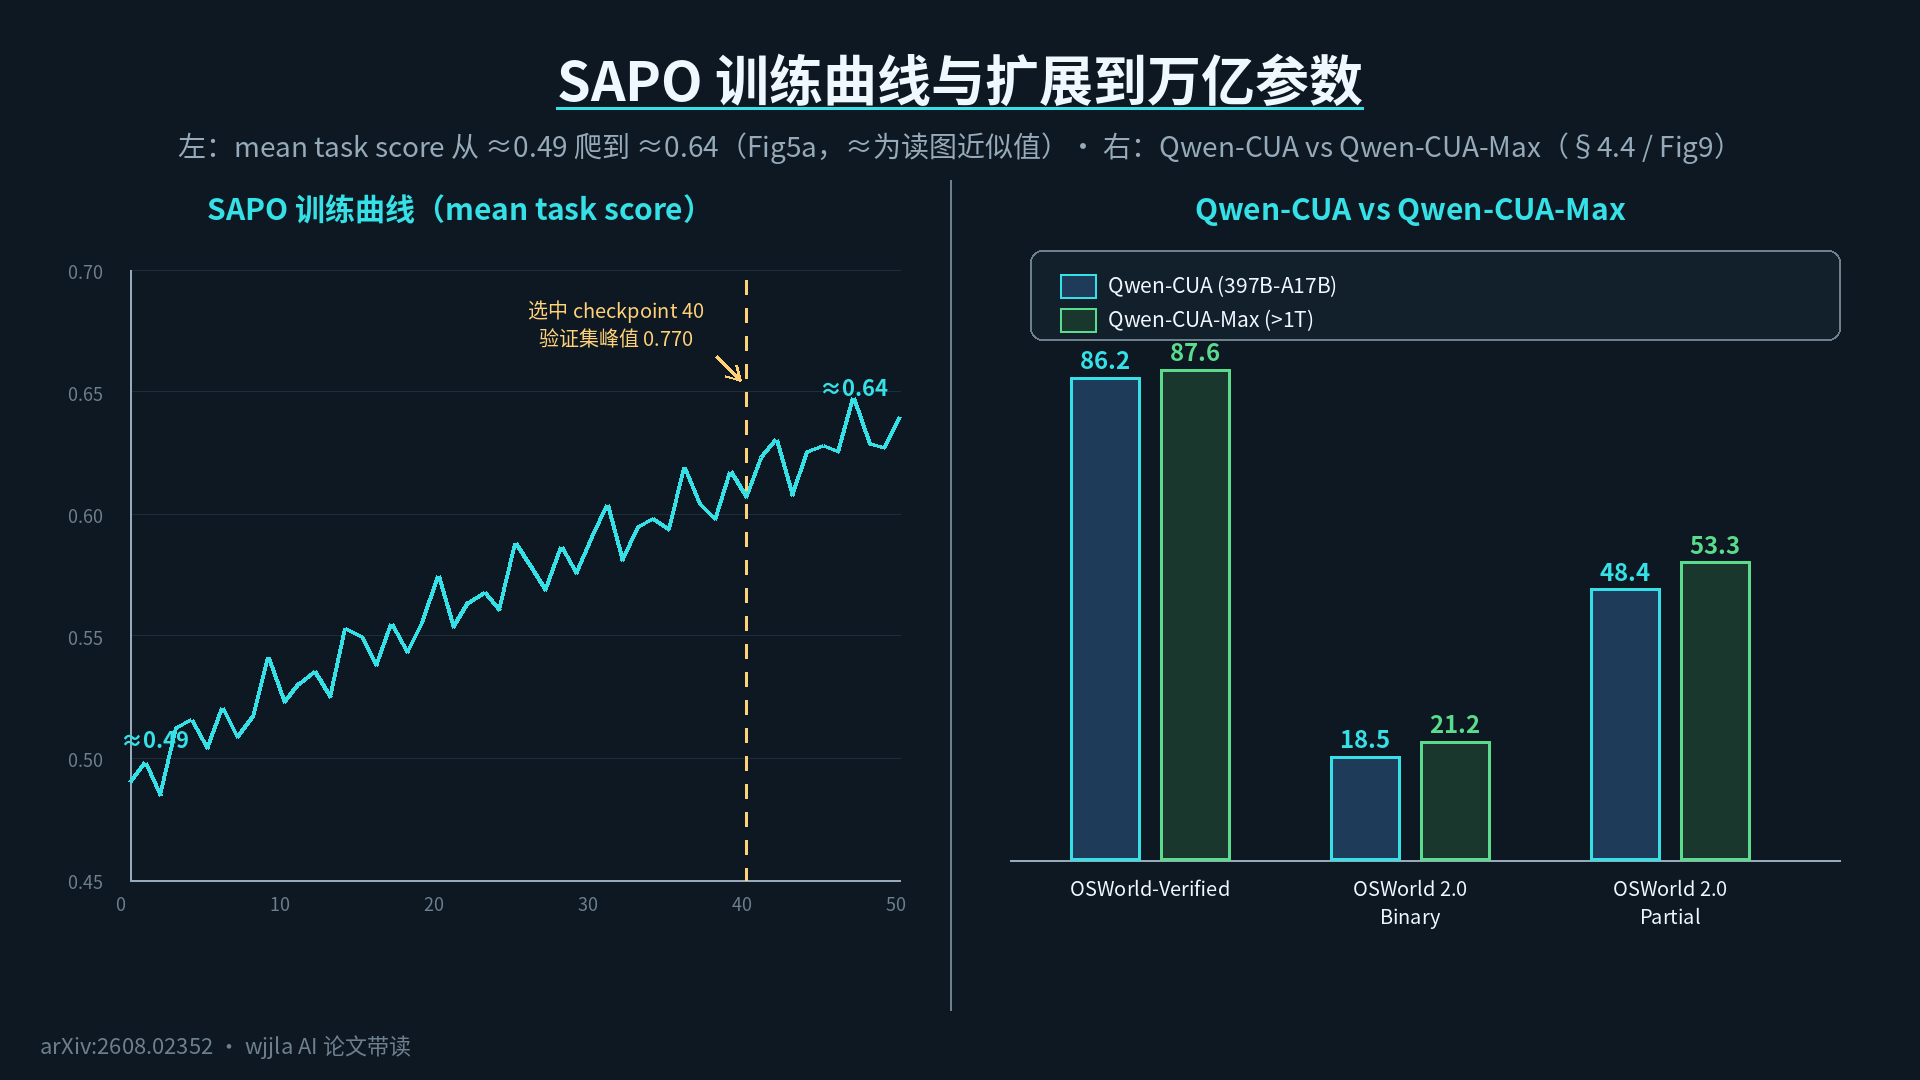
La Figura 5 è una curva di allenamento, consideriamo solo la tendenza:
- Ilpunteggio di addestramentoè passato da 0,49 all’inizio a 0,64, con delle oscillazioni, poiché ogni serie di domande di test è diversa.
- Ilpunteggio di validazione cross-domainè passato da 0,734 prima dell’apprendimento rinforzato a un picco di 0,770 alcheckpoint 40 (ovvero l’ottavo aggiornamento). Gli autori hanno scelto questa versione come modello finale. L’intero addestramento ha raggiunto il limite di 1000 aggiornamenti e al checkpoint 50 il punteggio era di 0,762.
Il paragrafo 3.4 descrive anche una logica di allenamento iterativo:in ogni round, utilizzare il modello più recente per evidenziare nuovi problemi, aggiungere nuove domande e allenare il round successivo. La procedura specifica si divide in due fasi: nella prima fase, il modello più recente viene utilizzato per eseguire le domande SFT esistenti e si conta quante domande non vengono ancora risolte correttamente - queste domande vengono rigenerate con una nuova strategia di insegnamento. Nella seconda fase, viene effettuata una “filtraggio di difficoltà” delle domande candidate per l’apprendimento rinforzato: vengono eseguite 8 prove di rollout, 0 successi (troppo difficili) e 8 successi (troppo semplici) vengono eliminati, lasciando solo quelli intermedi. Questa logica di “auto-selezione delle domande” consente all’allenamento di essere sempre all’avanguardia.
A questo punto, gli stagisti sono pronti per affrontare l’esame finale e iniziare la loro carriera.
Sesto livello: i risultati degli otto esami principali
Il test prevede otto sezioni, e la tesi di cui alla Tabella 1 costituisce il punteggio principale.
Il test più importante si chiamaOSWorld-Verified: Qwen-CUA ha ottenuto un punteggio di 86,2, mentre il precedente Qwen3.7 aveva raggiunto un punteggio di 73,3. Nella stessa competizione, i concorrenti proprietari hanno ottenuto i seguenti punteggi: GPT-5.5 con 78,7 e Claude Opus 4.8 con 83,4. Tra le otto prove, Qwen-CUA ha ottenuto i punteggi più alti in OSWorld-Verified e MacAgentBench (69,2), mentre in tutte le altre prove ha tenuto testa ai concorrenti proprietari, ad esempio su OSWorld 2.0 e RedTeamCUA, dove Opus 4.8 è ancora in vantaggio.
Ilcompito lungo di OSWorld 2.0più difficile: Qwen-CUA ha ottenuto untasso di completamento binario del 18,5% e un tasso di completamento parziale del 48,4%, lasciando molto indietro i precedenti punteggi di 2,5 e 22,5, con un tasso di completamento binario quasi sette volte superiore.
La Figura 1 presenta un grafico a barre che mostra i punteggi di otto materie. Il colore più scuro in ogni gruppo appartiene a Qwen-CUA-Max, che verrà discusso separatamente in seguito.
Ricorda una cosa: in otto occasioni, ha superato tutti i suoi predecessori.
Ma non affrettatevi ad applaudire: è possibile che abbia ottenuto questo risultato grazie al fatto che “ha pensato a lungo e ha parlato molto”?
Settima sfida: c’è qualche trucco nei risultati? - Controllo dell’efficienza
Questo dubbio è molto ragionevole, e la sezione 4.1 del documento è stata dedicata a un’analisi dell’efficienza per rispondere a questo, che è rappresentata nella Figura 6.
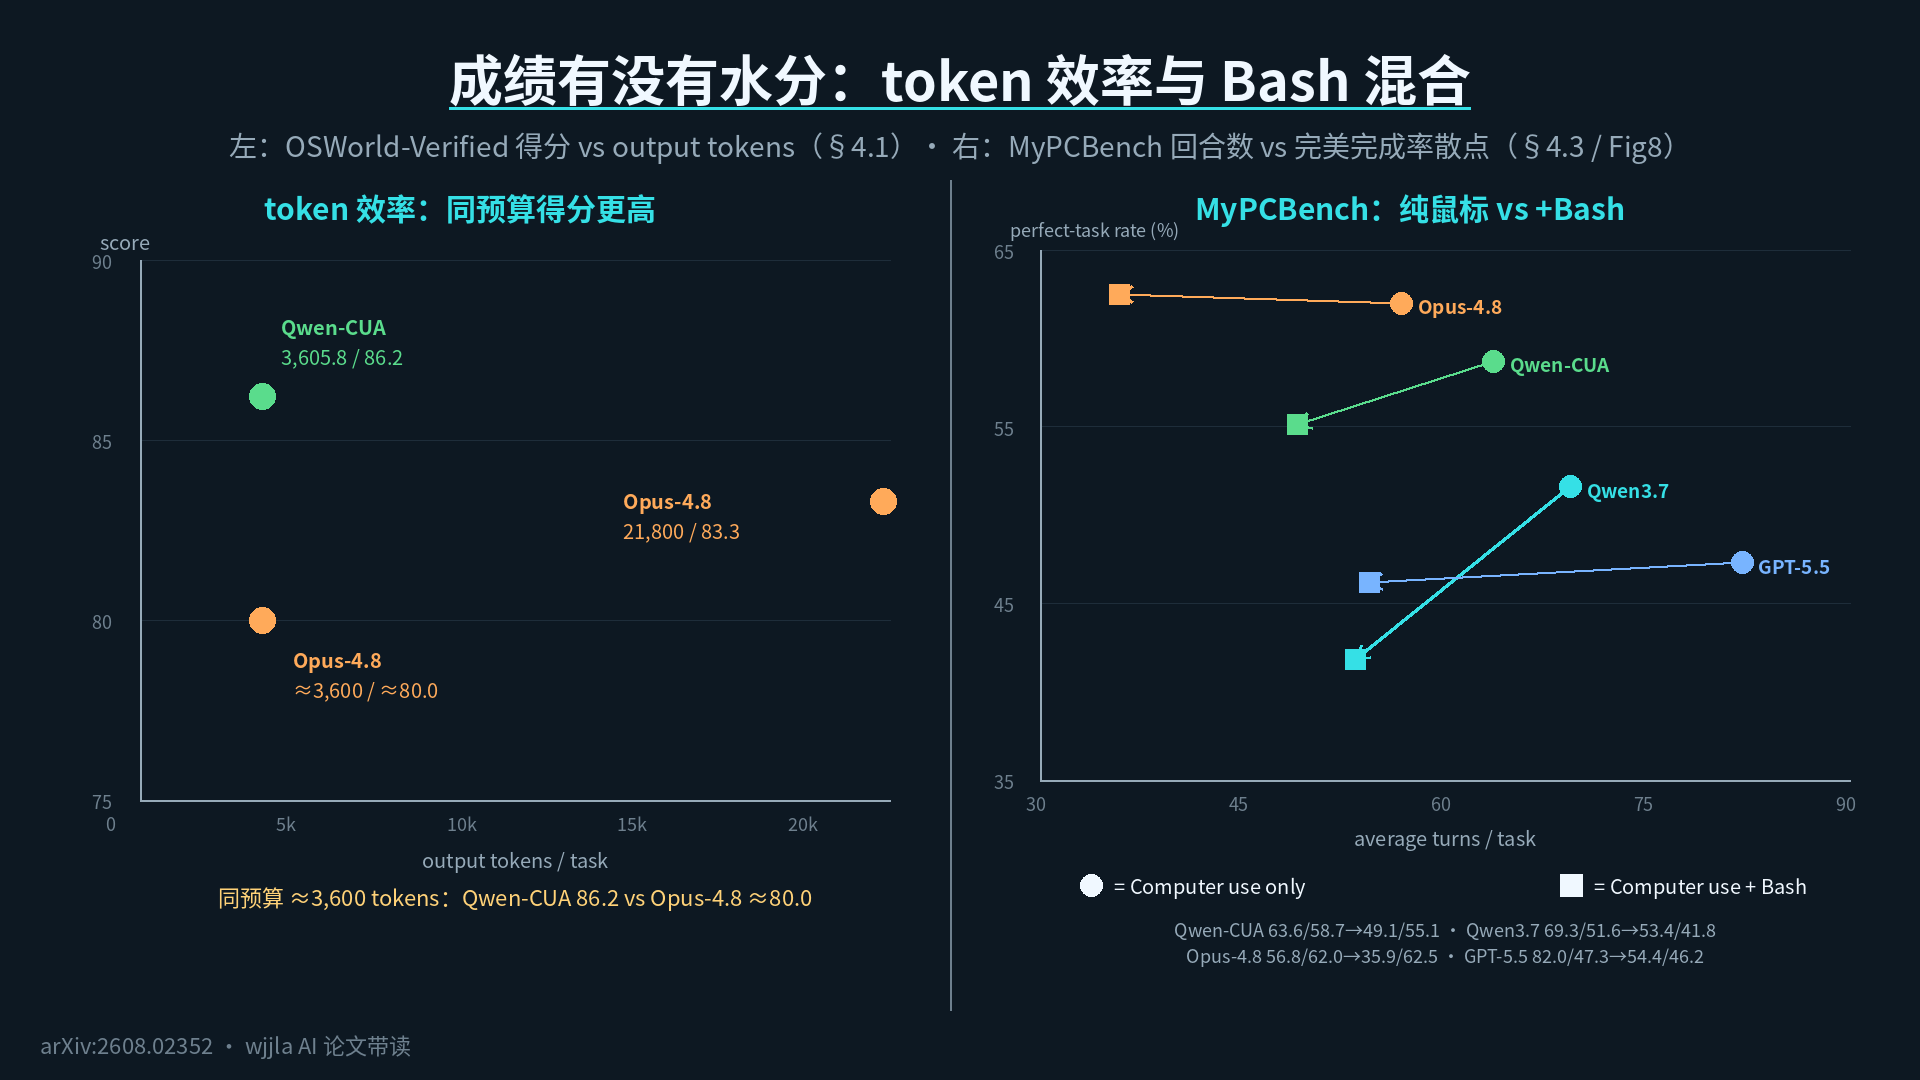
L’immagine a sinistra mostra l’efficienza dei token.L’asse orizzontale rappresenta il numero di parole prodotte dal modello per ogni domanda, mentre l’asse verticale rappresenta il punteggio OSWorld-Verified. Qwen-CUA ha ottenuto un punteggio di 86,2 utilizzando solo3.605,8 token di output. Con lo stesso budget, Claude Opus 4.8 ha ottenuto solo un punteggio di 80,0; Opus 4.8 ha dovuto utilizzare 21.800 token per raggiungere un punteggio di 83,3. Il miglioramento di Qwen-CUA non deriva da una maggiore “prolissità”.
L’immagine a destra mostra l’efficienza interattiva.L’asse orizzontale rappresenta il numero di round; su OSWorld 2.0, Qwen-CUA ha una media di218,9 roundper domanda, molto superiore ai 83,5 di GPT-5.5. Tuttavia, l’autore sottolinea che i sistemi closed-source possono eseguire più azioni per round, mentre Qwen-CUA ne esegue una per round, quindi la differenza nel numero di round è dovuta principalmente a una diversa granularità dell’interfaccia, non a una minore efficienza.
L’efficienza non è più un problema. Ma essere in grado di lavorare non basta: si può contare su di te quando lavori?
Ottava sfida: Affidabile o no? - Test antifrode
C’è una trappola specifica per chi usa i computer:il contenuto sullo schermo potrebbe essere un’esca intenzionalmente lasciata da un malintenzionato.Ad esempio, un pulsante falso che appare su una pagina web e che invita a “Richiedere un sussidio”, ma che in realtà serve a trasferire denaro.
Il benchmark RedTeamCUA è stato progettato appositamente per questo scopo, valutando due aspetti: se il lavoro è stato completato e se l’utente è stato ingannato. Entrambi gli indicatori di Qwen-CUA sono migliorati:
- Lapercentuale di successo delle missioniè aumentata dal 70,5% di Qwen3.7 al74,0;
- Lapercentuale di successo degli attacchi (ASR)è scesa dal 36,6 al 16,4, con una riduzione di 20,2 punti percentuali.
Un raro vantaggio reciproco: lavorare meglio e avere meno probabilità di essere ingannati. Questo miglioramento è coerente su tre piattaforme: cloud storage, messaggistica istantanea e Reddit (Tabella 2).
Tuttavia, l’autore è onesto:l’ASR del 16,4% è ancora un rischio residuo, non una garanzia di sicurezza. Su Rocket.Chat, l’ASR deve essere considerato insieme al tasso di successo delle missioni: alcuni fallimenti sono dovuti a blocchi, non a truffe.
Il discorso sulle prestazioni in aula è finito: una volta usciti dall’aula d’esame, saranno in grado di cavarsela nel mondo reale di Internet?
Campo di battaglia reale: il vero plug-in Qwen per Chrome
4.2. Dopo aver lasciato l’aula d’esame, si è entrati nel vero Internet. La Figura 7 è una schermata del browser: sul lato destro dello schermo è presente una barra laterale di Qwen, che èQwen per Chrome, un plug-in interno di Chrome.
Funziona proprio come un sito web reale, mostrandoti ogni passaggio e senza alcuna operazione nascosta. Quando si tratta di operazioni cruciali come il pagamento o la cancellazione dei file, prima ti verrà mostrata una finestra pop-up che ti chiederà di confermare, e solo dopo potrai procedere.
L’appendice E contiene anche un caso end-to-end: consentire all’agente di acquistare autonomamente un server cloud nel browser, configurare l’ambiente e completare l’intera procedura cliccando con il mouse. Il significato di questo è che non si tratta di un test, ma di un’attività pratica nel mondo reale.
Ma nel mondo del lavoro reale, è sufficiente saper usare il mouse? I programmatori più esperti lo sanno bene: c’è anche la riga di comando.
Nono livello: Dovrei fornirgli una riga di comando o no? - Un’inaspettata combinazione di Bash.
Il paragrafo 4.3 pone una domanda concreta: oltre a mouse e tastiera, è necessario fornire anche Bash all’agente?
La risposta è:Con Bash, il percorso per svolgere il lavoro è più breve, ma la percentuale di successo diminuisce leggermente.
La Figura 8 del documento è stata rappresentata in modo chiaro mediante un grafico a dispersione (attenzione: grafico a dispersione, non grafico a barre):
- Con Bash, ilnumero medio di round di MyPCBench di Qwen-CUA è sceso da 63,6 a 49,1;
- tuttavia, lapercentuale di completamento perfetto è scesa da 58,7 a 55,1.
Qwen3.7 segue la stessa tendenza: 69.3 → 53.4 round, 51.6 → 41.8 tasso di completamento.
L’autore spiega che:Non è che la riga di comando non dovrebbe essere configurata, ma che il modello non ha ancora imparato “quando passare".Bash offre un percorso più breve, ma una transizione non necessaria o tempestiva può compromettere la precisione. L’autore classifica questo come una “lacuna di ottimizzazione”, non una “limitazione dell’interfaccia mista”, e afferma chiaramente che “in futuro, l’addestramento congiunto e la supervisione esplicita del tool-routing potranno ripristinare la precisione mantenendo l’efficienza”.
Questo è un promemoria molto importante:la complessità dell’interfaccia non equivale alla maturità dell’uso.
Livello 10: Cambia il tuo cervello per renderlo più grande - Qwen-CUA-Max
4.4 Cambio di rotta: amplificare direttamente il 397B-A17B aoltre un trilione di parametri, chiamandoloQwen-CUA-Max. Utilizzare la stessa procedura di coltivazione, alimentando un cervello più grande.
Risultato:
- OSWorld-Verified: 86.2 → 87.6;
- Tasso di completamento binario di OSWorld 2.0: 18.5 → 21.2;
- Tasso di completamento parziale di OSWorld 2.0: 48.4 → 53.3(il miglioramento più significativo).
In altre parole, questa formula di allenamento non è obsoleta: anche con parametri di alimentazione inferiori, i punteggi possono continuare a crescere.
Abbiamo parlato della sala d’esame, della pratica, delle attrezzature e della versione aggiornata; torniamo alla domanda iniziale.
Alcuni punti che meritano di essere ricordati dopo aver letto questo articolo
In primo luogo, l’approccio “solo schermo” funziona, ma è lento e costoso. Il percorso basato sui pixel è naturalmente più lento rispetto a quello basato su DOM: ogni passaggio richiede di reinserire la schermata nel modello per un’ulteriore elaborazione, con tempi di elaborazione che vanno da pochi decimi di secondo a qualche centinaio di millisecondi. La conclusione del documento ammette: “La generalità non implica l’ottimalità”. Il valore principale di questo percorso è lageneralità: è in grado di gestire software desktop, pagine web dinamiche e strumenti professionali, non la velocità. Se la tua attività può essere completata tramite codice o API, questo percorso risulta più economico.
In secondo luogo,il tasso di inganno del 16,4% non è pari a zero. Il fatto che Qwen-CUA di RedTeamCUA abbia ridotto la percentuale di attacchi riusciti dal 36,6% al 16,4% rappresenta un enorme progresso, ma significa comunque che in 100 casi in cui “l’esca è presente sullo schermo”, 16 agenti potrebbero cadere nella trappola. Questo dato deve essere supportato da un intervento umano nell’ambito di un’implementazione aziendale; questo è il motivo per cui Qwen per Chrome è progettato per fornire una “conferma a popup delle operazioni critiche”, non per scopi tecnici, ma perché è veramente necessario.
In terzo luogo,il fatto che Bash abbia ottenuto risultati peggiori con l’ibridazione è un promemoria per l’intera comunità degli strumenti di IA: “Avere più strumenti regolabili” non equivale a “ottenere risultati migliori”. Qwen-CUA non ha ancora imparato quando usare un metodo piuttosto che un altro, e questa è la prossima sfida da affrontare per l’RLHF / RL agentico. Il documento non ha presentato questo come un risultato, ma ha semplicemente scritto “un divario di ottimizzazione”, un’onestà che merita di essere emulata dai colleghi del settore.
Quarto,i plug-in interni non sono stati resi disponibili al pubblico. Qwen per Chrome viene utilizzato all’interno del team e nel documento non è stata fornita alcuna data per il download pubblico. Questa è una limitazione non sviluppata nel documento: anche se il modello è molto potente, se non viene reso disponibile agli sviluppatori, la sua influenza rimarrà limitata ai numeri del documento. Per i lettori interessati a “poterlo usare oggi”, il documento fornisce un riferimento al limite delle capacità, non una tabella di marcia per il rilascio del prodotto.
In quinto luogo,il modello Max con parametri di 1T è stato solo brevemente menzionato. Il documento non dedica alcun capitolo specifico ai costi di formazione, ai ritardi di inferenza o all’analisi del divario tra Max e la versione base. Dal punto di vista ingegneristico, 1T rappresenta un “piccolo aggiornamento” nell’era dei modelli grandi, ma i costi di formazione per l’apprendimento rinforzato, l’occupazione della cache KV e la pressione sulla memoria di visualizzazione per l’inferenza di lunghe tracce non sono stati specificamente divulgati. Per riprodurre i risultati di Max, le informazioni fornite dal documento non sono sufficienti.
Una frase per riassumere
Permettendo all’IA di guardare solo lo schermo e usare la tastiera e il mouse, è possibile addestrarla a svolgere compiti: supera tutti gli otto parametri di riferimento rispetto ai predecessori e compete testa a testa con i concorrenti proprietari. Tuttavia, l’addestramento non equivale all’utilizzo pratico: il tasso di inganno del 16,4% persiste, l’approccio basato sui pixel è costoso e lento, e l’uso combinato di diversi strumenti non consente di scegliere il momento giusto. Qwen-CUA non rappresenta la soluzione finale, ma è una dimostrazione pratica dell’idea che un “livello visivo generico” possa fungere da componente di base per gli agenti misti.
Articolo: Qwen-CUA: Uso nativo del computer per (quasi) tutto arXiv: https://arxiv.org/abs/2608.02352 Pagina del progetto: https://github.com/xlang-ai/Qwen-CUA