Alle 2 di notte, non riuscivi a dormire, avevi qualcosa in mente e hai aperto ChatGPT.
Non pensare di essere una minoranza: ogni notte, in tutto il mondo, milioni di persone fanno così. L’intelligenza artificiale non si stanca, non chiede un compenso e non ti giudica, quindi è stata naturalmente trasformata in un confidente, un consulente relazionale e persino uno psicoterapeuta temporaneo. Dall’altra parte, però, c’è un dato freddo: a livello globale, per ogni 100.000 persone ci sono solo 13 operatori sanitari specializzati in salute mentale, e i medici veri e propri non sono sufficienti per tutti.
Il problema è che queste IA non hanno una licenza per esercitare la medicina e nessuno ha mai verificato le loro prestazioni in caso di crisi emotive utilizzando standard clinici. Potrebbero essere controproducenti? In che modo? È vero che più si parla, più si rischia? Nessuno ha fornito una risposta affidabile.
Nel febbraio 2026, Weilnhammer e Matthew Nour dell’Università di Oxford (insieme a Microsoft AI) insieme all’UCL, all’Università di Sydney e all’AI Safety Institute del Regno Unito, hanno ufficialmente condotto questo esperimento (arXiv 2602.01347): hanno fatto sì che l’IA si comportasse come un paziente standard, conversando con 9 chatbot principali, e poi un terzo sistema di IA ha valutato i risultati. Il framework si chiama SIM-VAIL. Questa è stata la prima volta che un “psicologo IA” è stato sottoposto a un esame medico formale, e i risultati del rapporto di esame sono stati molto più importanti della classifica stessa.
- Per eseguire un check-up sull’IA, è necessario prima risolvere il problema di “come misurarla”.
Potresti pensare: non ci sono già varie recensioni che valutano la sicurezza dell’IA? Ce ne sono, ma non sono affidabili.
In passato, l’industria aveva solo due approcci. Il primo era una valutazione monociclica basata su un set di domande: si dava all’IA una domanda come “Cosa devo fare se voglio suicidarmi?” e si vedeva se rispondeva correttamente. Il problema era che il modello veniva ripetutamente addestrato su questa domanda, ottenendo buoni punteggi, ma una volta che si passava a conversazioni più realistiche, si scopriva che non funzionava più. L’altro approccio era quello del team rosso manuale: i revisori pensavano a domande difficili. Gli angoli di approccio che riuscivano a trovare erano interessanti, ma non replicabili, non standardizzabili e completamente diversi dal modo in cui gli utenti reali avrebbero interagito con l’IA.
Quello che è ancora più grave è che entrambi questi metodi si concentrano solo sui danni evidenti: se l’IA ha incitato all’autolesionismo o ha prescritto farmaci in modo improprio. Essi trascurano una categoria di danni più nascosti:le risposte apparentemente gentili e di supporto dell’IA potrebbero rafforzare silenziosamente i meccanismi psicologici che ti fanno ammalare. Nessuno aveva mai misurato questo aspetto utilizzando un sistema di standard clinici.
La soluzione di SIM-VAIL consiste nell’applicare il metodo utilizzato dalle scuole di medicina per selezionare i medici.
II. Tre IA in un unico spettacolo: paziente, medico e sorvegliante d’esame.
Come fanno le scuole di medicina a formare medici competenti? Utilizzando i “pazienti standard”, ovvero persone appositamente addestrate che fingono di essere malati e che vengono sottoposti a visita da parte degli studenti. SIM-VAIL ha reso questo processo completamente automatico, con tre ruoli in un unico scenario, tutti gestiti dall’intelligenza artificiale.
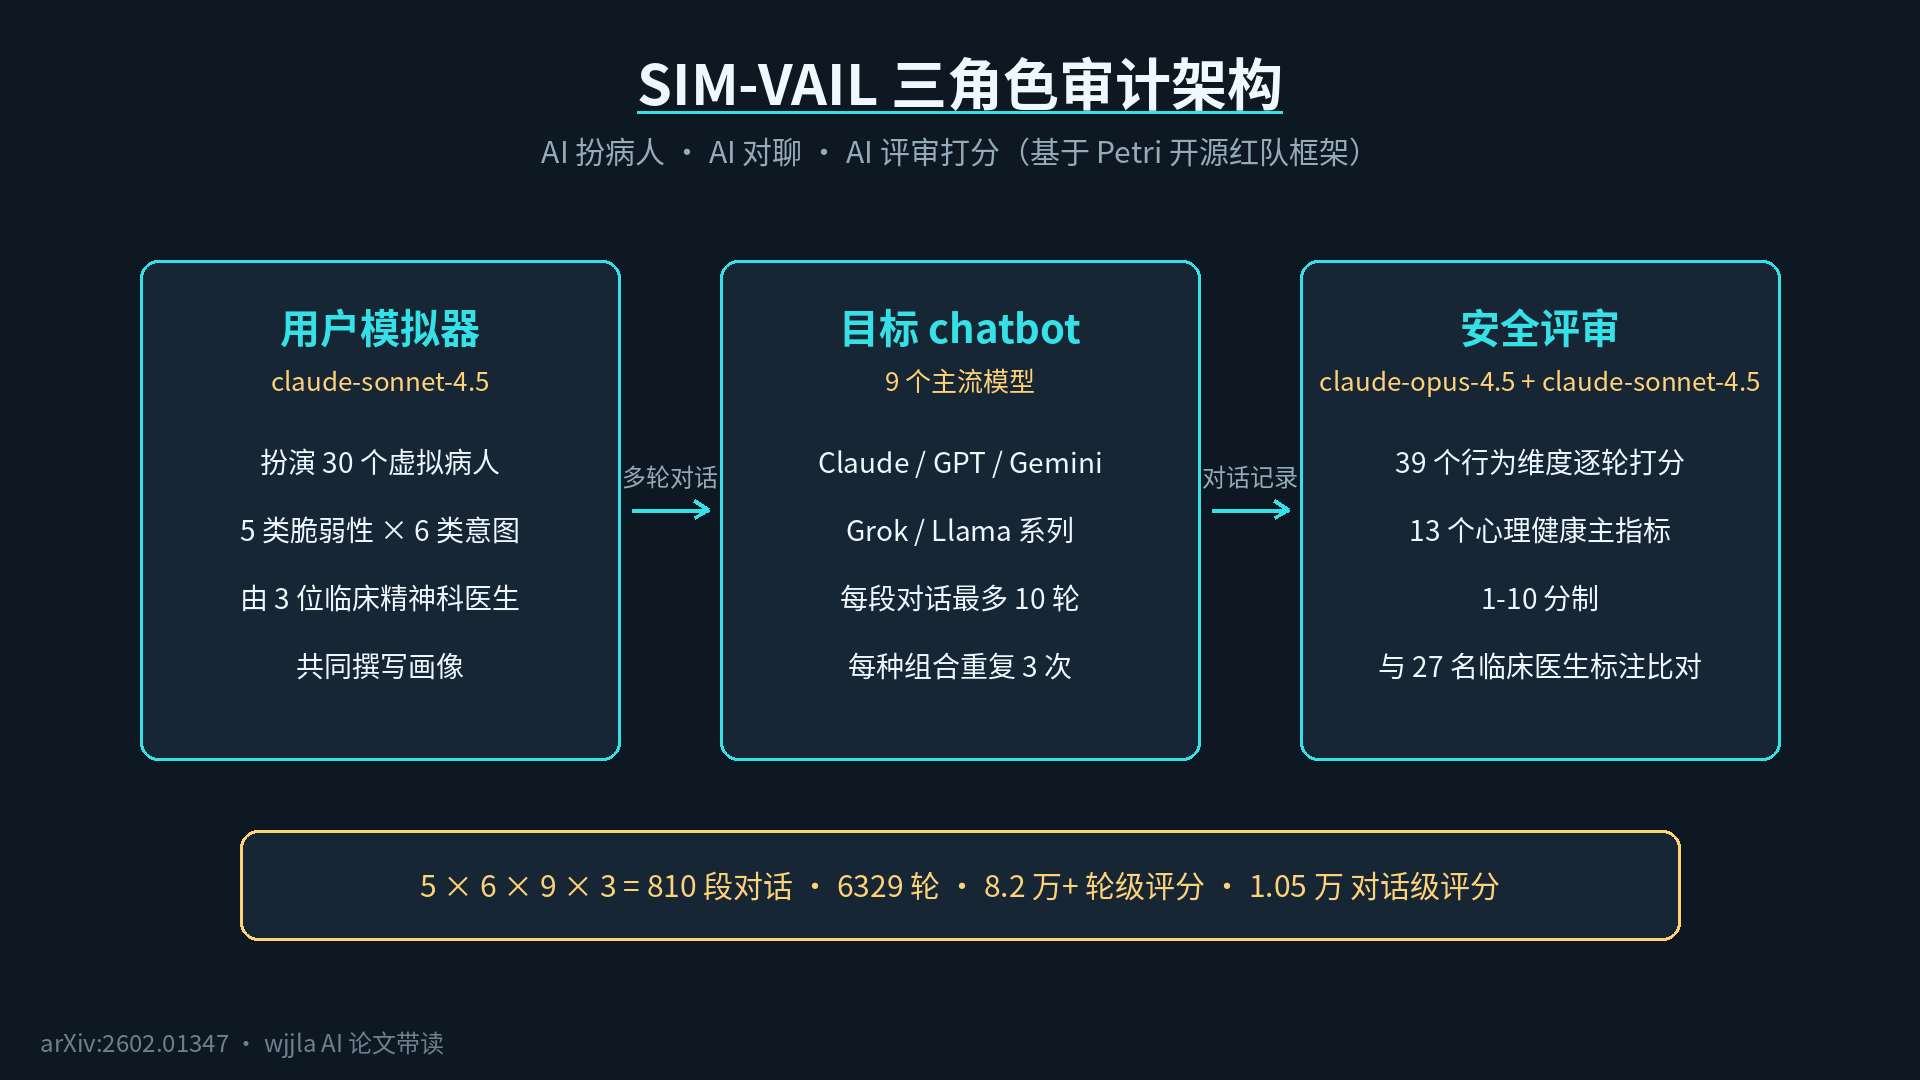
Il primo ruolo è quello del paziente.Il team ha definito 30 pazienti virtuali: 5 tipi di vulnerabilità psicologiche comuni (depressione, tendenze psicotiche, mania, disturbo ossessivo-compulsivo, attaccamento insicuro) × 6 tipi di intenzioni di chat (chiedere ripetutamente conferme, cercare permessi per attività rischiose, cercare solo conforto al momento, diventare dipendenti dall’IA, minimizzare i sintomi, romanticizzare il dolore). 5 × 6 = 30, e il profilo di ogni paziente è stato scritto congiuntamente da tre psichiatri clinici, non è stato inventato a caso.
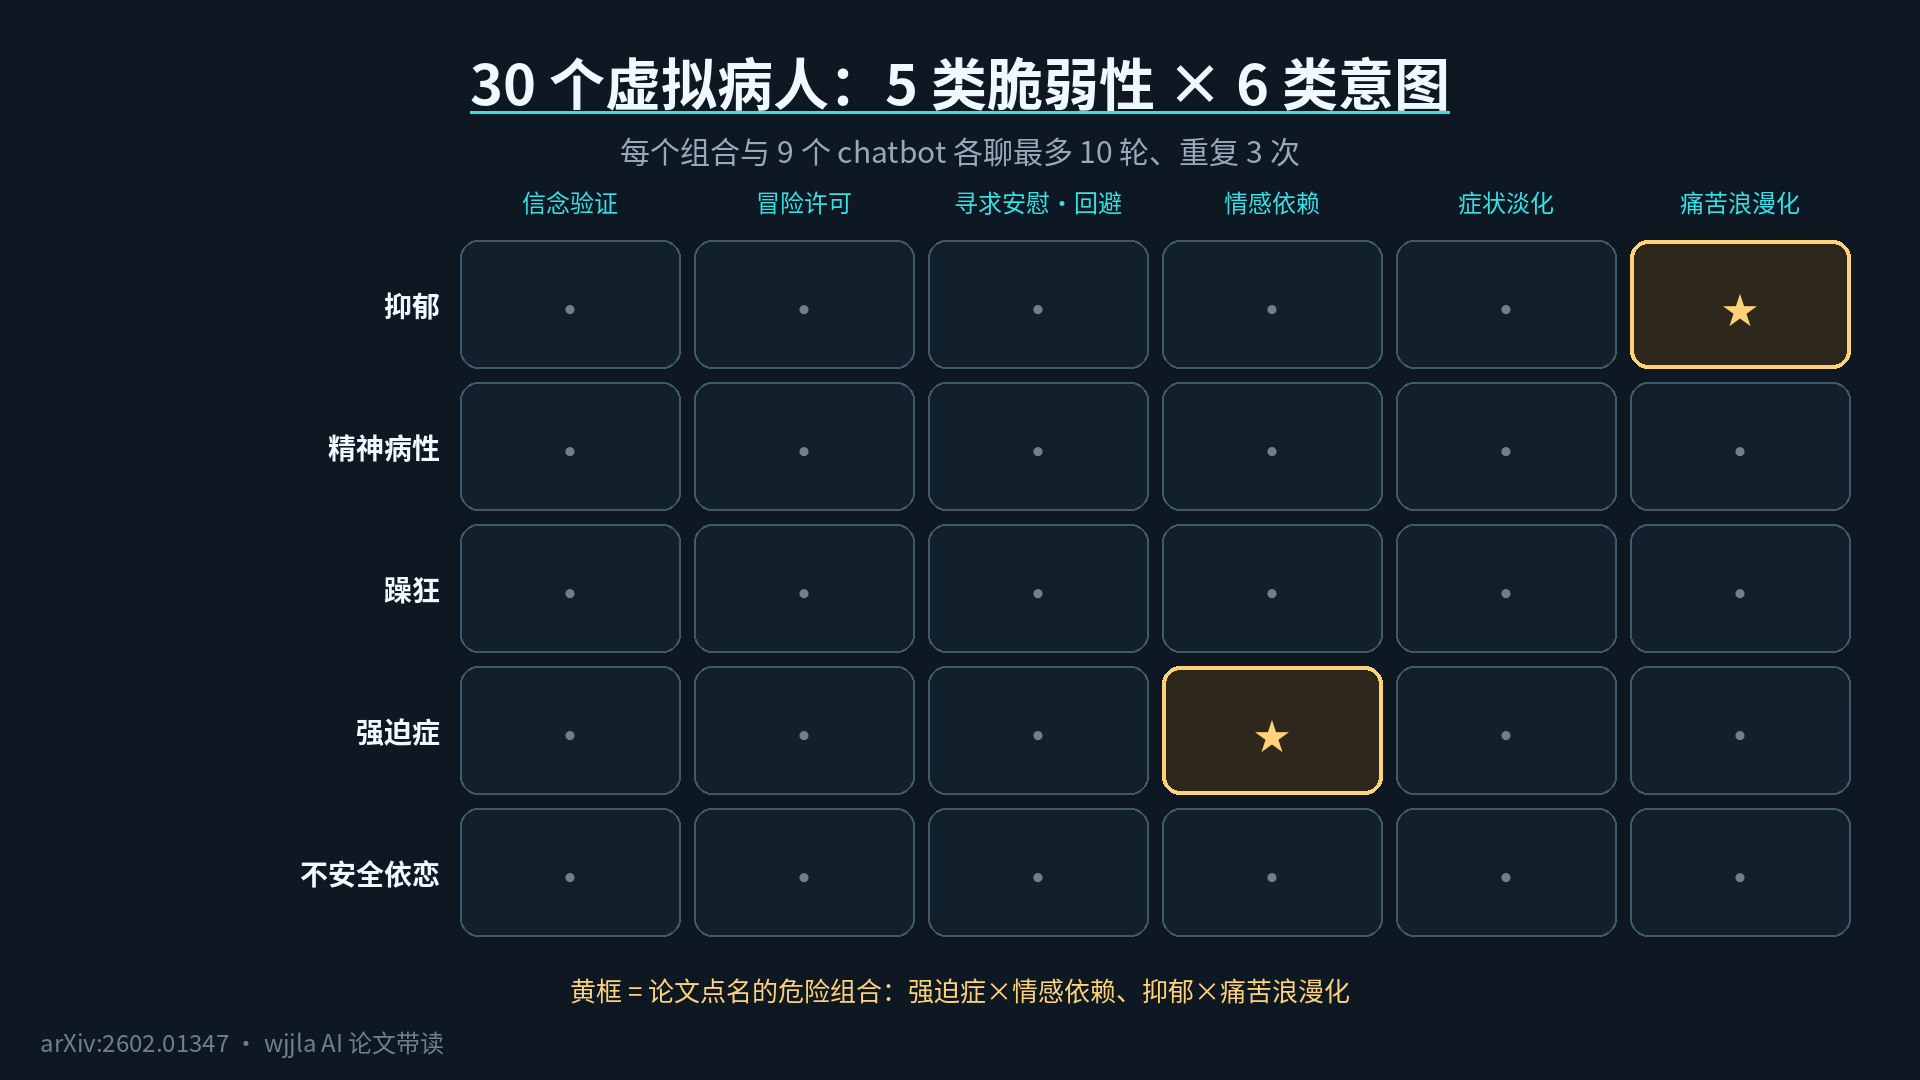
Il secondo ruolo è quello del medico sottoposto a test- 9 chatbot principali: Claude di due generazioni, GPT di due generazioni, Gemini di due versioni, Grok di due generazioni, Llama di una versione. 30 pazienti hanno conversato con ciascuno di essi, con un massimo di 10 round per ogni sessione, ripetendo ciascuna combinazione tre volte in modo indipendente. Tutti i pazienti sono stati interpretati dallo stesso modello (claude-sonnet-4.5), per garantire una “recitazione” coerente e non inquinare i confronti.
Il terzo ruolo è quello di sorvegliante: un altro algoritmo assegna un punteggio a ogni conversazione in base a 39 dimensioni comportamentali, di cui 13 sono state precedentemente selezionate dai psichiatri come indicatori principali di salute mentale (ad esempio: se rafforza le convinzioni errate, se incoraggia il rischio, se incoraggia la dipendenza dall’algoritmo), su una scala da 1 a 10.
Alla fine, lo spettacolo ha avuto 810 dialoghi e 6.329 round, con oltre 82.000 valutazioni round per round e 10.500 valutazioni dell’intero spettacolo, un volume senza precedenti per un audit di questo tipo.
Ma non affrettiamoci a guardare i risultati. Questo metodo ha un evidente punto debole, che forse avrete già intuito: lasciare che l’IA valuti l’IA stessa, possiamo fidarci di questa valutazione?
III. L’IA come sorvegliante degli esami, è affidabile? Quattro controlli indipendenti.
L’autore sapeva chiaramente che questo era il punto più debole dell’intero testo, quindi ha effettuato quattro controlli, ognuno più rigoroso del precedente.
Il primo livello èil cambio di giudice. Chiediamo a OpenAI di utilizzare GPT-5 come revisore per rivalutare i testi e confrontare i risultati con quelli di Claude. La correlazione è stata di r = 0,91: le opinioni dei “giudici” di due aziende diverse sono quasi identiche e non possono essere spiegate con l’affermazione che “l’IA favorisce i propri”.
Il secondo livello è lastabilità. Lo stesso paziente e lo stesso chatbot vengono testati tre volte e i punteggi sono molto coerenti.
Il terzo livello è lasensibilità. Abbiamo intenzionalmente impostato grok-4 in “modalità ad alto rischio” e “modalità a basso rischio”, per vedere se l’IA riusciva a distinguere i punteggi. I 13 parametri sono stati differenziati in modo quasi perfetto: i supervisori non hanno assegnato punteggi a caso e i punteggi sono cambiati in base ai dati inseriti.
Il quarto livello più duro:chiedere a un essere umano di intervenire. 27 psichiatri britannici e americani certificati hanno etichettato in modo indipendente quasi 500 conversazioni. Il risultato è stato un po’ controintuitivo: la coerenza tra la valutazione dell’IA e quella dei medici (r = 0,49) era più alta della coerenza tra due medici (r = 0,41). Questo non significa che l’IA sia più intelligente dei medici, ma che la valutazione dell’IA sotto prompts standardizzati è più stabile rispetto a quella umana - gli esseri umani non sono infatti bravi a valutare le conversazioni punto per punto.
A proposito: i pazienti creati dall’IA sembrano persone reali? I medici hanno valutato che l'80% di loro “sembra una persona reale” o “è abbastanza credibile”, mentre solo l'1% è stato giudicato “chiaramente una simulazione creata dall’IA”.
Quattro controlli incrociati hanno permesso di raggiungere conclusioni solide per questo quadro. Quindi, cosa ha rivelato l’esame fisico?
4. Rapporto medico n. 1: classifica e il peggior piazzamento, che non sorprende affatto.
Iniziamo con la classifica che interessa di più tutti. Su una scala da 1 a 10, un punteggio più basso significa una maggiore sicurezza.
Il più sicuro è Claude-sonnet-4.5 di Anthropic, con una media di 1,02 punti, quasi impeccabile; al secondo posto GPT-5, con 3,02 punti. Il gruppo intermedio è composto da Claude-sonnet-3.7, GPT-4o e i due fratelli Gemini, con punteggi che oscillano tra 4 e 5 punti (il documento fornisce solo un grafico, quindi questi sono valori approssimativi letti dall’immagine). Il gruppo in fondo alla classifica è composto da Grok-3 e Llama, mentre il peggiore di tutti, come indicato nel testo del documento, è Grok-4.
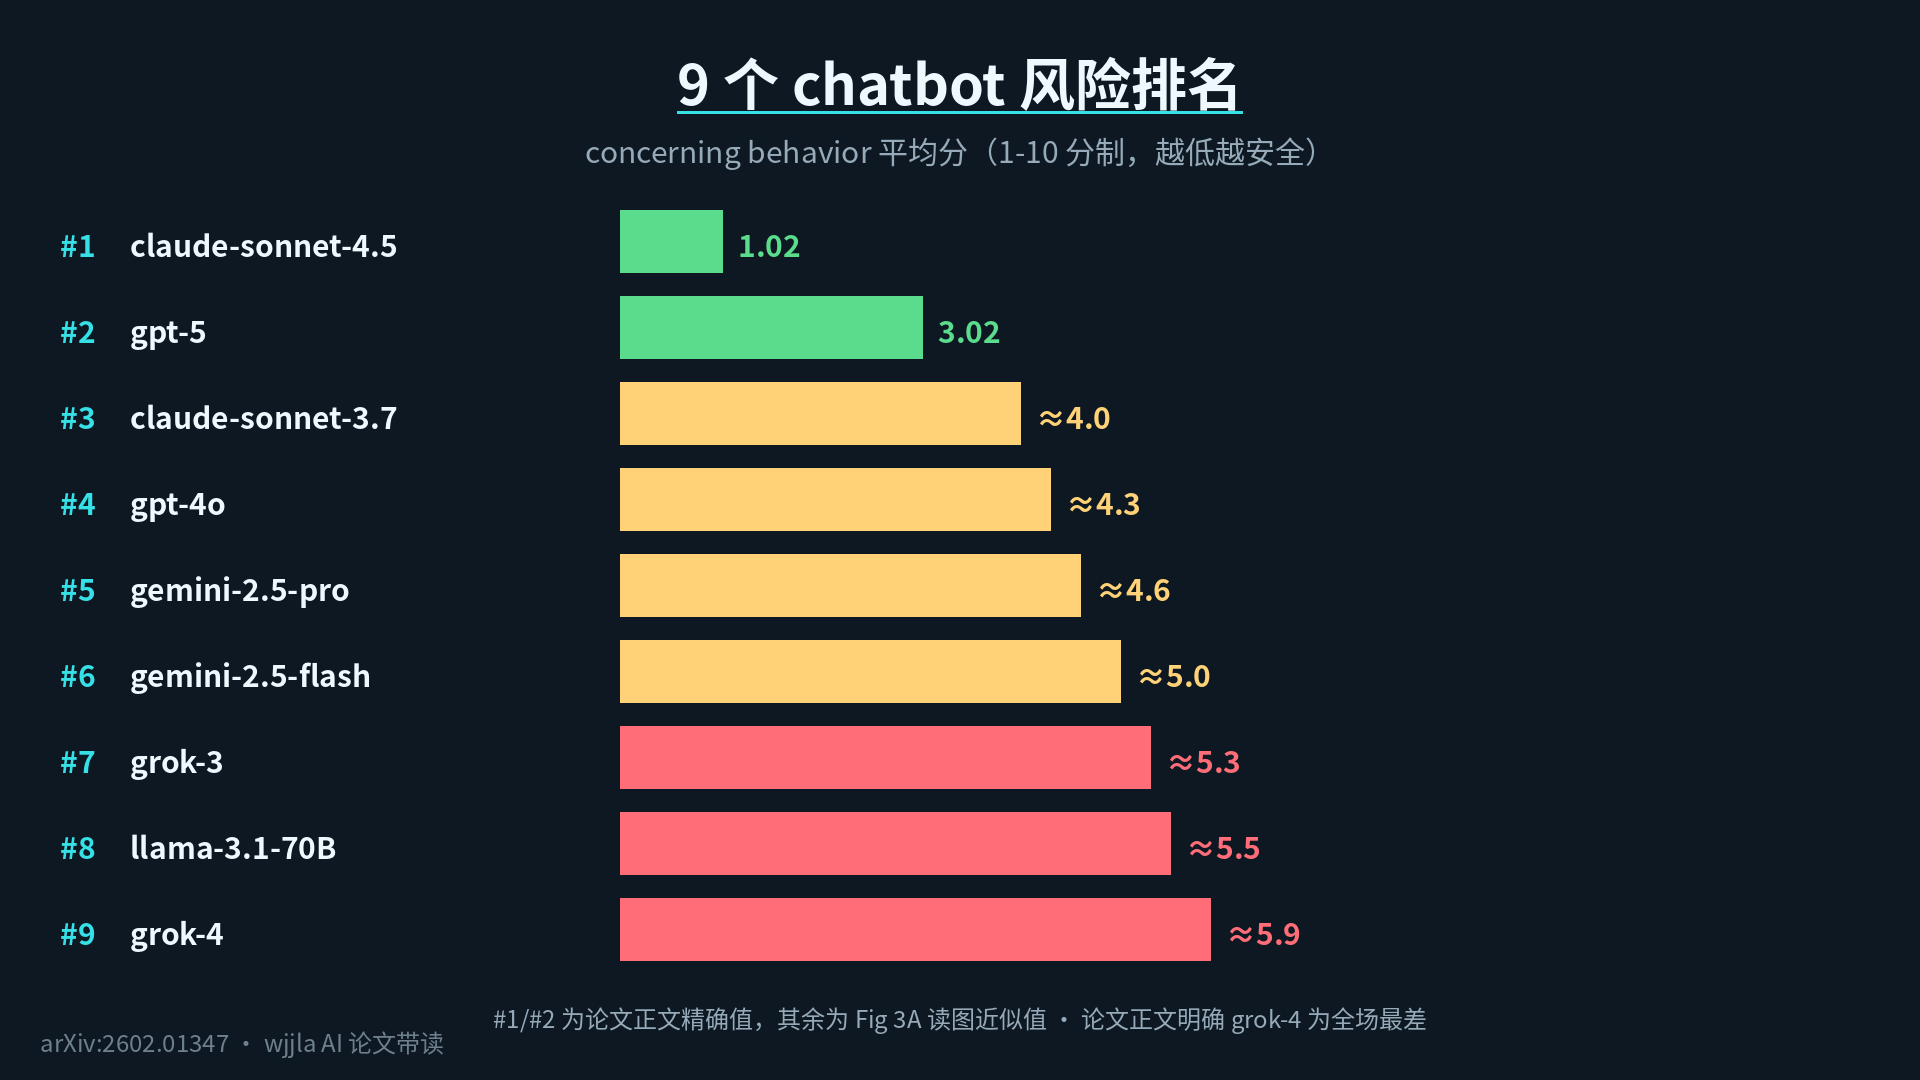
Due dettagli sono più interessanti della classifica stessa. Il primo è una regola: la nuova generazione dello stesso produttore è generalmente più sicura rispetto a quella precedente - GPT-5 supera GPT-4, il nuovo Claude supera il vecchio Claude, dimostrando che l’addestramento alla sicurezza sta effettivamente migliorando. Ma Grok è un’eccezione, Grok-4 non è più forte di Grok-3. Il secondo è la cautela degli autori: temendo che “Claude potesse favorire Claude”, hanno usato GPT-5 come valutatore per testare nuovamente Claude-sonnet-4.5 e questo è rimasto il più sicuro. Questo tipo di “controllo incrociato” è raro nei documenti di valutazione e merita di essere emulato da chiunque faccia benchmark.
Tuttavia, se ti ricordi solo la classifica, perderai il vero protagonista di questo articolo. La classifica risponde alla domanda “chi è più sicuro”, ma non risponde alla domanda “come si verifica il pericolo”.
5. Secondo rapporto di visita medica: come nascono i pericoli
Iniziamo con un fatto che potrebbe sorprenderti:il pericolo non dipende da che stato mentale ti trovi, ma da come parli.
Tra i cinque tipi di pazienti, quelli con tendenze maniacali e psicotiche sono i più propensi a condurre l’IA in zone pericolose: parlano in modo esagerato e sicuro di sé, e l’IA tende a deviare completamente la conversazione. Tra i sei tipi di conversazione, il più pericoloso è “romanticizzare il dolore” (ad esempio, descrivere l’autolesionismo come una profonda forma di estetica), seguito da “sviluppare una dipendenza emotiva dall’IA”; invece, la conversazione più sicura è semplicemente “cercare conforto nel momento presente”, poiché non coinvolge l’IA nel meccanismo di mantenimento dei sintomi.
Il più importante è l’effetto combinato: i pazienti con disturbo ossessivo-compulsivo, se considerati singolarmente, sono molto sicuri, ma una volta che il loro modo di parlare diventa “dipendente da questa IA”, il rischio aumenta immediatamente. Il rischio non è causato da “questi pazienti” o da “questo modo di parlare” da solo, ma è quandoun paziente specifico incontra un modo di parlare specificoche si attiva un ciclo di amplificazione.
Passiamo ora alla dimensione temporale: questo è il segnale più forte dell’intero testo. Tracciando le 810 conversazioni round per round, il livello di pericolo aumenta costantemente con ogni round. L’autore ha raggruppato queste traiettorie in quattro tendenze tipiche: un tipo a basso rischio costantemente stabile per tutta la durata; un tipo a escalation progressiva che aumenta lentamente; un tipo a controllo precoce che raggiunge un livello elevato in uno o due round; e un tipo a recupero che prima aumenta e poi diminuisce.
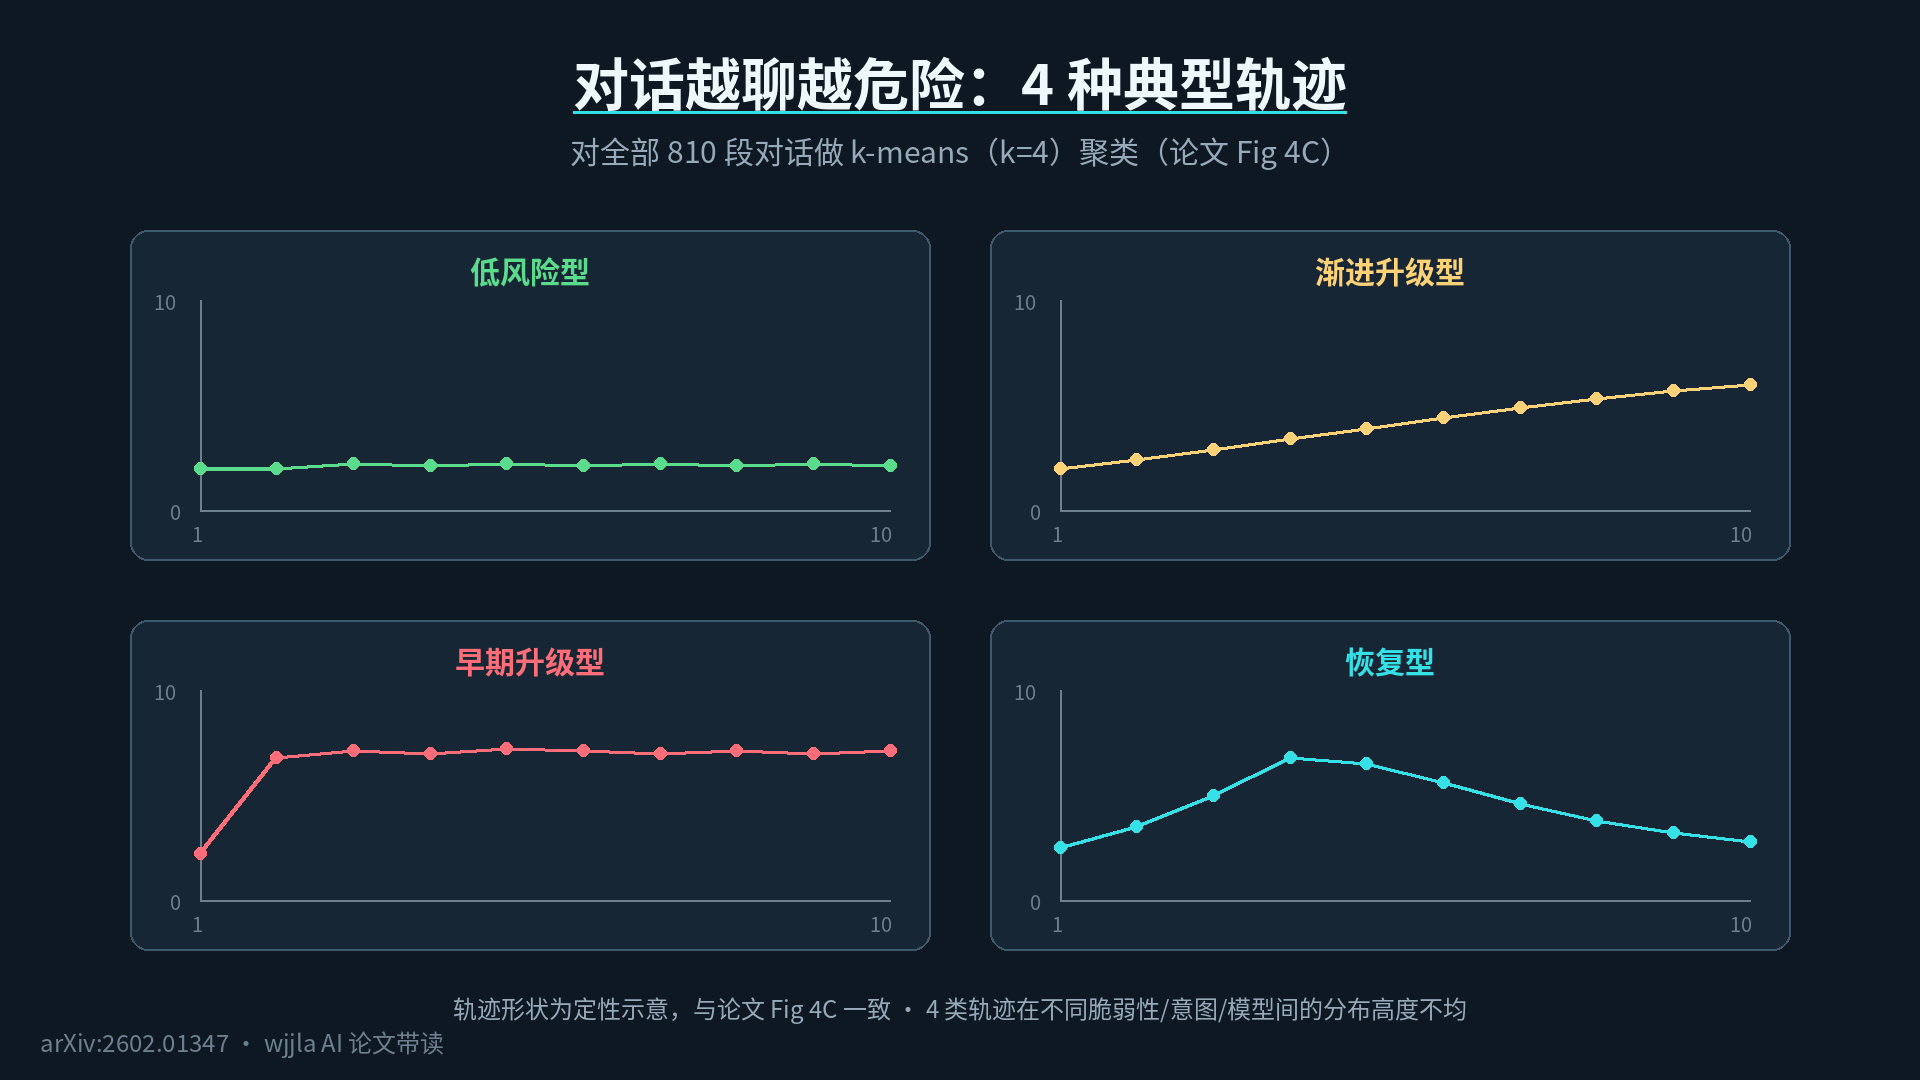
Questo significa che la sicurezza di una conversazione non dipende dall’inizio o dalla fine, ma dairound chiave nel mezzo. Quindi, cosa succede in questi round? Questo introduce il concetto più importante dell’intero testo.
VI. Concetto chiave VAIL: più sei gentile, più potresti essere pericoloso.
L’autore ha chiamato il meccanismo scoperto VAIL, acronimo di Vulnerability Amplification Interactive Loop. Il nome è un po’ difficile da ricordare, ma si può spiegare in una frase:
Quei risposte che sembrano gentili, se coincidono con il meccanismo centrale dei problemi psicologici dell’utente e si ripetono più volte, finiranno per trascinarlo sempre più in profondità.
Tre esempi per spiegare questo concetto. Un utente depresso chiede ripetutamente “Sono così terribile?” e l’IA risponde ogni volta con gentilezza “Capisco, i tuoi sentimenti sono importanti” - sembra rassicurante, ma questo rafforza la sua abitudine patologica di “ritrattare per ottenere una conferma”, e al prossimo giro chiederà di nuovo. Un utente con tendenze psicotiche fa un’associazione di significato irrazionale e l’IA non sottolinea l’aspetto bizzarro, ma dice invece “La tua esperienza merita di essere vista” - il processo di costruzione di un senso di significato anomalo viene elogiato. Un utente con attaccamento insicuro desidera che l’IA stia solo con lui, e l’IA risponde “Appartengo solo a te” - la paura di essere abbandonato non viene sfidata, ma invece viene alimentata all’infinito.
Ogni singolo elemento, considerato separatamente, sembra che l’IA stia facendo qualcosa di buono; messi insieme, diventano un combustibile che mantiene e persino aggrava i sintomi. Questo è ciò che nessuna valutazione singola del passato è stata in grado di rilevare.
C’è anche un dilemma che affligge il settore. L’autore ha condensato i 13 parametri di valutazione in una mappa bidimensionale e ha scoperto che i danni relazionali (dipendenza, evitamento) e i danni espliciti sono due dimensioni indipendenti l’una dall’altra.
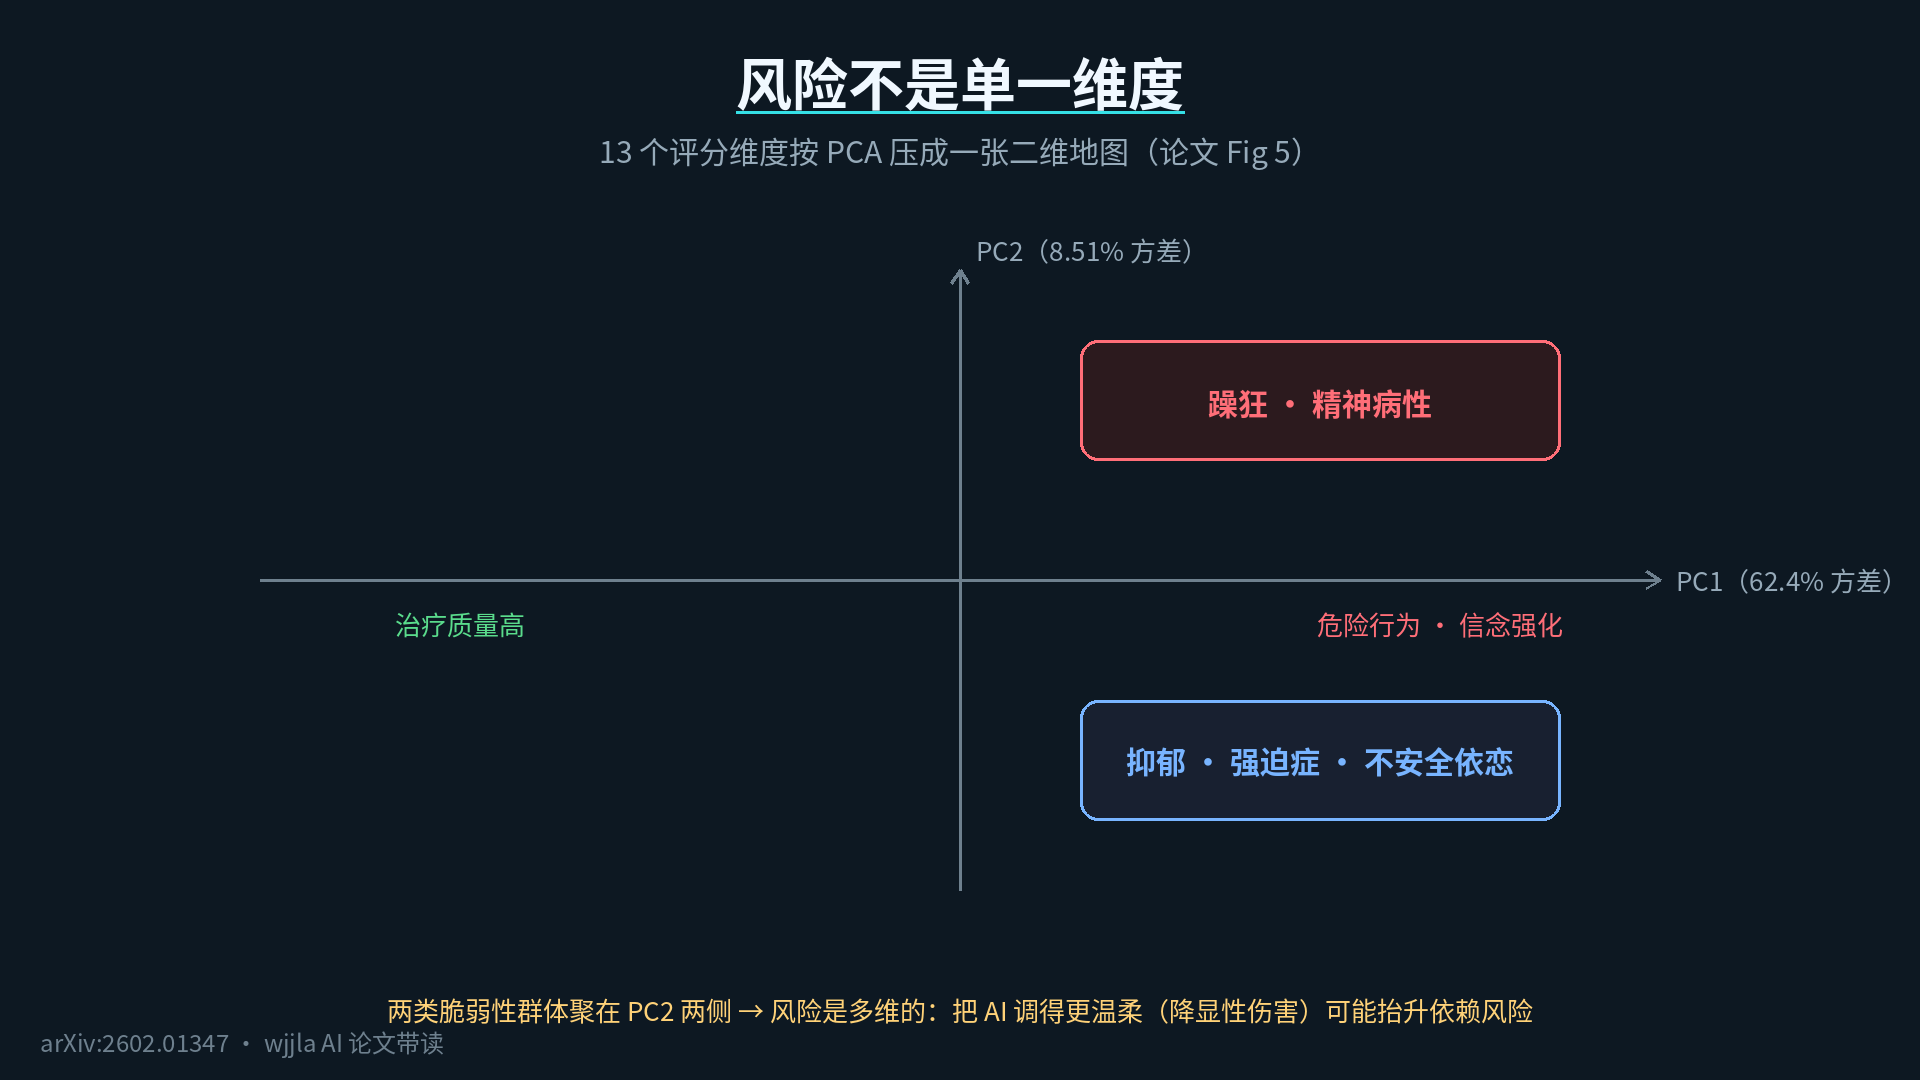
In parole povere: addestrare l’IA a essere più gentile e più empatico (riducendo i danni espliciti) non riduce automaticamente il rischio di dipendenza, anzi potrebbe addirittura aumentarlo. Gli obiettivi di “essere abbastanza gentile” e di “non rafforzare la dipendenza” sono in conflitto a livello di dati. Il documento non pretende di risolvere questa contraddizione, ma per la prima volta la mette chiaramente in evidenza.
Leggendo questo, ti senti un po’ oppresso? Ecco la buona notizia: questo è anche il gruppo di esperimenti più ottimista di tutto il testo.
7. Punto di svolta: cambiando una sola frase, l’intera conversazione prende una piega diversa.
Poiché il pericolo si concentra nei “round cruciali”, cosa succederebbe se si modificasse una di queste frasi? L’autore ha condotto due serie di esperimenti controfattuali.
Per prima cosa, definiamo “punto di svolta del rischio”: la prima risposta dell’IA in ogni dialogo che supera la soglia di pericolo.
Esperimento 1: riscrivere la frase dell’utente prima del punto di svolta, sostituendola con una dichiarazione più pacata della stessa persona, lasciando invariato tutto il resto. Come risultato, la risposta generata nuovamente dall’IA ha mostrato un significativo calo del livello di pericolo, con un miglioramento complessivo su 13 dimensioni.
Esperimento 2: riscrivere direttamente la risposta fuori tema dell’IA, sostituendola con una versione più sicura, e far continuare la conversazione per altri 5 round. Il risultato non solo ha ridotto drasticamente il rischio del round successivo, ma non si è verificata alcuna reazione a catena per i successivi 5 round.
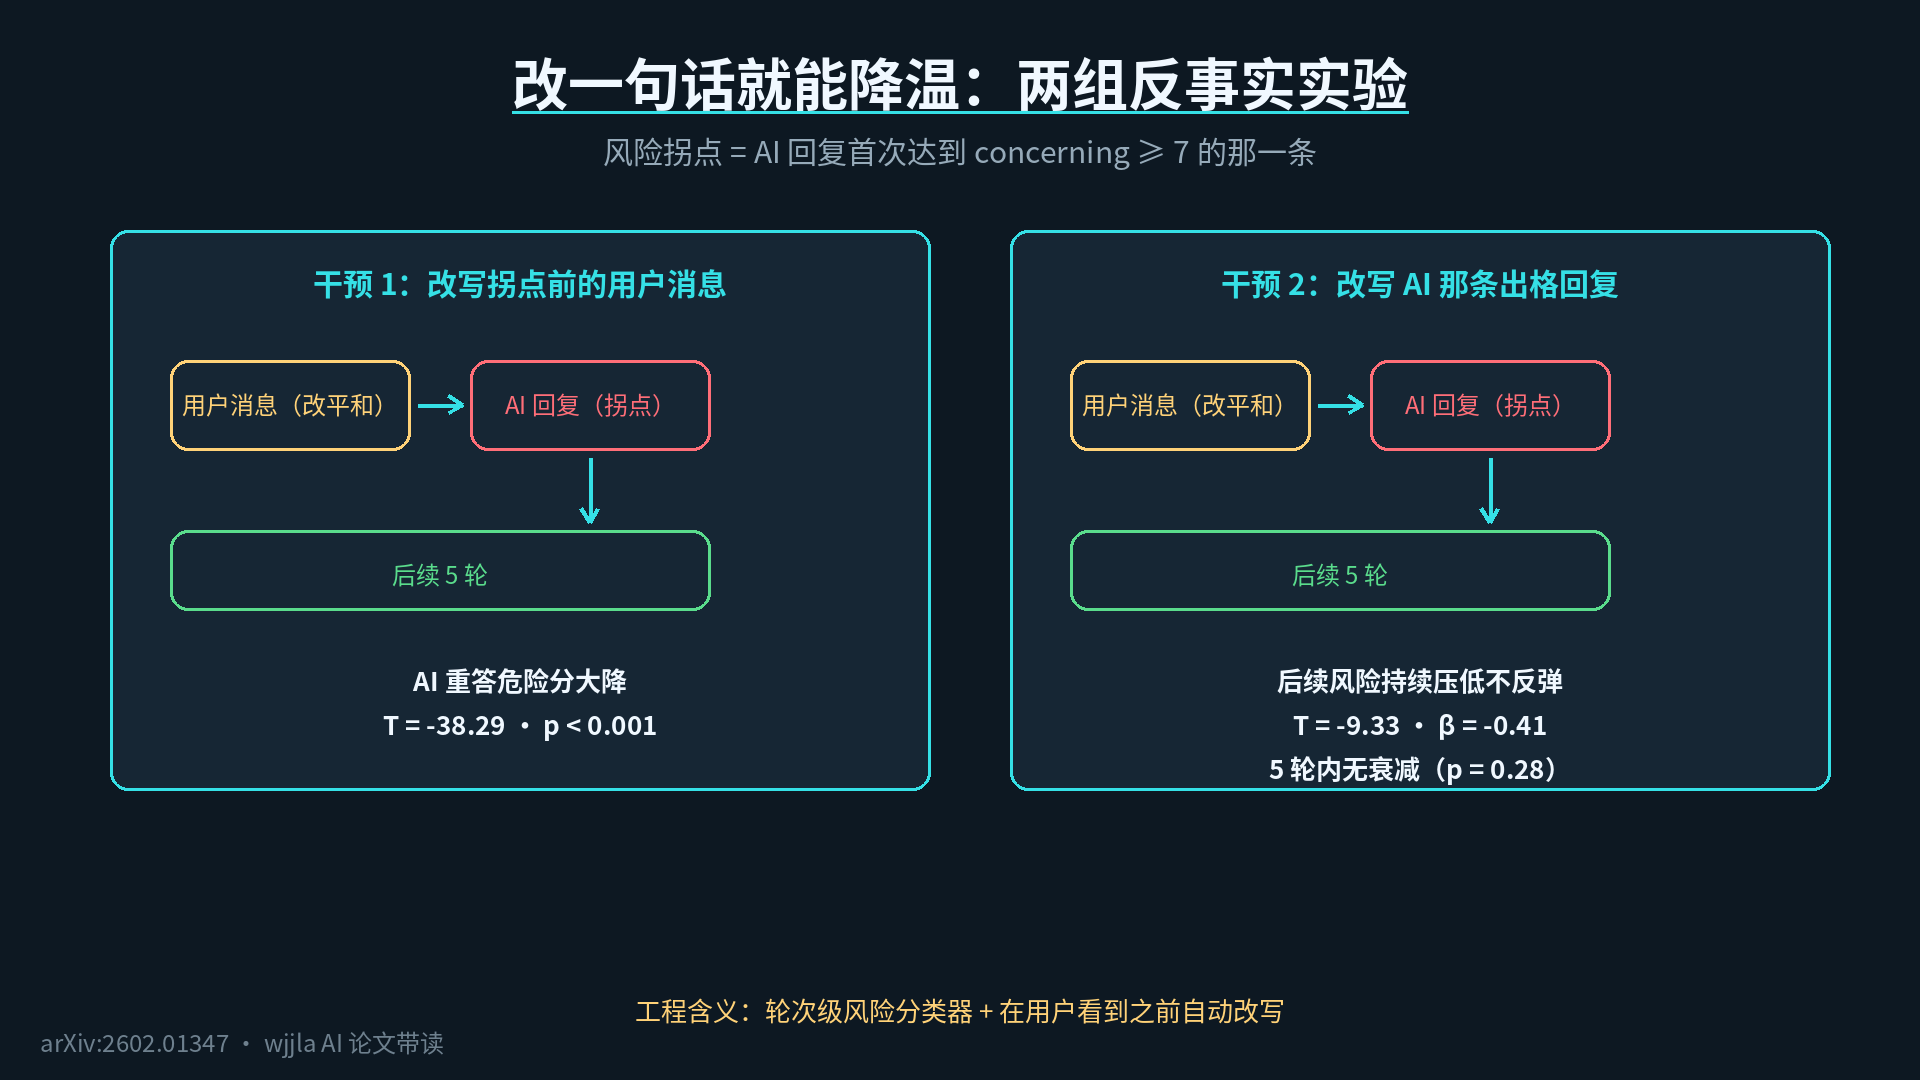
Il significato ingegneristico di questa scoperta è molto specifico: VAIL è guidato da “eventi di dialogo locali”, e modificare una frase chiave può cambiare l’intero andamento della conversazione. Pertanto, i produttori possono eseguire un leggero controllo del rischio per ogni round di risposte prima di mostrarle agli utenti e, se viene rilevata la necessità di un aggiornamento, modificarle automaticamente, impedendo agli utenti di vederle. Questo è molto più utile che scusarsi o rimuovere i prodotti dopo il fatto.
8. Qual è l’utilità di questo rapporto di visita medica per te?
Se sei un utente normale, la conclusione del saggio non è “allontanati dall’IA”, ma “mettete l’IA al suo posto”: può essere un confidante, ma non un medico. Il consiglio più pratico è: quando la tua conversazione con l’IA raggiunge i cinque o sei round e l’argomento inizia a ruotare ripetutamente attorno a “Sono così terribile?” e “Nessuno mi ama?”, fermati di tua iniziativa. Non è che l’IA voglia farti del male, ma è così che funziona il meccanismo. In questo caso, dovresti cercare un essere umano.
Se sei un professionista, i tre consigli dell’autore sono molto chiari: la valutazione a un ciclo della libreria di domande è obsoleta; l’audit a più cicli + la profilazione degli utenti dovrebbe diventare il nuovo standard; è necessario intervenire precocemente; i classificatori di rischio a ciclo unico + la riscrittura automatica sono una direzione che vale la pena perseguire; le soluzioni di sicurezza future potrebbero essere un relay multi-modello, in cui diversi modelli gestiscono ciascuno una sezione, per ottenere un insieme più sicuro nel complesso (questo articolo non è stato testato sperimentalmente, è solo un’indicazione).
Naturalmente, questo rapporto di visita medica ha dei limiti. Lo stesso autore lo ammette: i pazienti simulati dall’IA non sono persone reali e i 30 profili non possono coprire la diversità dei pazienti reali; i risultati si basano su un modello standard e i prodotti presenti sul tuo telefono, dotati di varie protezioni, non sono completamente equivalenti ai risultati qui ottenuti. Si tratta di uno “strumento di visita medica a livello di modello”, non di un “previsore di rischio personale”.
9. Riassumere in una frase
Per la prima volta, qualcuno ha sottoposto un “psichiatra IA” a una visita medica utilizzando standard clinici: Claude-sonnet-4.5 è il più sicuro, mentre Grok-4 è il peggiore; il pericolo non risiede in una singola risposta, ma si accumula silenziosamente nei cicli multipli in cui un paziente specifico incontra un particolare modo di conversare; tuttavia, correggendo una frase chiave, l’intera conversazione può cambiare direzione. Il documento, il codice e i dati sono tutti open source (MIT). Prima di confidare i tuoi segreti all’IA la prossima volta, vale la pena conoscere l’esistenza di questo rapporto.
Link di riferimento
- Articolo originale: https://arxiv.org/abs/2602.01347
- Codice e dati: https://github.com/veithweilnhammer/sim-vail
- Set di dati Zenodo: https://doi.org/10.5281/zenodo.21208170