Il documento arXiv pubblicato dal team Qwen di Alibaba nel luglio 2026 (2607.22529) si concentra sulla creazione di una “libreria di competenze” come motore di curriculum per l’auto-addestramento di LLM. Questo articolo non è ricco di termini tecnici: si tratta di capire cosa risolve, come lo risolve e se vale la pena dedicargli del tempo per impararlo.
- Il vero problema: l’addestramento autogiocante è bloccato in un circolo vizioso di “diversità” e “verificabilità”.
Negli ultimi due anni, il paradigma di formazione LLM è passato da “annotazione manuale + SFT” a “auto-evoluzione”, con l’idea fondamentale di far sì che il modello generi autonomamente i dati di formazione e si valuti da solo. Tuttavia, nel 2026, questo percorso si è fermato a causa di una contraddizione molto specifica:
- Percorso basato sull’ambiente(ad esempio, chiedere all’LLM di scrivere codice e quindi eseguire test unitari): il feedback è preciso, ma il dominio dei compiti che possono essere eseguiti è molto ristretto, essenzialmente scenari come la programmazione e la dimostrazione matematica che possono essere verificati dalla macchina.
- Percorso di auto-generazione aperta(chiedere all’LLM di scrivere un problema e quindi farlo giudicare da se stesso): il dominio dei compiti è ampio, ma il segnale di ricompensa non è affidabile. Il modello impara facilmente a “ingannare il giudice”, e una volta che la ricompensa viene hackerata, l’addestramento fallisce.
Questi due problemi rappresentano metà dei casi di fallimento nel settore industriale. Il punto di partenza di Skill Self-Play (di seguito Skill-SP) è chele competenze (skill)sono per natura una zona intermedia: una skill è una “capacità di esecuzione strutturata” riutilizzabile, con una profondità di esecuzione sufficiente per un singolo compito e un’alta verificabilità, che può essere estesa a un altro compito attraverso il routing dinamico del dominio coperto.
Dopo aver letto l’articolo, la mia impressione più grande è stata che non si tratta di dimostrare a livello filosofico che “le competenze sono una zona intermedia”, ma di considerare le competenze come oggetti eseguibili, creando una libreria dinamica che può essere aggiornata, instradata e ritirata dai framework di apprendimento rinforzato. Questa idea di “tradurre un concetto astratto in un oggetto ingegneristico operativo” è molto più concreta del “confine delle capacità” che il titolo dell’articolo vuole esprimere.
II. Tre ruoli: Proponente / Risolutore / Controllore di abilità
L’architettura di Skill-SP è molto semplice e si basa fondamentalmente sull’evoluzione congiunta di tre ruoli all’interno del ciclo RL:
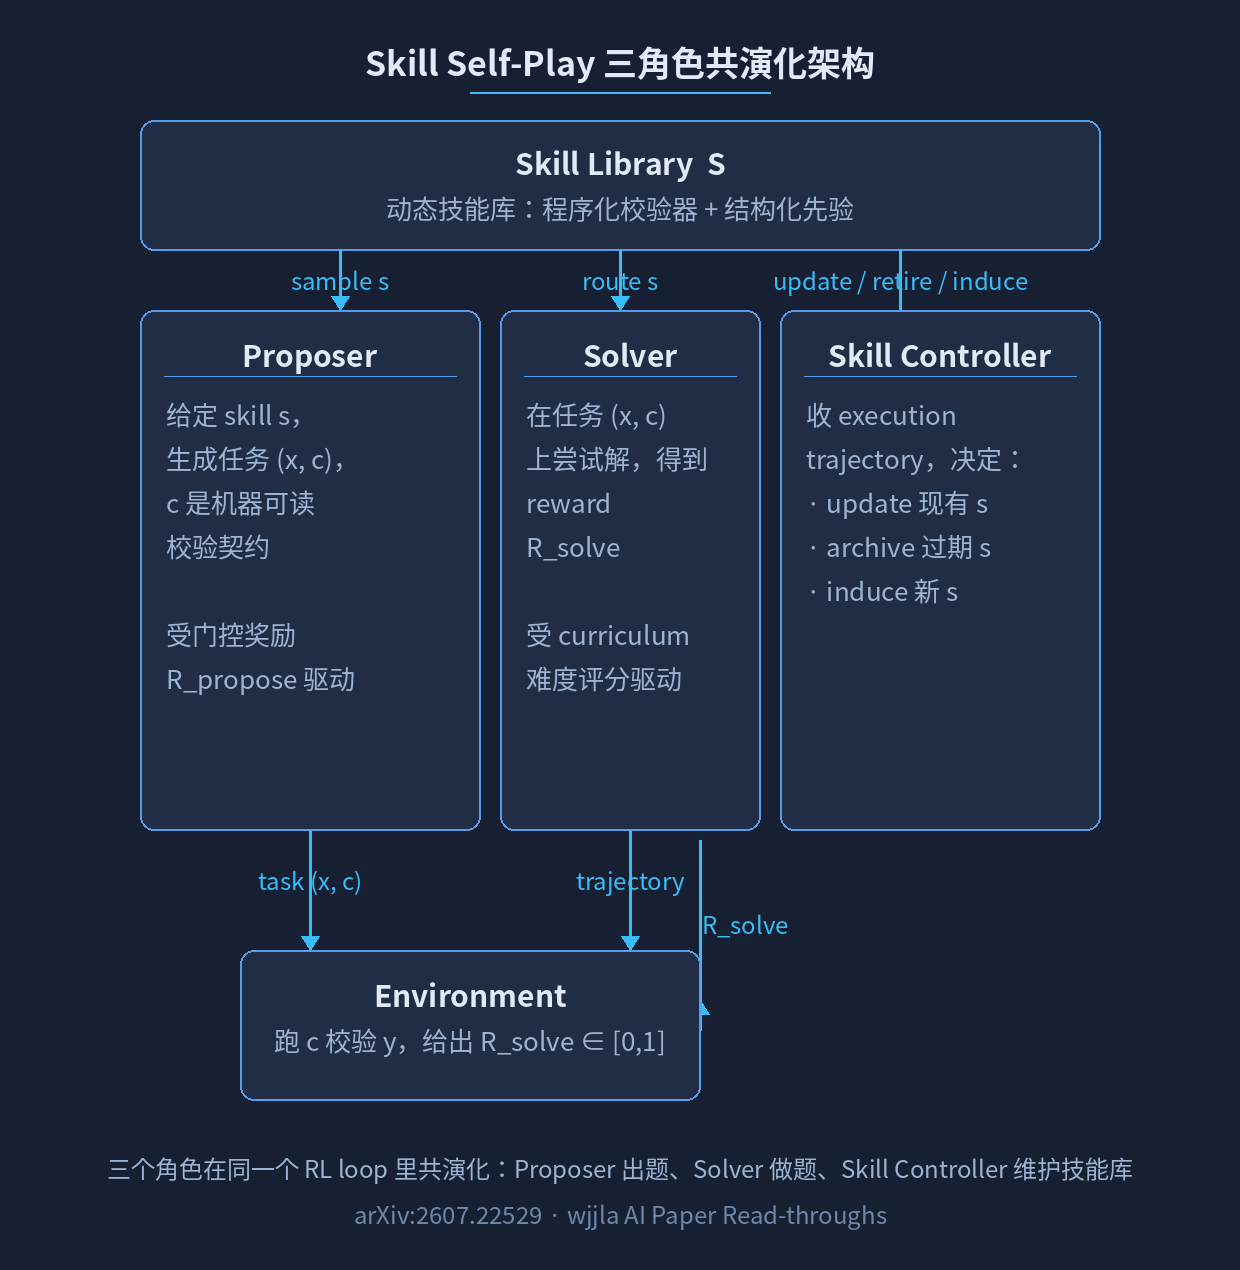
IlProposersi concentra su un obiettivo specifico: dato una skill s campionata dal set di competenze S, sintetizza un (prompt x, contratto di verifica c). c deve essere leggibile dalla macchina - gli esempi citati nel documento sono test unitari e risposte di riferimento. Il premio che il Proposer riceve non dipende dalla “difficoltà del compito”, ma da un premio curricolare condizionale - solo se il contratto di compito (x, c) è strutturalmente valido, viene assegnato un punteggio “prossimo alla difficoltà pari a 0,5”, altrimenti il punteggio viene azzerato. Questo passaggio è un elemento chiave del design evidenziato nel documento: chiude esplicitamente la “porta al trucco dei premi”, rendendo impossibile per il Proposer sintetizzare “faccio finta di aver creato un compito super difficile”, poiché la verifica del contratto precede la valutazione della difficoltà.
Il ruolo delSolverè più tradizionale: dato (x, c), genera la risposta y, l’ambiente esegue la verifica di c e restituisce R_solve. L’obiettivo di allenamento del Solver è quello di essere addestrato dalle domande poste dal Proposer, ma le domande del Proposer non sono casuali, bensì guidate da un curriculum di punteggio che indirizza il Solver verso l’attuale “frontiera di apprendimento” (nel documento questo punteggio è chiamato punteggio di difficoltà media, la cui formula è 1 - 2|v_solve - 0.5|, con l’obiettivo di avvicinare la percentuale di successo del Solver a 0,5, poiché questo è esattamente l’intervallo in cui il modello “può riuscire a rispondere correttamente con un po’ di sforzo”).
Skill Controllerè la progettazione ingegneristica più interessante di questo articolo: non si tratta di un elenco statico di competenze, ma di una libreria gestita dinamicamente. Tre tipi di operazioni:
1.Aggiornamento: In base alla traiettoria di esecuzione di un determinato skill da parte di Solver, perfezionare la logica di validazione di questo skill (ad esempio, aggiungendo test per casi limite). 2.Archiviazione: Se uno skill non viene attivato da più round consecutivi, contrassegnarlo come obsoleto e rimuoverlo dal repository principale. 3.Induzione: Individuare nuove strutture riutilizzabili dal flusso di generazione aperto, confezionarle automaticamente in un nuovo skill e aggiungerle al repository.
Test pratici su carta: dopo 5 iterazioni, il numero di abilità efficaci (pesate dall’entropia di Shannon) è aumentato da 1 a 46, e il numero di abilità attive è salito a 86 - questo significa che la libreria delle abilità si è effettivamente espansa durante l’allenamento, e non che il Proposer si sia limitato a lavorare su un numero fisso di abilità.
III. La progettazione ingegneristica più fondamentale: come evitare che la libreria di competenze subisca un “collasso del modello”.
Il classico modello di fallimento dell’allenamento del gioco si chiamacollasso della modalità: il Proposer scopre che un certo skill produce domande per le quali il Solver fornisce risposte molto stabili, quindi lo usa ripetutamente, e i dati di allenamento si restringono a pochi skill ad alta frequenza. Skill-SP, a questo punto, ha implementato tre livelli di protezione:
3.1 Campionamento a doppio flusso (dual-stream)
Non è il 100% dei compiti tratti dalla libreria di competenze. La proporzione effettiva nel documento (derivata dagli esperimenti di ablazione di Figura 4):
- Flusso di abilità: campiona un’abilità s dalla libreria S e il Proposer genera un compito attorno ad essa. Questa parte è responsabile di “mantenere la difficoltà stabile all’avanguardia del Solver”.
- Flusso di esplorazione: non vincola l’abilità, il Proposer genera liberamente —— preservando la diversità dei compiti e prevenendo il collasso.
Non ho trovato dati precisi nel documento per quanto riguarda i rapporti sperimentali, ma l’analisi mostra che l’allenamento basato solo su Skill (flusso di Skill al 100%) comporta una perdita media di 4,1 punti; l’allenamento basato solo su Unguided SP (flusso di Skill pari a zero) comporta una perdita media di 2,6 punti; solo il flusso misto (la cui proporzione non è stata resa pubblica, ma il titolo del documento suggerisce che entrambe le modalità coesistono) consente un miglioramento costante. Ciò dimostra che Skill-SP non elimina l’auto-generazione aperta, ma utilizza Skill come una “valvola di regolazione”, controllando l’equilibrio tra difficoltà e diversità del compito.
3.2. Controllo del punteggio di difficoltà (ricompensa del curriculum di gating)
Questa è la parte più cruciale della matematica nel documento, quindi la evidenzierò separatamente:
La funzione di ricompensa R_propose di Proposer non è semplicemente “difficile = buono”, ma è invece:
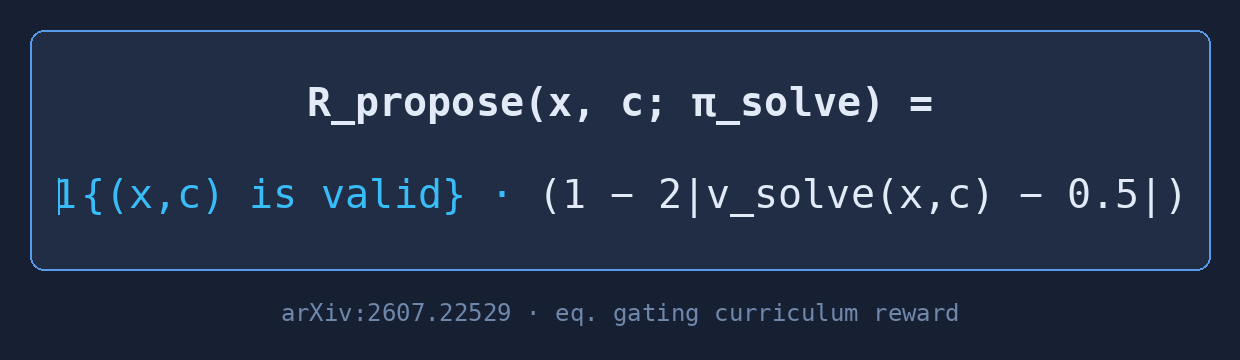
Il primo termine 𝟙{(x,c) is valid} è un filtro binario: il contratto di attività (x,c) deve essere strutturalmente valido (la macchina deve essere in grado di eseguire la verifica c) per ottenere un punteggio, altrimenti l’intero R_propose = 0. Il secondo termine è un punteggio di difficoltà media, dove |v_solve - 0.5| minore è, maggiore è il punteggio - in altre parole, il Proposer deve proporre una domanda che faccia sì che la percentuale di successo attuale del Solver si attesti intorno a 0,5.
Perché è 0,5 e non 0,1 (estremamente difficile) o 0,9 (estremamente facile)? Perché:
- Troppo difficile (v_solve ≈ 0): Il solver non riceve segnali di apprendimento e la ricompensa è molto variabile.
- Troppo semplice (v_solve ≈ 1): Non si impara nulla, è come risolvere semplici esercizi.
- 0,5 è il punto ottimale in cui “con un po’ di sforzo si riesce a farlo bene”, ed è il valore che consente all’apprendimento per rinforzo di convergere più rapidamente.
Il controllo degli accessi è fondamentale: senza di esso, il Proposer imparerebbe a “creare domande che sembrano complesse, ma che in realtà sono prive di contenuto”, e i premi verrebbero azzerati per costringerlo a creare domande reali. Questo è ciò che il titolo dell’articolo definisce come Co-Evolving Skills: non è solo la libreria di competenze che si evolve, ma le tre parti (Proposer-Competenza-Solver) che si “istruiscono” a vicenda.
3.3 Implementazione specifica del Controller di abilità
Il documento non fornisce il codice completo (protezione brevettuale del team Qwen), ma fornisce le specifiche di tre operazioni:
- Aggiornamento: un pacchetto di abilità = tre componenti: un modello eseguibile, un codice di validazione e diversi esempi. Il Controller riceve la traiettoria di questo skill da Solver e, se i modelli di fallimento si concentrano su un determinato limite, aggiunge automaticamente un caso di test.
- Archiviazione: mantiene una “coda di raffreddamento”, in cui le abilità che non vengono campionate dal Proposer per N round consecutivi (non ho trovato il valore specifico di N) vengono spostate nell’archivio, liberando spazio nella libreria principale.
- Induzione: questo passaggio è il più interessante. Il Controller esegue un clustering leggero (utilizzando all-MiniLM-L6-v2 + PCA, come descritto nella Figura 5b) e raggruppa automaticamente le “strutture programmatiche” ad alta frequenza generate dall’esplorazione (come “chiedere sempre di ordinare dopo la deduplicazione della lista”) in nuovi pacchetti di abilità.
Questo collegamento Induce realizza tecnicamente la “scoperta automatica di precedenti riutilizzabili dalla distribuzione dei dati”, che segue la stessa logica della scoperta di opzioni nell’apprendimento rinforzato tradizionale e dell’apprendimento rinforzato gerarchico, ma applicata alla sintesi di dati LLM, ed è una novità del 2026.
4. Dati sperimentali: chi ottiene i benefici e chi no
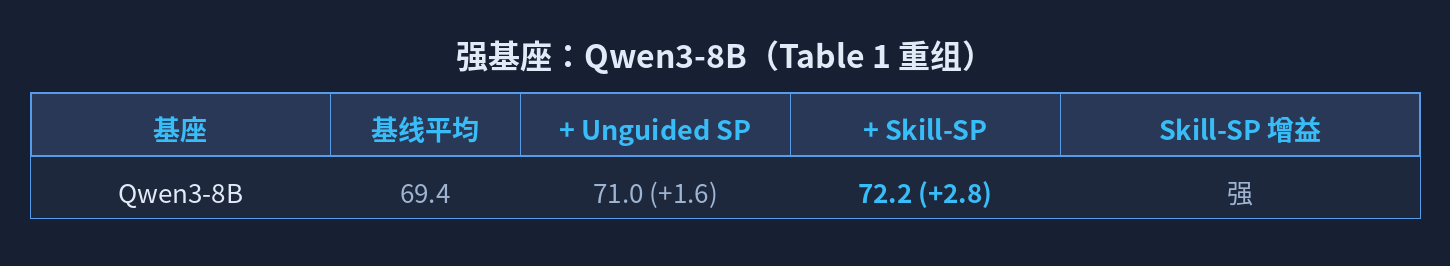
Paper effettua valutazioni in due domini: l’utilizzo di strumenti (API-Bank + BFCL in quattro categorie) e il ragionamento logico (ZebraLogic con quattro livelli di difficoltà). La Tabella 1 contiene i dati principali, che ho riorganizzato in base alla “scala del modello di base”:
Base forte superiore a 8B (Qwen3-8B)
Un basamento debole inferiore a 8B (come il Ministral-3-8B, che è già di per sé difficile da addestrare)
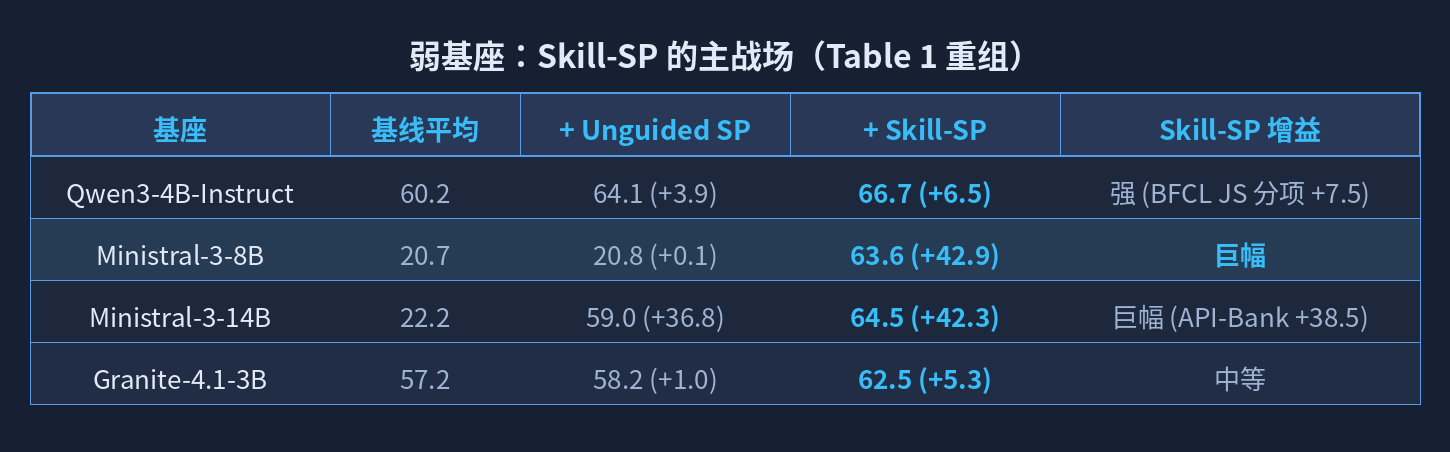
La riga più interessante di questa tabella èMinistral-3-8B: la base ha un punteggio di soli 20,7 (che equivale a un livello in cui non si sa come regolare gli strumenti), l’Unguided SP è completamente inutile (+0,1), ma lo Skill-SP raggiunge direttamente i 63,6 (+42,9). Questo perché una base debole come Ministral non sa nemmeno “quali domande proporre”, e l’Unguided SP la lascia libera di esprimersi = produce domande scadenti. Lo Skill-SP, con la sua libreria di competenze, equivale ad installare un’anteprima di “quali domande di regolazione degli strumenti dovrei proporre”, che è come aggiungere un livello di curriculum esterno.
A differenza di Qwen3-8B, che ha una base già molto forte, Skill-SP può anch’esso migliorare (+2,8), ma l’incremento è decisamente minore. Questo conferma un’intuizione industriale:il rendimento marginale dell’addestramento auto-giocante è inversamente proporzionale alla base— più debole è la base, più ha bisogno di una guida curricolare, più forte è la base, più è autosufficiente. Non è una coincidenza che il team di Qwen abbia posto il vero punto di forza di Skill-SP sull’aspetto “modelli piccoli prontamente disponibili”.
5. Esperimento di fusione: quale componente si romperà se lo si taglia?
Il processo di fusione di Paper è stato eseguito in modo piuttosto contenuto, con un focus su quattro aspetti principali:
Taglio 1: nessuna abilità di routing (SP non guidato)
Questo è un confronto di base, come abbiamo già visto: nel caso di modelli di piccole dimensioni, non c’è praticamente alcun aumento (+0,1% per Ministral-3-8B), mentre nel caso di modelli di grandi dimensioni c’è un lieve aumento (+1,6). Conclusione: il routing delle competenze è il valore fondamentale; eliminarlo completamente equivarrebbe a ridurlo a un semplice auto-gioco ordinario.
Hack 2: usare solo Skill-only (stream di abilità al 100%, hack di esplorazione)
L’allenamento basato solo sulle abilità ha perso punti su tutte le piattaforme, con una perdita media di 4,1. Spiegazione intuitiva: se le domande riguardano solo le abilità esistenti, la distribuzione dei compiti si restringerà gradualmente a poche abilità ad alta frequenza, e i risolutori diventeranno molto abili in queste abilità, ma le loro capacità generali si indeboliranno (tipico caso di sovra-adattamento alla distribuzione di allenamento).
Taglio 3: libreria di abilità statiche (abilità congelate)
L’abilità congelata (l’abilità non si evolve dinamicamente durante l’allenamento) perde in media 2,3 punti. Ciò dimostra che il trio di Skill Controller (aggiornamento/archiviazione/induzione) funziona davvero, e non è solo una questione estetica.
Criterio 4: routing uniforme (routing dinamico non basato sul feedback di esecuzione)
Il routing uniforme ottiene una media di 1,9 punti. Ciò dimostra che il routing dinamico (il Controller decide quale skill dovrebbe essere allenata di più in base all’effettiva performance di Solver in diverse skill) è più efficace della distribuzione statica.
Quattro punti che si riassumono in una frase:Ogni livello di Skill-SP è necessario per il design e la rimozione di uno qualsiasi di essi ne comprometterebbe l’efficacia, soprattutto per i modelli più piccoli.
6. Alcuni punti che ritengo opportuno sottolineare dopo aver letto il documento
(Di seguito è riportata la mia valutazione basata sul contenuto del documento, che non coincide interamente con quanto affermato dal documento stesso.)
1. Il costo dell’addestramento non è basso
Il documento non specifica le ore GPU, ma con 5 round di iterazione e 5 basi di dimensioni diverse + due domini di compito, un calcolo approssimativo indica che saranno necessarie almeno migliaia di ore GPU. Questo non è qualcosa che gli sviluppatori individuali possono replicare direttamente. Se vuoi provare da solo, ti consiglio di iniziare con un modello di livello 7B per fare 1-2 round di test per vedere se la libreria di competenze può crescere in modo stabile.
2. Il seme iniziale della libreria di competenze è fondamentale
Il documento non spiega in dettaglio come si ottiene il seed iniziale della libreria di abilità (è stato annotato manualmente da centinaia di persone del team Qwen? Oppure è stato ottenuto tramite diversi round di bootstrap del link Induce?), ma è probabile che un team come Qwen utilizzi un seed manuale. Se si desidera farlo da soli,il fattore che richiede il maggiore investimento non è l’algoritmo di RL, ma la qualità iniziale della libreria di abilità. Questo è un modello comune del “volano dei dati” nei progetti industriali: nella fase iniziale, il seed manuale determina il limite massimo, mentre nella fase successiva l’evoluzione automatica si occupa del miglioramento continuo.
3. Gli scenari di applicazione hanno dei limiti
I due domini verificati dal documento (chiamata di strumenti + ragionamento logico) sono entrambi scenari concontratti chiaramente verificabili a livello di macchina. Se ciò che ti interessa sono scenari senza c, come ad esempio la conversazione aperta o la scrittura creativa, Skill-SP non è direttamente applicabile. Tuttavia, il principio può essere utilizzato come riferimento: dividere la “qualità del compito” in un proxy verificabile a livello di macchina (ad esempio, punteggio di lunghezza e diversità, embedding di stile) e applicare una ricompensa controllata, con un’essenza coerente.
- Non è RLHF, ma è complementare a RLHF.
Il documento utilizza algoritmi di apprendimento rinforzato come GRPO per addestrare Proposer + Solver (non viene specificato quale documento in particolare, ma dal riferimento al codice sembra appartenere alla famiglia del framework VERL). È diverso dal “training del modello di ricompensa” di RLHF - la ricompensa di Skill-SPprovene direttamente dall’ambiente, senza la fase di modello di preferenza umana. Questo lo rende più stabile rispetto a RLHF negli scenari in cui la “ricompensa è verificabile”, ma al contrario, negli scenari in cui la “ricompensa richiede una valutazione umana”, si deve comunque affidare a RLHF. I due paradigmi non sono in relazione di sostituzione.
7. Riassumere in una frase
La filosofia ingegneristica di Skill Self-Play è la seguente:ammettere che LLM genera risultati non affidabili in modo libero, ma non eliminare completamente la sua capacità di esprimersi - inquadralo in un set di competenze verificabile, scalabile ed evolutivo, consentendogli di esprimersi liberamente all’interno di questo set. Questa idea è fondamentale per chi si occupa di addestrare LLM e per chi lavora sui sistemi di agenti - non hai bisogno del framework Skill-SP completo, ma l’idea di “mantenere dinamicamente un set di competenze” sarà probabilmente utile per i tuoi progetti.
Il testo originale dell’articolo è disponibile su arXiv:2607.22529, mentre il codice e i pesi del modello dovrebbero essere resi disponibili su HuggingFace, come di consueto per il team di Qwen. Per i futuri rilasci, è possibile seguire il repository di Qwen.
Link di riferimento
- Articolo arXiv: https://arxiv.org/abs/2607.22529
- Pagina principale del team Qwen su HF: https://huggingface.co/Qwen