まず、3つの本当に失敗した例を見てみましょう。
モデルに中国の伝統音楽のパフォーマンスを撮ってもらったところ、楽器や画面に表示される字が本物の中国の伝統とは合っていませんでした。ナイジェリアの結婚式を撮ってもらったところ、来賓の衣装や式のアイテムはすべて「標準的なもの」で、ナイジェリアの要素は見えませんでした。日本の将棋の対局を撮ってもらったところ、将棋盤や駒がすべて欧風のチェスに変わっていました。.
映像自体は問題ない。光と影、動き、解像度など、すべてが完璧だ。しかし、それがまさに問題なのです。ウェンシェンの動画は非常に現実的で、映像が現実的であるほど、文化的なミスが見えにくく、目立つようになる。海外市場向けの動画では、衣装や儀式が間違っていれば、現地の人はすぐにそれがわかり、最悪の場合、冒涜と見なされる可能性がある。
この論文「CultureVidBench: Benchmarking Cultural Understanding in Text-to-Video Generation」は、この問題に関する完全なテストを作成したものです。12カ国、1,000問、7つのモデルが文生動画の文化理解を競い合うものです。第一著者のXianjing Hanは南洋理工大学出身、共著者のBin Zhuはシンガポール経営大学出身で、協力者にはセントラル・スーペレックとケンブリッジ大学も含まれています。私はこの論文を完全に読みましたが、その価値は特定のスコアではなく、「AIは文化を理解しているか?」という疑問を初めて定量化可能なエンジニアリング問題として提示したことにあります。
以前の評価ではなぜ文化が検出されなかったのか
ウェンセンの動画の評価は数多くあります。VBenchやEvalCrafterなどの主流のベンチマーが常に使用されていますが、これらは画質、動きの流暢性、物理学の合理性、関連性に焦点を当てています。また、物理学の常識やロボットの信頼性をテストするものもあり、それぞれの分野に特化しています。
文化という次元では、動画側でシステム的なテストを実施している企業はほとんどありません。しかし、静止画の側では、ViSAGeやCUBE-1Kが文化のコンセプトをテストしています。ただし、静止画では動きが見えず、音声も聞こえません。動画に映る文化は生きているものです。儀式には流れがあり、シーンには音楽があり、看板には文字があります。このギャップを埋めるのがCultureVidBenchの役目なのです。
ギャップを埋める最初のステップは試験用紙の作成であり、試験用紙の質が後のすべての結論の信憑性を直接決定します。この論文では、試験用紙の作成に力を入れており、それだけで別途説明する価値があります。
12カ国を対象とした試験問題はどのように作成されたのか
まず国を選んでください。著者は世界価値観調査(World Values Survey)の文化地図を借用しています。これは学術界でよく使われている文化区分ツールで、世界を8つの文化圏に分けています。例えば、儒教圏、英語圏、アフリカのイスラム圏などです。各文化圏から代表的な国を選び、12カ国を集めて6大陸にまたがっています。このリストの意図的な組み合わせに注意してください。アメリカ、中国、インドなど、オンラインで多くの資料が見られる注目を集める国々もあれば、エチオピア、ナイジェリア、マレーシアなど、リソースが少ない国々も含まれています。後ほどわかるように、この組み合わせは本文の最も重要な結論の1つを直接検証するものです。
再構成の問題。著者は文化を3つのカテゴリに分類しています。物質文化(食べ物、衣服、建築、装飾など、目に見えるものでも触れることのできるも)、社会的実践とパフォーマンス(挨拶、食事、ダンス、スポーツ、宗教活動など、人々が行っていること)、儀式(結婚式、葬儀などの一連の流れ)。この3つのカテゴリをさらに14の側面に分け、世界各国の文化資料から828の文化要素を収集し、最終的に1000のキーワードにまで絞り込みました。物質文化は270、実践は386、儀式は344で、平均で12.8の英語単語が使用されています。
出題の質は人手で確保されています。各ヒントワードはテンプレートに合わせて生成されます。物質文化は「誰 + 何をする + どのような文化的要素を持つ + どの国」という形式で、例えば「女性がブラジルのレストランでフェイジョアダを皿に盛っている」などです。儀式に関しては、一連の流れとして分類され、サブアクティビティに分解されます。例えば、中国の茶の結婚式の習慣は、両親に跪いて茶を奉じ、赤い封筒を受け取るという3つのステップに分けられます。候補の出題は2人のヒトアノーターによって確認され、表現が自然かどうか、文化的な正確性かどうか、そして写真が撮れるかどうかが確認されます。
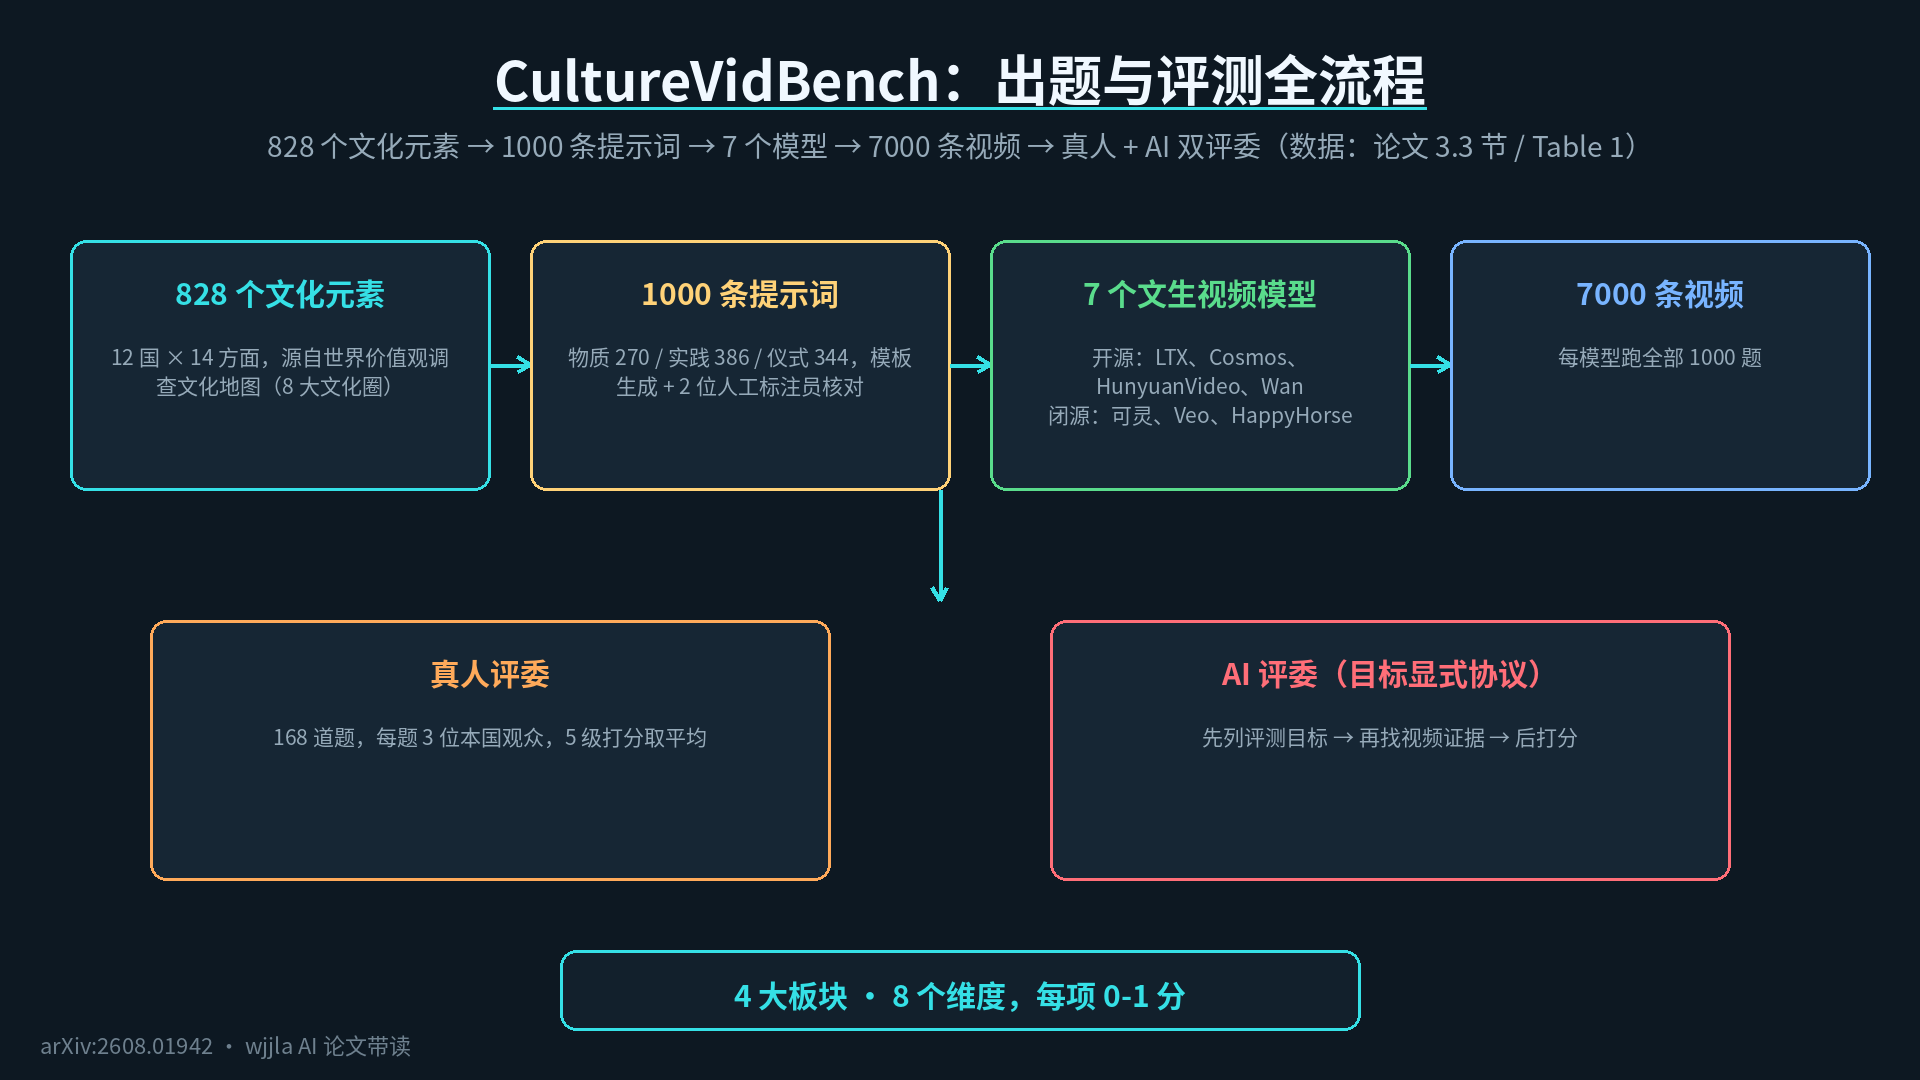
全体のフローは次のとおりです。828のカルチャー要素→1000のキーワード→7つのモデルをそれぞれ実行して7000件の動画を生成→実人とAIの2つの審査員による評価。参加者は、4つのオープンソースモデル(LTX-2.3-22B、Cosmos-Predict-2.5-14B、HunyuanVideo-1.5、Wan-2.2-14B)と3つのクローズドソースモデル(Kling-3.0、Veo-3.1-Fast、アリのHappyHorse-1.0)でした。
どのように評価するか:2つの大きな問題を8つの小さな項目に分割する
採点システムは非常に明確に設計されており、各動画は2つの大きな質問に答えています。
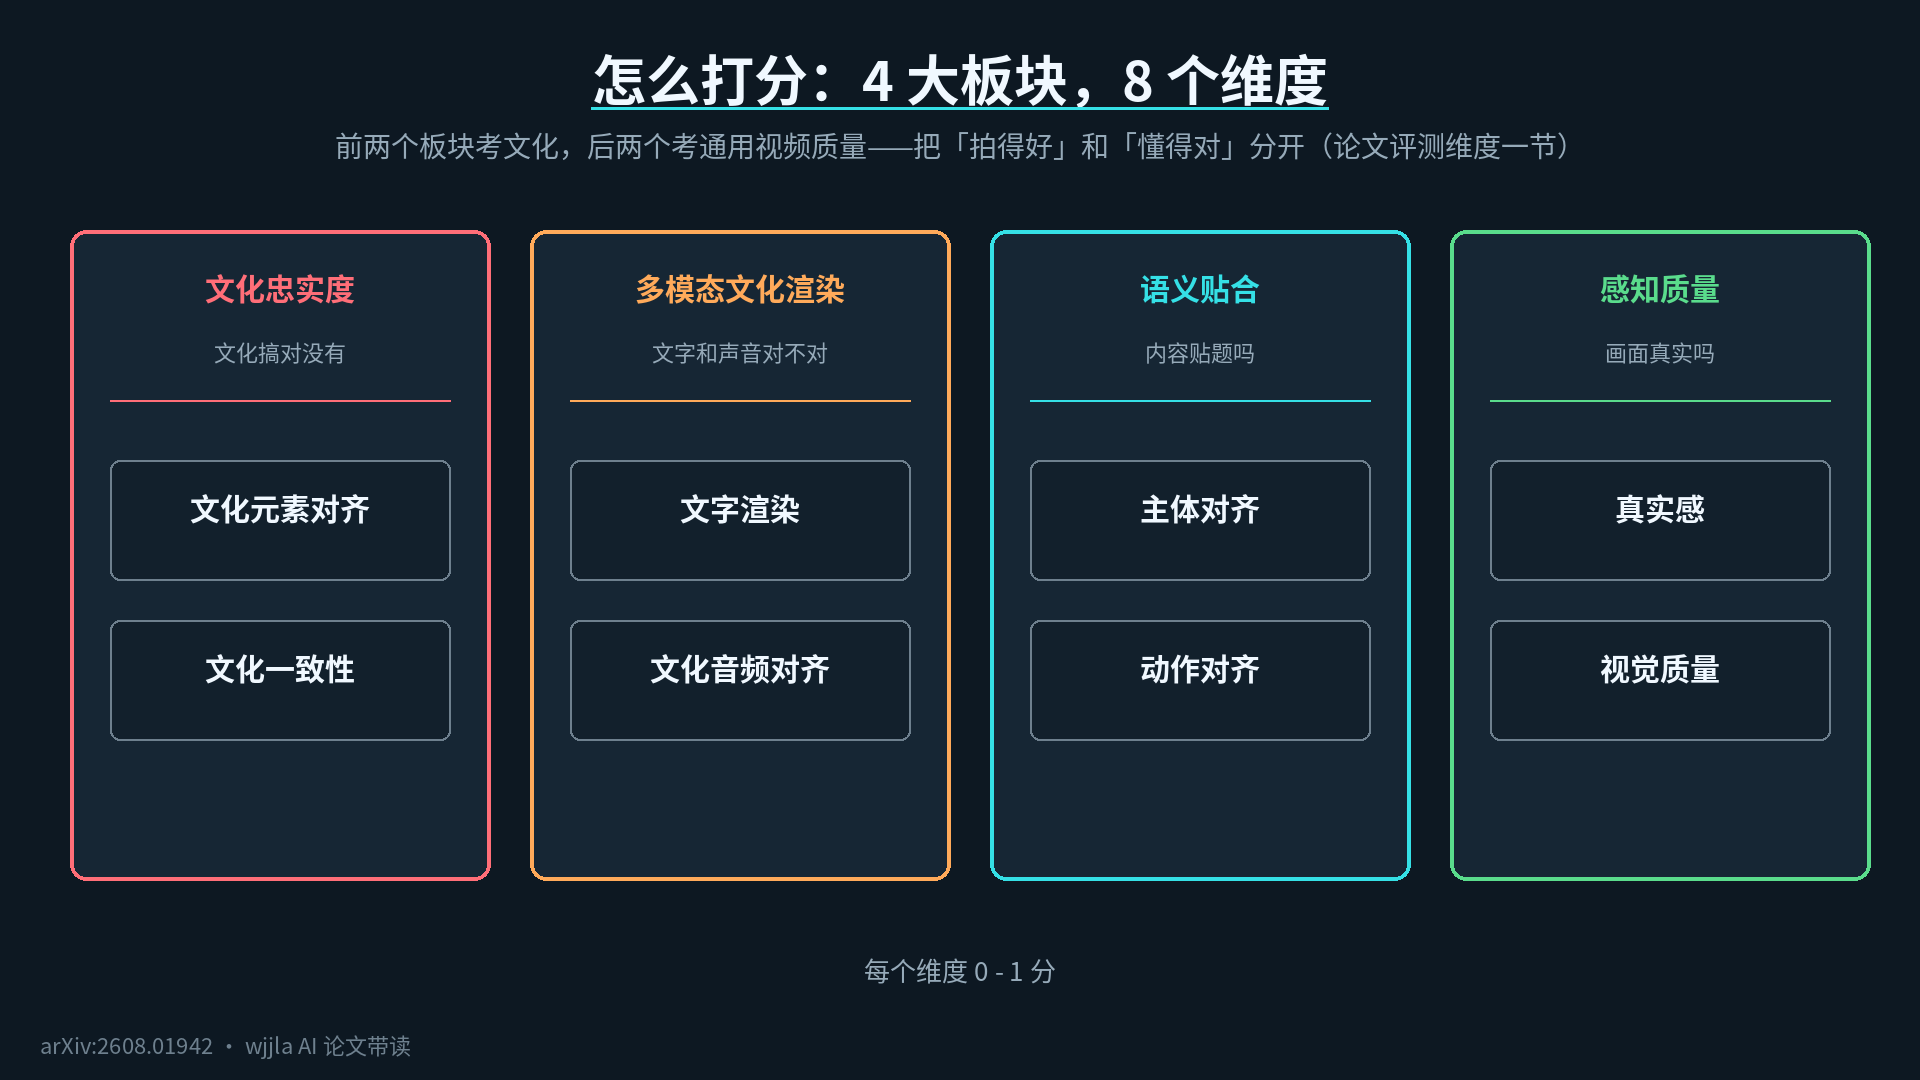
- 文化が正確かどうか(文化の忠実度):必要な文化的要素は現れていますか(文化要素の整合性)?他国の要素が混じっていないか(文化の一貫性)?
- 動画自体が良質かどうか(意味の適合性と感知的品質):主題やアクションは適切ですか?映像は現実的ですか?
0~1点が与えられます。さらに、別途セクションがあり、多様なモダリティの文化表現が求められます。画面に表示されるテキスト、背景に流れる音声、日本のシーンで見られる漢字の看板、結婚式で演奏される伝統的な楽曲などがこのセクションで評価されます。テキストと音声を別に評価するのは、この試験の独自の特徴であり、後ほど大きな問題となる可能性があります。
審査員は2つのグループに分かれています。実人審査員は168の問題(14の分野×12の国)を選び、各問題について3人の現地視聴者が5段階の評価を行い、平均をとります。これはコストがかかりますが、金字塔の基準です。AI審査員は、作者が設計した「ターゲット・エクスプレッシブ」プロトコルを使用しています。これは、AIに主観的な評価をさせないように設計されています。まず、問題の内容を教え、次にビデオから関連する証拠を探し、最後に証拠に基づいて評価を行います。このプロトコルが有効かどうかを確認するための専用テーブルがあります。
成績表:オープンソースとクローズドソースの間にあるギャップ
ページ6の表1はこのセッションで最も重要な表です。まず、文化要素に合わせた列の実人評価を見てみましょう。
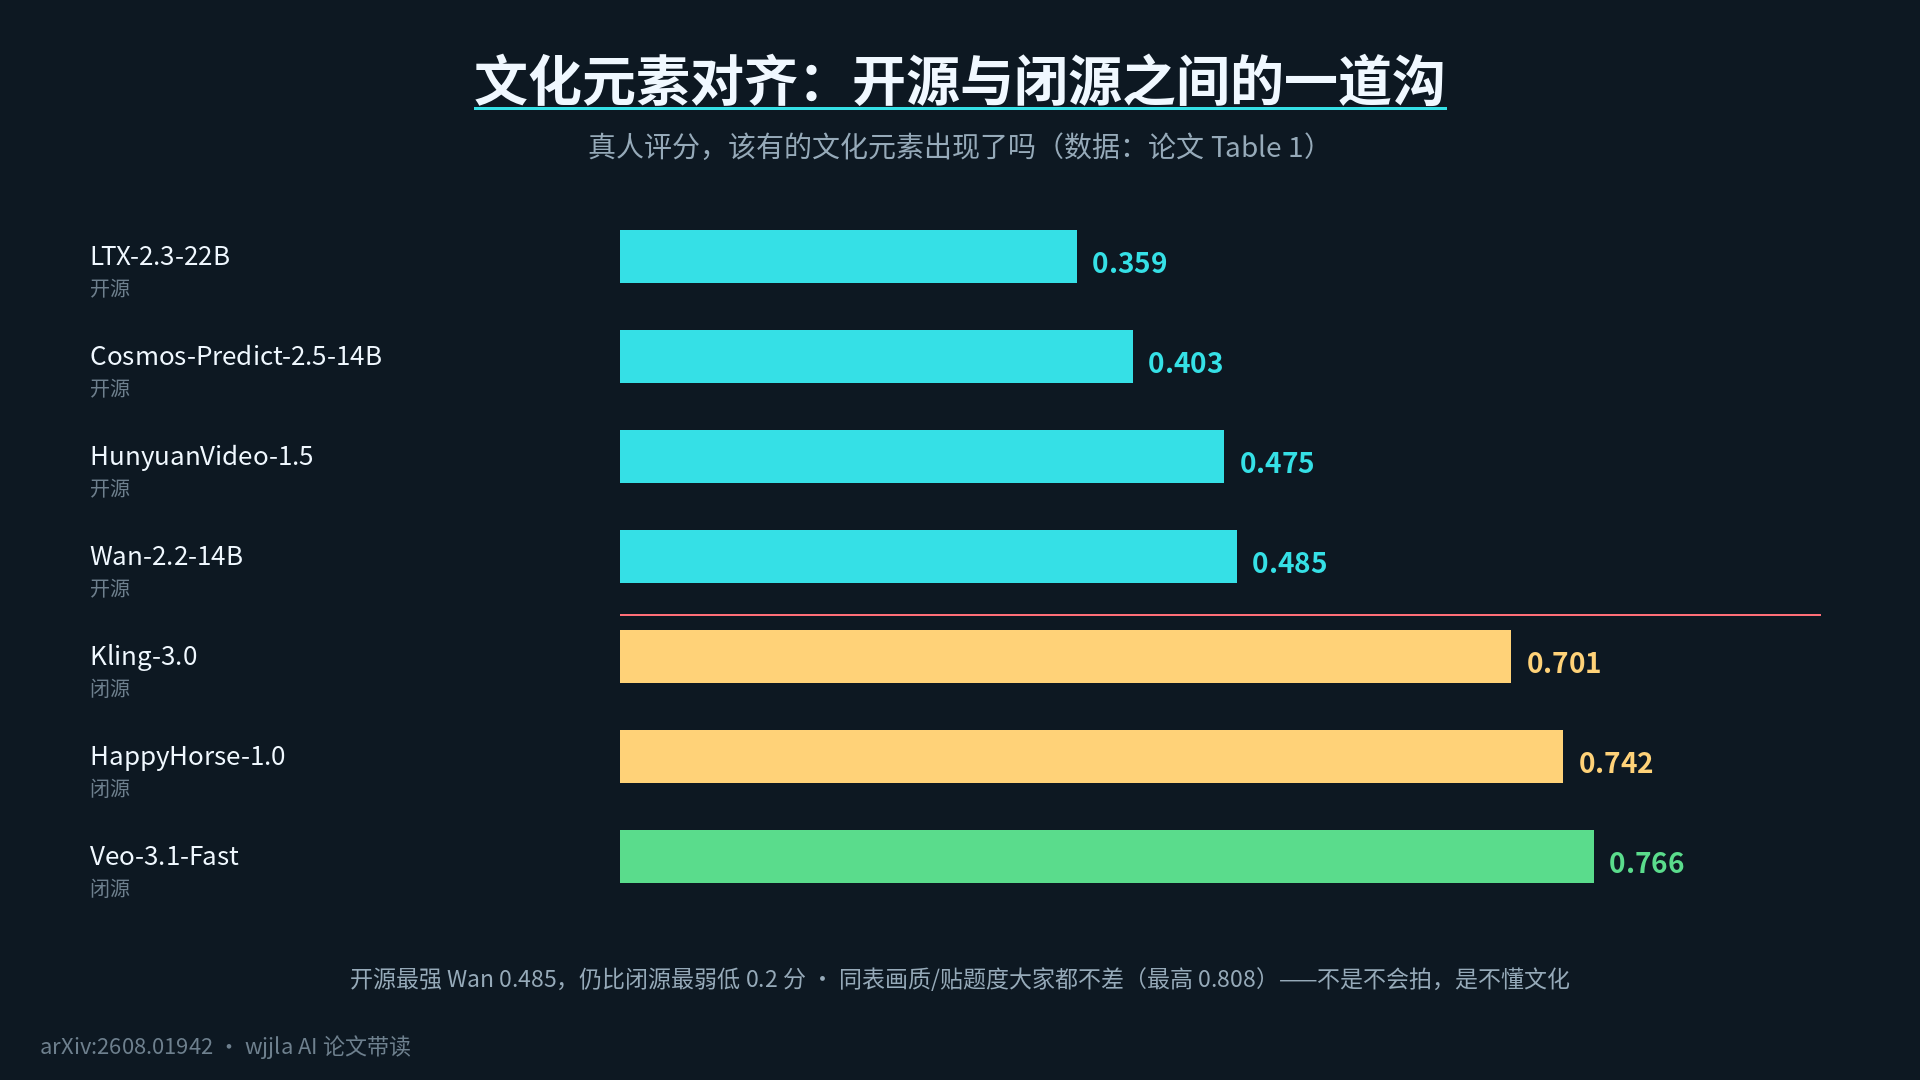
4つのオープンソースモデルはいずれも0.359から0.485の間に位置し、3つのクローズドソースモデルは0.701から0.766に直接ジャンプしています。最高得点はVeo-3.1-Fastの0.766で、HappyHorse-1.0は0.742、Kling-3.0は0.701です。オープンソースで最も強いWan-2.2-14Bでも0.485にすぎず、クローズドソースで最も弱いモデルよりも0.2ポイント低い結果となっています。これは明らかに大きな差がありますね。
しかし、同じ表にはもう1つの重要な情報が隠されています。つまり、画質や関連性といった一般的な能力に関しては、誰もが同程度に優れており、基本的に0.49以上で、最高で0.808に達しています。この2つの要素を組み合わせて考えると、結論は明白です。モデルは動画の撮影が苦手ではなく、文化に関する知識が不足しているのです。文化の違いと生成能力の違いは別物であり、このテストはこの2つを別々に評価するうえで有意義なものです。
全てのセクションの中で最も酷いもの:テキストのレンダリング
表1には、文化の調整よりも目に余るもう1つの列があります。それが画面テキストのレンダリングです。
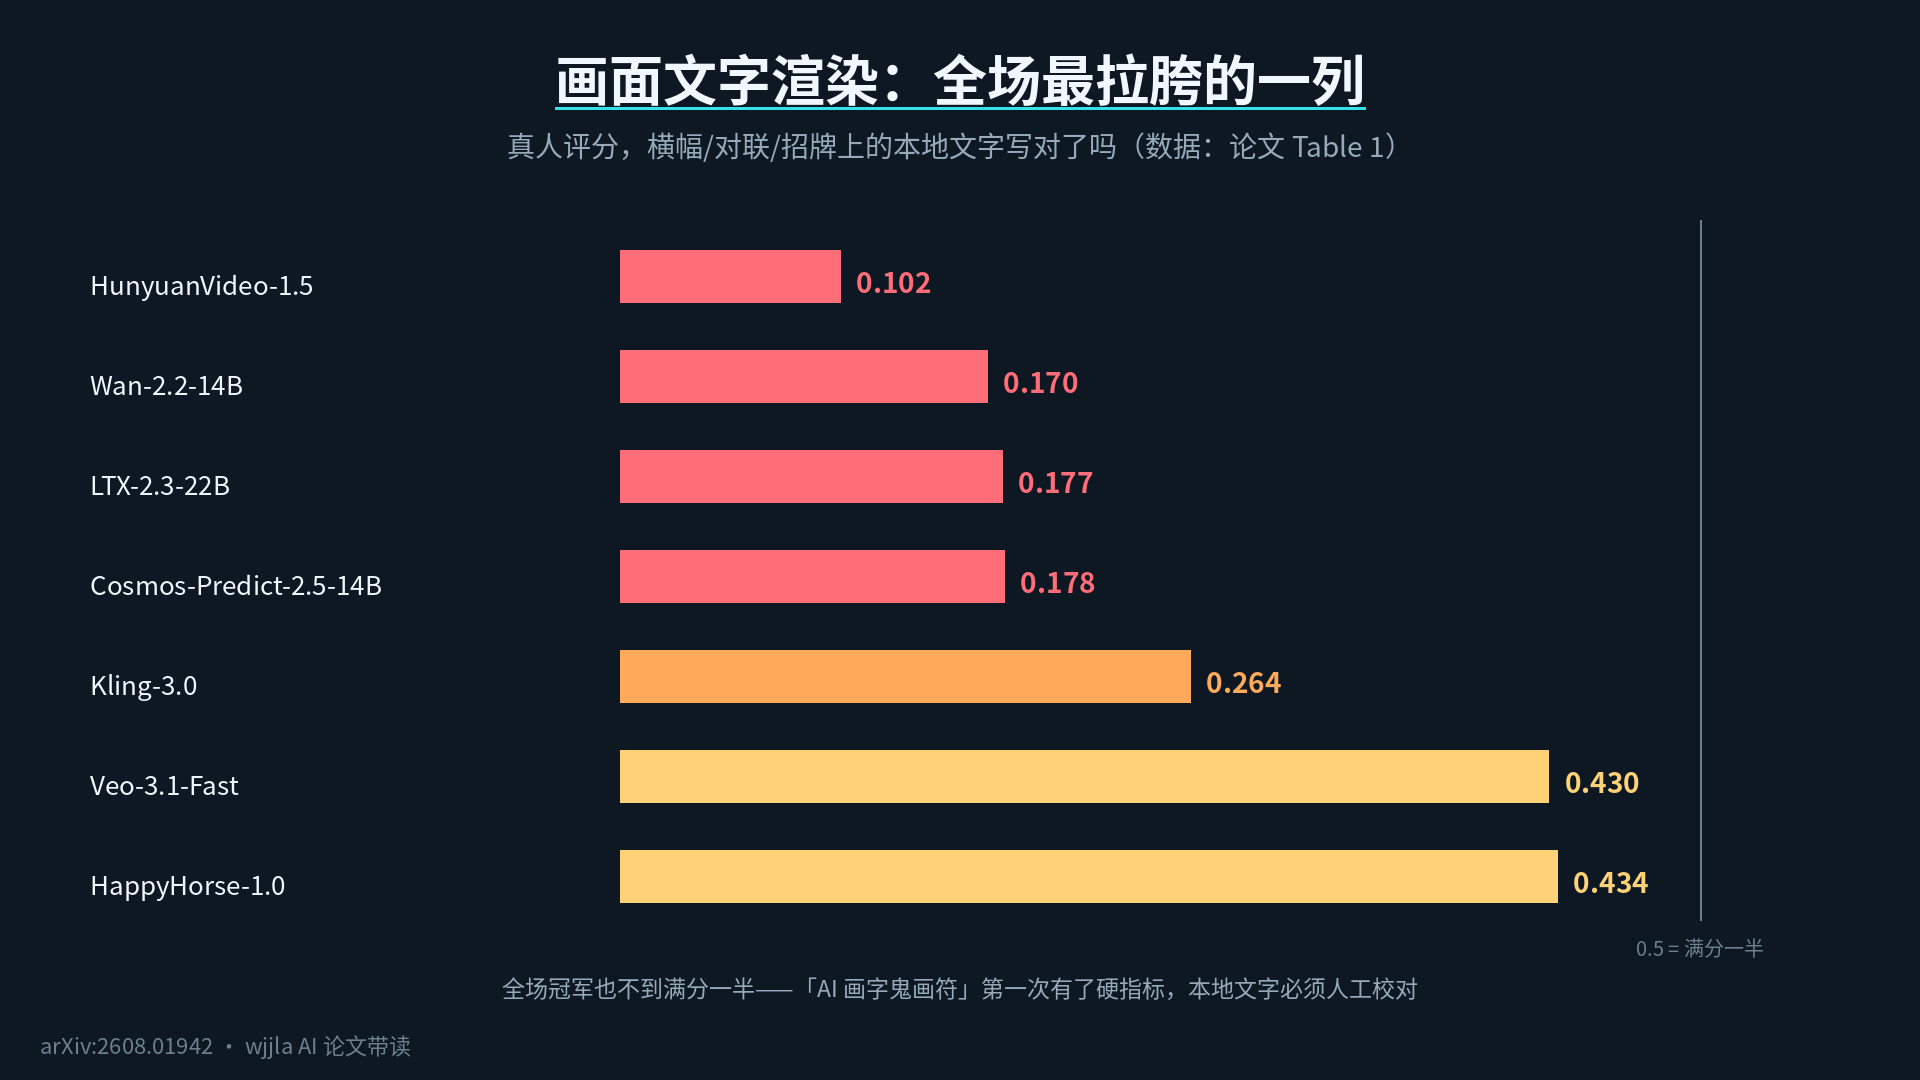
オープンソースチームの最高得点はCosmos-Predict-2.5-14Bで0.178、HunyuanVideo-1.5は0.102と低く、クローズドソースチームの方がわずかに優れており、HappyHorse-1.0で最高の0.434となっています。いずれのチャンピオンも満点の半分以下でした。バナー、対句、看板に書かれた現地語は、AIがほとんど書き間違えていました。オンラインで広まっている「AIが字を書くのは不思議な字」という話に、初めて具体的な指標が示されました。実用的な結論:動画に現地語が含まれている場合は、公開前に必ず手動で校正を行ってください。現時点では、どのモデルもこれを代行できません。
AI 審査員は信頼できるのか:テーブル 2 の対赌
AIを審査員として利用する目的は、評価の規模を拡大することです(人間による168項目の評価はすでに多大な投資がされています)。しかし、AIの評価は信頼できるのでしょうか?表2は、国別の平均Kendall τとSpearman ρでこの問いに答えています。数値が1に近いほど、AIと人間のランキングが一致していることを示しています。
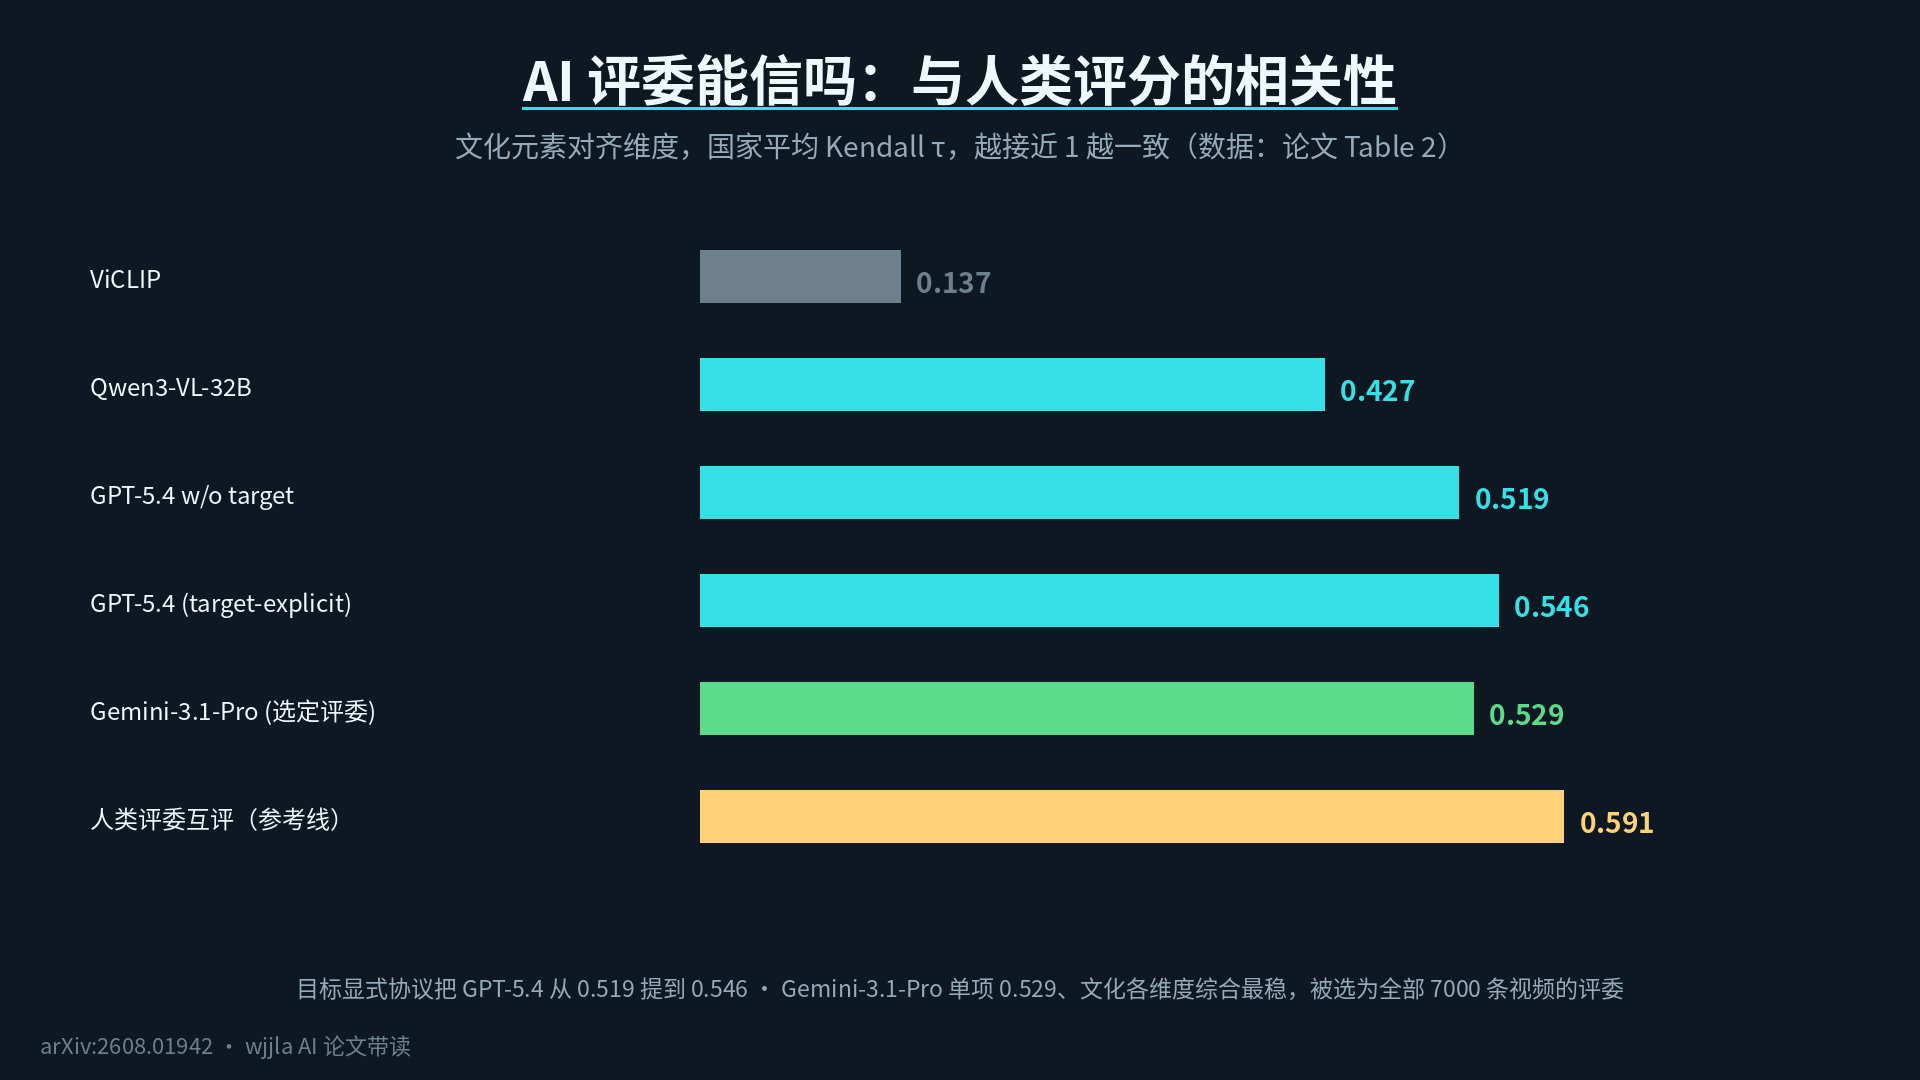
小型モデルではほとんど機能しない。ViCLIPのような画像とテキストの類似度を計測する小型モデルでは0.137しか得られず、Qwen3-VL-32Bでは0.427にまで上がりました。GPT-5.4で明示的なターゲットプロトコルを使用した場合、文化要素の整合性は0.519から0.546に向上し、プロトコル自体が効果的であることがわかりました。最終的に、著者はGemini-3.1-Proを評価者として選択しました。これは0.529を得ましたが、GPT-5.4よりもわずかに低いものの、文化の各次元(文化の一貫性0.521、テキストのレンダリング0.527)を総合的に評価すると最も安定した結果となっています。著者はこれを使って7,000本の動画すべてに点数を付けました。
主な基準は、人間の審査員間の相関関係であり、それは0.591でした。つまり、最高のAI審査員は、文化の観点から人間の審査員間の合意に近づいています。文化の評価は「人に依頼しなければならない」から、「AIに一通りチェックしてもらう」に変わっています。しかし、現実主義や視覚的品質などの主観的な観点では、人間自身の一貫性が低いため、AIも優れた結果を出せず、このような点数はあくまで目安として参考にする程度にしておくべきでしょう。
国と国の間:0.3のギャップ
ページ7の図5は、国別のスコアを示しています。この表(正確な数字は付録に記載されています)は、おそらく本文の中で実務家に最も役立つページでしょう。
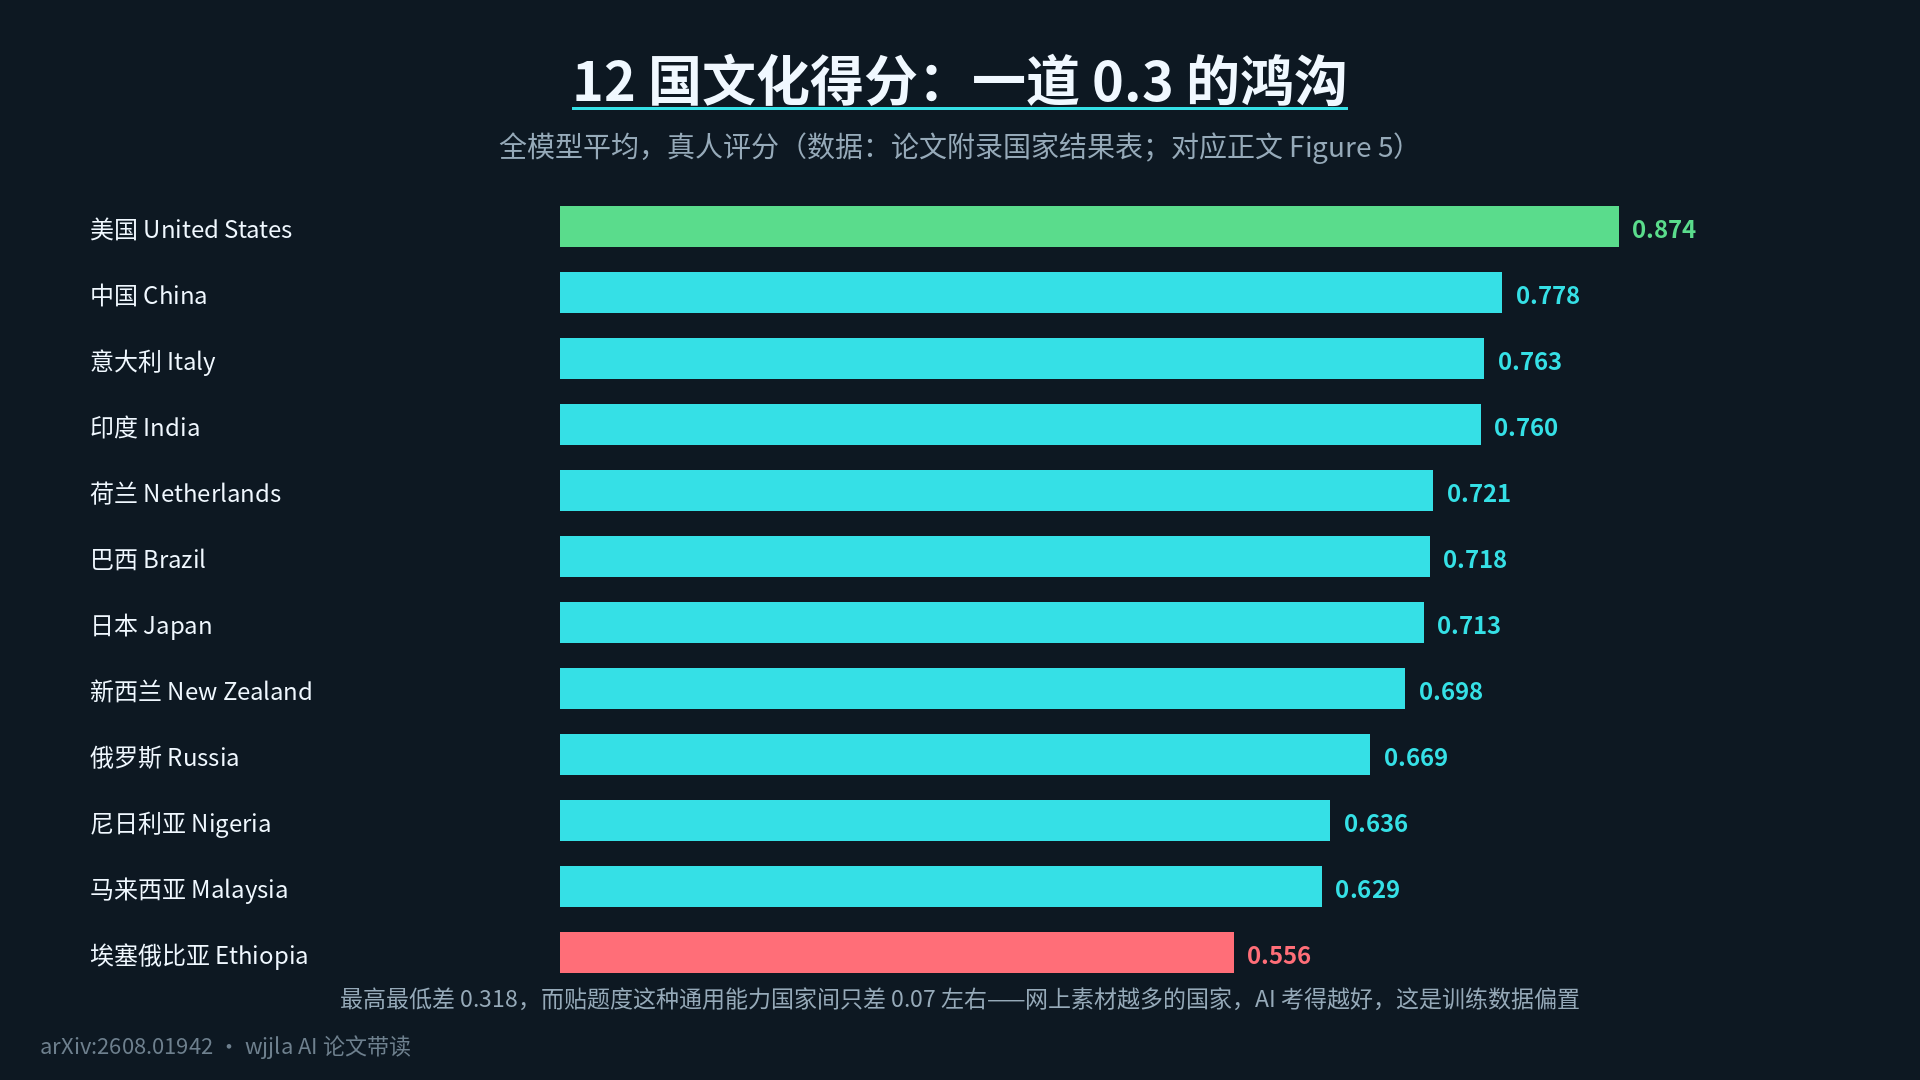
米国は0.874でほぼトップで、中国は0.778、イタリアは0.763、インドは0.760です。次いで、オランダは0.721、ブラジルは0.718、日本は0.713、ニュージーランドは0.698です。さらに下には、ロシアは0.669、ナイジェリアは0.636、マレーシアは0.629です。最下位はエチオピアで0.556となっています。
最高点と最低点の差は0.3以上でした。著者はまた、各国の分散度を算出しました。文化的な類似性の指標は0.3前後でしたが、一般的な能力である「テーマに合った表現」はわずか0.07程度の差しかありませんでした。つまり、どのモデルも「2人が将棋をしている」を正確に認識できますが、エチオピアの「肩すくめの挨拶」や日本の「将棋」などの文化的な細かさにはすぐに点数が変わってしまうのです。この法則は非常に明白であり、少し冷淡でもあります。オンライン素材が多い国ほど、AIは優れた結果を出します。これはモデルの優劣ではなく、トレーニングデータの偏りによるものです。
図6では、さらに追加のコメントがあります。オープンソースのモデルは、エチオピア、マレーシア、ナイジェリアなどの低資源国でより大きな点数の低下を経験していますが、クローズドソースのモデルも低下していますが、それでも強みが大きいため、低下後もリードを維持しています。
どの文化が撮影しにくいか:アイテムは簡単だけど、プロセスが難しい
図8は、14の側面を文化の種類別に示しています。物質文化の総合得点が最も高く、社会的実践とパフォーマンスが次いで、儀式が最も難しいものでした。文化の得点は、祝いのカテゴリで-15.6%、衣装のカテゴリで-30.9%と、意味の得点に比べて低くなっていました。
理由は非常にシンプルです。1つの対象物を撮影するのは静的な視覚問題ですが、時間と空間の流れを含む一連の動きを撮影するのは、まったく別のレベルの難易度があります。
図7の失敗例は最もわかりやすい例です。日本の将棋のシーンでは、HappyHorse-1.0で正確に再現されたのは将棋の盤と駒だけで、駒に書かれた字はすべて間違っていました。エチオピアの正統派キリスト教の十字架の描きでは、すべてのモデルが指先で十字を作るジェスチャーを再現できませんでした。マレーシアのハリ・レイヤ(Hari Raya)の装飾では、HunyuanVideo-1.5がクリスマスのスタイルで直接レンダリングされていました。高資源文化のパターンが低資源文化のシーンを完全に乗っ取ってしまったのです。
読み終わった後に留意すべきこと
まず、総合得点を能力と勘違いしてはいけません。この論文の最大の方法論的貢献は、「良く撮る」ことと「正しく理解する」ことを別々に評価することです。モデルの画質が0.8、文化が0.4の場合、現地のコンテンツには最適ですが、海外のコンテンツにはまったく適していないでしょう。モデルを選ぶ際には、何を求めているのかを考慮する必要があります。
第二に、クローズドソースの優位性は確かですが、神格化すべきではない。0.766は、クローズドソースのチャンピオンでさえ、20%以上の文化的要素を正確に翻訳できていないことを意味しています。テキストレンダリングの0.434は、どのモデルも全てのチェーンで信頼できないことを示しています。多文化プロジェクトでは、ローカライゼーションの審査は省略できません。
第三に、国別のスコアテーブルは保存しておく価値がある。どの市場のコンテンツを制作する場合も、まず該当国のスコアを確認する必要があります。アメリカ、中国、インドなどの資源が豊富な市場では、主流のモデルを信頼することができますが、エチオピア、マレーシアなどの市場では、0.55~0.63のスコアは、文化的な詳細の半分近くが誤っていることを意味し、手動で対処する必要があります。著者は、各国の各モデルについての完全なマトリックスのほかに、より詳細な因果分析を提供していません。例えば、決定的な要因はトレーニングデータの量かデータのバランスかといった点ですが、論文ではそれらについては詳細に説明していません。
第四に、AI の審査員はこのスコアよりも重要である。1000問×7モデルの規模の評価は、人間だけで永遠に終わることはないでしょう。ターゲットエクスプレッシブプロトコル(まず目標を列挙し、次に証拠を探し、最後にスコアを付ける)は、AI の審査員の関連性を人間同士の評価に近づけます。この手順は、おそらく次のマルチモーダル評価の標準となるでしょう。
簡単に言えば、動画の撮影に関してはAIはすでに卒業しているが、文化に関してはまだ勉強中であり、この論文はその勉強の進歩状況を示す最初の成績表である。
論文:CultureVidBench:テキストからビデオへの生成における文化的理解のベンチマーキング arXiv:https://arxiv.org/abs/2608.01942 プロジェクトホームページ:https://hanxjing.github.io/CultureVidBench/