想像してみてください。あなたはインターンを雇い、彼に航空券の予約、申請書の記入、書類の整理をしてもらっています。
しかし、あなたは彼に一つのルールを設けました。それは、画面を見ること、マウスやキーボードを操作すること、ソフトウェアのバックエンドにあるどんなインターフェイスも見ることはできないというルールです。
これは非常に難しいように思えますが、それが2026年8月4日にarXivに投稿された論文「Qwen-CUA: Native Computer Use for (almost) Everything」が行ったことです。Qwenチームと香港大学Xlang Labが共同で発表し、30人以上の著者が参加し、GitHubリポジトリはxlang-ai/Qwen-CUAで公開されています。
今日の記事では、1つの疑問に答えていきます。このルールの下で育成されたインターンは、実際に仕事をこなせるのでしょうか?
なんでこんなに厳しいルールにしないといけないの?
AIがデジタルの世界で働きたいのであれば、実際には3つの道しかありません。コードを書くか、インタフェースを調整するか、グラフィカルユーザーインタフェースを利用するかです。最初の2つの道については、過去数年間に大規模なモデルがすでに優れています。なぜなら、これらのモデルはテキストを理解し、ツールを調整することができるからです。
しかし、現実には、多くの作業が最初の2つの道には該当しません。デスクトップソフトウェア、古いシステム、専門ツールなど、機能はすべて画面に表示されていますが、コンピュータはそれを読み取ることはできません。したがって、「画面だけを見て、マウスとキーボードだけを使う」ことは自虐ではなく、すべてのソフトウェアに適用できる唯一の方法なのです。
しかし、この道には3つの大きな問題があります。インターフェイスの状態が半分しか見えず、エラーがどんどん大きくなっていき、証拠が何十枚ものスクリーンショットに散らばっています。論文1の導言では、この3つの問題について非常に明確に述べています。Qwen-CUAはどのようにして1つずつクリアしていったのでしょうか?まずは「目と手」から始めなければなりません。
第1ステージ: 目と手を組み合わせる
論文の2.1節では、インターンに最小限の装備を与えたことを示しており、それが図2に示されています。
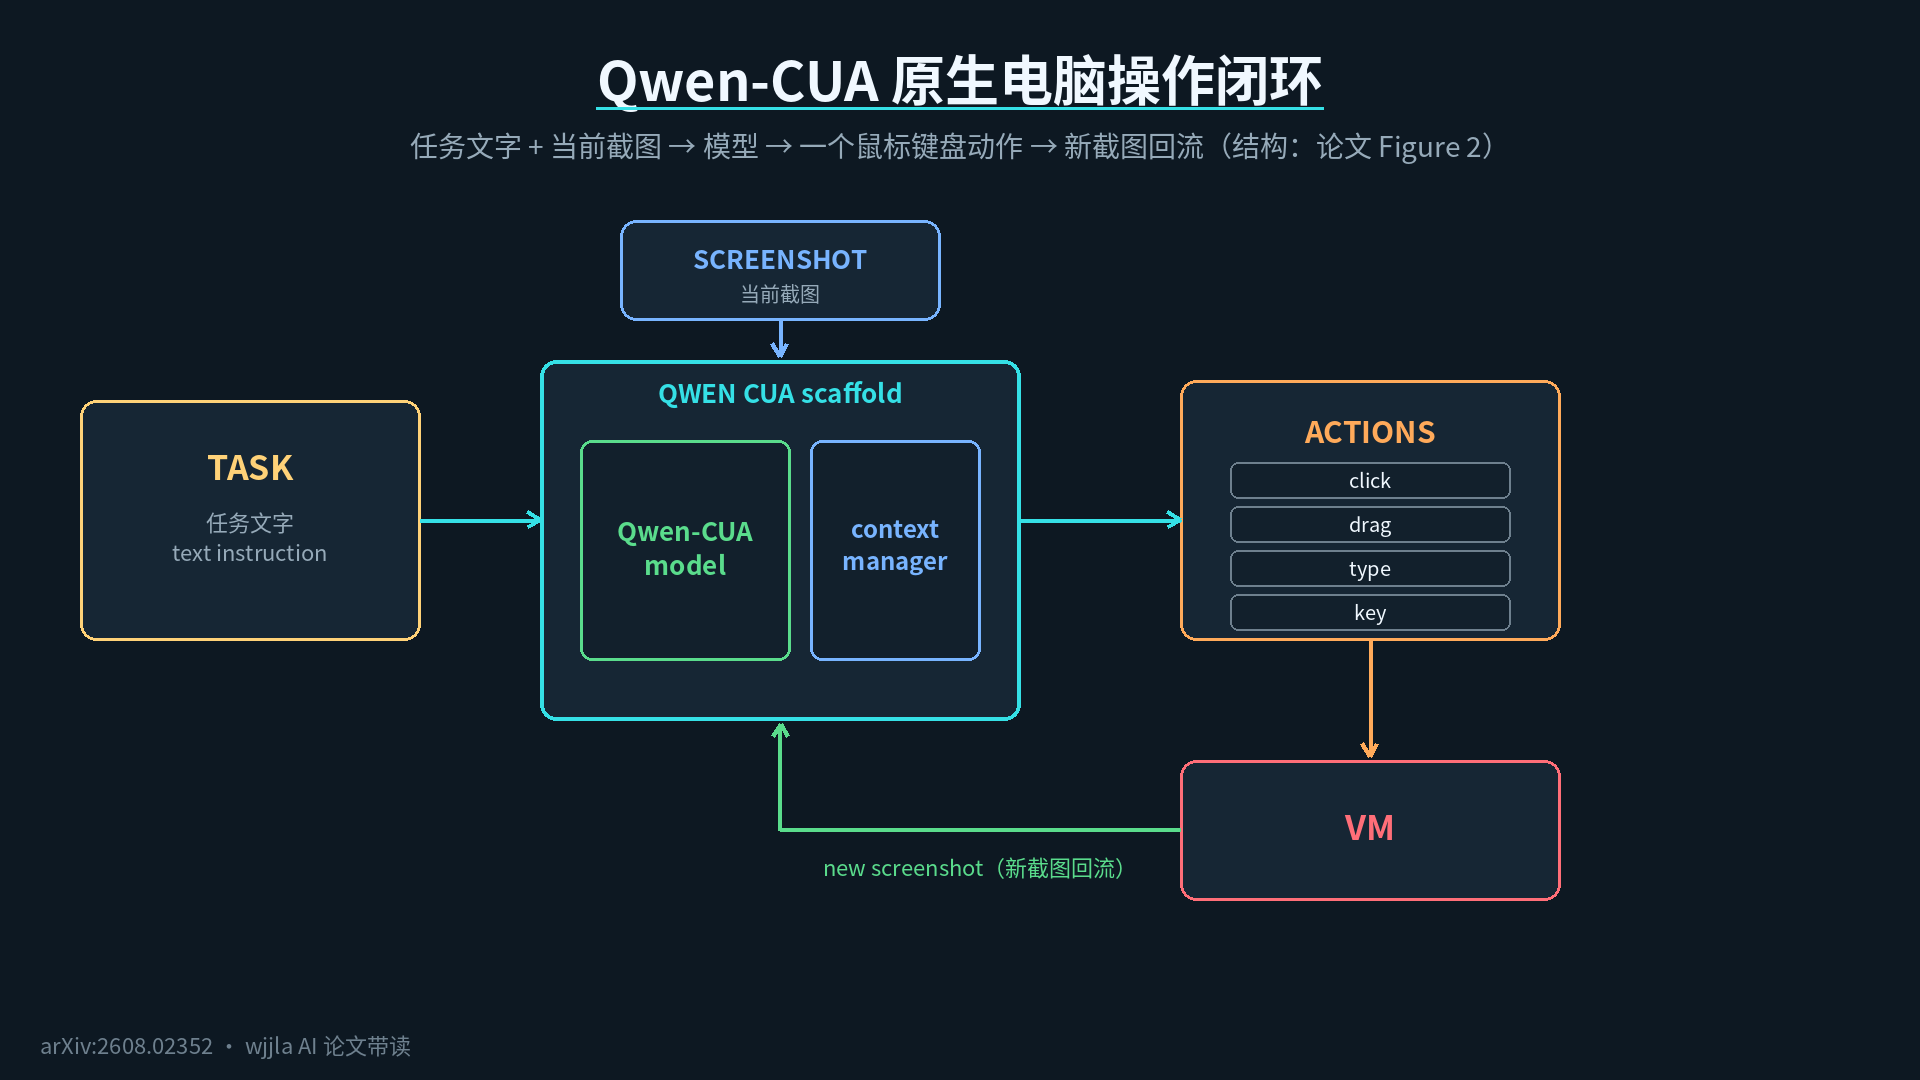
全ての作業の流れは次のとおりです。タスクのテキストを入力し、現在のスクリーンショットを見て、マウスやキーボードの操作を出力する。操作は3つに分かれています。マウス(移動、左/右/中クリック、ダブルクリック、トリプルクリック、ドラッグ、スクロール)、キーボード(キーの組み合わせ、長押し/離し、テキスト入力)、コントロール(スクリーンショット、待機、終了、ユーザーに電話をかける)。付録Aにはすべての操作の一覧が記載されています。
真ん中に「scaffold」と呼ばれるものがあります。これをワークステーションのコーディネーターと考えてください。タスクをモデルに渡し、スクリーンショットを入力し、仮想マシンにアクションを実行し、新しいスクリーンショットを取り込みます。内部の詳細は気にしなくていいです。各ラウンドでは、1つのみの作業に集中してください。
論文の中に私が平易な言葉に翻訳しなければならない一文があります。この機器はブラウザーやデスクトップアプリケーションにわたって動作し、設定を変更することなく動作します。DOMツリー、アクセシビリティメタデータ、専用APIは一切使用していません。これは標準的な「人間の目と手」なのです。
目と手の調整は最初のステップにすぎません。本当に面倒なのは、作業を続けるうちに何かを忘れてしまうことです。
第2ステージ:記憶力が足りないので、メモを使って対応します
2.2節では、記憶力の問題を解決しています。
長時間のタスクでは、数十枚から数百枚のスクリーンショットが撮られ、すべてを短期記憶に保存しようとすると誰も対応できないでしょう。Qwen-CUAのアプローチはノートパッドのように機能します:
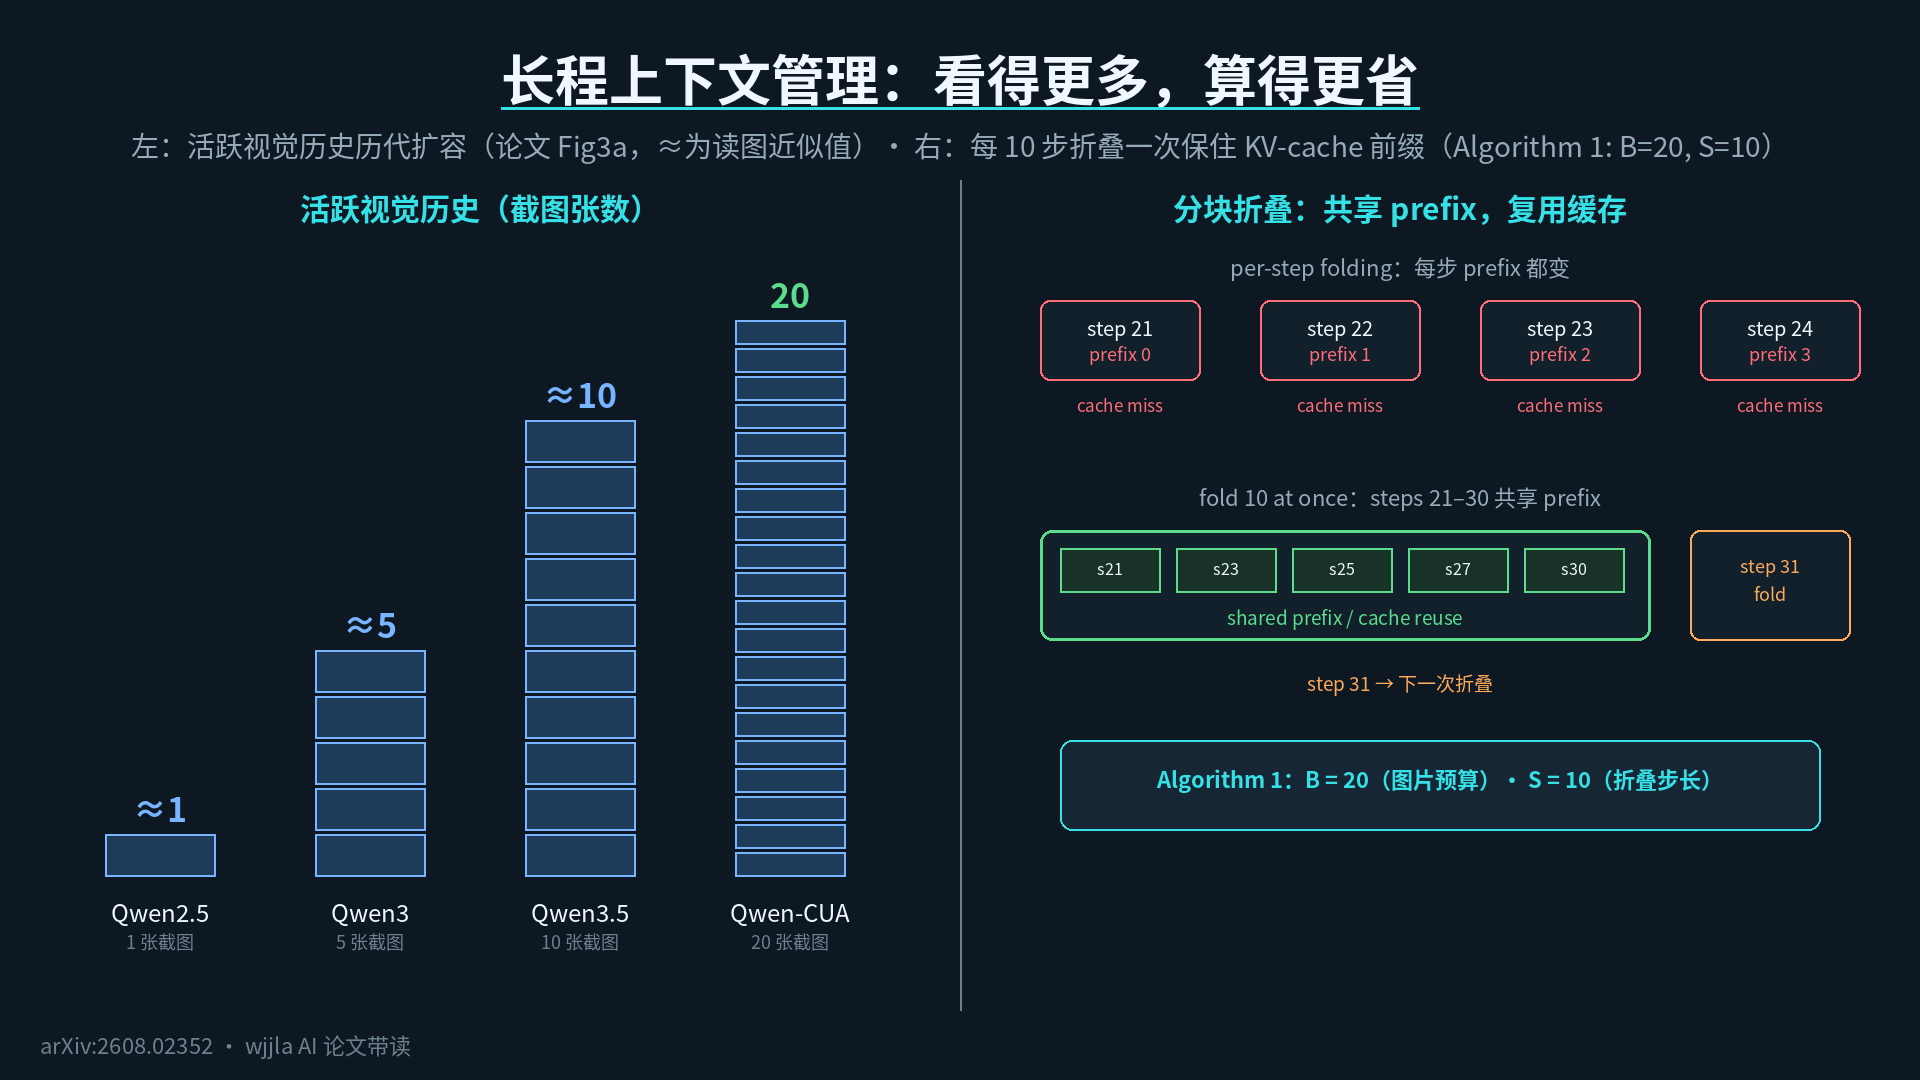
- アクティブなビジュアル履歴は最大20枚のスクリーンショット。最近の20枚はテーブルに広げていつでも見ることができます。
- 10枚集めるごとに、1枚前に折りたたむ。折りたたむことは捨てることではなく、古いスクリーンショットをテキストのプレイスホルダーに置き換えることです。「ここにはスクリーンショットがあったが、その時Xをした」と書くことになりますが、その時の行動や考えはすべてコンテキストに残っています。
論文の図3(a)は、Qwenの各世代の「デスクトップ」がどのように拡大してきたかを示しています。Qwen2.5は1枚、Qwen3は5枚、Qwen3.5は10枚、Qwen-CUAは20枚に直接拡大しています。図3(b)では、2つの折りたたみ方法を比較しています。1つはすべてのステップでプレフィックスを変更する方法、もう1つは10ステップごとにプレフィックスを変更する方法です。後者の場合、プレフィックスは共有され、KVキャッシュは直接再利用されるため、コンピューティングパワーが節約されます。
もう1つのトレーニングの詳細事項は、強化学習で使用されるのは、同じ折りたたみオペレーターであり、長いトレース全体が文脈に制約された複数のスライスに切り分けられ、各スライスは同じ終了報酬を継承します。これにより、中間ステップに報酬を手動で与える必要がなく、監視信号が最終状態から中間の決定まで伝達されます。
目、手、メモ帳はすべて揃っています。次の核心の問いは:このインターンはどのようにして育ったのでしょうか?
第3ステージ:どうやって練習するか——まずは10万コアの「自動車教習所」を作る
コンピューターが動作する知能体をトレーニングする際に最も難しいのは、モデルではなく、何度も試行錯誤を重ねる場所を見つけることです。
著者は「自動車教習所」を作り、アリクラウドのECS上に構築し、10万近くの仮想CPUコアを実現し、数万の並行環境を同時に展開することができました。各仮想コンピュータは独立したワークステーションであり、自由に操作できます。
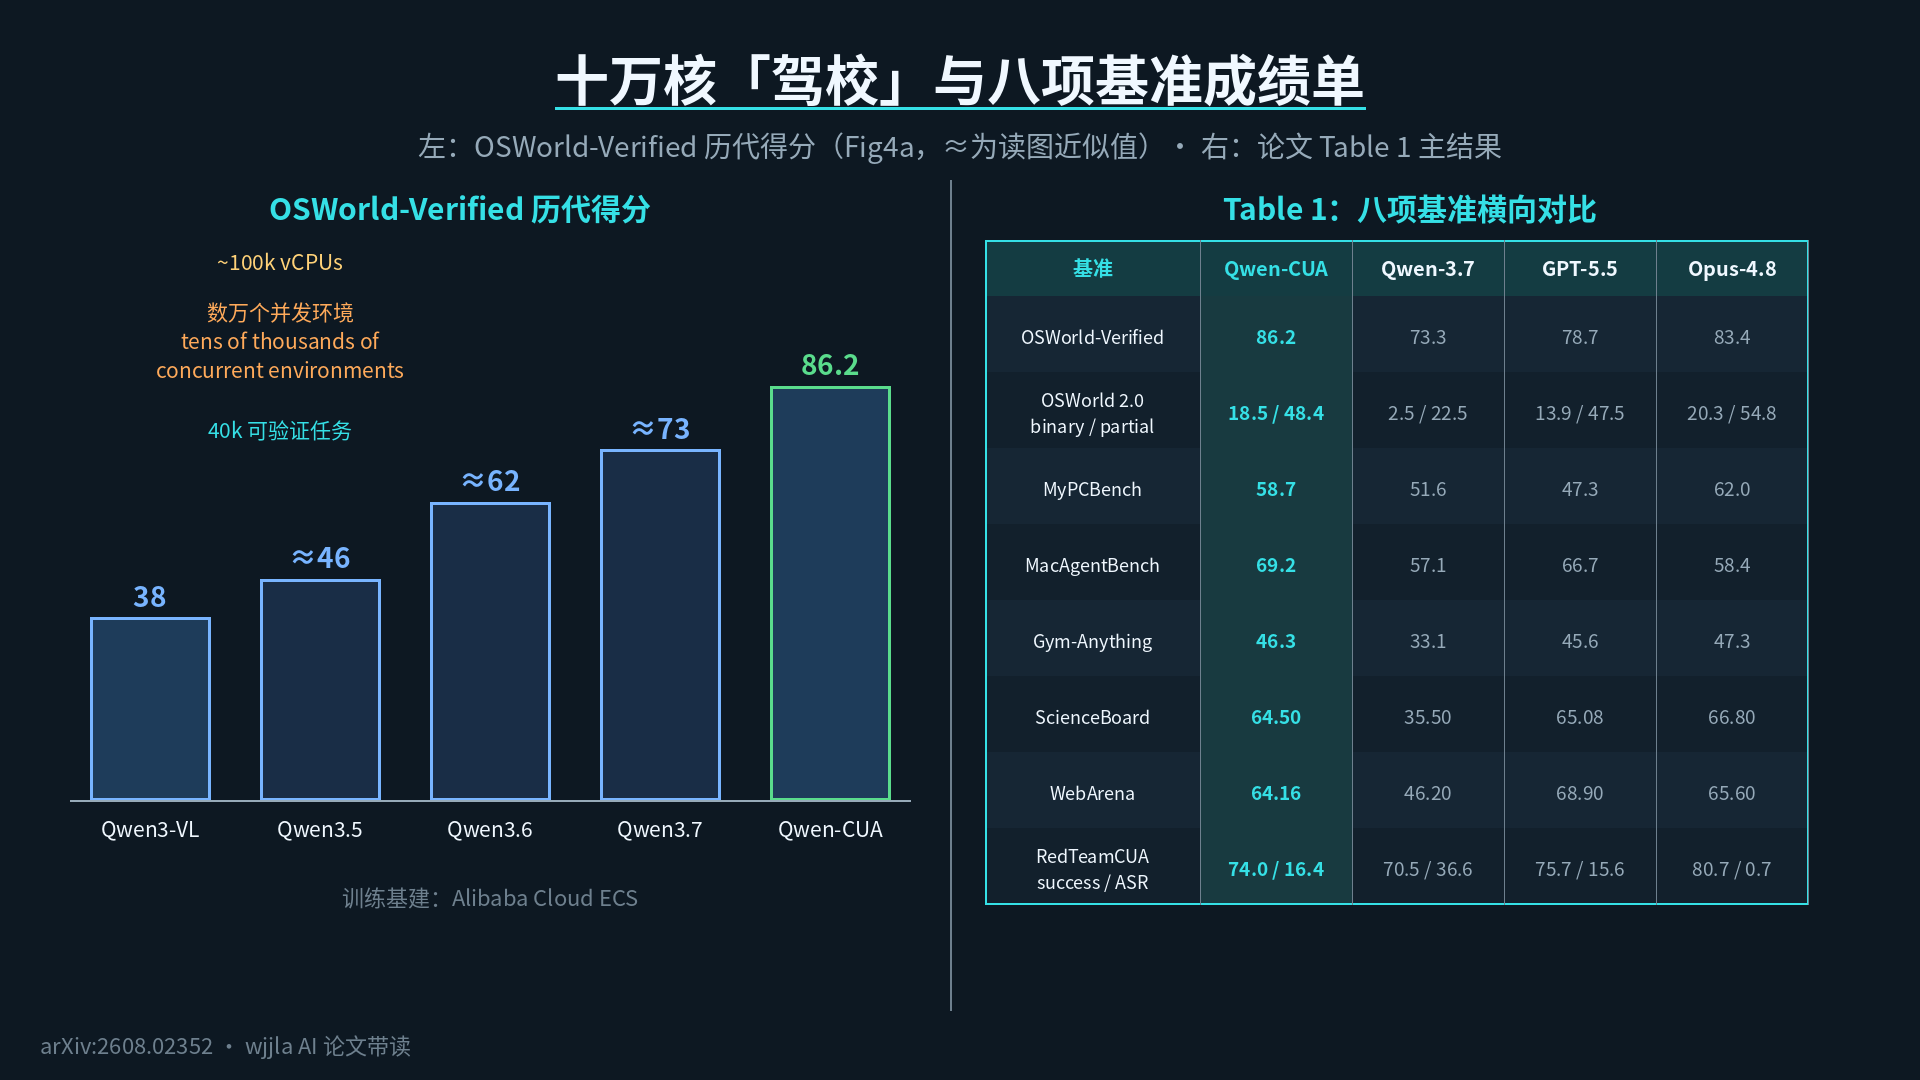
図4(a)は非常にわかりやすく、Qwen3-VLの38からQwen3.5の46、Qwen3.6の62、Qwen3.7の73、そしてQwen-CUAの86.2までの各世代のOSWorld-Verifiedのスコアが示されています。図には3つのマイルストーンが示されており、それらは約4万件の検証可能なタスク、約10万個のvCPU、数万個の並列環境です。
教習所と試験が整ったとしても、教材はどこから手に入れるのでしょうか?それが次のステップです。
第四関:教材 - 3種類の演習問題と1種類の指導教師による指導
教材は3種類の演習に分かれており、さらに「師匠による指導」というカテゴリーもあります。私があなたのためにそれらを1つの授業スケジュールにまとめたので、ご覧ください。
- 環境操作問題(第1種)——ソフトウェアのボタン、メニュー、状態切り替えの認識を教える。
- ユーザーインタラクション問題(第2種)——タスクの情報を省略してみて、ユーザーが自発的に質問してくるかどうかを確認する。この問題では、OSWorld 2.0の「シミュレートユーザー」アプローチを利用しています。シミュレートユーザーは、ユーザーが質問したときにのみ応答します。
- 長いフローの問題(第3種)——大規模なタスクを自動的にスコアできる小さなフェーズに分割します。これはリレーレースのように各フェーズで検証可能な終了状態を設定し、状態が変更された場合には次のフェーズに状態をシリアル化して渡します。このアプローチは「フェーズ・ステート・チェーンイング」と呼ばれ、論文3.2.2で詳細に説明されています。
- 実人による指導(第4種)——実人に自分のコンピュータで実際の作業を行ってもらいます。航空券の予約、申込書の記入、CAD、Blenderなどを行ってもらいます。モデルは各ステップに「内面独白」(思考チェーン)を追加し、スクリーンショットと自分のアクションに合致するかどうかを2回の検証で不正確な記述を排除します。
この4つを合わせたものが自動車教習所のすべての教材です。しかし、コンピューターの操作を学ぶ際に最も重要なのは、データではなく、エラーを犯し、エラーから学習を重ねて成長することができるアルゴリズムです。
第五関:コーチング方法 - 試行錯誤の中で点数を伸ばす
3.3節では強化学習について説明しており、アルゴリズムの名称はSAPO(Soft Adaptive Policy Optimization)です。名称は覚えなくても、「間違った選択はペナルティ、正しい選択は報酬」という最新のトレーニング方法の1つであることを知っておけば十分です。
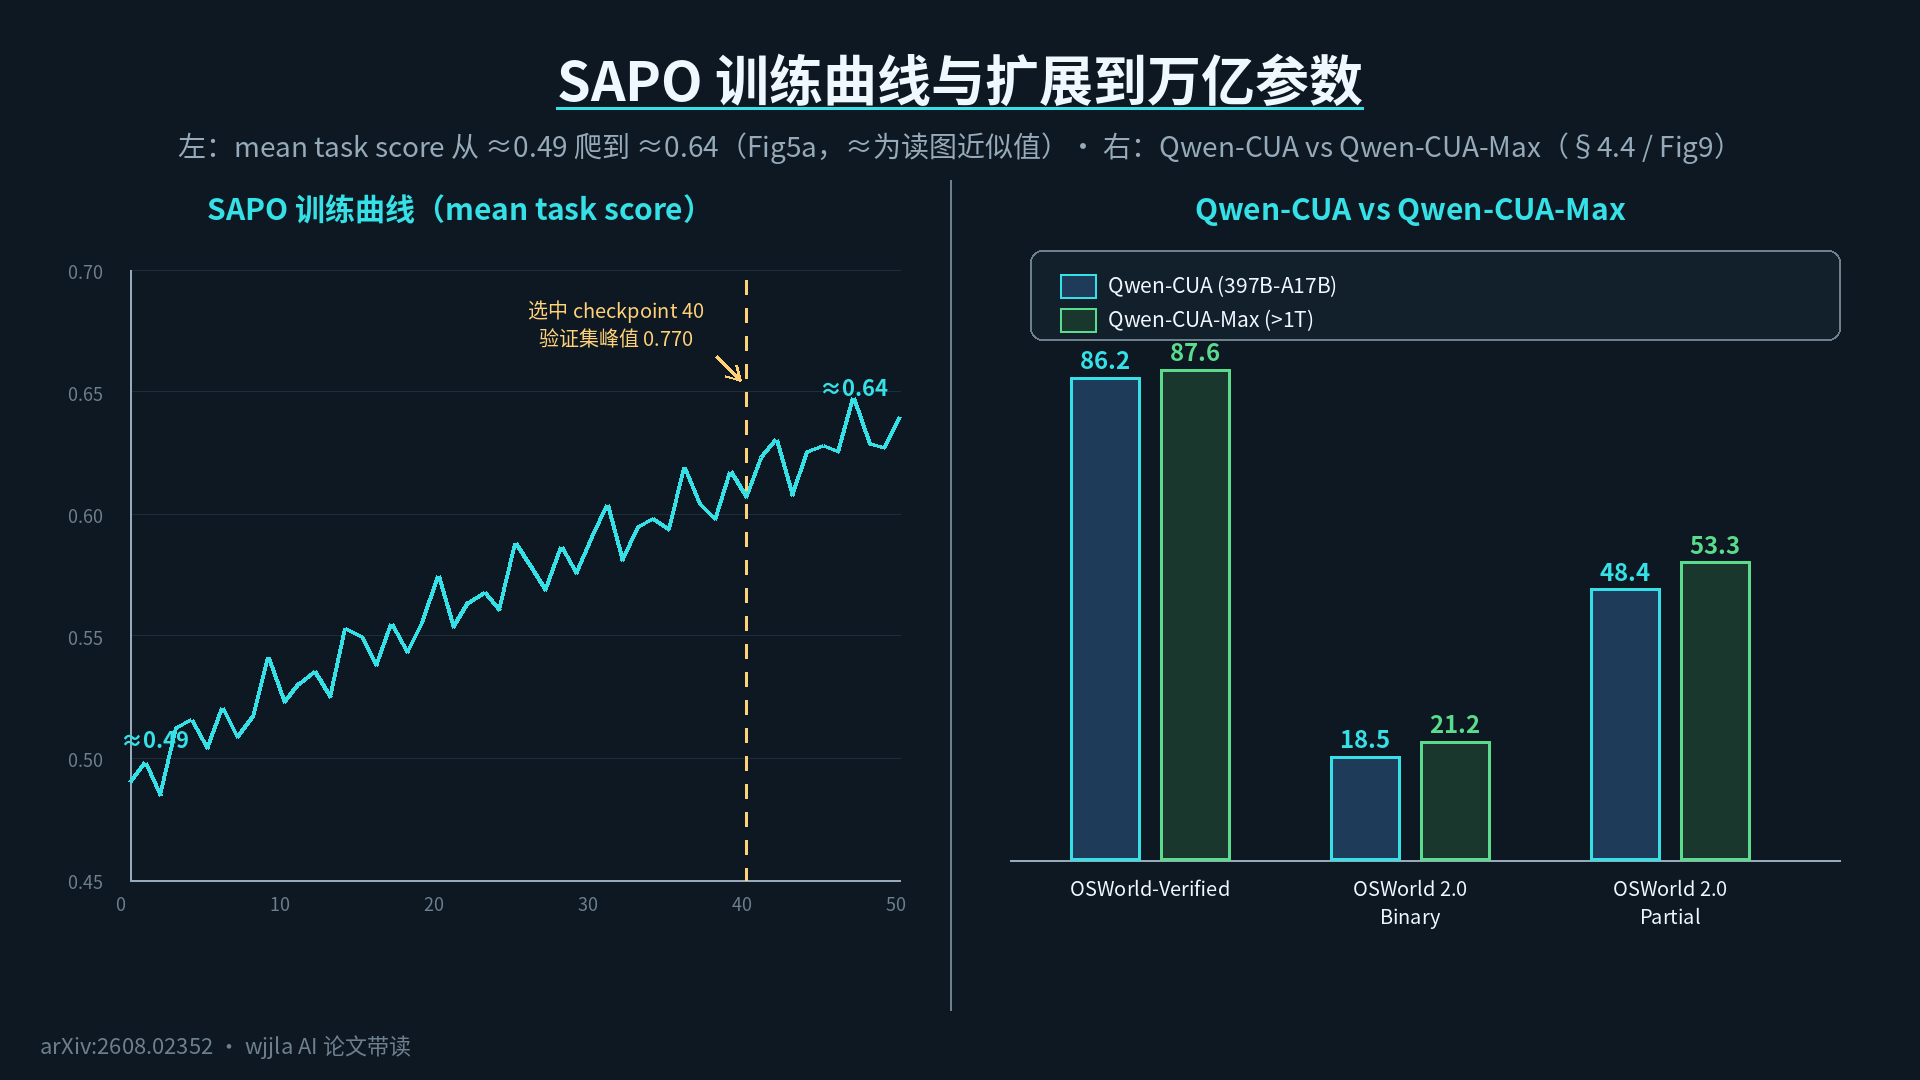
図5はトレーニング曲線ですが、私たちは傾向のみを見ています。
- トレーニングスコアテストの質問のバッチごとに異なるため、最初の0.49から0.64まで、途中でジッターがあります。
- クロスドメイン検証スコアRL前の0.734からチェックポイント40(つまり、800回目の更新)の0.770ピークまで、著者はこのバージョンを最終モデルとして設定しました。トレーニング全体で1,000回の更新予算が実行され、チェックポイント50で0.762になりました。
3.4節では、反復トレーニングの論理を説明しています。各ラウンドでは、最新のモデルを使用して新しい問題を発見し、新しい問題を追加し、次のラウンドのトレーニングを行う。具体的には、2つのステップで実施します。最初のステップでは、最新のモデルを使用して既存のSFT問題を実行し、どの問題がまだ正しく解けないかを統計します。これらの問題は、教師戦略で再生成されます。次のステップでは、強化学習の候補問題に「難易度の選別」を行います。8回の実験(ロールアウト)を実行し、0回成功した場合(難しすぎ)や8回すべて成功した場合(簡単すぎ)は除外し、中間の難易度の問題のみを残します。このような「自己選択」により、トレーニングは常に最適な状態で実施されます。
ここまで練習したら、インターンは正式にデビューし、試験に向かうことになります。
第六関:8つの大テストの成績表
試験会場では合計8つの項目があり、論文の表1は主な成績表です。
最も重要なカテゴリーは「OSWorld-Verified」で、Qwen-CUAは86.2点を獲得しました。前バージョンのQwen3.7は73.3点でした。同じカテゴリーでは、GPT-5.5が78.7点、Claude Opus 4.8が83.4点でした。8つのカテゴリーすべてで、Qwen-CUAは「OSWorld-Verified」と「MacAgentBench」で同じカテゴリーの最高得点を獲得しました(69.2点)。その他のカテゴリーでも、閉源の強豪と互角の戦いを繰り広げました。例えば、OSWorld 2.0とRedTeamCUAでは、Opus 4.8が依然としてQwen-CUAよりも優れていました。
より難しいOSWorld 2.0 長時間タスクでは、Qwen-CUA は18.5 のバイナリ完了率と 48.4 の部分完了率を獲得し、前バージョンの 2.5 と 22.5 に大きく差をつけました。バイナリ完了率はほぼ 7 倍になりました。
図1では、8つの成績が棒グラフで表示されています。各グループの色の最も濃い部分はQwen-CUA-Maxで、後で別途説明します。
まず、一つ覚えておいてください。8つの項目すべてで、彼は前任者を上回っていました。**
しかし、まずは拍手をせずに待ってください。彼は「長い間考えていたり、余計なおしゃべりをしていた」ことで有名になったのではないでしょうか?
第七関:成績に水分はないか?効率チェック
この疑問は非常に合理的で、論文の第4.1節ではこの疑問に答えるための効率分析が特に行われており、それが図6に示されています。
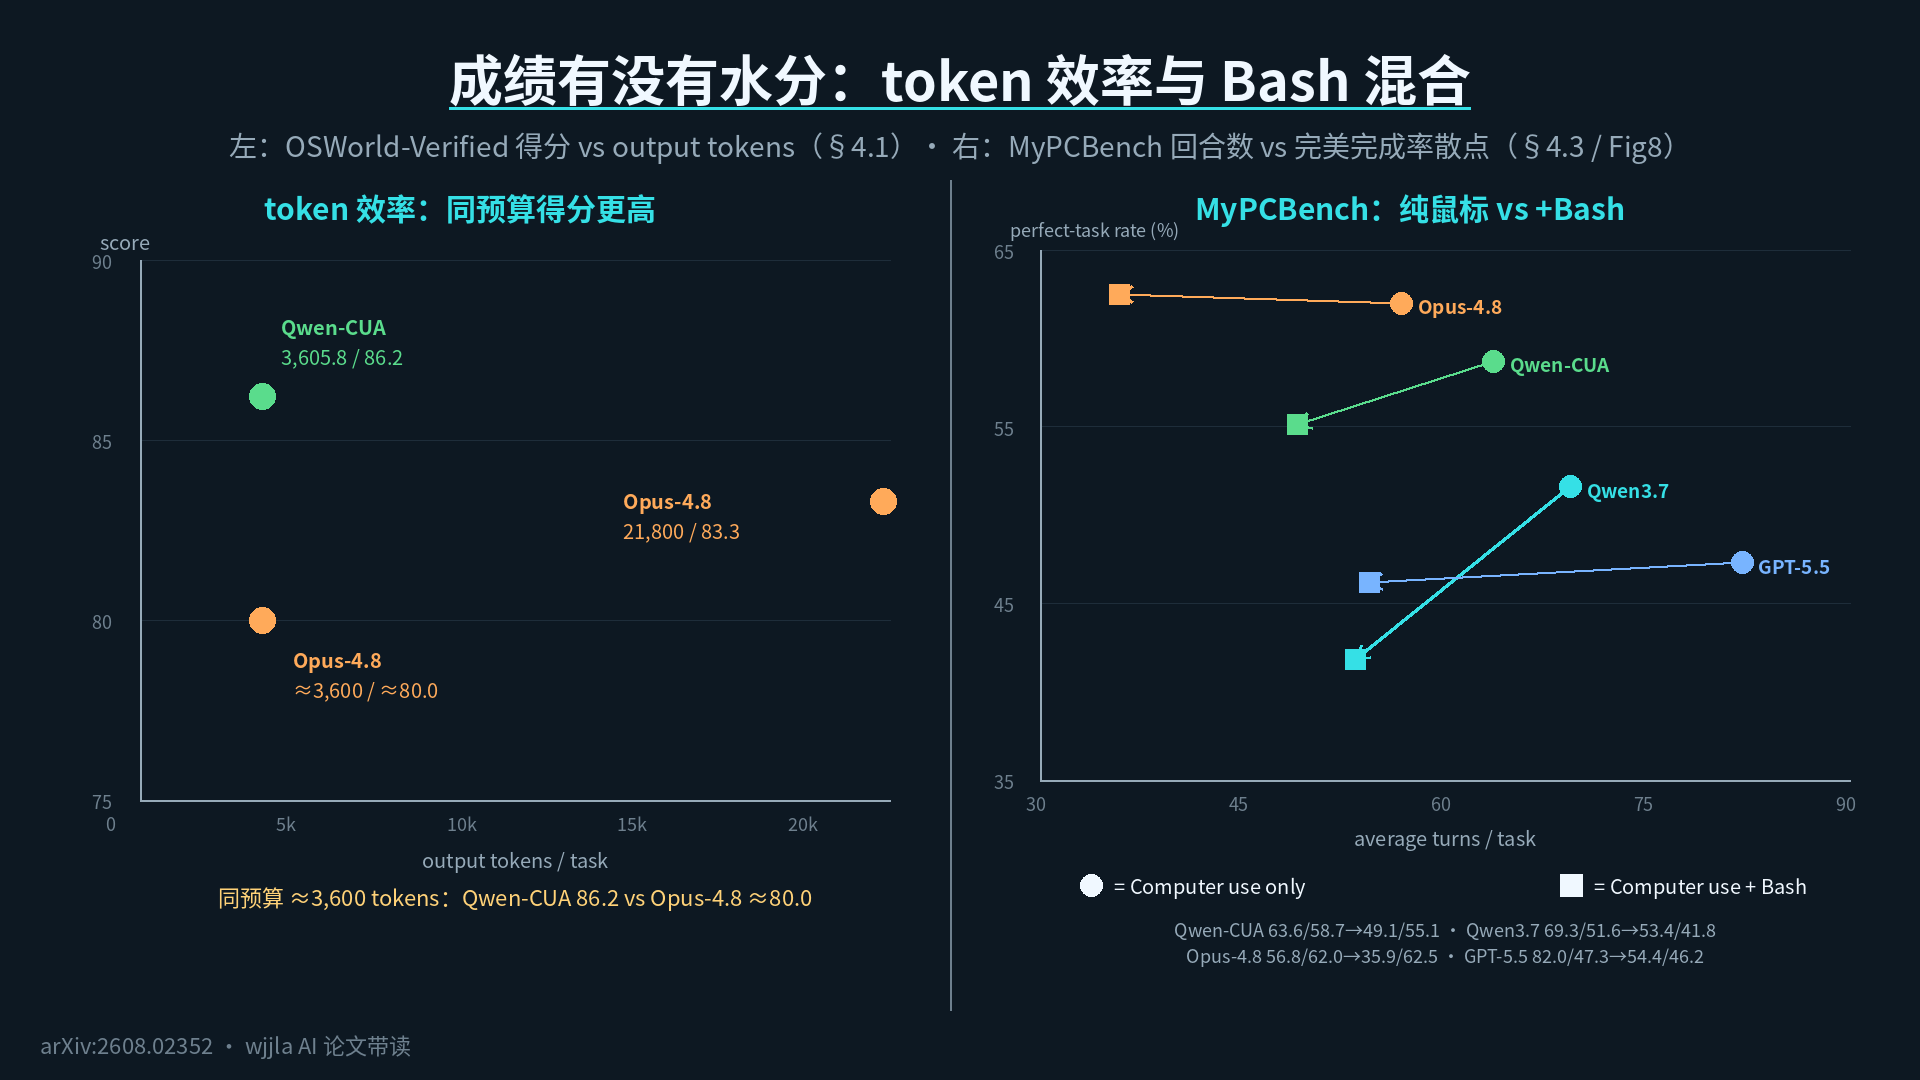
左のグラフはトークンの効率を示しています。横軸は各問題のモデル出力の文字数、縦軸はOSWorld-Verifiedのスコアです。Qwen-CUAは3,605.8トークンの出力で86.2を獲得しました。同じ予算で、Claude Opus 4.8は80.0しか獲得できず、Opus 4.8が83.3を獲得するには21,800トークンが必要でした。Qwen-CUAの向上は「冗長」から来るものではないのです。
右図は対話効率です。横軸はラウンド数で、OSWorld 2.0でQwen-CUAは平均で218.9ラウンド/問題で、GPT-5.5の83.5よりもかなり多くなっています。しかし、著者は注意を促しています。クローズドソースシステムでは1ラウンドで複数のアクションを実行できますが、Qwen-CUAでは1ラウンドで1つのアクションしか実行できないため、ラウンド数の差はインタフェースの粒度の違いによるものであり、「機能が弱い」わけではないのです。
効率は問題ではない。しかし、仕事をするだけでは不十分です。仕事をする際に信頼できるか?
第8ステージ:信頼できるかどうか——フィッシング対策テスト
コンピュータを操作する際に特に注意するべきことの1つは、画面に表示されるコンテンツが悪意のある者によって設置されたトラップである可能性があることです。例えば、ウェブページに「補助金を受け取る」という偽ボタンが表示され、クリックすると実際には送金が行われる場合があります。
レッドチームCUAはこのベンチマーでこれを特にテストし、2つの数値を確認します。1つは作業が完了したかどうか、もう1つは騙されたかどうかです。Qwen-CUAの2つの指標はいずれも改善しています:
- 「タスク成功率」はQwen3.7の70.5から74.0に上昇しました。 -「攻撃成功率(ASR)」は36.6から16.4に低下し、合計20.2ポイント減少しました。
まれな双勝利:仕事をより良くこなし、だまされる可能性が低くなる。この改善は、自分のクラウドストレージ、インスタントメッセンジャー、Redditの3つのプラットフォームすべてに適用されます(表2)。
しかし、著者は正直に言っています。16.4のASRは依然として残留リスクであり、セキュリティ保証ではありません。Rocket.ChatでASRを見る場合、タスクの成功率も考慮する必要があります。一部の失敗はトリックに引っかかったためのもので、実際に詐欺に遭ったわけではないのです。
試験場でのパフォーマンスはさておき、試験場を出た後、本当のインターネットでうまくいけるのでしょうか?
実戦場:本物のプラグイン Qwen for Chrome
4.2 セクションでは、試験室を出て実際のインターネットにアクセスします。図7はブラウザのスクリーンショットです。画面右側にQwenのサイドバーが追加されており、これがQwen for Chromeであり、Chromeの内部プラグインです。
それは本物のウェブサイトで動作し、すべての動作が明確に表示されます。不透明な処理はありません。支払いやファイル削除などの重要な操作を行う前に、まずポップアップが表示され、ユーザーに確認を求められます。
付録Eには、エージェントがブラウザで自分でクラウドサーバーを購入し、環境を設定し、すべてをマウスでクリックして完了するエンドツーエンドのケースが示されています。このケースの意義は、エージェントが試験用紙に取り組んでいるわけではなく、実際の世界で業務をこなしていることにあります。
しかし、実際の仕事では、マウスの操作だけで足りるのでしょうか?ベテランのプログラマーなら誰でも知っているように、コマンドラインもあります。
第九関:彼にコマンドラインを与えるべきかどうか——Bash の混乱が予想される
4.3節では、マウスやキーボード以外に、エージェントにBashを開く必要があるかどうかという実際の質問がされています。
答えは:Bashを使用すると、作業の手間が少なくてすみますが、成功率がわずかに低下します。
論文の図8は、散布図でわかりやすく示されています(注意:散布図ではなく、柱状グラフです)。:
Bashを追加した後、Qwen-CUAのMyPCBenchの平均ラウンド数は63.6から49.1に減少した。 しかし、完了率は58.7から55.1に低下した。
Qwen3.7も同じ傾向が見られ、ラウンド数が69.3から53.4に、そして達成率が51.6から41.8に減少しています。
著者の説明は次のようになっている。「問題ではなく、モデルが「いつ切り替えるべきか」をまだ学んでいないのです。」Bashはより短いルートを提供しますが、不要な切り替えやタイミングのずれは正確率に影響を与えます。著者はこれを「最適化のギャップ」と分類し、「混合インタフェースの限界」ではないと主張し、「将来的には、連合トレーニングと明示的なツールルーティングの監視によって、正確率を回復しながら効率を維持することができる」と明確に述べています。
これは非常に重要な警告です。インタフェースが充実していても、それが使い方が熟達していることを意味するわけではないのです。
第10ステージ:より大きな脳に交換する——Qwen-CUA-Max
4.4 節で別のアプローチをとる。397B-A17Bを1兆以上のパラメータに直接拡大し、名前をQwen-CUA-Maxとします。同じ育成方法で、より大きな脳に feeding を行っていきましょう。
結果:
- OSWorld 検証済み:86.2 → 87.6;
- OSWorld 2.0 バイナリ完成率:18.5 → 21.2;
- OSWorld 2.0 部分完成率:48.4 → 53.3(最も伸びた項目)。
つまり、この育成レシピは時代遅れではないのです。さらにパラメータを与えれば、スコアをさらに伸ばすことができるのです。
試験会場、実戦、装備、アップグレード版についてはすべて説明しました。最初の質問に戻りましょう。
読み終わった後に思いついた、注意すべきこと
まず、「画面のみを見る」というアプローチは実現可能ですが、遅くて高価です。ピクセルベースのアプローチは自然とDOMベースのアプローチよりも遅く、スクリーンショットをモデルに再入力するたびに何十ミリ秒から何百ミリ秒かかかります。論文の結論では、「汎用性は最適性を意味するわけではない」と自ら認めています。このアプローチの最大の価値は汎用性であり、デスクトップソフトウェア、動的ウェブページ、専門ツールに適用できますが、速度ではありません。もしあなたの作業をコードやAPIで実現できれば、その方が安上がりです。
二つ目に、16.4%の騙され率はゼロではない。RedTeamCUAでQwen-CUAが攻撃成功率を36.6%から16.4%に下げたのは大きな進歩ですが、それでも「画面に诱惑があれば」100回中16回エージェントが騙されることを意味しています。この数字は企業の導入では人手による対応が必要になるでしょう。これがQwen for Chromeが「重要な操作のポップアップ確認」として設計された理由であり、これは技術的な実証ではなく、本当に必要なものです。
第三に、Bash をミックスインすると点数が下がるので、これはAIツールコミュニティ全体への警告です。「調整できるツールが増えた」ことは「効果が向上した」ことを意味するわけではありません。Qwen-CUAはまだ、いつどちらの手を使うべきかを学んでいないため、これはRLHF/エージェント型RLの次の課題となっています。論文ではこれを成果として提示するのではなく、「最適化のギャップ」として直接記述しています。このような誠実さは、同僚の研究者にとって模範となるべきものです。
第四に、社内専用のプラグインは公開されていない。Qwen for Chromeはチーム内で動作しており、論文ではダウンロード開始日を公開することを約束していません。これは論文で詳細が記載されていない制約であり、モデルがどんなに優れていても、開発者の手に渡っていない限り、その影響力はただの数字にすぎません。「今日から使えるか」を気にする読者にとって、論文は機能の上限を示すものですが、製品のリリーススケジュールを示すものではありません。
5つ目に、1Tのパラメータを持つMaxモデルは軽く触れられただけです。論文では、トレーニングコスト、推論遅延、Maxとベーシック版のギャップ分析についての章は別途設けられていません。エンジニアリングの観点から見ると、1Tは大規模モデル時代の「小さなアップグレード」ですが、RLのトレーニングコスト、KVキャッシュの占有量、長いトレースの推論にかかるメモリ圧力などは具体的に明らかにされていません。Maxの結果を再現するには、論文で提供された情報だけでは不十分です。
一言でまとめると
AI に画面を見せたり、マウスやキーボードを操作させるだけで、実際に作業をこなせるようになります。8 つのベンチマークすべてで前任者を上回っており、クローズドソースの強い競争相手とも互角の戦いができます。しかし、それで実用化されるわけではありません。16.4%の被だま率は変わっておらず、ピクセルベースのアプローチは高価で時間がかかり、ツールを組み合わせても、いつ使うかを選ぶことができません。Qwen-CUA が示したのは、終点ではなく、「汎用視覚層」をハイブリッドエージェントの基本コンポーネントとして利用するというコンセプトのエンジニアリング実証でした。
論文:Qwen-CUA:(ほぼ)全てのことに利用できるネイティブコンピュータ arXiv:https://arxiv.org/abs/2608.02352 プロジェクトホームページ:https://github.com/xlang-ai/Qwen-CUA