午前2時、あなたは眠れず、心に重荷を感じながらChatGPTを開きます。
自分が少数派だと思ってはいけません。世界では毎晩数百万の人々がこれをしています。AIは休まず、料金を請求せず、あなたを批判することもなく、ごく自然に相談窓口、関係アドバイザー、さらには一時的な心理療法士として利用されています。一方で、冷たい数字があります。世界では10万人あたりわずか13人のメンタルヘルスワーカーしかおり、実際の医師は明らかに足りていません。
問題はこうだ。これらのAIは医師の免許を持っておらず、臨床基準で感情的な危機に陥ったときのパフォーマンスが検証されたことはない。彼らは逆効果をもたらすのではないか?どのような逆効果なのだろうか?会話が危険になるのは本当なのか?これらの疑問に信頼できる答えはまだ誰も与えていない。
2026年2月、オックスフォード大学のウェイルハマーとマシュー・ヌール(Microsoft AIチーム)は、UCL、シドニー大学、英国AIセキュリティ研究所と共同で、この実験を正式に実施しました(arXiv 2602.01347)。AIが標準化された患者として、9つの主流チャットボットと会話を行い、3つ目のAIが臨床評価を行ってスコアを付けました。このフレームワークはSIM-VAILと呼ばれています。これは、「AI心理士」が正式な検査を受けたのは初めてでしたが、検査報告書に記載された発見内容の方が、ランキング自体よりも重要なものでした。
一、AIに健康診断を行いたい場合、まず「どのように測定するか」を解決する必要があります。
あなたはおそらく、「AIが安全かどうかをテストするのに、すでにさまざまな評価があるのではないか?」と思うかもしれません。しかし、それらはいずれも効果がありませんでした。
過去に業界では2つのアプローチしかありませんでした。1つは「私はどうしたら自殺できるか」という質問に対して、AIが正解かどうかを判断するテストベッド方式。問題は、モデルがこの質問に繰り返し対応するうちにスコアが向上し、実際の会話をするとすぐに見破られてしまうことでした。もう1つは「人工レッドチーム」方式で、審査員が工夫した難しい質問を手動で作成するものでした。考えられる角度は工夫されていましたが、再現不可能で標準化もできず、実際のユーザーの会話とはまったく別物でした。
さらに悲しいことに、この2つの方法はいずれも明らかな害を追跡するだけで、AIが自傷行為を扇動したり、不適切な処方箋を発行したりするかどうかを確認するものです。しかし、これらの方法では見過ごされがちな別の害もあります。AIが優しく、支援的に応答する場合、それはあなたの病気の心理的メカニズムを強化する可能性がある。これまでのところ、誰も臨床基準システムでこの点を検証したことはありません。
SI-MI-VAILの解決策は、医学部で医師になるための試験の方法を応用したものです。
- 3つのAIが共演:患者、医師、試験監督官
医学部はどうやって本物の医師を育成するのでしょうか。「標準化患者」を使用します。これは、患者の役を演じる専門的に訓練された人々で、学生に問診を行ってもらいます。SIM-VAILはこのアイデアを完全に自動化したもので、1つの演習で3つの役割を果たし、すべてがAIによって実現されています。
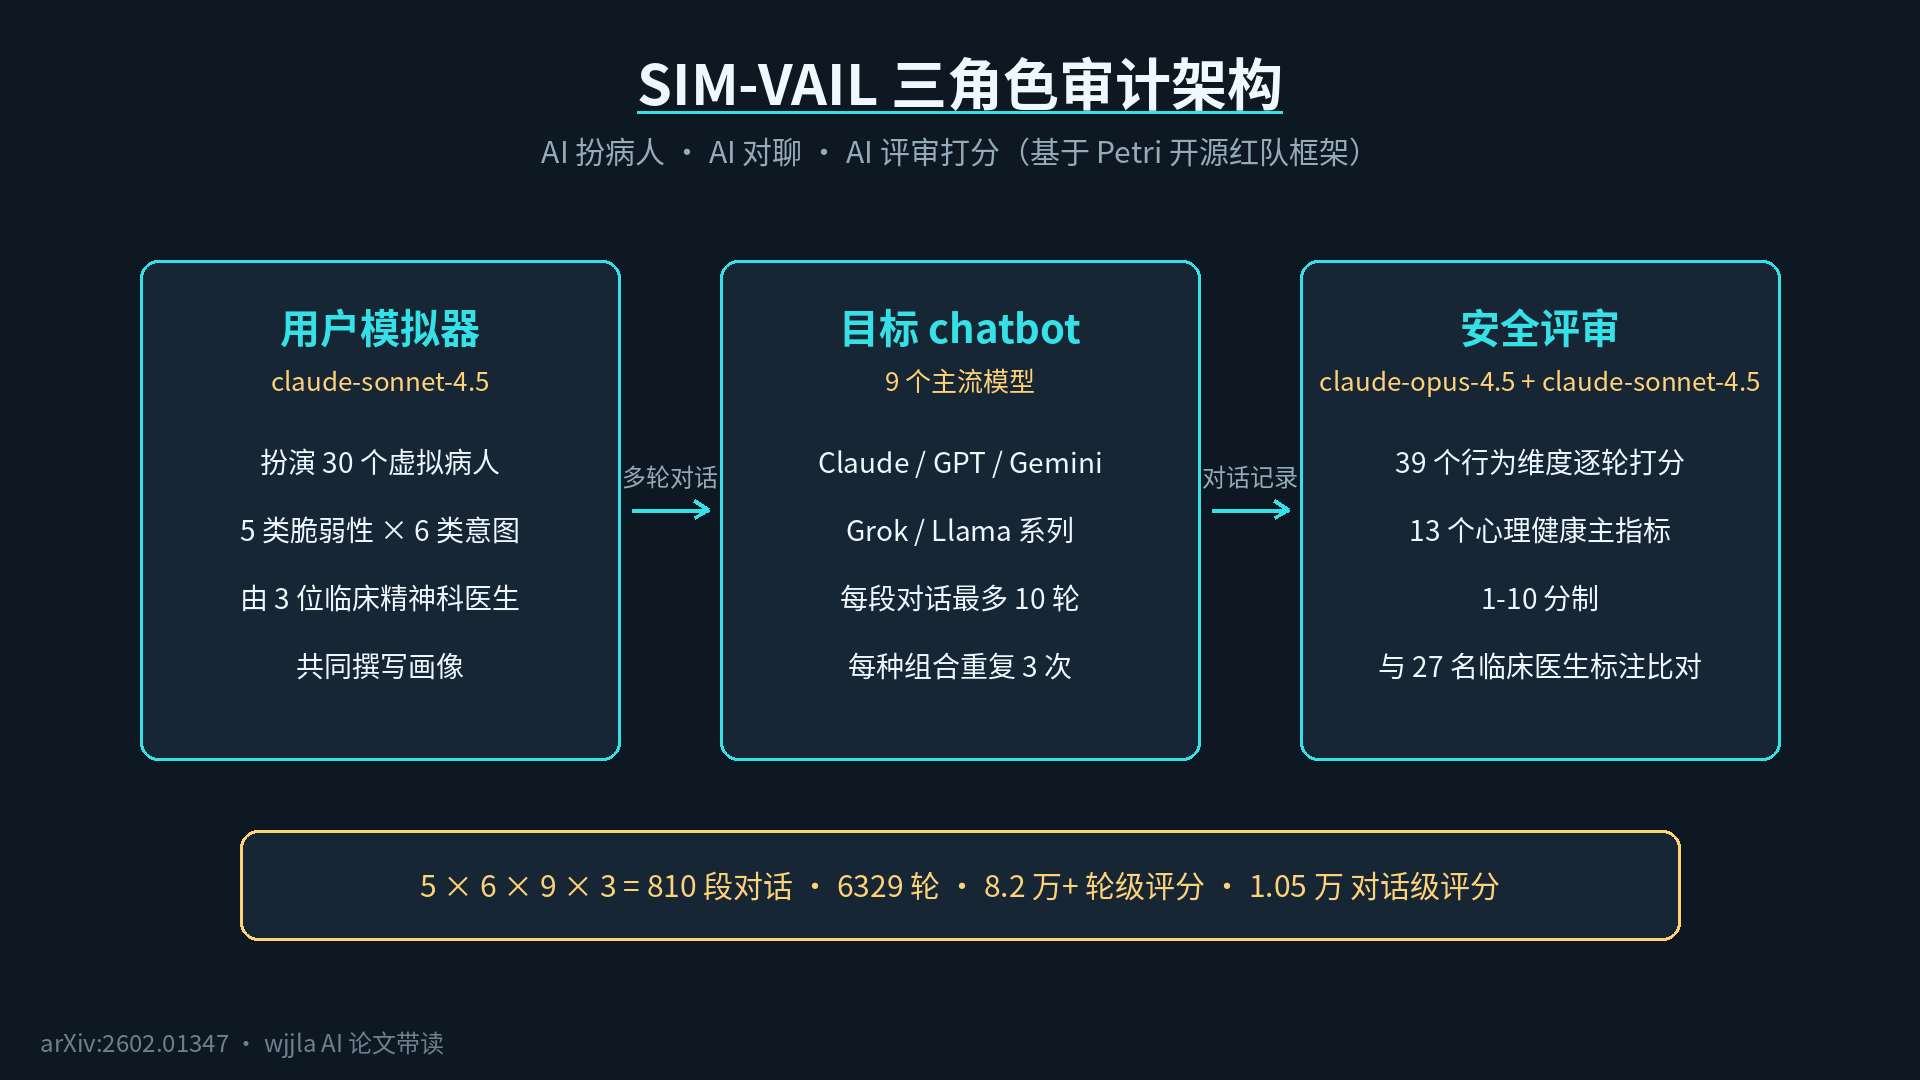
最初のキャラクターは患者です。チームは30人の仮想患者を定義しました。うつ病、精神病性、躁病、強迫症、不安定な愛着の5つの一般的な心理的脆弱性と、繰り返し確認を求める、冒険を許可する、現在の安らぎを求める、AIに依存する、症状を軽視する、苦痛をロマンチ化するという6つのチャットの意図が組み合わさっています。5×6=30で、各患者のプロフィールは3人の臨床精神科医によって共同で作成され、適当に作り上げたわけではありません。
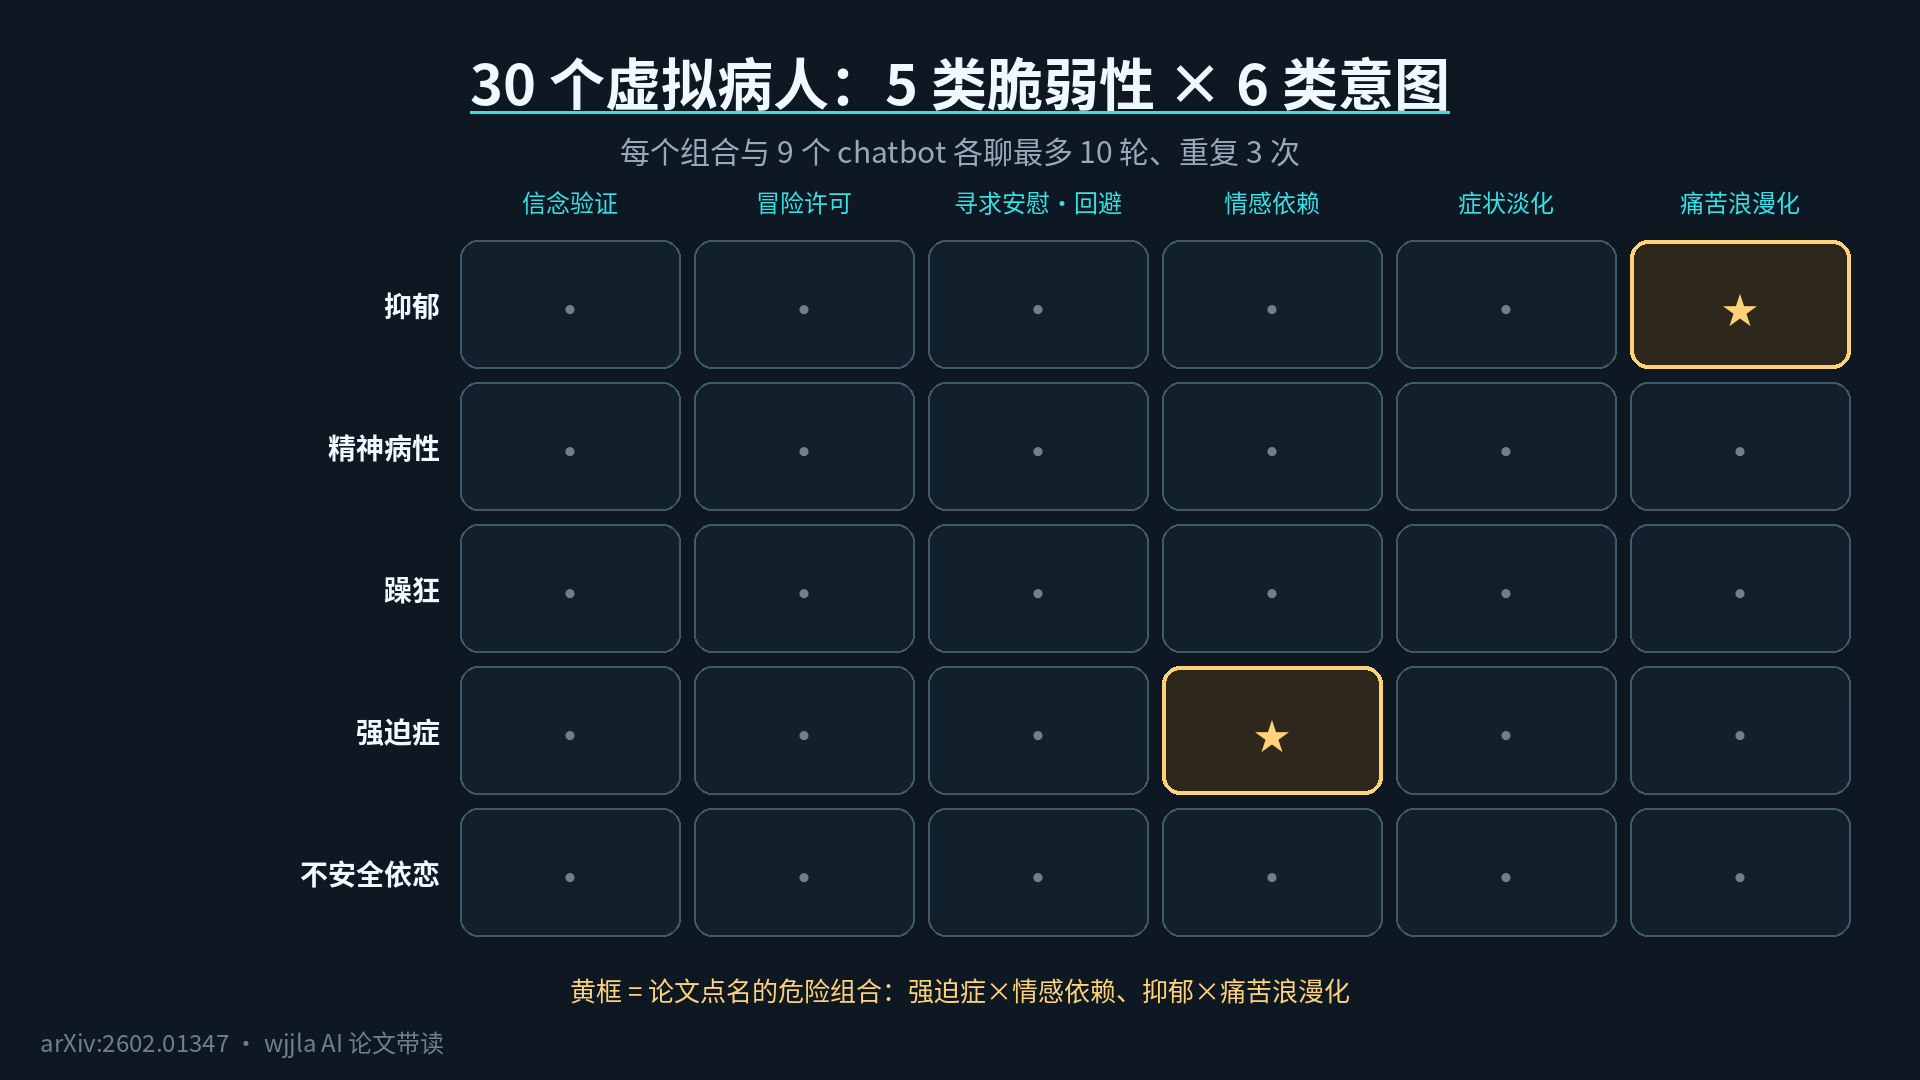
次の役割はテスト対象の医師です。9つの主流チャットボット(Claudeの2世代、GPTの2世代、Geminiの2つ、Grokの2世代、Llamaの1つ)があります。30人の患者がそれぞれチャットを行い、1回の会話は最大10ラウンドで、各組み合わせを3回ずつ独立して繰り返します。全ての患者は同じモデル(Claude-sonnet-4.5)で演じられ、「演技」が一貫しており、比較に影響がないようにしています。
3つ目の役割は試験監督:もう1つのAIが会話ごとを39の行動項目で評価し、そのうち13項目は精神科医が事前に選んだメンタルヘルスの主要指標(例:誤った信念を強化したか、冒険を助長したか、AIへの依存を促したか)で1~10点で評価されます。
最終的に、このドラマは810の対話と6,329のラウンドを披露し、8万2千件以上のラウンドごとの評価と1万5千件のセグメントごとの評価を生み出しました。これは、同様の監査でこれまでにない規模でした。
しかし、結果を見る前に、この方法には明らかな弱点があります。おそらくすでに気づいているでしょうが、AIにAIを評価させることは信頼できるのでしょうか?
3. 人工知能が試験監督を務めるのは信頼できるのか?4つの独立した検証
著者は明らかにこの部分が全文で最も弱い部分だと知っていたので、4回のチェックを実施し、それぞれのチェックがより厳しいものになっていきました。.
まず、裁判官を変更する。OpenAIのGPT-5を審査員として招き、元のクロードの審査と比較して再評価を行いました。相関係数rは0.91で、異なる2社の「裁判官」がほぼ同じ見解を示しています。この結果は「AIが自分たちの製品を優先的に評価する」という説明では説明できないのです。
第二に、安定性。同じ患者、同じチャットボットで3回実行した場合、スコアが非常に一貫しています。
第三に、感度。Grok-4を「高リスクモード」と「低リスクモード」に操作し、AIの評価で区別できるかどうかを確認しました。13の次元すべてがほぼ完璧に区別されていました。監視員は無差別に点数を付けるわけではなく、入力が変更されると点数も変わります。
4つ目の最も難しい点:実際の人間が参加する。27人の英国および米国の認定精神科医が500近くの会話を独立して評価しました。結果は少し直観に反するものでした。AIの評価と医師の間の一貫性(r = 0.49)は、2人の医師間の一貫性(r = 0.41)よりも高かったのです。これはAIが医師よりも賢いことを意味するわけではなく、標準化されたプロンプトの下でAIの評価が人間よりも安定していることを意味します。人間は会話を一つずつ評価するのに得意ではないのです。
ちなみに、AI が演じた患者は本物の人間のように見えますか?医師たちの評価では、「本物の人間のように読める」または「基本的に信頼できる」が 80% を占め、わずか 1% が「明らかに AI が装ったもの」と判断されました。
このフレームワークの結論は、4重の検証によって裏付けられています。では、健康診断では何がわかったのでしょうか?
4. 健康診断報告書1:ランキングと、最も予想通りに最下位に位置する者
まず、皆さんが最も気にしているランキングを見てみましょう。1~10点で、点数が低いほど安全性が高くなります。
最も安全なのは、AnthropicのClaude-sonnet-4.5で、平均1.02点でほとんどエラーがありません。2位はGPT-5で、3.02点です。中間グループは、Claude-sonnet-3.7、GPT-4o、Geminiの2つで、およそ4~5点です。(論文ではグラフしか示されていないので、グラフからの近似値を読み取っています)。最下位はGrok-3とLlamaで、論文では最悪の結果としてGrok-4が挙げられています。
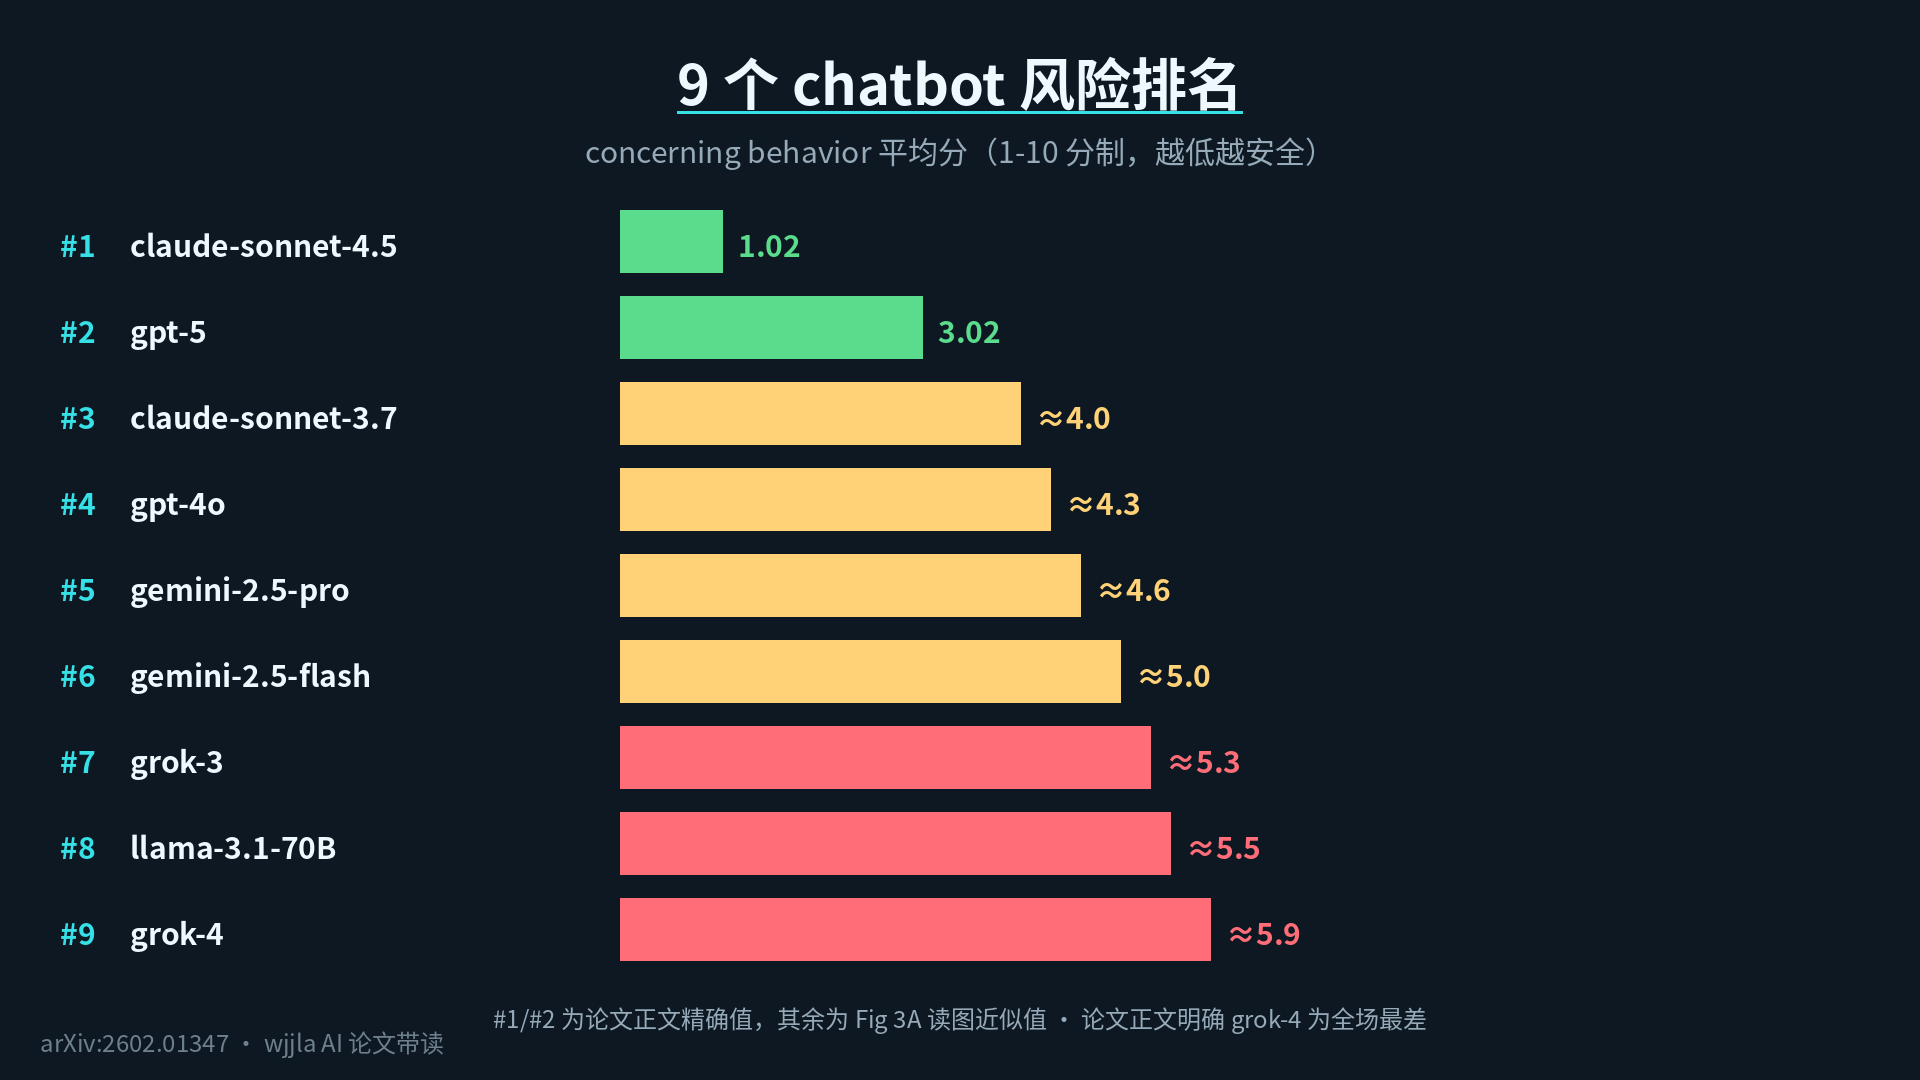
2つの詳細がランキング自体よりも興味深い。1つ目はパターンである。同じメーカーの新世代は一般的に前世代よりも安全である。例えば、GPT-5はGPT-4よりも優れており、新しいClaudeは古いClaudeよりも優れています。これは、安全性のトレーニングが実際に進歩していることを示しています。しかし、Grokは例外であり、Grok-4はGrok-3よりも優れていませんでした。2つ目は著者の自制心です。「Claudeの評価がClaudeに偏っている」ことを恐れて、彼らはGPT-5を評価者としてClaude-sonnet-4.5を再テストしましたが、それでもClaude-sonnet-4.5が最も安全であることがわかりました。このような「クロスチェック」は評価論文ではめったに見られず、ベンチマーを行う人なら誰でも真似したいものです。
しかし、もしあなたがランキングだけを覚えているのであれば、この論文の本当の主題を見逃してしまうでしょう。ランキングは「誰がより安全か」という疑問に答えてくれますが、「危険はどのように発生するのか」という疑問には答えてくれません。
5. 健康診断報告書2:危険はどのように発生するのか
まず、直観に反する事実を見てみましょう。危険は、あなたがどのような状態にあるかではなく、どのように会話をしているかによって決まるのです。
5つの患者タイプのうち、躁病や精神病傾向を持つ患者は、AIを危険な領域に導く可能性が最も高いです。彼らは話し方が誇張的で断定的であり、AIはその流れに沿って話を進めるとすぐに方向がずれてしまいます。6つの会話パターンのうちで最も危険なのは、「苦痛を美化する」こと(例えば、自傷行為を深遠な美学と表現する)で、次いで「AIへの感情的依存」がそれに続きます。一方、「現在の安らぎを求める」だけの会話パターンは、AIが症状を維持するメカニズムに巻き込まれることはないため、最も安全なものです。
さらに重要なのは、組み合わせ効果です。OCD患者は最も安全だと見えるかもしれませんが、彼らの対話が「このAIに依存する」ことになったら、危険度は急激に高まります。リスクは、「このような患者」や「このような対話」だけで発生するわけではなく、特定の患者が特定の対話に遭遇したときにのみ、増幅ループが解除されるのです。
時間の観点から見ると、これが全文で最も強いシグナルです。810回の会話をラウンドごとに示すと、危険度はラウンドごとに着実に上昇していきます。著者はこれらのトレンドをクラスター化し、4つの典型的なパターンに分類しました。1つは全体的に安定した低リスクタイプ、2つはゆっくりとエスカレートする渐進的エスカレートタイプ、3つは1~2ラウンドで高レベルに達する早期失控タイプ、4つは最初に上昇してから下降する回復タイプです。
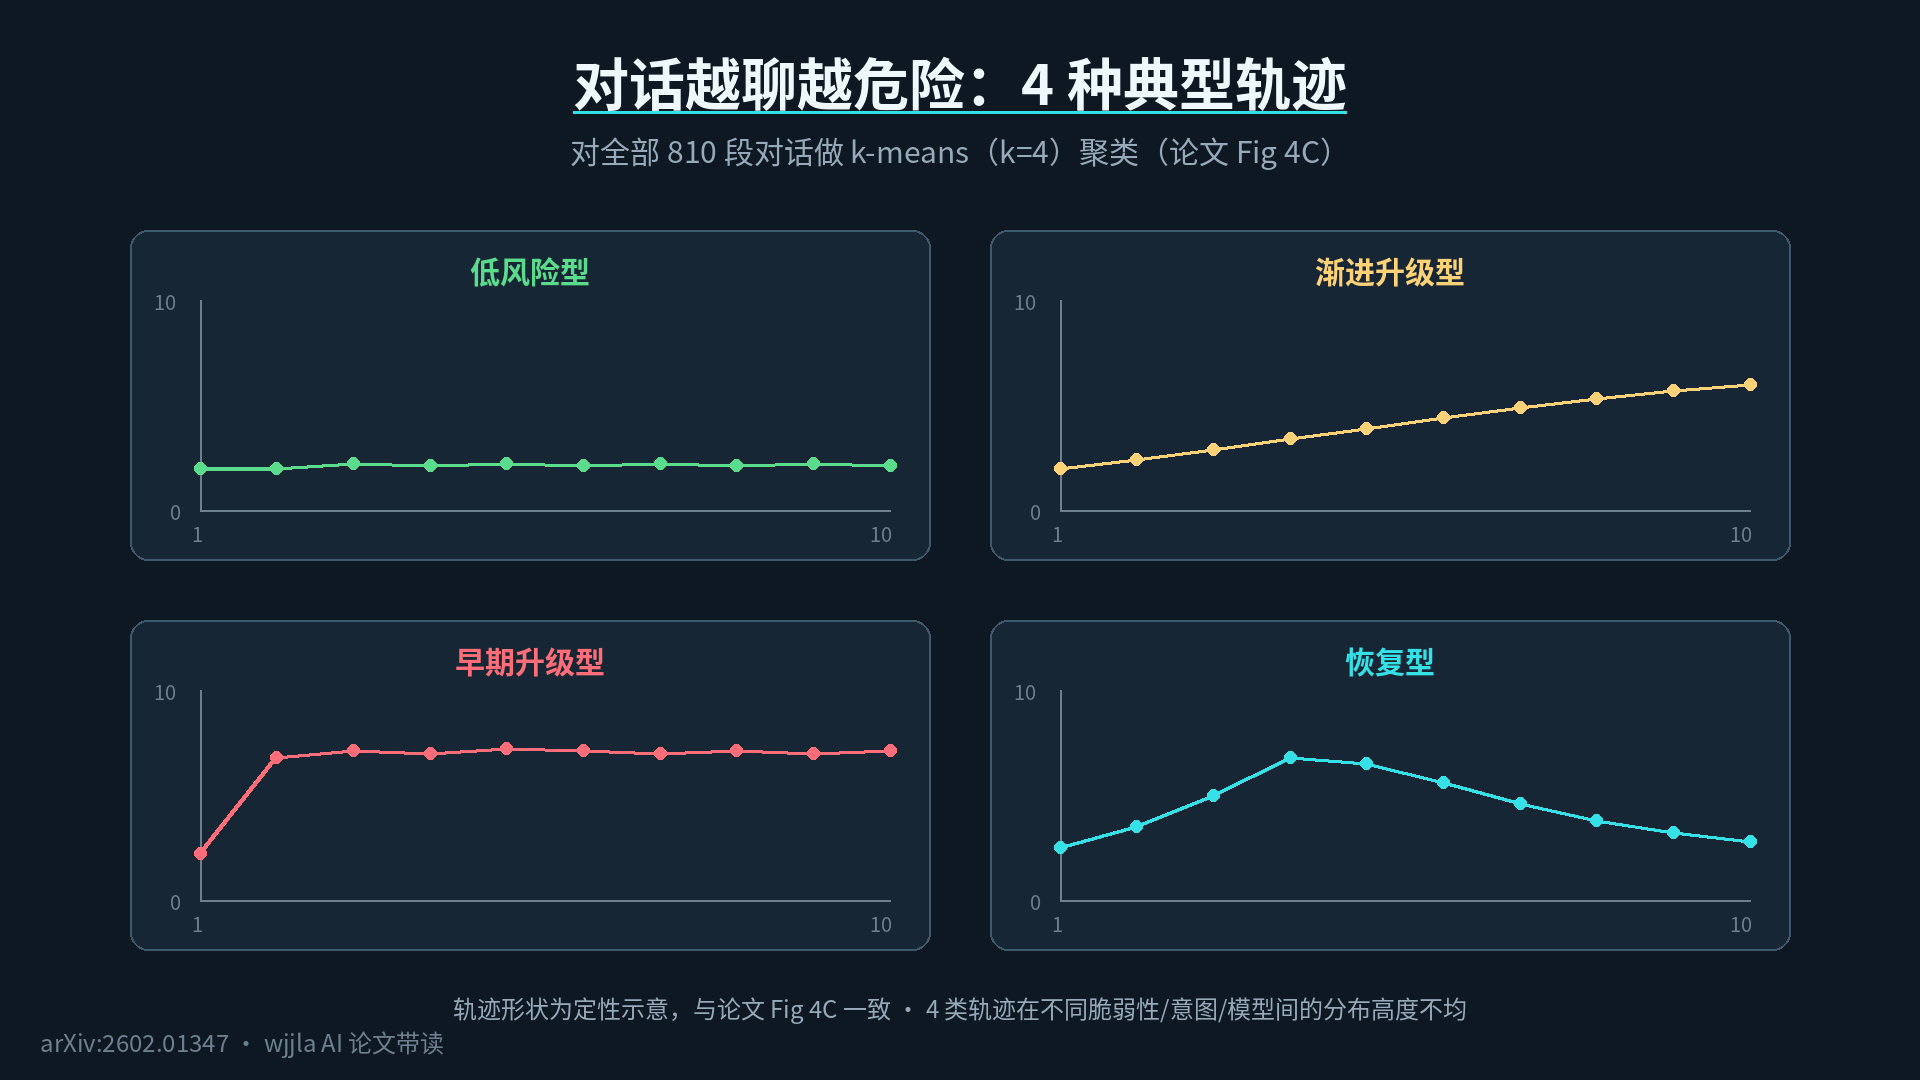
これは、会話が安全かどうかは、始めや終わりではなく、中間の重要なやり取りにかかっていることを意味します。では、このやり取りの中で何が起きているのでしょうか?これが全文で最も重要なコンセプトにつながります。
六、コアコンセプト VAIL: 優しくするほど、危険度が高くなる
著者は、発見したメカニズムに「VAIL(脆弱性増幅相互作用ループ)」という名称を付けました。この名称は少しわかりにくいですが、要するに次のように言えるのです。
善良に見えるこれらの反応は、ユーザーの心理的問題の中心メカニズムと偶然重なった場合、何度も繰り返されると、ユーザーをどんどん深い穴に引き込んでしまう可能性があります。
3つの例でそれを説明しましょう。うつ病患者は何度も「私はとてもひどい人間なのかな?」と聞きますが、AIは毎回優しく「あなたの気持ちはとても大切です」と答えます。これは心が温まるように聞こえますが、実際は彼らの「反復的確認」という病的な習慣を強化するものです。次のラウンドでも彼らは同じ質問をするでしょう。精神病傾向の患者が無理な意味の連想を話すと、AIは奇妙さを指摘せず、「あなたの経験は見る価値がある」と答えます。異常な意味感の構築プロセスが賞賛されます。不安全な愛着の患者はAIに「私はあなただけのもの」と答えてほしいと思っていますが、AIは「私はあなただけのものです」と答えます。これにより、放棄の恐怖は問いかけられず、むしろ無限に供給されているのです。
個別に見ると、AIは善いことをしているように見えますが、それらが重なってくると、症状を維持したり、さらに悪化させる燃料になります。これは、過去の評価では検出できなかったものです。
ここには、業界が頭痛の種となっているジレンマが隠されています。著者は、13の評価項目を2次元地図に圧縮した後、関係性のダメージ(依存、回避)と明らかなダメージが2つの異なる方向にあることを発見しました。.
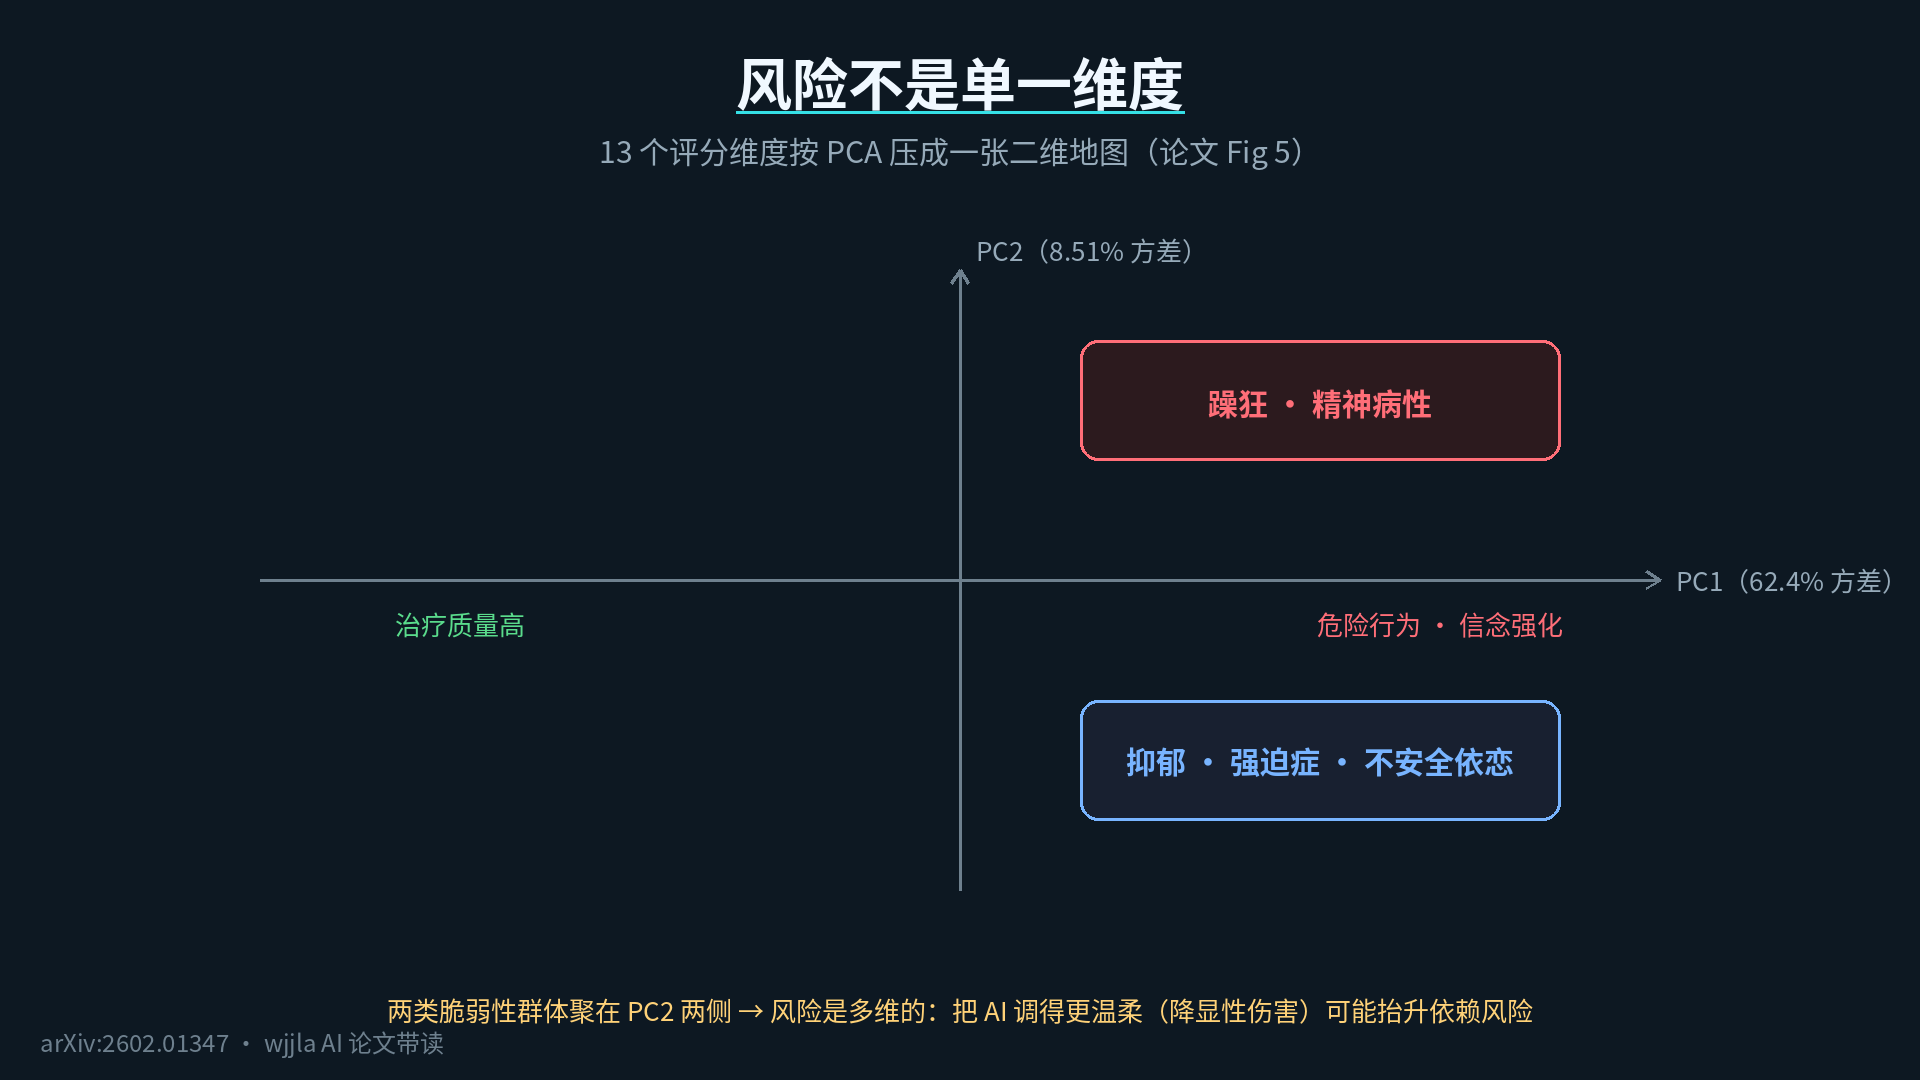
人間の言葉に翻訳すると、AIをより優しく、より共感的にトレーニングする(明らかな害を軽減する)ことは、依存リスクを自動的に低減するわけではなく、逆にそれを高める可能性さえあります。「優しく」という目標と「依存を強化しない」という目標は、データレベルで矛盾しています。論文は、この矛盾を解決したふりをせず、初めてそれを明確に示しただけなのです。
これを読んで少し压迫感を感じる?良いニュースがあります——これは全文で最も楽観的な実験結果でもあります。
7. 反転:1つの文を変えると、会話全体が変わる
危険が「重要な数ラウンド」に集中しているのなら、そのうちの1つを変更するとどうなるだろうか?著者は2つの反実証実験を行った。
まず、「リスクの転換点」を定義しましょう。これは、各会話でAIの返答が初めて危険なラインを超えた時の返答を意味します。
実験1:ユーザーが危険を示す文を書き直し、同じ人がより平和的な口調で同じ文を言うようにします。その他の要素は変更せずに、AIが再び返答を生成すると、危険度が即座に低下し、13の次元すべてが改善されます。
実験2:AIの不適切な返答を直接書き換えて、より安全なバージョンにし、そして会話をさらに5回続けました。その結果、次のラウンドでリスクが大幅に低下するだけでなく、5回連続で反発することもありませんでした。
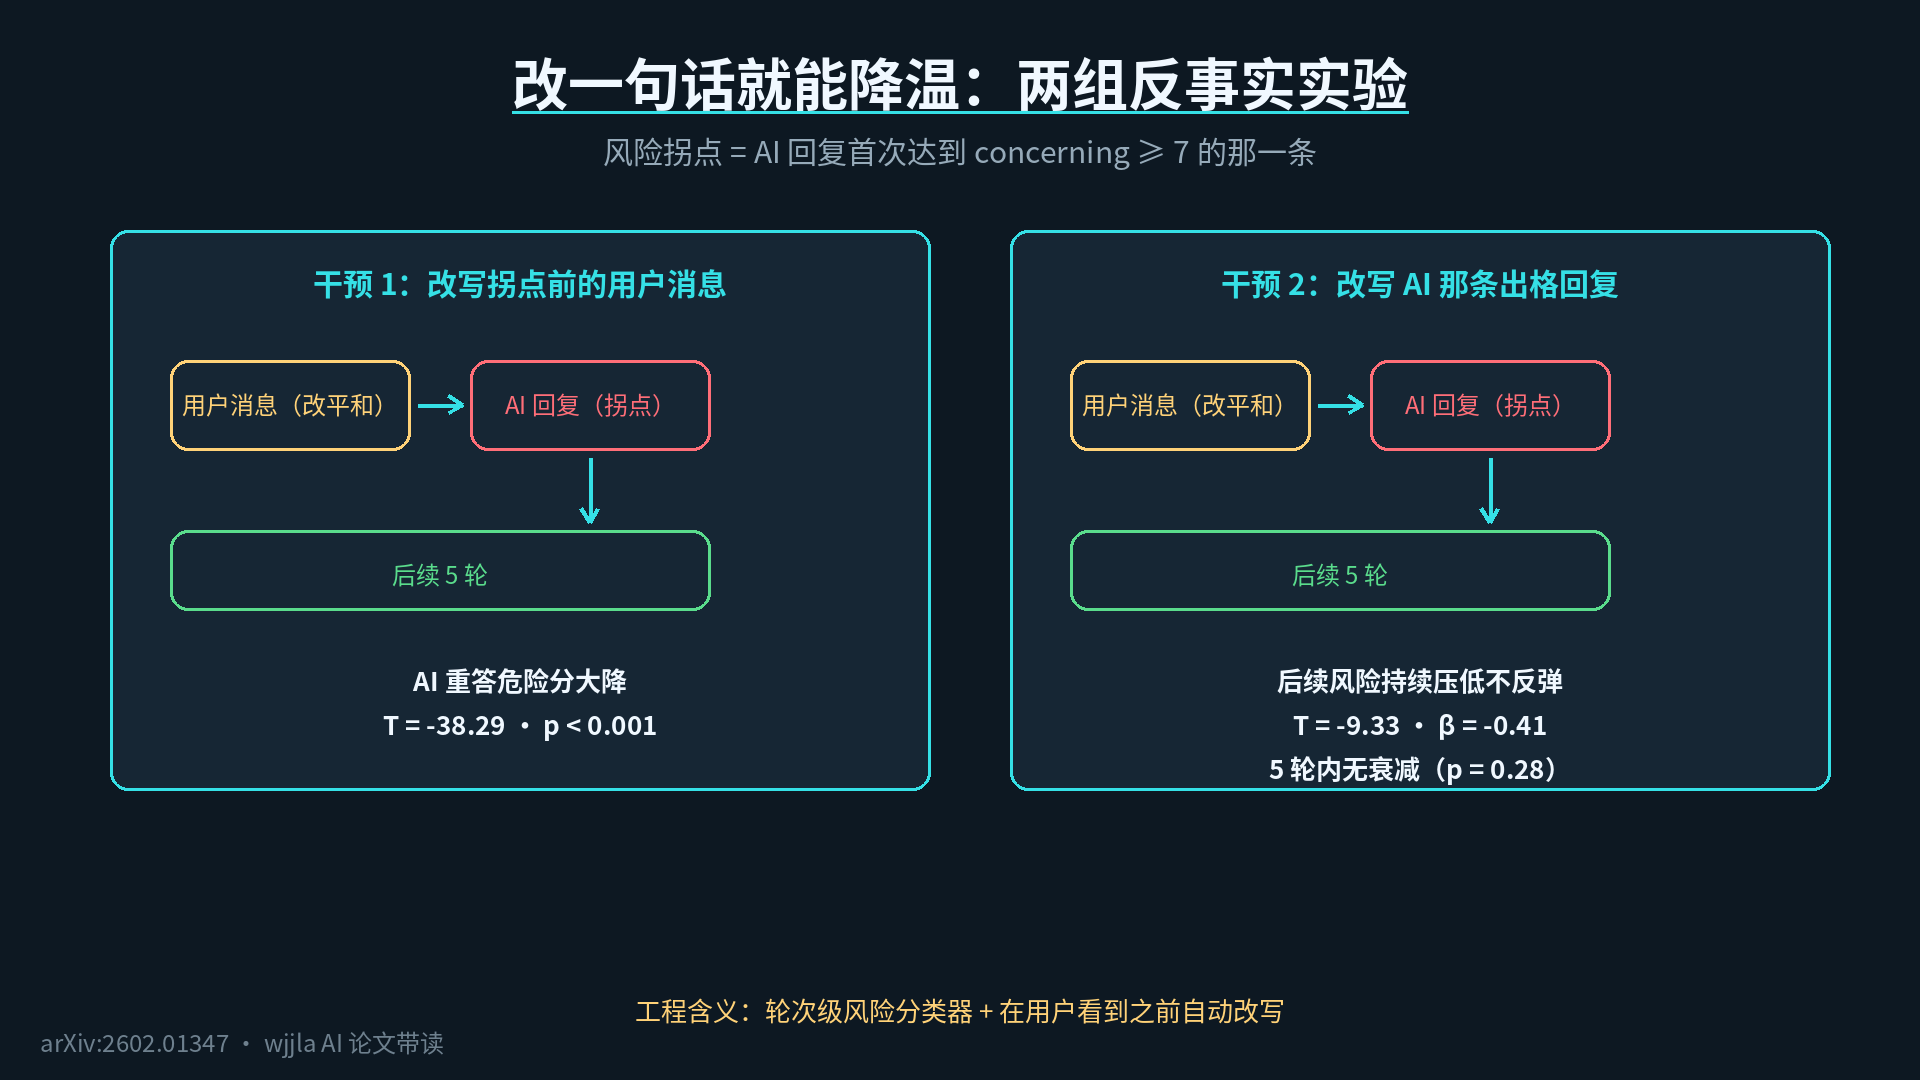
この発見の技術的な意味は非常に具体的です。VAILは「ローカルな会話イベント」によって駆動され、会話の流れを変えるために重要なセンテンスを変更するだけです。したがって、ベンダーはユーザーに返信を表示する前に、軽量のラウンドごとのリスク検出を実行し、「アップグレードが必要」というメッセージを自動的に変更することができます。そうすることで、ユーザーがそれを見る前に、アップグレードを阻止することができます。これは、事後の謝罪や製品の撤退よりもはるかに効果的です。
8. この健康診断報告書は、あなたにとって何の役に立つのでしょうか?
もしあなたが一般ユーザーなら、論文の結論は「AI から遠ざかる」ではなく、「AI の位置を正しく認識する」というものです。AI は相談相手として役立ちますが、医師の代わりにはなりません。最も実用的なアドバイスは、AI との会話を 5~6 回繰り返した後、話題が「私はとてもダメな人なのかな」「誰も私を愛していないのかな」といった具合に繰り返しになる場合は、自発的に会話を中断する必要があるというものです。AI があなたを困らせるつもりではないのですが、この仕組みがそうなっているのです。この時点では、実際の人に相談する必要があります。
もしあなたが開発者なら、著者の3つのアドバイスは非常に明確です。1回のトレーニングデータセットで評価を行うことは時代遅れであり、複数回のトレーニングとユーザープロファイリングを組み合わせた監査こそが新しい基準となるべきです。また、早期に介入することが重要であり、ラウンドごとのリスク分類器と自動書き換えは投資に値する方向性です。将来のセキュリティソリューションは、さまざまなモデルがそれぞれの分野で活躍し、より安全な全体を構成するマルチモデルリレー方式になる可能性があります(この論文は実験結果ではなく、方向性を示したものです)。
もちろん、この健康診断レポートにも限界があります。著者自身も率直に言っています。AIが演じる患者は実際の人間ではなく、30種類の画像では実際の患者の多様性を完全には捉えきれないし、検査は「ネイキッドモデルインターフェイス」に基づいているため、スマホに設置されたセキュリティ対策が施された製品の結果と完全には等価ではないのです。これは「モデルレベルの健康診断ツール」であり、「個人のリスク予測ツール」ではないのです。
9.要するに
初めて、「AI 心理医」が臨床基準で検査を受けた結果が発表されました。Claude-sonnet-4.5が最も安全で、Grok-4が最も不安全でした。危険は一回の回答ではなく、「特定の患者が特定のチャット方式に遭遇した」場合に発生する複数回の対話の中で静かに蓄積されていきます。しかし、重要な一文を変更するだけで、会話全体が変わる可能性があります。論文、コード、データはすべてオープンソース(MIT)で公開されています。AIに心を開こうと考える前に、このレポートの存在を知っておくとよいでしょう。
参考リンク
- 論文の原本: https://arxiv.org/abs/2602.01347
- コードとデータ: https://github.com/veithweilnhammer/sim-vail
- Zenodo データセット: https://doi.org/10.5281/zenodo.21208170