アリのQwenチームが2026年7月にarXivで公開した論文(2607.22529)の中心は、「スキルライブラリ」をLLMの自己対戦トレーニングのカリキュラムエンジンとして構築することです。この論文では専門用語を多く使っていませんが、何を解決しているのか、どのように解決しているのか、そして時間をかけて取り組む価値があるかどうかを確認することができます。
I. 問題の本当の焦点: 自己対戦トレーニングが「多様性」と「検証可能性」という二つの問題に行き詰まっている
過去2年間、LLMのトレーニングパラダイムは「人工ラベリング+SFT」から「自己進化」に切り替わりました。その中心的なアイデアは、モデルにトレーニングデータを自ら生成し、自分でスコアを付けるようにすることでした。しかし、この道を2026年まで歩んだ結果、非常に具体的な矛盾に直面してしまいました。。
- 環境に依存するルート(例えば、LLMにコードを書かせ、ユニットテストを実行させる): フィードバックは正確ですが、実行できるタスクの範囲が限られており、基本的にはプログラミングや数学の証明など、機械で検証できるシナリオに適しています。
- オープンエンドの自己生成ルート(LLMに問題を書かせ、LLMに自分で判定させる): タスクの範囲は広いものの、報酬の信号は信頼できません。モデルは「審判をごまかす」ことを簡単に学び、報酬がハッキングされると、トレーニングが崩れます。
この2つの問題は、産業界で失敗したケースの半分ずつを占めています。Skill Self-Play(以下、Skill-SPと略称)の切り口は、「スキル」が持つ自然な中間領域にあります。スキルとは、再利用可能な「構造化実行能力」であり、1つのタスクに対して十分な実行深度と検証可能性を備え、別のタスクに移行した場合には動的ルーティングによってカバー範囲を拡大することができます。
論文を読み終わった後に感じた最大のことは、「スキルは中間領域である」という哲学的な主張ではなく、スキルを実行可能なオブジェクトと見なし、RLフレームワークで更新、ルーティング、退役できるダイナミックライブラリとして実現していることです。この「抽象概念を操作可能なエンジニアリングオブジェクトに落とし込む」アプローチは、論文のタイトルで表現されている「能力の最前端」よりもはるかに実践的だと感じました。.
- 3つの役割:提案者/解決者/スキルコントローラ
Skill-SPのアーキテクチャは非常にシンプルで、中心となるのは3つのロールがRLループの中で共進化していくというものです。
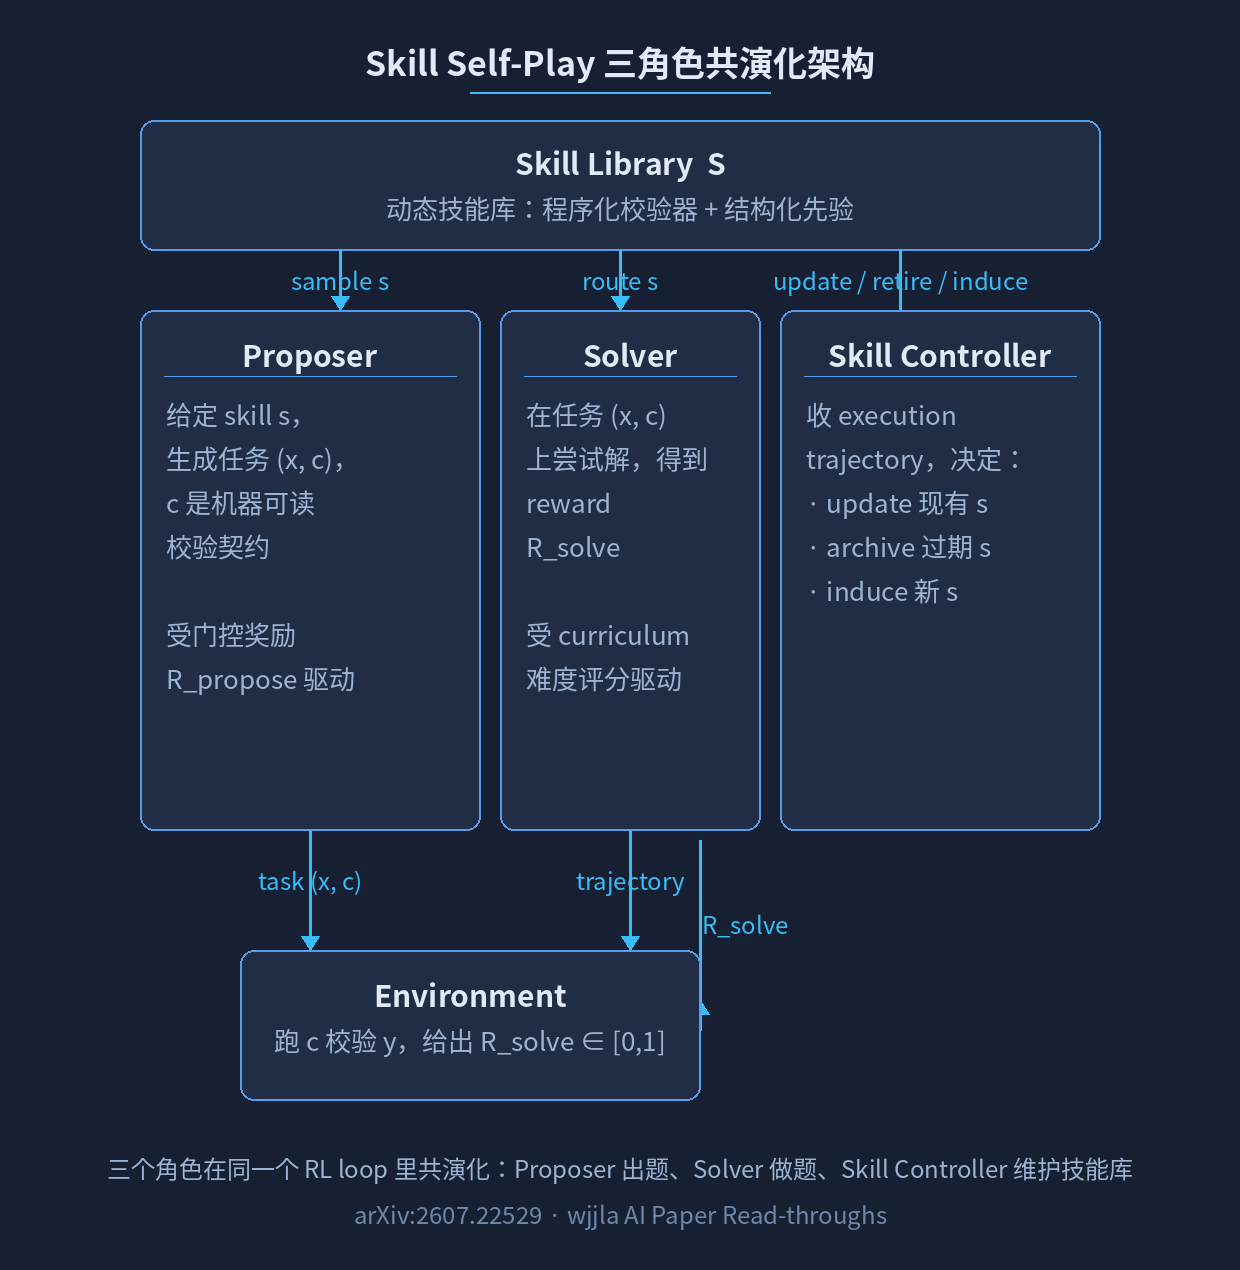
提案者は、スキルライブラリSからサンプリングしたスキルsを与えられた場合に、(プロンプトx、検証契約c)を合成するという、非常に焦点のあるタスクを実行します。契約cは機械で読み取れるものでなければなりませんが、論文ではユニットテストや参考回答が例として挙げられています。提案者が受け取る報酬は「タスクの難易度」ではなく、「ゲートドカリキュラム報酬」です。タスク契約(x,c)が構造的に合法である場合にのみ、「難易度が0.5に近い」としてスコアが付けられ、そうでない場合はスコアがゼロになります。このステップは、論文で強調されている重要な設計です。これにより、「報酬ハッキング」が明示的に防止されます。提案者が「超難しい問題を作ったふりをする」ことはできず、なぜなら、契約の検証が難易度のスコアリングよりも先に行われるためです。
Solverはより従来的なことを行っています。(x, c)が与えられた場合、答えyを生成し、環境はcを実行して検証し、R_solveを返します。Solverのトレーニング目標は、Proposerが出した問題でトレーニングを受けることです。ただし、Proposerが出す問題はランダムではなく、カリキュラムのスコアによってSolverの現在の「学習フロンティア」に導かれています(論文ではこのスコアを中程度の難易度スコアと呼び、式は1 - 2|v_solve - 0.5|で、Solverの成功率が0.5に近づくように設定されています。これは、モデルが「努力すれば正解できる」範囲とほぼ一致しています)。
スキルコントローラはこの論文で最も興味深いエンジニアリング設計であり、静的なスキルリストではなく、動的にメンテナンスされるライブラリです。3つの操作が可能です:
1.更新: ソルバーの特定のスキルに関する実行トレジェクトリに基づいて、そのスキルの検証ロジックを改善する(例えば、境界ケースのテストを追加する)。 2.アーカイブ: 何轮連続しても誰もトリガーしないスキルは、有効期限が切れたとマークされ、メインリポジトリから削除される。 3.誘導: オープンソースのリポジトリから新しい再利用可能な構造を発見し、自動的に新しいスキルにパッケージ化してリポジトリに追加する。
論文内の実験結果:5回の反復後、有効なスキル数(シャノンエントロピーで加重)は1から46に増え、アクティブなスキル数は86になりました。これは、トレーニング中にスキルセットが実際に拡大していたことを意味し、プロポーザーが何度も同じ固定スキルに取り組んでいたわけではないのです。
III. 最も重要なエンジニアリング設計: スキルベースが「パターンの崩壊」にどう対抗するか
ゲーム理論トレーニングの古典的な失敗パターンは「モードコラプス」と呼ばれています。提案者が特定のスキルで出題した問題に対してソルバーが安定した反応を示すと、提案者はそのスキルを繰り返し使用し、トレーニングデータの分布がいくつかの高頻度スキルに狭まっていきます。Skill-SPはこの点で3つの保護機能を備えています:
3.1デュアルストリームサンプリング(dualstream)
100%スキルライブラリからのタスクではない。論文の実際の割合(図4のアブレーション実験から導き出された):
- スキル・ストリーム: スキル・バンクSからスキルsをサンプリングし、Proposerはそれを中心にタスクを生成します。この部分は「Solverの最前線で難易度を安定させる」ことを担当しています。
- エクスプローレーション・ストリーム: スキルにバインドされず、Proposerは自由にタスクを生成します。これにより、タスクの多様性が維持され、崩壊が防止されます。
実際のテスト結果では、論文で正確な数値を見つけることはできませんでしたが、メルトダウンは次のように示しています。スキルのみのトレーニング(100%スキルストリーム)では平均で4.1ポイント減、Unguided SPのみのトレーニング(0%スキルストリーム)では平均で2.6ポイント減、混合ストリームのみ(混合比は非公開ですが、論文のタイトルから両方が存在することが示されています)では安定して向上しています。これは、Skill-SPがオープンエンドのゲームプレイを排除するのではなく、スキルを「調整弁」として機能させ、タスクの難易度と多様性のバランスをコントロールしていることを示しています。
3.2 難易度スコアのゲーティング(カリキュラム報酬のゲーティング)
これは論文の中で最も重要な数学の部分なので、別途取り上げておきましょう。
プロポーザーの報酬関数R_proposeは、単純に「難しいほどよい」というものではなく、次のようになっています。
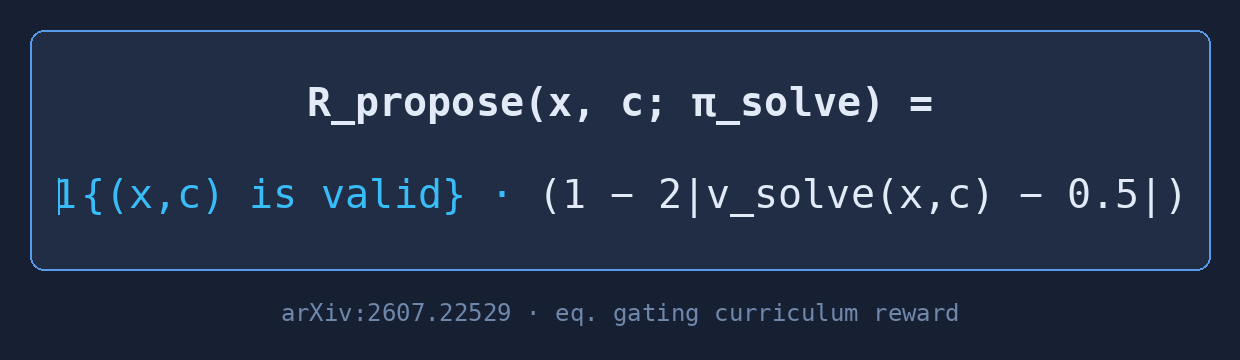
最初の項目「𝟙{(x,c) is valid}」は二項フィルタです。タスク契約(x,c)が構文的に正しい場合にのみスコアが付きます(マシンはcの検証を実行できます)。そうでない場合、R_proposeは0になります。2つ目の項目は中程度の難易度のスコアで、v_solve - 0.5の絶対値が小さいほどスコアが高くなります。つまり、Proposerが出した問題によって、Solverの現在の成功率が0.5の近くにある場合に高いスコアが付きます。
なぜ0.5なのか、0.1(非常に難しい)や0.9(非常に簡単)ではないのか?それは以下のためである。
- 難しすぎる(v_solve ≈ 0):ソルバーは学習信号を受け取れず、報酬のノイズが大きくなる。
- 簡単すぎる(v_solve ≈ 1):何も学べず、問題を解くのと同じことになる。
- 0.5 は「もう少し努力すれば正解が取れる」という最適なバランスで、RL が最も迅速に収束する。
ゲートは重要です。それがなければ、Proposerは「複雑に見えるが実際は何の意味もない問題」を作るようになってしまい、報酬がゼロになることで実際の問題を作ることを余儀なくされます。これが論文のタイトルである「Co-Evolving Skills」の意味です。つまり、スキルのライブラリだけが進化するのではなく、Proposer、Skill、Solverの3者が互いに「指導」し合いながら進化していくのです。
3.3 Skill Controller の具体的な実装方法
論文では完全なコードは提供されていません(Qwenチームの特許保護のため)が、3つの操作については概要が示されています。
- 更新: スキルパック = (実行可能なテンプレート、検証コード、いくつかのサンプル) の3つの要素。コントローラはこのスキルのトラジェクトリをSolverから受け取り、失敗パターンが特定の境界に集中している場合には、自動的にテストケースを追加します。
- アーカイブ: 「クーリングキュー」を維持し、Nラウンド連続でProposerによってサンプル化されなかったスキルをアーカイブに移動し、メインリポジトリの容量を確保します(Nの具体的な値は不明)。
- 誘導: このステップが最も興味深いものです。コントローラは軽量クラスタリングを実行し(all-MiniLM-L6-v2 + PCAを使用、図5b参照)、探索ストリームで生成された高頻度の「プログラム構造」(例えば、「常にリストを重複排除してソートする」)を新しいスキルパックに自動的にクラスタリングします。
この Induce リンクは、「データの分布から再利用可能な事前知識を自動的に発見する」ことを工学的に実現しています。これは、従来の RL におけるオプション発見や階層的 RL と同じ発想ですが、LLM データの合成に適用されているため、2026 年の新しい見どころとなっています。
4. 実験データ: 誰が利益を得るのか、誰が得られないのか
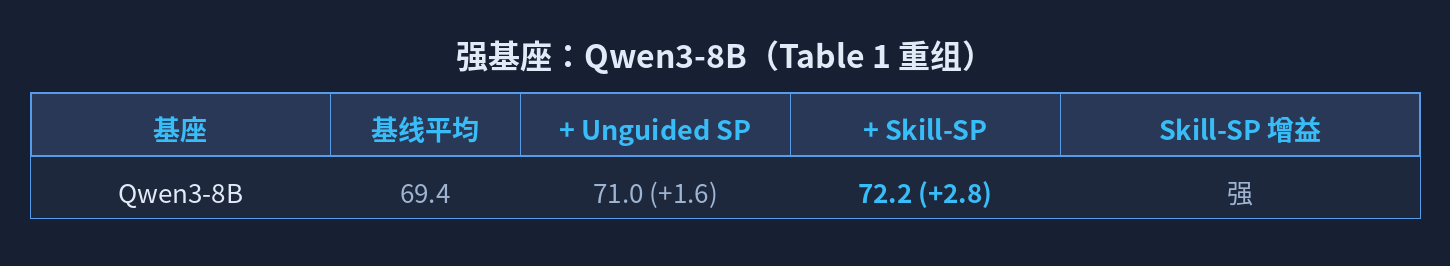
論文では、2つの分野で評価を行っています。1つはツールの呼び出し(API-BankとBFCLの4つのカテゴリ)、もう1つは論理推理(ZebraLogicの4つの難易度)。表1はコアデータであり、「ベースモデルの規模」に基づいて再編成してみましょう。
8B以上の強い基盤 (Qwen3-8B)
8B以下の弱い基板(本来すでにトレーニングが難しいミニストラル3-8Bのようなもの)
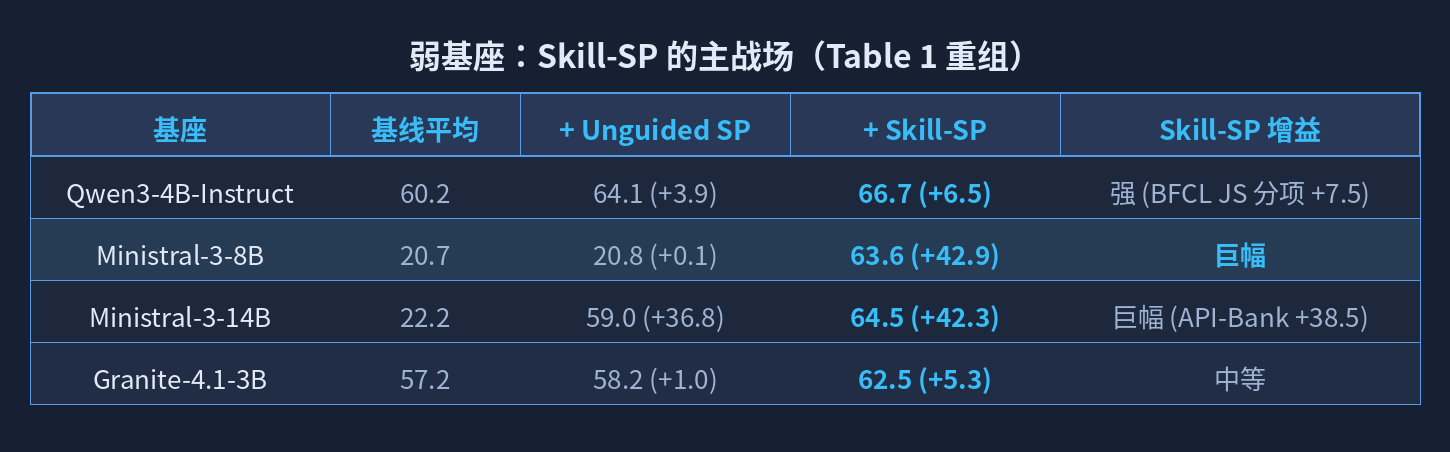
この表で最も興味深いのは、Ministral-3-8Bの行です。ベースはわずか20.7ポイント(基本的にツールを調整するのが苦手なレベル)、Unguided SPは全く役に立たない(+0.1)、しかしSkill-SPは63.6(+42.9)まで伸ばしています。これは、Ministralのような弱いベースは、「どんな問題を出すのか」すらわからないため、Unguided SPは自由に動作させると「無意味な問題」が出てくるからです。Skill-SPのスキルライブラリは、「どんなツールを使って問題を解決すべきか」という先入観を与え、カリキュラムの一層を追加するようなものです。
Qwen3-8Bのようなすでに強い基盤に対して、Skill-SPは(+2.8)で増加しますが、その増加量は明らかに小さいのです。これは産業界の直観を裏付けています。自己対戦トレーニングの限界利益は基盤と反比例です。つまり、弱い基盤はカリキュラムの指導が必要になるのに対し、強い基盤はより自給自足が可能です。Qwenチームは、Skill-SPの真のセールスポイントを「小型モデルの迅速な利用」に置いているのは偶然ではないのです。
5. 溶融実験:どの部品を切り取ると崩れるのか?
ペーパーの解析は比較的控えめに行われており、主に4つの側面から分析されています。
ハック 1: スキルルーティングなし (Unguided SP)
これはベースラインの比較で、すでに前述しています。小規模なモデルのシナリオでは基本的に増加はない(ミニストラル3-8Bで+0.1)、大規模なモデルのシナリオではわずかに増加(+1.6)します。結論:スキルルーティングがコアバリューであり、完全に削除すると通常の自己対戦に退化します。
ハック 2: スキルのみを使用 (100% スキルストリーム、ハック エクスプローレーション)
スキルのみのトレーニングでは、全ての基準で点数が下がり、平均で4.1ポイント下がりました。直観的な説明:既存のスキルのみをテストに使用すると、タスクの分布が徐々にいくつかの高頻度のスキルに狭まり、ソルバーはこれらのスキルに精通しますが、一般的な能力は低下します(典型的にはトレーニング分布への過適合)。
カット 3: 静的スキル ライブラリ (フローズン スキル)
フローズンスキル(スキルはトレーニング中に動的に進化しない)の平均点は2.3点です。これは、Skill Controllerの「更新」、「アーカイブ」、「誘導」という3つの機能が実際に機能していることを示しており、ただのデコレーションではないのです。
カット 4: 均一ルーティング (実行結果に基づく動的ルーティングではなく、均一なルーティング)
ユニフォームルーティングは平均で1.9ポイントとなっています。これは、動的ルーティング(コントローラが異なるスキルの実際のパフォーマンスに基づいて、どのスキルをよりトレーニングすべきかを決定する)が静的割り当てよりも効果的であることを示しています。
4つのメリットを1つの文にまとめると、「Skill-SPの各層の設計はすべてが必要であり、いずれかの層を削除すると効果が低下し、特に小型モデルの場合にはその影響が大きくなる」と言えるでしょう。
6.私が論文を読み終わった後で注意すべき点をいくつか挙げておきたい
(以下は、論文の内容に基づいて私が行った判断であり、すべてが論文自体によるものではない)
1. トレーニングにかかるコストは高い
論文ではGPU時間について具体的に言及していませんが、5回の反復処理×5つの異なる規模のトレーニングベース+デュアルタスクドメインでは、少なくとも数千時間のGPU時間が必要になると試算できます。これは個人開発者が直接再現できることではありません。自分でやりたい場合は、まず7Bクラスのモデルで1~2回のテストを実施し、スキルベースが安定して成長するかどうかを確認することをお勧めします。
2. スキル ライブラリの初期の種は非常に重要です
論文では、スキルベースの初期種の入手方法について詳細には触れていません(Qwenチームが数百のスキルを手動でラベル付けしたのか?それともInduceリンクが何ラウンドかのブートストラッピングで生み出したのか?)。しかし、Qwenのようなチームはおそらく手動で種を作成しているのでしょう。自分でやりたい場合、最も投資すべきはRLアルゴリズムではなく、スキルベースの初期品質です。これは産業プロジェクトでよく見られる「データフライホイール」パターンです。初期段階では手動で種を作成して上限を決め、後期では自動進化で継続的な改善を行うのです。
3. アプリケーションのシナリオには制約がある
論文で検証された2つの領域(ツールの呼び出しと論理推論)はいずれも明確な機械検証可能な契約が存在するシナリオです。もしあなたがオープンな対話や創造的な執筆など、Cが存在しないシナリオに関心があるのであれば、Skill-SPは直接適用できませんが、その原理は参考にできます。「タスクの質」を機械でチェックできるプロキシ(長さ、多様性のスコア、スタイルの埋め込みなど)に分解し、ゲートドリワードを適用すれば、本質的には同じです。
4. これはRLHFではないが、RLHFと互いに補完し合うものです
論文では、GRPOのようなRLアルゴリズムを用いてProposerとSolverをトレーニングしています(具体的にどの論文かは明記されていませんが、コードの参照からverlフレームワークに基づいていることがわかります)。これはRLHFの「報酬モデルのトレーニング」とは異なります。Skill-SPの報酬は環境から直接与えられます。人間の偏好モデルのステップは省略されています。そのため、「報酬が検証可能」なシナリオでは、Skill-SPはRLHFよりも安定していますが、逆に「報酬を人間が判断する」必要があるシナリオでは、依然としてRLHFに依存する必要があります。この2つのパラダイムは互いに代替えの関係にはありません。
7. 一言でまとめる
Skill Self-Playのエンジニアリング哲学は次のとおりです。「LLMが自由に生成するものは信頼できないことを認めるが、その発揮の余地をすべて切り捨てるわけではない。検証可能で拡張可能かつ進化可能なスキルライブラリにそれを枠組み込み、そこで自由に発揮させる」。この考え方は、LLMトレーニングを行う人々にはもちろん、エージェントシステムを構築する人々にも必読である。完全なSkill-SPフレームワークは必要ないが、「スキルライブラリを動的にメンテナンスする」という抽象概念は、おそらく自分のプロジェクトでも活用できるでしょう。
論文の原文はarXiv:2607.22529で、コードとモデルのウェイトはQwenチームの慣例に従ってHuggingFaceで公開される予定です。Qwenリポジトリをフォローしてください、後続のリリースが公開されます。
参考リンク
- arXiv の論文: https://arxiv.org/abs/2607.22529
- Qwen チームの HF ホームページ: https://huggingface.co/Qwen